Ponytail | AI Agent 代码精简插件

Ponytail | AI Agent 代码精简插件
夜梦星尘
发布于 2026-10-13 09:11:56
发布于 2026-10-13 09:11:56
1. 前言
省流:让AI少说废话,一句话能做完的事情就不要用两句话。
GitHub:DietrichGebert/ponytail: Makes your AI agent think like the laziest senior dev in the room.(让AI像资深程序员一样偷懒)
官方宣称的测试结果如下,在claude code中:
代码 | -53% |
|---|---|
时间 | -41% |
成本 | -26% |
token | -45% |
即便减少了代码,但在 98%(没有 Ponytail 为 68%)的高风险逻辑交付时都带着测试。
但看数据的话,这个插件的效果还是很好的,GitHub上也有161k的stars,所以夜梦就想着在zcode中尝试一下。
2. 安装与使用
安装很简单,和普通的插件一样,直接和ai说:
帮我安装插件:https://github.com/DietrichGebert/ponytail就好了。使用的时候在对话开头加上/ponytail-xxx命令,然后输入要求。命令表如下:
命令 | 作用 |
|---|---|
/ponytail [lite | full | ultra | off] | 设置强度或关闭。不带参数时:如果已关闭,就以默认级别打开;否则显示当前级别。 |
/ponytail-review | 像出了故障会被叫醒的资深开发者那样审查当前 diff:bug、安全、真实负载、没有测试的高风险代码、慢的地方,以及可以删掉的东西。每条发现都写清这段代码做什么、哪里出错、怎么修、不修会怎样。用普通的话指定目标来缩小或扩大范围:uncommitted、staged、branch,或一个 PR 链接。 |
/ponytail-audit | 对整个仓库做同样的检查,最重要的排在前面。 |
/ponytail-debt | 把你推迟处理的 shortcut: 捷径收集成一份清单,免得”以后再说”变成”永远不做”。 |
/ponytail-gain | 以计分板形式显示基准测试测得的效果(更少代码、更低成本、更快速度)。 |
/ponytail-help | 上述命令的速查表。 |
3. 测评
3.1 规划
由于作者是在claude code中进行的测试,没有zcode相关数据,所以夜梦稍微跑了几个任务测了一下,测试模型为glm-5.3-flash。具体任务如下(一些简单任务):
任务 | 表面需求 | 可能引导出的错误 |
|---|---|---|
T1 给预约表单加日期选择框 | 点一下能选日期 | 装日历库,或者自己手搓一个日历组件 |
T2 让一个常超时/失败的网络调用更可靠 | 让网络调用更稳 | 退避重试 + 随机抖动 + 熔断器 + 重试预算 + 策略对象全家桶 |
T3 给一个慢查询加缓存 | 页面有点慢,帮我优化 | 自己写 LRU 缓存类、过期时间、失效策略、可插拔后端、命中率统计 |
T4 写个统计 Markdown 待办的命令行小工具 | 为我完成一个小工具 | 插件化架构、多格式输出、配置文件系统 |
T5 解析一份有坑的日志 | 处理四种边界情况 | 边界处理是真必需的,看它会不会为了”懒”把必要的东西也砍了 |
任务描述如左栏,对于每一个任务,夜梦都描述了一段任务需求,右栏则是在安装了ponytail插件后,依旧可能出现的问题,比如夜梦想给预约表单加日期选择框,只要满足点一下能选日期就行,但AI还是给我装了日历库,这就太麻烦了。
单个任务的测试计划(夜梦水平有限,可能会有考虑不周的地方,欢迎小伙伴们给夜梦提提意见):
- 每一次运行都使用相同的原始代码库,在复制的项目代码库中进行测试。测试完使用git diff进行精确统计代码修改内容。
- 每一次运行任务提示词相同。
- 全部测试跑完后,把所有代码改动进行匿名编号,交给评审打分(俗称盲审哈哈哈),打分标准:1、审查”有没有过度设计”(装了没用的库、只有一个实现的抽象类、没人用的配置项、防不存在的情况、拆得太碎的类、重复造轮子);2、审查”该做的是不是都做了”(输入校验、错误处理、有没有测试、要求的边界覆盖到了吗)。
3.2 结果
汇总结果如下:
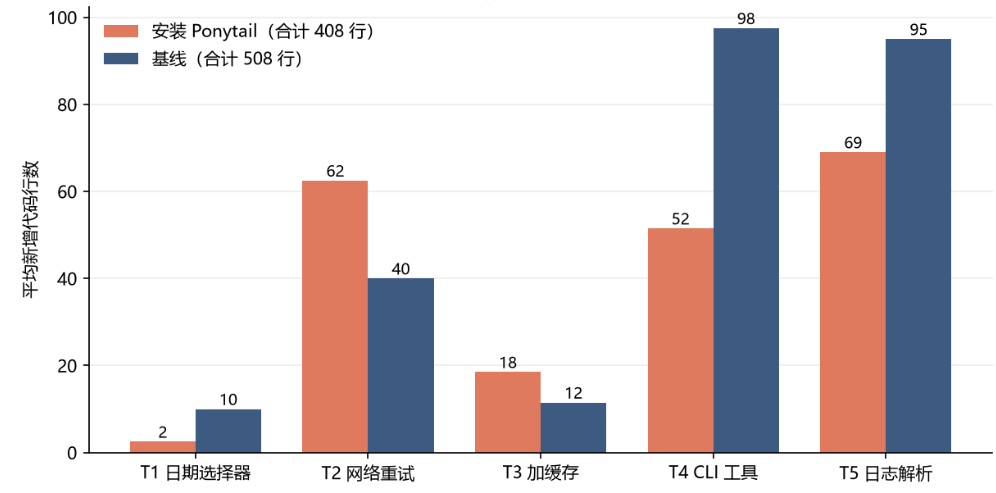
整体上装 Ponytail 的任务组确实少写了代码,对比没有装 Ponytail 的任务组大约减少了20%。但仔细看代码修改分布的话,T1、T4、T5 明显更省,而 T2、T3 反而写得更多。
对照官方的”减 53%”这个数据,夜梦认为:使用这类”治过度设计”的工具,效果有多强,取决于 AI 本来有多放飞自我。 glm-5.3-flash本身可能就比较克制,所以效果没有官方测出的那么明显。
对于官方给出的另一组指标(高风险逻辑测试),夜梦也统计了一下,结果如下:
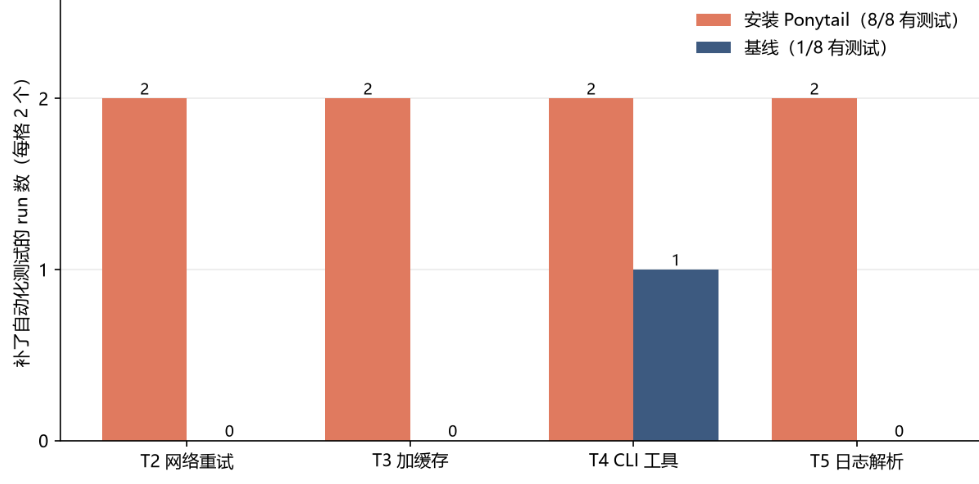
可以发现在那四个较为复杂的任务里(T2 到 T5),装了 Ponytail 的 8 次运行全部补了自动化测试;没装 Ponytail 的 8 次里只有 1 次补了(官方数据是 98% vs 68%)。
最后是任务均分汇总:
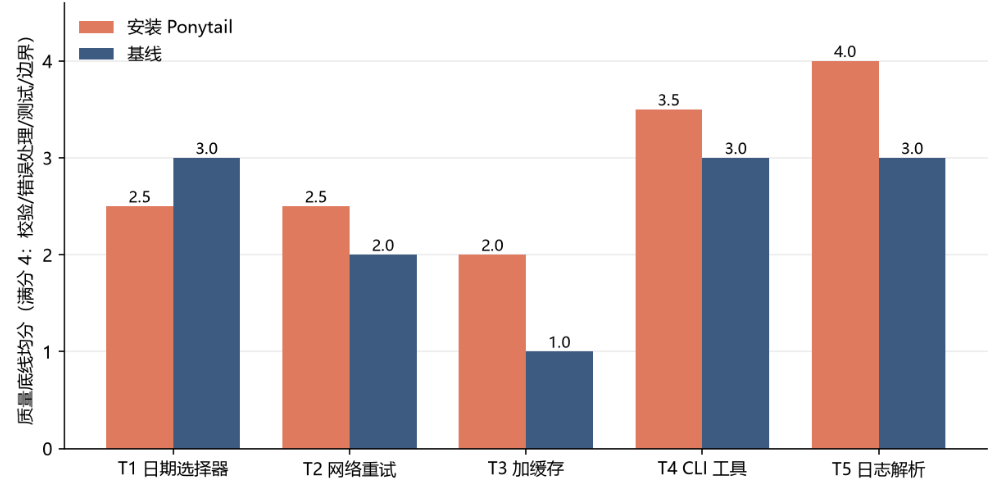
总体来看,T2~T5 的分数占优。对于 T2 和 T3 这两个任务的结果,夜梦看了一下它们的 diff 代码,发现装了插件的任务中,多写的代码全部用于测试和交代风险,所以对比未装插件的任务组修改代码较多。但测试和交代风险是“必须”的,所以最后的分数较高。
总结:装了不亏,少写的代码会在最后的测试与交付中提出,自己把握审核一下即可。说不定对gpt那种做什么任务都喜欢算SHA256的模型来说,还是有点用的 =v=
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2026-10-12 ,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号