移动端自动化提速:Jev 承接每一步的界面判断
原创
移动端自动化提速:Jev 承接每一步的界面判断
原创
克劳德2048
发布于 2026-09-24 12:57:58
发布于 2026-09-24 12:57:58
移动端自动化和桌面一样,卡点都在"这一步点哪个"。屏幕小、控件多、层级深,用大模型逐步判断既慢又贵。这一周我把移动端自动化的界面判断交给 Jev,多步操作明显跟手了。这篇讲清楚移动端场景里 Jev 的落地:痛点、适配、实战流程、效果对比。文中官方口径数据可核实,整体提速为方案性测算,非某项目真实业绩,Jev 仍处早期访问阶段。
Jev 是 TypeSafe AI 推出的高速低成本 AI 判断器,区别于 ChatGPT、Claude 这类生成式大模型,它不做自由问答、文案创作和代码编写,核心定位是软件或 AI 系统中的专用判断组件:输入当前状态加上固定候选选项或评判标准,输出确定性选择(Choice)、量化打分(Score)或真伪概率(Noul)。核心优势是决策 70~500ms、输入 0.042 美元每百万 token 且输出免费、专注封闭式判断规避幻觉、承接大模型琐碎判断从而降本增效。
一、行业痛点拆解
移动端每一步操作都要判断该点哪个界面元素。用大模型逐步判断,慢在逐字生成、单步以秒计;贵在高频调用双向计费;脆在偶尔返回不存在的元素或格式错误导致脚本中断。移动端交互步骤密集,这些问题格外突出,用户能明显感到"卡"。
二、Jev 适配逻辑
"点哪个界面元素"是从当前元素固定集合里选一个,标准的封闭判断。用 Choice 选元素,用 Noul 判断是否有需要先关闭的拦截弹层,用 Score 给候选元素匹配度打分。候选元素由代码从界面层级里提取后给定,Jev 只在边界内选。这四点正好命中它的适配特征:固定选项、批量、低延迟、低成本。
下面这张图对照了两种方案:
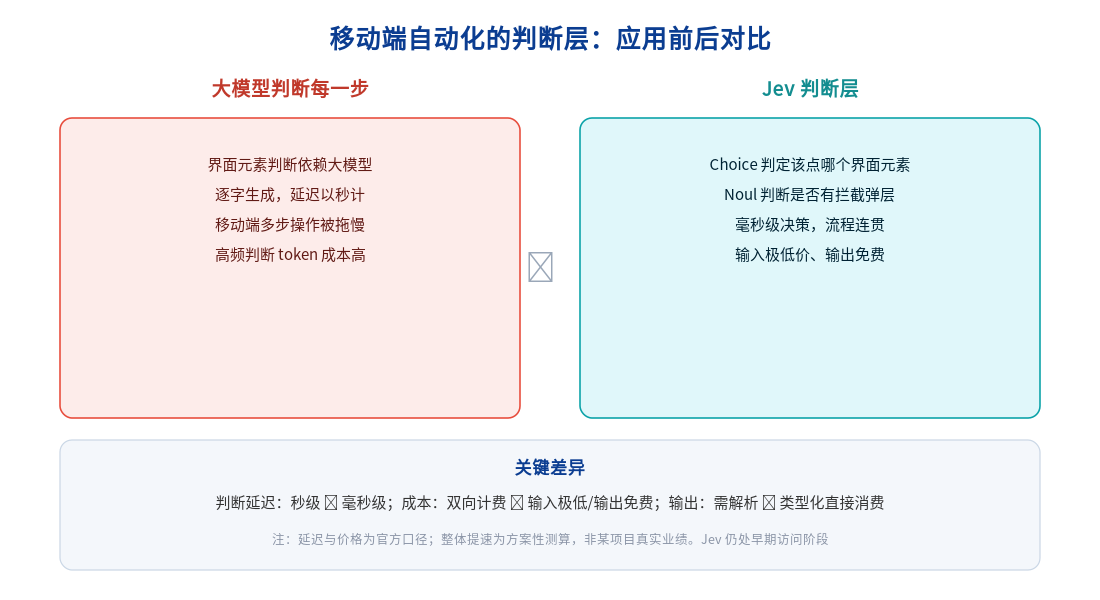
移动端自动化的判断层:应用前后对比
三、实战落地流程
五步:输入状态(代码抓取当前界面元素列表加任务目标组成 state)→ 固定候选(元素列表作为 Choice 候选)→ Jev 决策(Choice 选元素、Noul 判弹层,一次调用并行)→ 输出结果(返回选中元素加置信度,直接读字段)→ 落地执行(高置信直接操作、中等加校验、低置信升级大模型或人工)。循环推进完成任务。
四、效果数据佐证
延迟:Jev 官方口径 70~500ms,大模型同类判断以秒计;第三方实测 Jev 中位 0.32 秒、大模型开推理 26 秒,移动端多步操作从卡顿变连贯。成本:Jev 输入 0.042 美元每百万 token、输出免费,第三方实测每千份判断约 0.22 美元、大模型 1.31~3.08 美元。准确率:实测两者大致持平,Jev 的价值在极低成本与延迟。整体提速取决于判断步骤占比,属方案性测算,需自测。
五、避坑与生产落地建议
边界:Jev 不做计数、精确计算、日期换算、开放式创作和无边界推理,这类先在代码里处理好再交它判断;界面元素提取由代码负责;复杂推理交大模型。生产接入:优先影子运行并行对照,基于自身界面数据校准阈值(阈值不等于真实准确率),低置信度自动转人工或强推理大模型兜底。判断层交 Jev、生成与兜底交大模型、逻辑与候选留代码,移动端自动化才能快、稳、省。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号