CVPR 2026上的多模态工作


仔细扒了一下最近的顶会顶刊,发现多模态方向越来越卷了,想顺利发文,必须转变思路! 具体来说:以往参数越大性能越强的思路和拼接式架构已经逐渐示弱,原生统一架构成为新风口;跨模态融合、对齐、生成等基础方法的研究也已非常深入,单纯做修改注意力模块的参数、替换损失函数等的小改进创新不足,需要结合垂直场景,挖掘具体痛点,比如医疗场景中多模态数据的标注稀缺等。 此外,多模态+具身智能、多模态+因果学习、多模态+agent等交叉方向则处于蓝海阶段,可发挥空间还很大,非常值得关注。 当然,更多的风向变化和前沿创新思路,还是需要多看看最新的顶会论文!为给大家节省时间,我给大家整理好了CVPR、ICLR、ICML、AAAI等顶会上153篇高分的论文和源码!
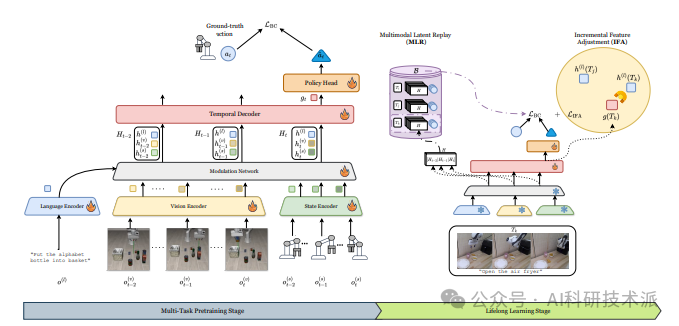
Lifelong Imitation Learning with Multimodal Latent Replay and Incremental Adjustment
内容:本文面向终身模仿学习场景,核心融合多模态隐式回放机制与增量调整策略开展方法设计:首先针对多模态输入数据构建隐式表征空间,通过多模态隐式回放将历史任务的关键隐式特征进行高效存储、采样与重放,规避传统原始数据回放带来的存储开销与模态冗余问题,有效缓解终身学习中的灾难性遗忘;同时引入增量调整模块,在持续接收新任务模仿数据时,仅对模型参数与行为策略进行渐进式局部更新,而非全局重训练,兼顾新任务学习能力与旧任务知识留存;整体依托双机制协同,让模型在连续多任务模仿过程中,实现多模态信息的有效复用、新旧任务知识的平稳更迭,完成端到端的终身模仿学习。
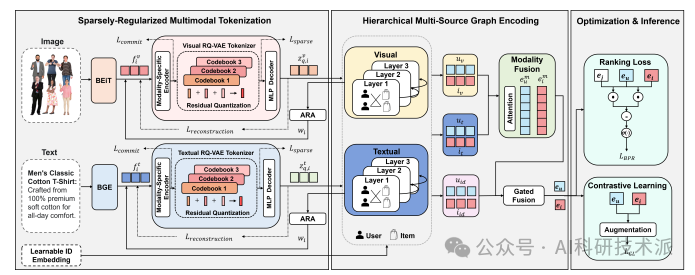
MoToRec: Sparse-Regularized Multimodal Tokenization for Cold-Start Recommendation
内容:本文针对终身模仿学习任务,提出融合多模态隐式回放(MLR)与增量特征调整(IFA)的一体化方法,整体架构由视觉、语言、机器人状态等模态专属编码器、调制网络、时序解码器与策略头构成,先完成多任务预训练,在后续终身学习阶段冻结 CLIP 等主干编码器,仅更新时序解码器与策略头以降低训练成本与过拟合风险。该方法摒弃传统回放方案存储原始多模态数据的模式,转而在回放缓冲区中存储融合视觉、语言、机器人状态及控制指令的紧凑联合隐式特征,大幅削减存储开销并提升特征复用效率,以此缓解终身学习中的灾难性遗忘问题。
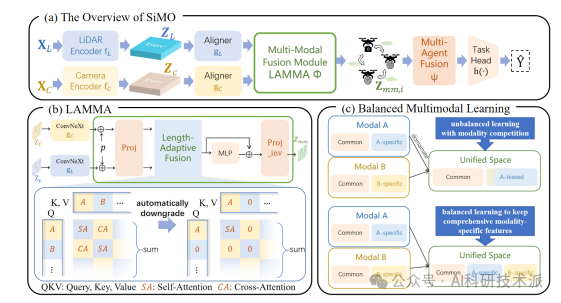
SIMO: SINGLE-MODALITY-OPERABLE MULTIMODAL COLLABORATIVE PERCEPTION
内容:本文针对多智能体协同感知中多传感器模态失效、跨智能体语义不一致以及模态竞争导致单模态分支无法独立工作的问题,提出单模态可用的多模态协同感知框架 SiMO,首先采用 Lift-Splat-Shot 与 PointPillar 分别提取相机、激光雷达的 BEV 特征,借助 ConvNeXt 构建对齐模块将不同模态特征映射至统一语义空间,再设计即插即用的长度自适应多模态融合模块 LAMMA,结合自注意力与交叉注意力机制实现特征融合,该模块可在某一模态缺失时自动退化为纯自注意力运算,全程维持融合前后特征空间与跨智能体语义的一致性,保障模态失效时系统仍可正常运行;
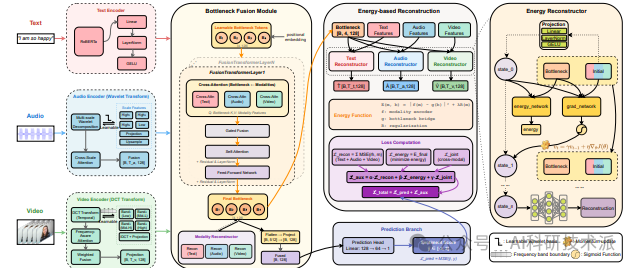
DCER: Robust Multimodal Fusion via Dual-Stage Compression and Energy-Based Reconstruction
内容:本文提出 DCER 鲁棒多模态融合框架,采用双阶段压缩结合能量重构解决噪声与模态缺失问题。先在单模态内分别对音频做小波变换、视频做离散余弦变换以降噪并提取有效特征,再利用固定容量的可学习瓶颈令牌实现跨模态融合,规避分模态学习捷径;针对模态缺失场景,通过梯度下降优化能量函数还原缺失表征,同时依靠能量值完成不确定性量化。模型结合预测损失、重构损失、能量损失等联合训练,显著提升多模态情感分析在噪声和模态缺失场景下的性能与鲁棒性。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2026-06-16,如有侵权请联系 cloudcommunity@tencent.com 删除
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号