忆芯科技:Flash2DRAM 动态数据加载

忆芯科技:Flash2DRAM 动态数据加载
数据存储前沿技术
发布于 2025-02-11 19:29:29
发布于 2025-02-11 19:29:29
全文概述
本文讨论了在有限内存下通过动态数据加载技术从闪存到DRAM进行LLM(语言模型)推理的方法。
- LLM正驱动着工业革命的下一个浪潮,但其巨大的模型尺寸要求大量内存,对边缘和端点设备构成挑战(Fig-3)。
- 为解决这一问题,文中提出了利用高频和低频权重分离、以及计算存储(CSD)技术来优化内存使用(Fig-4)。
- 通过将高频权重保存在GPU/NPU的DRAM中,并利用CSD预测并加载所需的低频权重,可以显著减少内存需求(Fig-5/6)。
- 此外,还探讨了不同模型的参数、性能及成本,并提出了一些加速推理的具体策略,如模型量化、训练时权重剪枝和使用预加载机制来进一步提高效率(Fig-4)。
本文概述了一个综合的应用场景和生态系统,展示了如何通过创新的技术解决方案实现高效能的LLM推理。
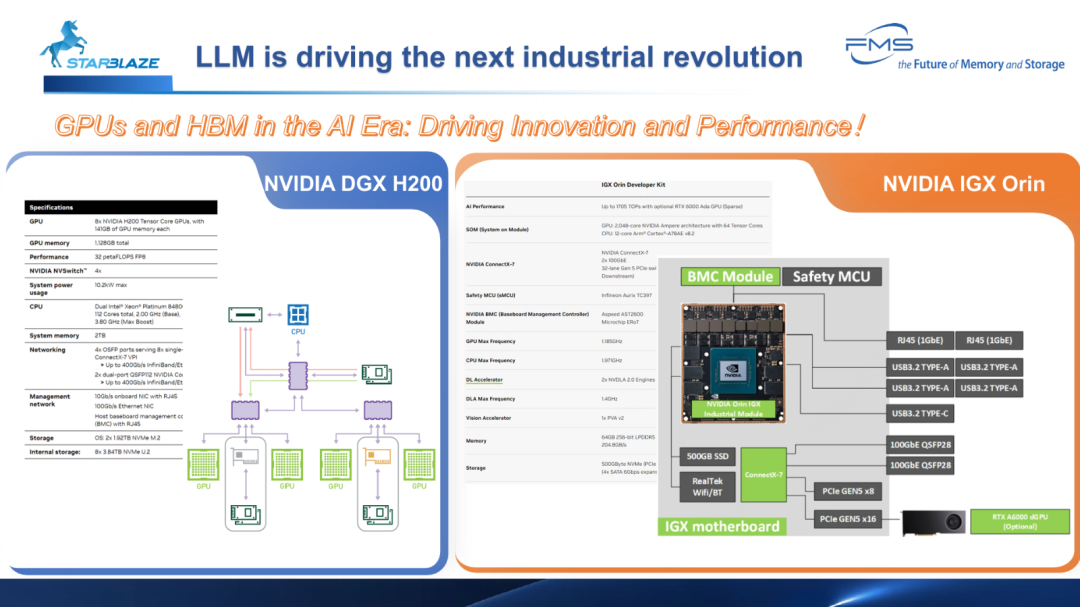
Fig-1
Nvidia 最新两款 GPU 配置信息
图展示了两种NVIDIA解决方案(DGX H200和IGX Orin) 在大模型(LLM)时代的技术特点和性能,分别用于高性能计算与工业应用。
- NVIDIA DGX H200 定位于数据中心级AI训练,提供超强GPU性能(8块H200 GPU,32 PFLOPS FP8计算能力)以及高速网络互连。
- NVIDIA IGX Orin 面向工业和边缘AI应用,具有高度模块化设计,支持强大的计算性能和扩展能力,同时保证工业级安全性。
两者均突出了GPU和HBM(高带宽存储器)在推动AI性能创新方面的重要作用。 ---
关于 Orin 边缘加速显卡
NVIDIA IGX Orin 的设计初衷是推动工业和边缘设备智能化升级,适用于多个垂直领域。
为什么选择 NVIDIA IGX Orin?
- 实时性与高性能 Orin 平台通过高性能 GPU 和低延迟网络支持复杂 AI 应用的实时处理。
- 模块化与扩展性 支持多种设备与接口,能够灵活适配不同场景需求。
- 安全可靠性 满足工业和医疗领域的安全标准,支持关键任务。
- 可持续发展 低功耗设计与强大的计算能力平衡,适合长期运行。
Note
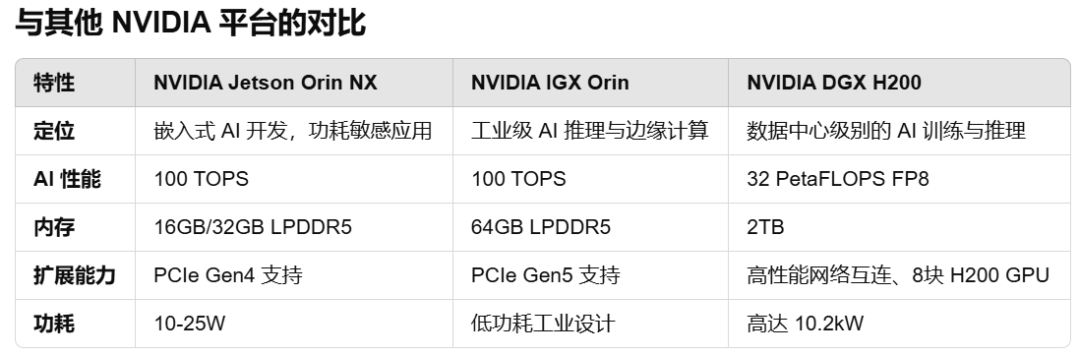
Orin 是 Nvidia 布局边缘计算场景的GPU加速卡,适用于垂直场景小模型,对边缘场景的时延和功耗更友好。
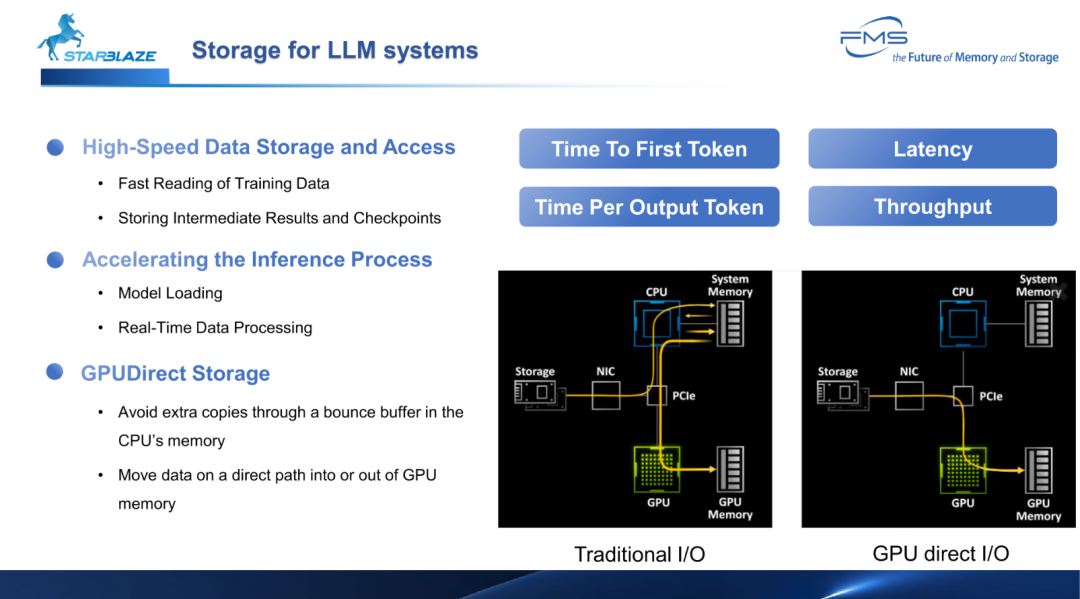
Fig-2
AI/ML 存储IO路径
右下角图示分析
1. Traditional I/O(传统 I/O)
- 数据从存储设备通过网络接口(NIC)传输到 CPU。
- 数据被加载到系统内存,然后再传输到 GPU 的内存中,过程涉及多次数据拷贝,增加延迟和资源消耗。
2. GPU Direct I/O(GPU 直连 I/O)
- 数据从存储设备直接通过网络接口(NIC)传输到 GPU 内存。
- 避免了通过 CPU 和系统内存的中转路径,显著降低延迟和提高数据传输效率。
---
实现 GPU Direct Storage 的核心技术是什么?需要哪些方面的适配?
核心技术
- 绕过 CPU 内存的直接数据传输
- 传统的数据路径需要将数据从存储设备加载到系统内存(通过 CPU),然后从系统内存拷贝到 GPU 显存。这种方式增加了延迟和资源消耗。
- GPUDirect Storage 实现了数据从存储设备直接传输到 GPU 显存,省略了系统内存的中间环节。
- RDMA (Remote Direct Memory Access)
- GPUDirect Storage 的核心依赖 RDMA 技术,可以让存储设备通过 DMA(直接内存访问)将数据直接加载到 GPU 显存。
- RDMA 的优势在于绕过 CPU 的干预,硬件级加速数据传输。
- 优化的 PCIe 通信协议
- GPUDirect Storage 使用优化的 PCIe 数据通路,允许存储设备(如 NVMe SSD)与 GPU 的直接数据交换。这需要高性能 PCIe(通常为 PCIe Gen4 或 Gen5)的支持。
- NVIDIA GPUDirect RDMA 技术扩展
- GPUDirect Storage 是 NVIDIA GPUDirect 技术的扩展,GPUDirect 包括支持网络设备(如 InfiniBand 和以太网)和存储设备(如 NVMe SSD)的直接数据传输能力。
- 存储堆栈的改造
- GPUDirect Storage 修改了传统的存储堆栈,优化了 I/O 子系统,直接支持 GPU 显存作为数据目标,减轻了文件系统和 CPU 的压力。
实现 GPUDirect Storage 所需的适配
要部署 GPUDirect Storage,需要从以下几个方面进行适配
1. 硬件支持
- GPU
- 必须使用支持 GPUDirect 的 NVIDIA GPU,如 A100、H100、以及其他较新的 GPU。
- 存储设备
- NVMe SSD 是 GPUDirect Storage 的主要存储介质,需支持高性能的数据吞吐(如 PCIe Gen4/Gen5 NVMe SSD)。
- 网络接口(NIC)
- 如果数据需要通过网络传输,则网络适配器(如 Mellanox ConnectX 系列)必须支持 RDMA 和 GPUDirect 技术。
- 主板和 CPU
- 支持高带宽的 PCIe 通道(如 PCIe Gen4 或更高版本)以连接 GPU 和存储设备。
2. 操作系统与驱动支持
- Linux 环境
- GPUDirect Storage 当前主要支持 Linux,推荐使用 NVIDIA 提供的优化内核(如 RHEL 或 Ubuntu)。
- 驱动程序
- 必须安装 NVIDIA 提供的 GPU 驱动程序和 GPUDirect Storage 驱动。
- 存储驱动
- 支持与 GPU 直接交互的 NVMe 驱动。
3. 文件系统和 I/O 堆栈
- GPUDirect Storage 对文件系统支持有限,通常建议使用并行文件系统(如 Lustre 或 GPFS)以充分利用带宽。
- 优化 I/O 调度器以减少额外开销,确保数据直接传输到 GPU。
4. 应用程序级别适配
- 必须调整应用程序以支持 GPUDirect Storage,例如修改数据读取和写入路径,使数据能够直接从存储传输到 GPU 显存。
- NVIDIA 提供了 API 和工具(如 CUDA 和 cuFile Library)以支持 GPUDirect Storage。
- 用于优化应用程序的 I/O 数据流。
- 提供直接访问存储和 GPU 显存的能力。
- cuFile Library
5. 存储架构设计
- GPUDirect Storage 通常需要重新设计存储架构,减少中间缓存和传输环节,以确保数据在存储设备和 GPU 显存之间以最高效率传递。
GPUDirect Storage 的实现流程
- 数据请求
- GPU 通过 cuFile 或其他 API 请求数据。
- 数据路径
- 数据直接从存储设备(如 NVMe SSD)传输到 GPU 显存,绕过 CPU 和系统内存。
- 硬件支持
- RDMA 或 PCIe 通道确保数据以最小延迟传输。
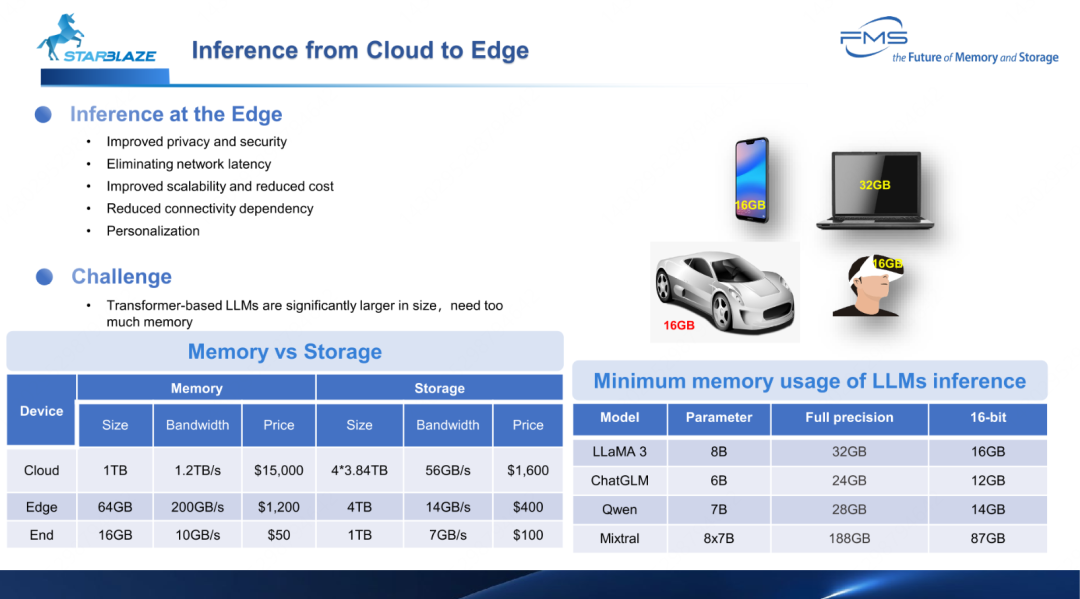
Fig-3
边缘推理的内存挑战
- 边缘推理的优势 边缘设备推理能够提高隐私性、安全性和个性化,减少网络依赖和延迟,非常适合实时应用。
- 挑战 大语言模型(如 LLaMA、ChatGLM)随着参数规模增加,对内存和存储需求非常高,尤其是边缘设备可能受到内存限制。
- 设备对比 云、边缘和终端设备在内存、存储以及性能上的差异显著,边缘推理设备需要在性能和成本之间找到平衡。
- 推理需求 根据不同模型的规模和精度要求,设备需具备足够的内存(如 16GB 或更高)以支持高效推理。
Note
考虑到边缘场景推理的实时数据流对带宽需求并不高,带宽可以降低,用Flash替代内存作为数据存储可能是更经济的方式。
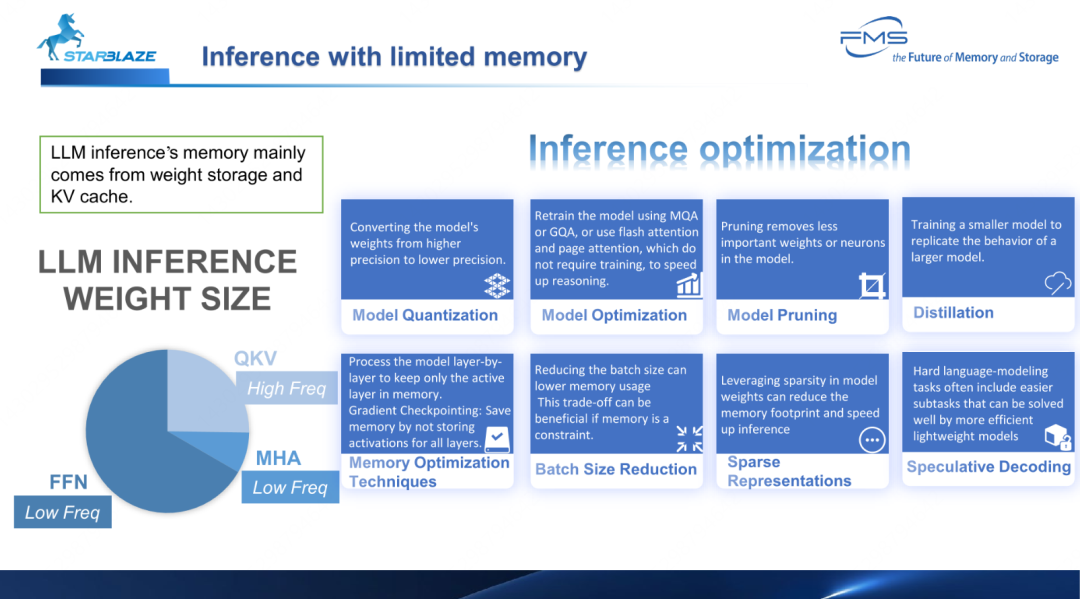
Fig-4
有限内存下的AI推理途径
推理过程与组件
- QKV(高频组件) 是计算注意力权重的核心,用于捕获输入序列中各位置之间的相关性。
- MHA(低频组件) 聚合多个注意力头的结果,增强了模型的全局特征捕获能力。
- FFN(低频组件) 是注意力模块的后处理单元,用于进一步提升特征的表达能力。
- 在推理任务中
- 输入数据首先经过 QKV 计算相关性,生成上下文相关的注意力表示。
- MHA 将不同注意力头的特征组合起来,形成多方面的全局特征。
- 最后通过 FFN 进行进一步的非线性特征映射,形成最终的输出。
区分不同组件的数据频率,合理放置以提高系统的整体效率。
推理优化方法(Inference Optimization)
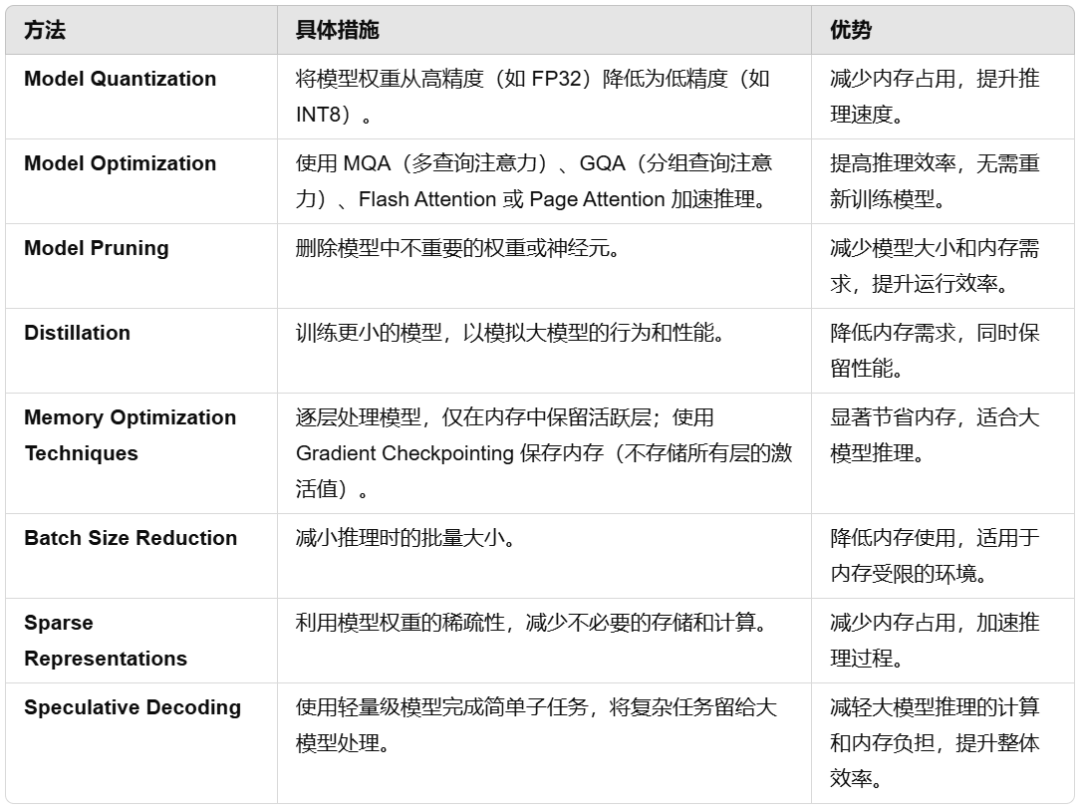
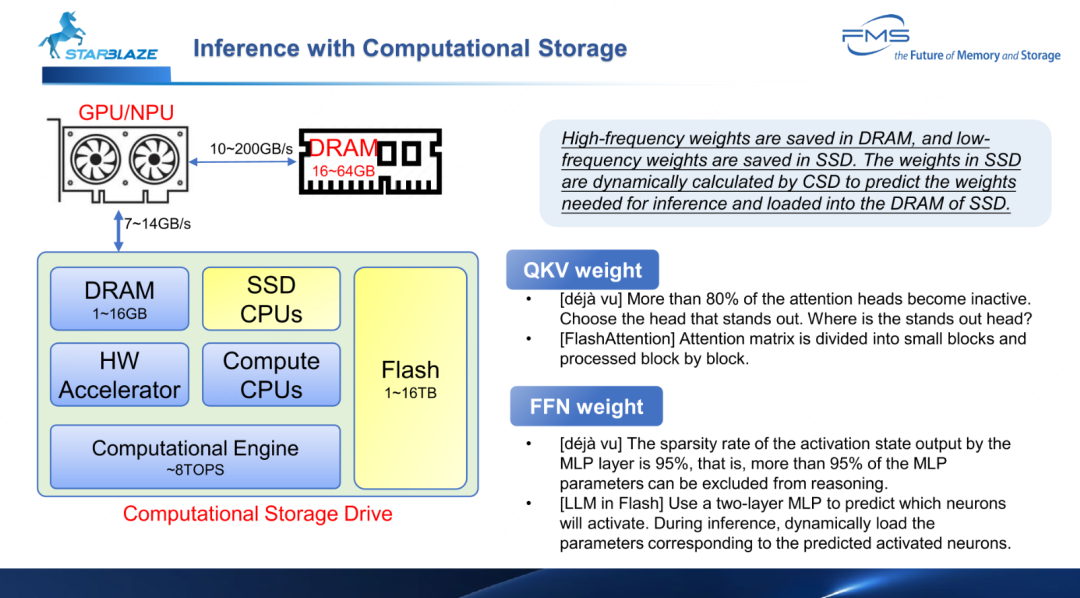
Fig-5
计算型存储(CSD)在推理中的作用
左图示意基于计算型存储耦合的加速计算系统(尤其在边缘受限场景)。
- 基于计算存储的优化
- 高频权重存储在 DRAM,低频权重存储在 SSD,结合 CSD 的动态计算和加载机制,实现高效推理。
- CSD 提供硬件加速器和计算 CPU,能够在存储设备中完成部分计算任务,减少 GPU 的计算负担。
- 推理优化方法
- QKV 优化 减少无效注意力头的计算,并分块处理注意力矩阵。
- FFN 优化 利用模型稀疏性,动态加载必要参数,进一步降低存储和计算开销。
- 意义
- 提高存储设备与 GPU 的协同效率,减少内存和计算资源占用,使大模型推理能够在存储受限的环境中高效运行。
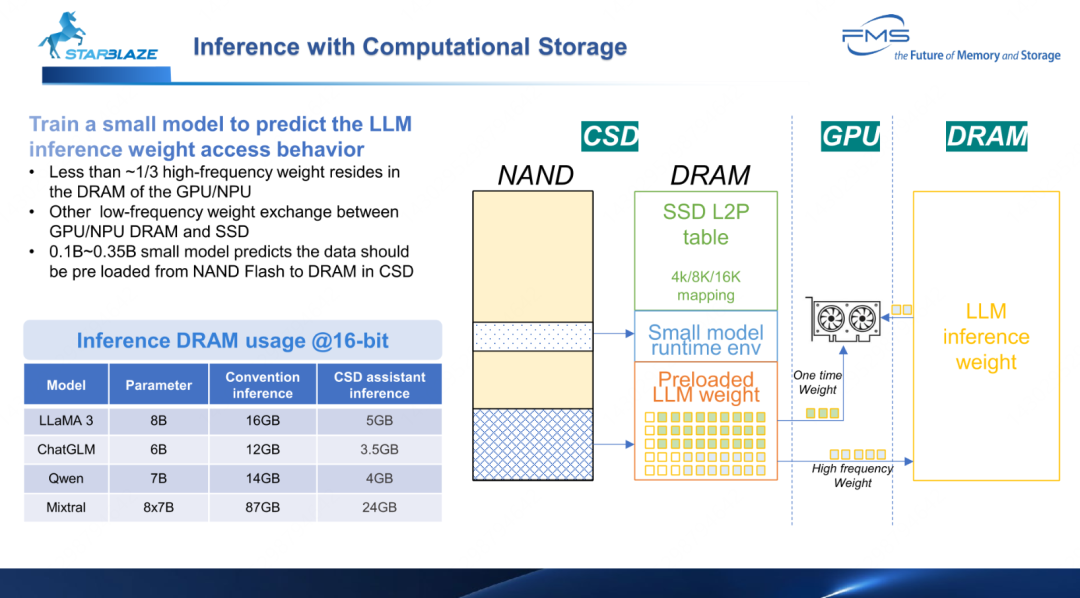
Fig-6
CSD 推理架构
使用小模型预测 LLM 推理中的权重访问行为
- 约有 1/3 的高频权重存储在 GPU/NPU 的 DRAM 中。
- 其他 低频权重在 GPU/NPU 的 DRAM 和 SSD 之间交换。
架构说明
- NAND(Flash 存储)
- 存储 LLM 的低频权重。
- DRAM(在计算存储设备中)
- 包含 SSD 的 L2P(逻辑到物理)映射表,用于 4K/8K/16K 大小的映射。
- 提供小模型的运行时环境,动态预测和加载需要的权重。
- 预加载的 LLM 权重部分根据小模型的预测结果从 NAND 移入 DRAM。
- GPU/NPU DRAM
- 存储高频权重和部分一次性加载权重(One-time Weight),为推理提供直接支持。
通过使用小模型预测 LLM 的权重访问行为,结合 计算存储设备(CSD),推理架构能够有效优化存储和计算资源。高频权重直接存储在 GPU/NPU 的 DRAM 中,低频权重则通过动态加载机制从 NAND 加载到 CSD 的 DRAM,再传输到 GPU,显著降低了 DRAM 占用和整体成本。
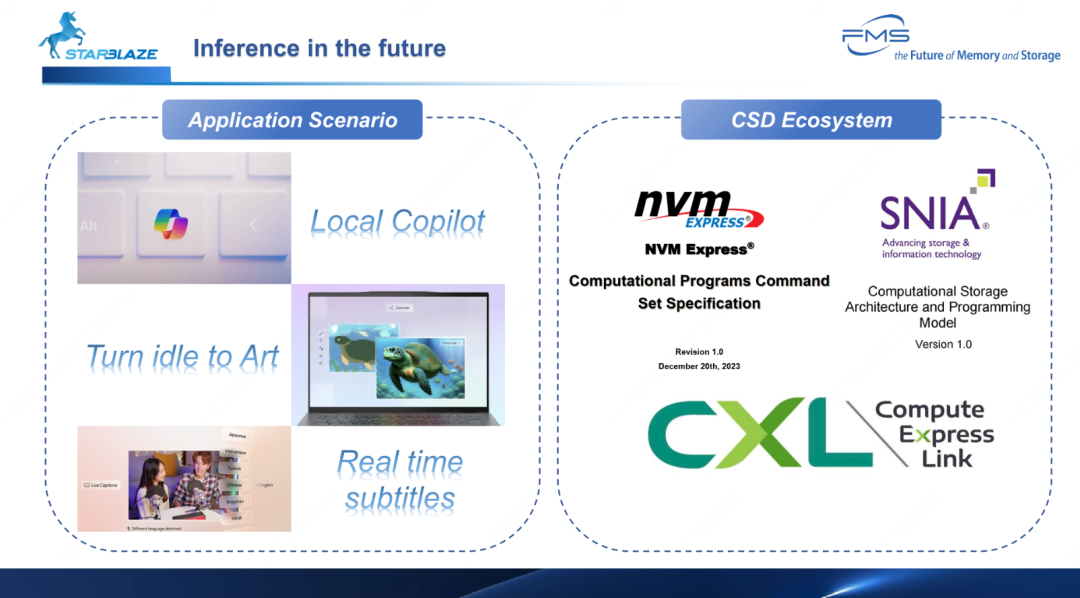
Fig-7
未来推理的发展方向
- 应用场景拓展
- 推理将更贴近终端用户,提供实时、本地化的功能支持,包括个性化助手、创意生成、实时语言处理等。
- CSD 生态系统完善
- 通过标准化(如 NVMe 和 SNIA 的规范)和新技术(如 CXL)的支持,计算存储设备(CSD)将成为推理任务的重要组件,减少延迟并提升效率。
- 结合本地与云计算
- 本地化的推理能力结合强大的计算存储生态,将推动更快、更个性化的 AI 应用发展。
本文参与 腾讯云自媒体同步曝光计划,分享自微信公众号。
原始发表:2024-12-25,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号