POINTNET:利用深度学习对点云进行3D分类和语义分割

POINTNET:利用深度学习对点云进行3D分类和语义分割

Mezereon
发布于 2023-05-10 08:53:54
发布于 2023-05-10 08:53:54
POINTNET:利用深度学习对点云进行3D分类和语义分割
参考自,PointNet: Deep Learning on Point Sets for 3D Classification and Segmentation 代码仓库地址为:https://github.com/charlesq34/pointnet/
介绍
这次介绍的是一个比较基础的工作,针对空间点云,进行分类或者语义分割的框架,现在通常也被用作对RGB-D图像进行特征提取的部分。
该工作的目的就是,输入点云信息,得到每一个点的语义,或者是得到整个点云代表的物体信息。
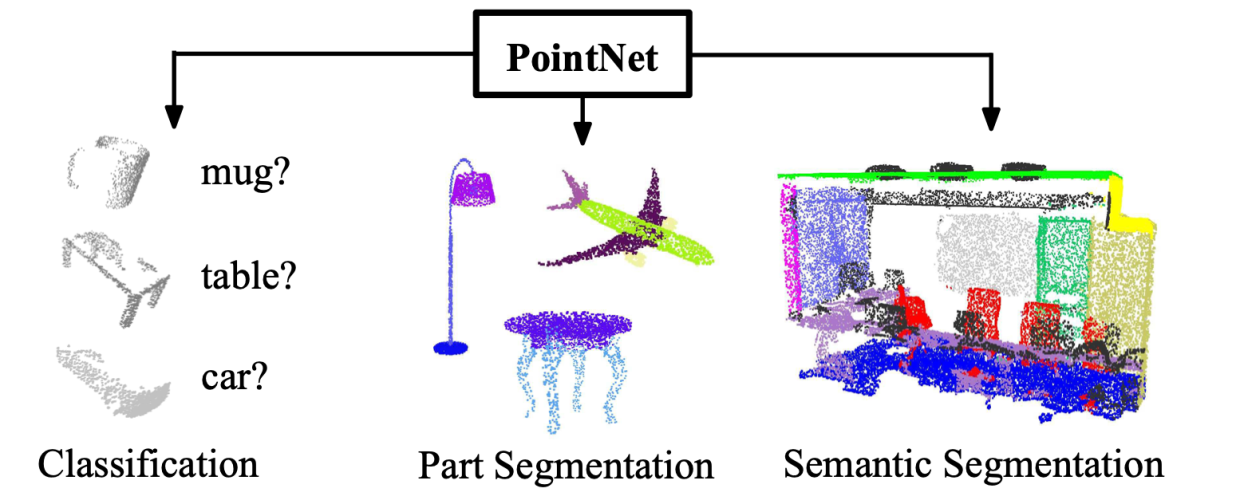
PointNet Application
如上图所示,该工作可以对点云数据进行分类,语义分割,部分分割等。
具体细节
首先,我们假设点云为一系列点的集合,记为

每一个点,都有坐标

,以及代表色彩的通道值,如果是rgb,那就是3个通道的值
这里直接给出整个PointNet的结构图
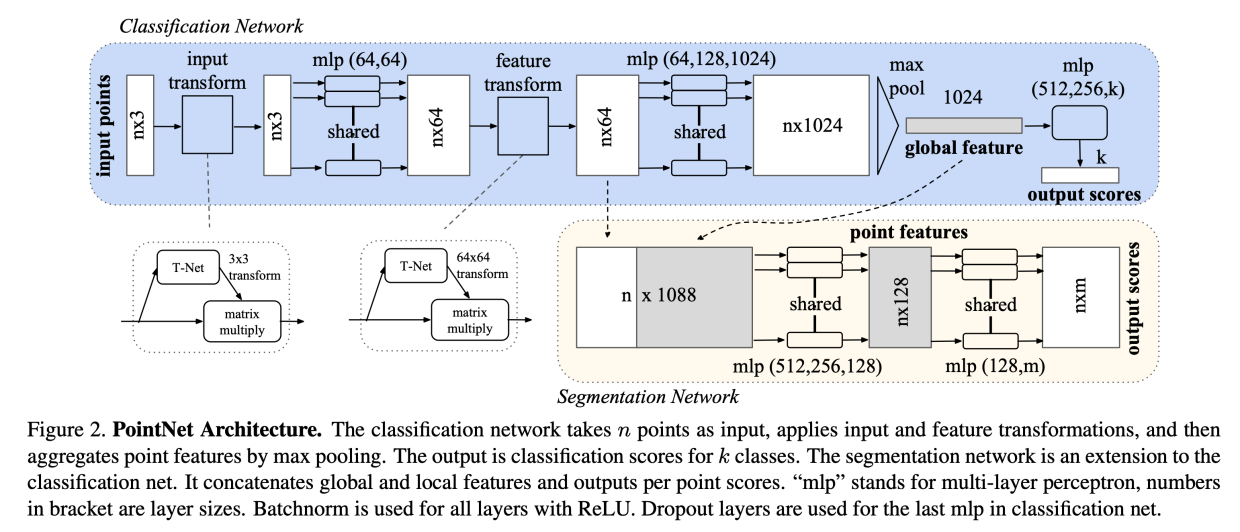
overview
我们首先来看蓝色背景的部分,代表一个分类网络,输入是一个

的点云信息,其中

是点的数目,

代表着空间坐标的维度
最终输出一个

维的分数,代表对
个物体的分类置信度。
我们来仔细看一下处理的过程:
1. Input Transform
这一部分由一个T-Net和矩阵乘法构成,最终输出的形状还是
通过分析其代码,可以知道,该T-Net由3个卷积层,1个最大池化层以及2个线性层组合而成
最终输出一个

的变换矩阵,然后右乘上输入(输入的形状是
)得到
的输出
直觉上看,就是用一个小的网络学习一个线性变换,对输入的点云做处理
2. MLP
代码中使用的是两个卷积层:
- 先用一个

的卷积,输出通道数为

- 然后是一个

的卷积,输出通道也是
所以最终的输出是

的形状
3. Feature Transform
和先前一样,用T-Net输出一个

的线性变换矩阵右乘上去
4. MLP
用三个

的卷积,将通道数直接提升到了

,输出的形状也就是

本质上和线性层是一样的
5. MaxPool
过一个MaxPool,kernel大小设置成

,直接得到一个
维的特征向量
6. MLP
最后直接用三个线性层,将输出转换成
维的分类置信度
语义分割的细节
这里合并了两个特征,形状分别是
和
将
长度的特征向量复制
次,接在
维的向量后面,便得到

的输出
过一系列MLP,最终输出

形状的矩阵,

代表语义分割的类别
实验分析
物体分类
首先是在ModelNet40数据集上分类的准确率
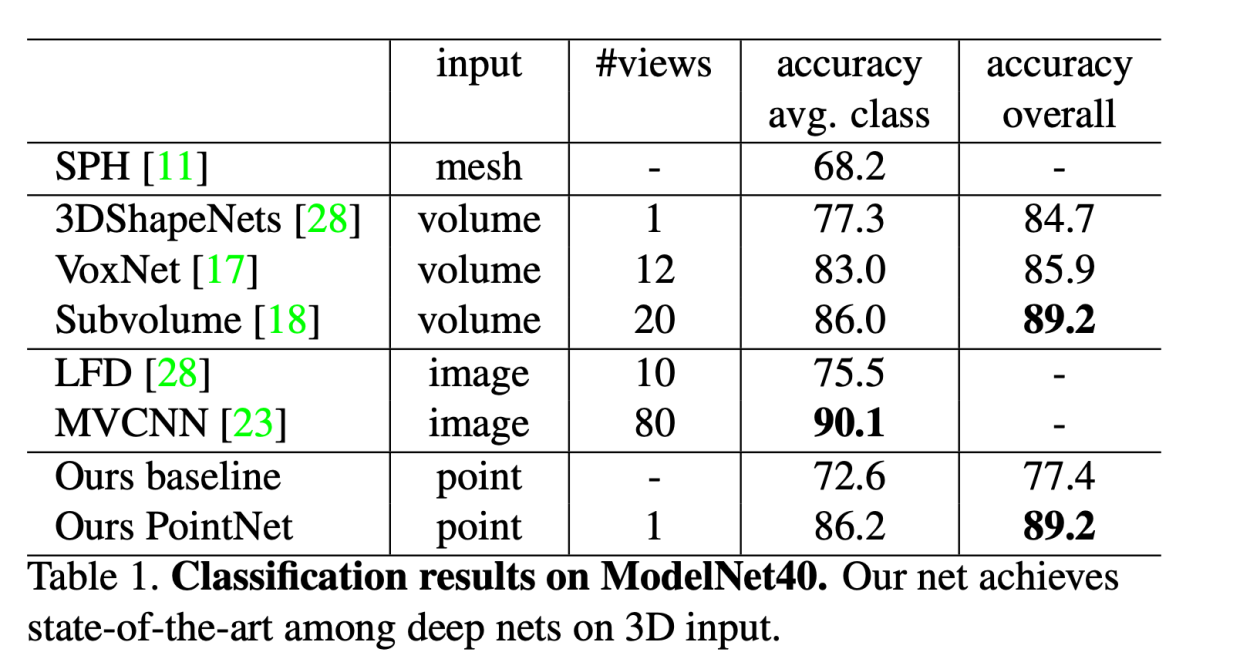
cls
基本上在3D输入上达到了SOTA的性能,整体正确率为89.2%。
语义分割
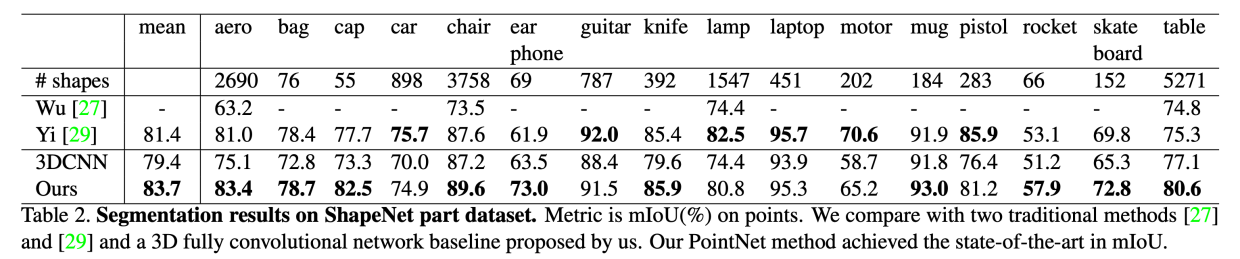
seg
可以看到,比起3D全卷积的baseline,mIoU也是达到SOTA的性能
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2023-05-08,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号