我把年报、招标文件和 14 年前的扫描件,分别喂给了裸 LLM 和 TextIn Xparse + LLM
原创
我把年报、招标文件和 14 年前的扫描件,分别喂给了裸 LLM 和 TextIn Xparse + LLM
原创
用户11872857
发布于 2026-10-29 11:06:42
发布于 2026-10-29 11:06:42
摘要
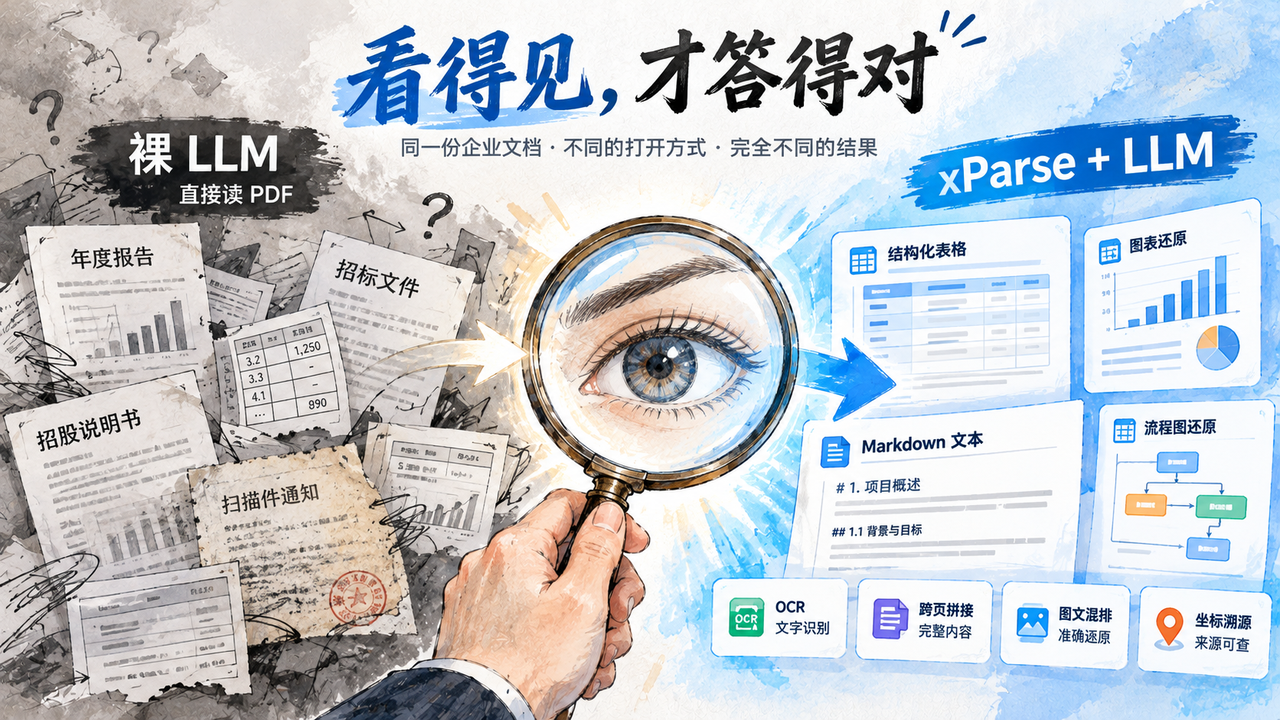
起因是一个听了很多遍的说法,Agent 的瓶颈不在智商,在视力。
我不太服气。现在的大模型连图片都能看了,读书看报不在话下,怎么会卡在视力上?于是搞了个对照实验,从公开渠道收了 7 份“地狱难度”的企业文档,200 页的上市公司年报、政府采购招标文件、303 页的招股书、还有一份 2012 年的纯扫描件公告,分别用两条链路喂给同一个 LLM,一条是裸模型直接读 PDF 原生文本(大多数 RAG 教程教你的默认做法),另一条是先用合合信息 TextIn xParse 解析成结构化 Markdown 再读。
33 道固定问题跑下来,裸读组可确定回答 61%,xParse 组 79%。数字差距是一方面,更刺激的是过程,扫描件那一组,裸读模型拿到的全部输入只有 36 个字符,五个问题全灭;而跨页表格、流程图、合并单元格这些场面,两组的差距不是答得好不好,是能不能答。
文末顺便聊聊这套东西的终局形态,合合信息在 QCon上刚发布的企业知识服务引擎,解析只是第一层,后面还有一整条把企业文档变成 Agent 共享记忆库的链路。
一、开始之前,先介绍一下 TextIn xParse
按老规矩,实验之前先介绍一下主角 TextIn xParse。
一句话定位,合合信息旗下面向 LLM 与 Agent 的文档智能基础设施。这句话的重心在「基础设施」,它不回答问题、不替你写报告,做的是更底层的事,把复杂文档转化为干净、一致、可用于 AI 的结构化数据,给知识库、RAG、各种 AI 工作流当数据底座。上一期我搭错题工作台的时候打过比方,它像水电煤,Agent 这栋楼能盖多高,取决于这层供给稳不稳。
合合信息做文档智能做了 20 年,xParse 是这套家底面向 AI 时代的产品化。官网上的几个数字,全球 1,000+ 企业在用,累计处理文档超 10 亿页,大规模场景下日处理千万页级,API 可用性 99.99%。生态位也很清楚,Dify、RagFlow、LangChain、Milvus 这些主流 RAG 技术栈即插即用,WorkBuddy、豆包工作这些 Agent 产品里有官方连接器,每天还有 1,000 页免费额度。
能力上挑几条和本文实验直接相关的说。格式层,PDF(电子档加扫描件)、Word、Excel、PPT、图片等 16+ 种格式通吃;识别层,文本、表格、公式、手写体、印章、页眉页脚等 16 种内容元素;结构层,合并单元格、跨页表格、无线表格的还原是官方明着宣传的强项,阅读顺序按版面还原;输出层,Markdown 和 JSON,LLM 直接消费,页码、段落、字符多级溯源。速度,百页 PDF 最快 1.5 秒。
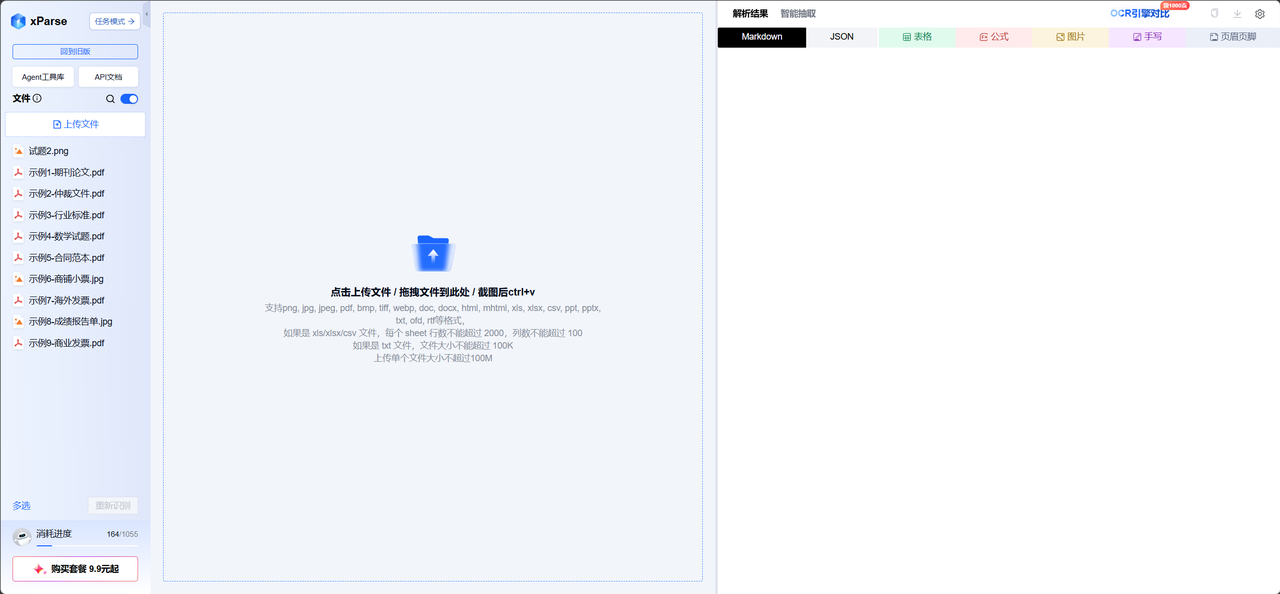
入口在 TextIn xParse,注册就能用。本次实验我全程走的是它的 CLI。
底牌交代完了。但官网上写的,和 200 页年报、2012 年扫描件面前实际发生的,永远是两回事。
二、实验设计,先交代清楚再开始实测
先说一下我为什么要较这个真。
这两年搭 RAG、写 Agent 的朋友都知道一个流程,文档进来,加载器一把梭转成文本,切块,入库,检索,生成。教程都这么教。但真实世界递给 Agent 的文档,长什么样?
这里我准备了四份文件:
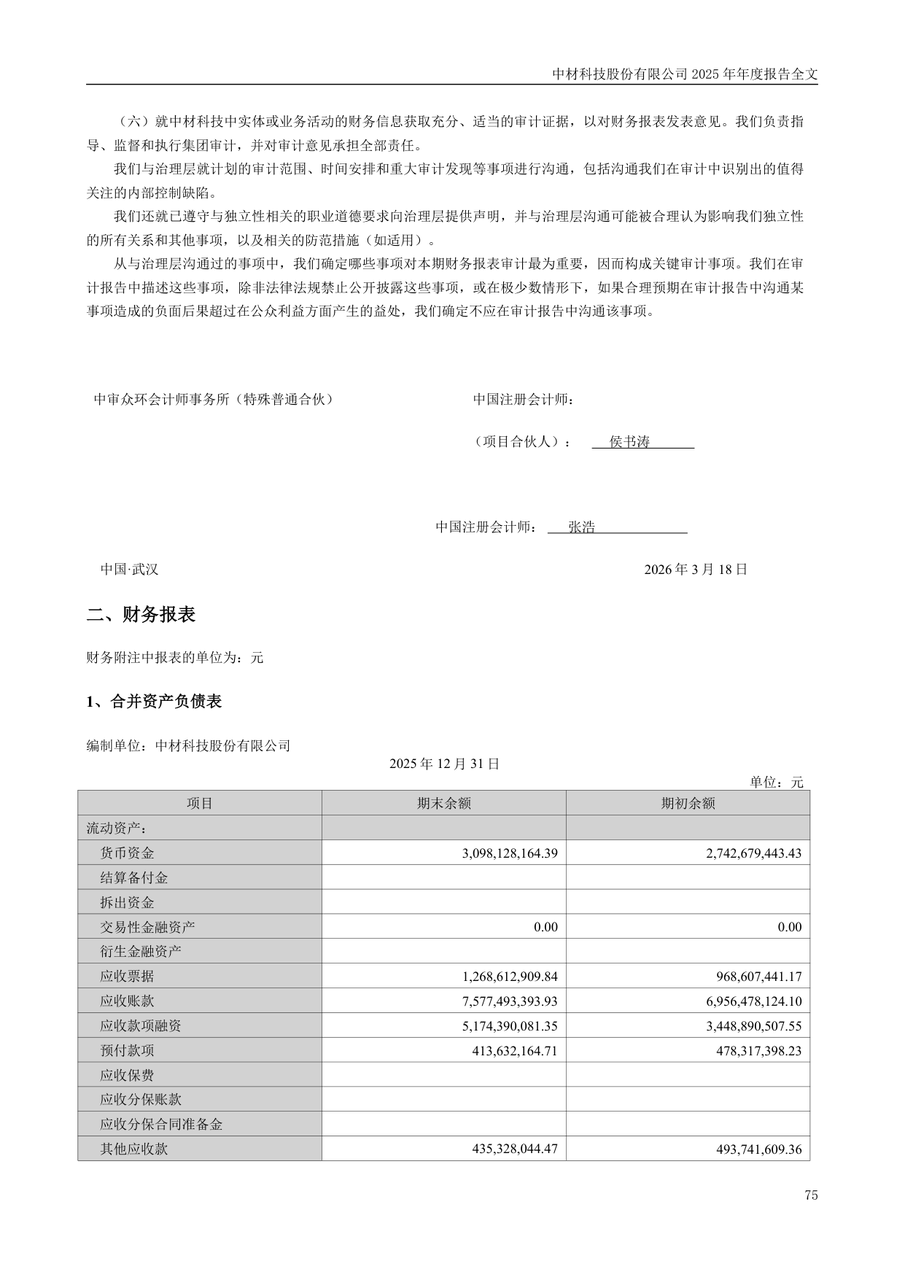
- 年报密表
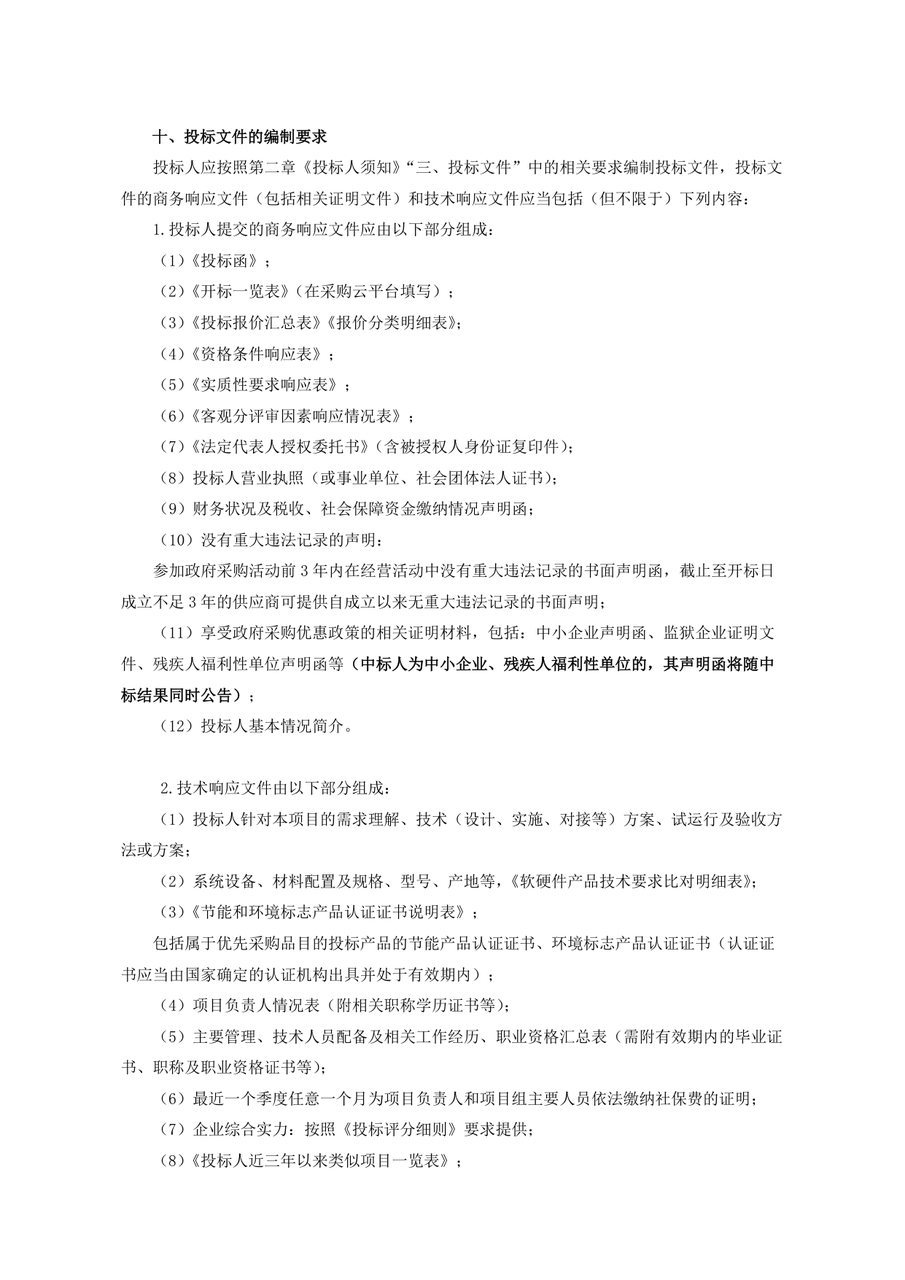
2. 评分细则表
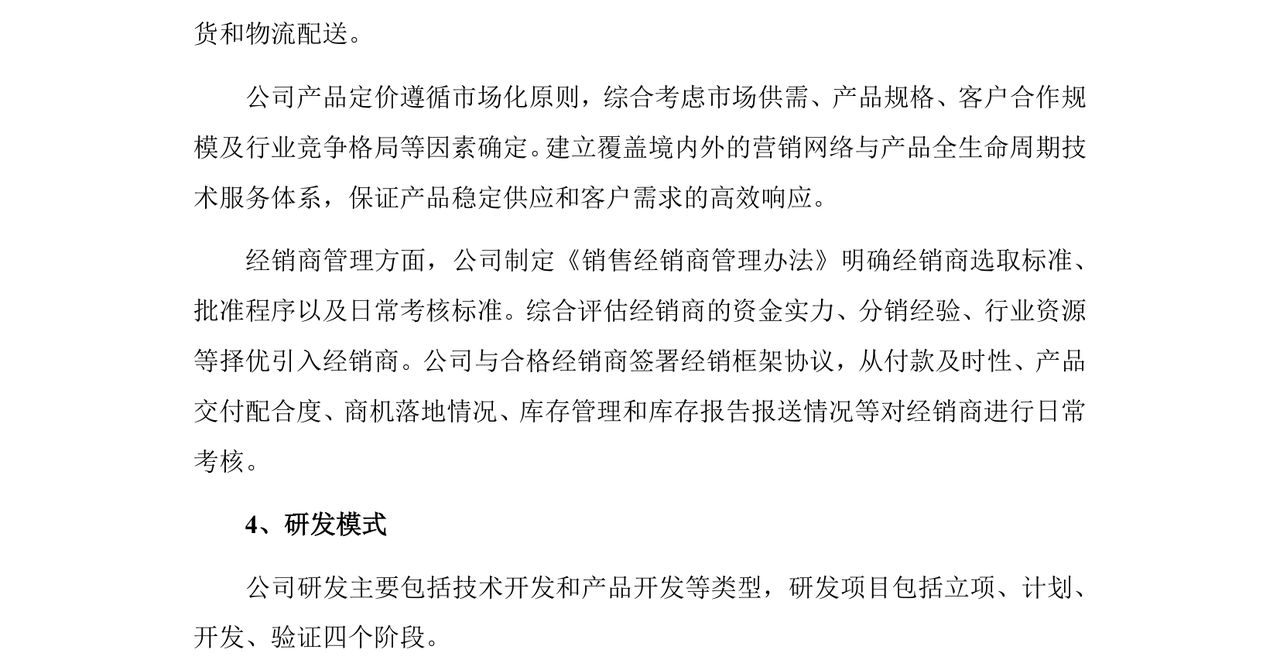
3. 招股书
4. 扫描件
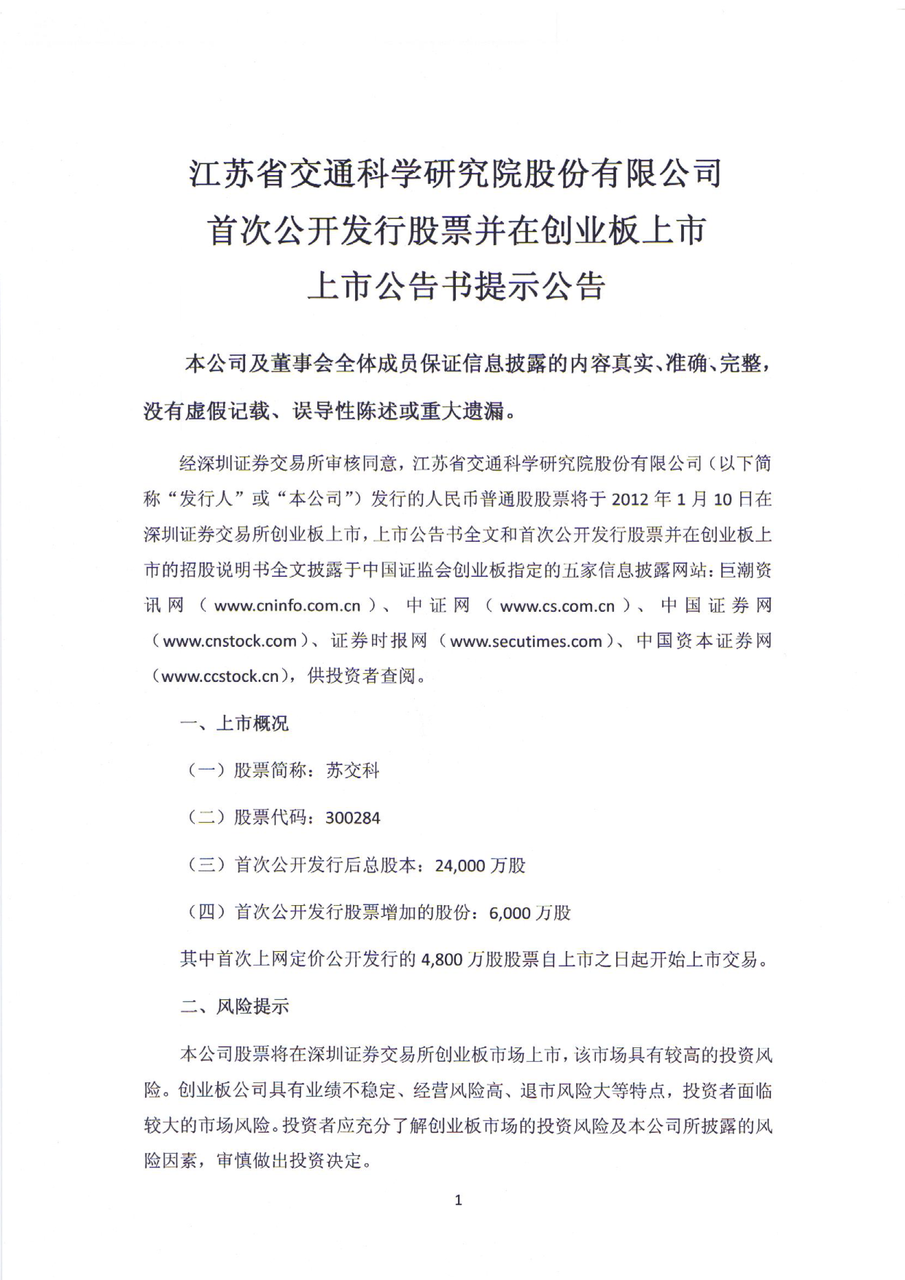
一份年报 200 页,财务报表一页接一页,续页连表头都不给你重复;一份招标文件,评分细则表里全是合并单元格,分值藏在格子里;招股书里塞着泳道流程图,关键信息全在图里;还有些老文档,干脆就是一张扫描图片,连文字层都没有。
这些文档喂给裸 LLM,到底会发生什么?我把好奇心落成了实验。
文档池,7 份,全部来自公开渠道,年报来自巨潮资讯,招标文件来自政府和高校官网,招股书来自上交所,扫描件是 2012 年的上市公告。每一份都截取了难点最集中的页段:
ID | 文档 | 页数 | 难点 |
|---|---|---|---|
T1 | 中材科技 2025 年报·三大报表 | 10 | 跨页表格、续页无表头、空值与零 |
T2 | 北京市政府采购招标示范文本 | 8 | 合并单元格评分表、勾选框、留白 |
T3 | 清华深圳国际研究生院招标文件 | 9 | 评分细则、符号标注 |
T4 | 上海市公安局招标文件 | 5 | 复杂评分细则 |
T5 | 长江存储招股书·经营模式章节 | 5 | 泳道流程图、图文混排 |
T6 | 长江存储招股书·三大报表 | 5 | 跨页财务表格 |
T7 | 苏交科 2012 上市公告 | 2 | 纯扫描,零文本层 |
两条链路,唯一变量是输入形态:
A 组(裸读): PDF → PyMuPDF 提取原生文本层 → LLM 回答
B 组(解析): PDF → xParse 解析成结构化 Markdown → 同一 LLM 回答
A 组走的是 LangChain 教程里最常见的那条路。B 组用的是 xParse,合合信息做了 20 年文档智能沉淀出来的解析服务,面向 LLM 和 Agent 的基础设施,支持 PDF、Office、图片等十几种格式,能识别 16 种内容元素,百页 PDF 最快 1.5 秒,解析结果直接输出 Markdown 和 JSON。
答题模型两边完全一致,都是干净上下文的 LLM,问题清单固定,谁也不许查外部资料,答不上来就必须承认。标准答案我单独从 PDF 文本层独立提取加交叉校验(比如资产总计必须等于流动资产合计加非流动资产合计,对不上就回去重查),不依赖任何一组的输出,避免既当运动员又当裁判。
另外我还加了个 A′ 组做辅助参照,把 PDF 渲染成图片让视觉模型逐页直读,模拟“多模态模型直接看文档”的路线,后面会讲到它的尴尬之处。
好了,直接开始实测,查看效果。
三、解析前 vs 解析后,先看原始画面对比
在讲答题成绩之前,先把两条链路“看到的东西”摆出来,这个对比比分数更直观。
第一张画面,T1 年报的跨页表格。
A 组(PyMuPDF 提取原生文本层)拿到的输入长这样,货币资金那一块:
项目
期末余额
期初余额
流动资产:
货币资金
3,098,128,164.39
2,742,679,443.43
结算备付金
拆出资金
交易性金融资产
0.00
0.00普通方式解析出来基本没有结构这一说法:
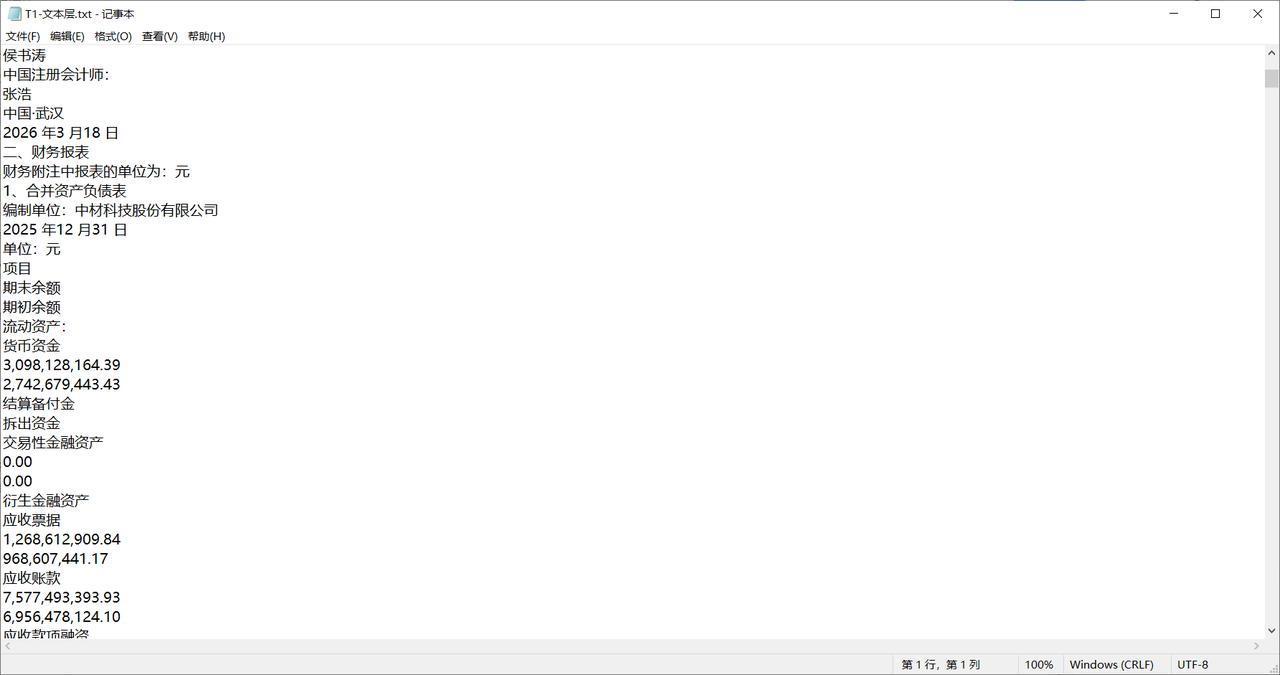
表格没了。科目和数字变成一锅线性文本,哪个数对应期末哪个对应期初,全靠数数。更阴险的是“结算备付金”“拆出资金”这种空科目,后面直接没有数字,一数错位,后面全错。而且这份报表有合并和母公司两套,科目名一模一样,只有数字不同,文本层里你根本分不清现在读的是哪套。
B 组(TextIn xP**arse解析**)的输入,同一个位置:
<table border="1"><tr>
<td>货币资金</td>
<td>3,098,128,164.39</td>
<td>2,742,679,443.43</td>
</tr><tr>
<td>结算备付金</td>
<td></td>
<td></td>
</tr><tr>
<td>交易性金融资产</td>
<td>0.00</td>
<td>0.00</td>
</tr></table>
三列关系明明白白,空值和 0.00 是两种不同的语义,前者是“没这个科目”,后者是“有,但为零”。整张资产负债表跨了 4 页,xParse 拆成 4 个连续的 table 块拼回来,行序连贯,中间还留着 <!-- 75 --> 到 <!-- 78 --> 的页码标记,每个数据在哪一页,可查。
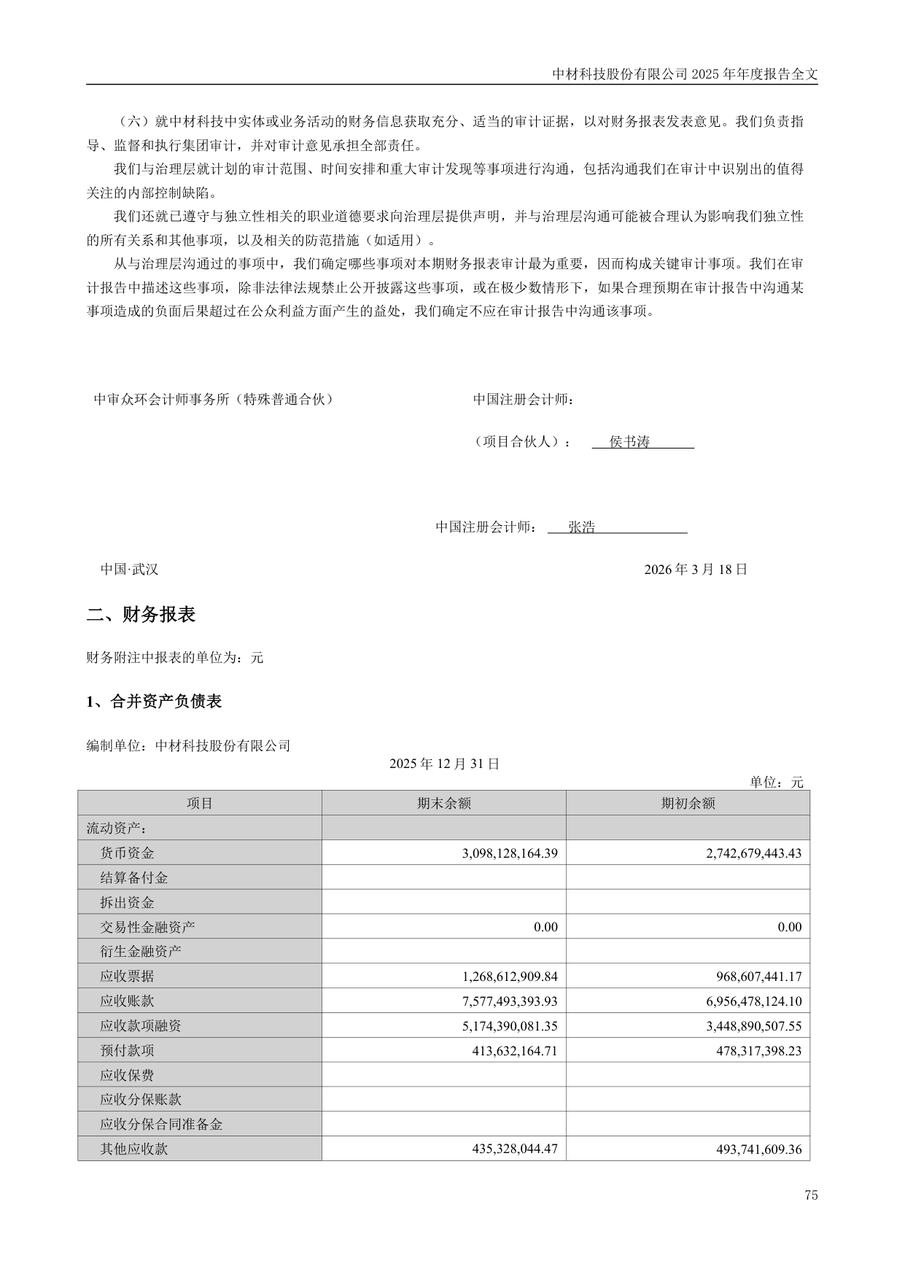
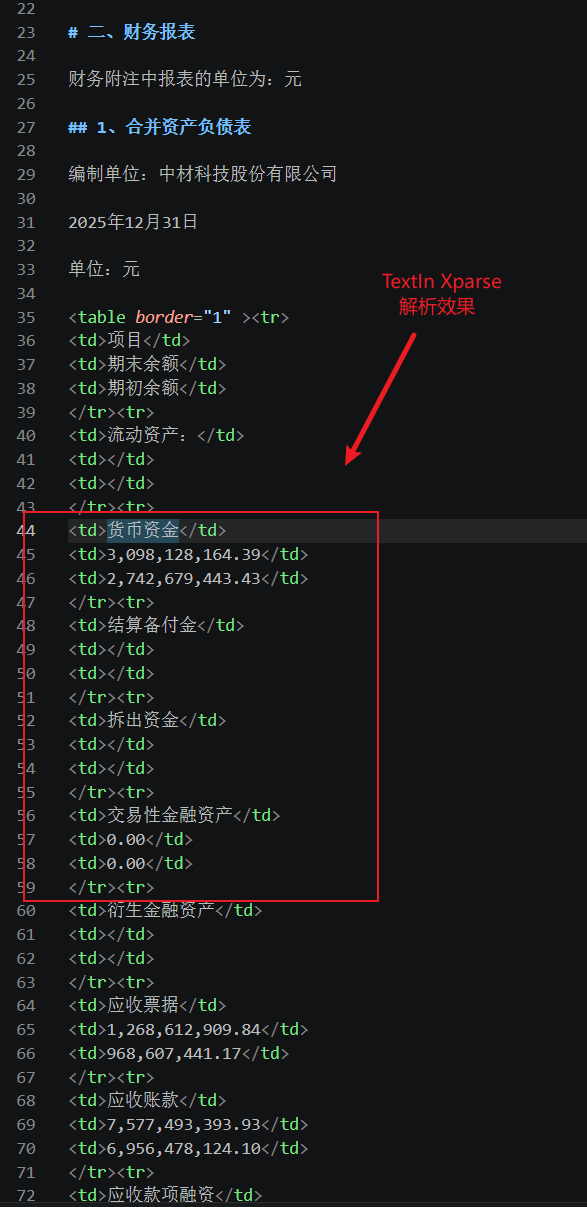
上面为 T1 跨页表格对比,上边 PDF 原件密表,下边 TextIn Xparse 的 table 输出,下面为导出md文件的效果,甚至页面分页这种结构都解析的非常清晰。
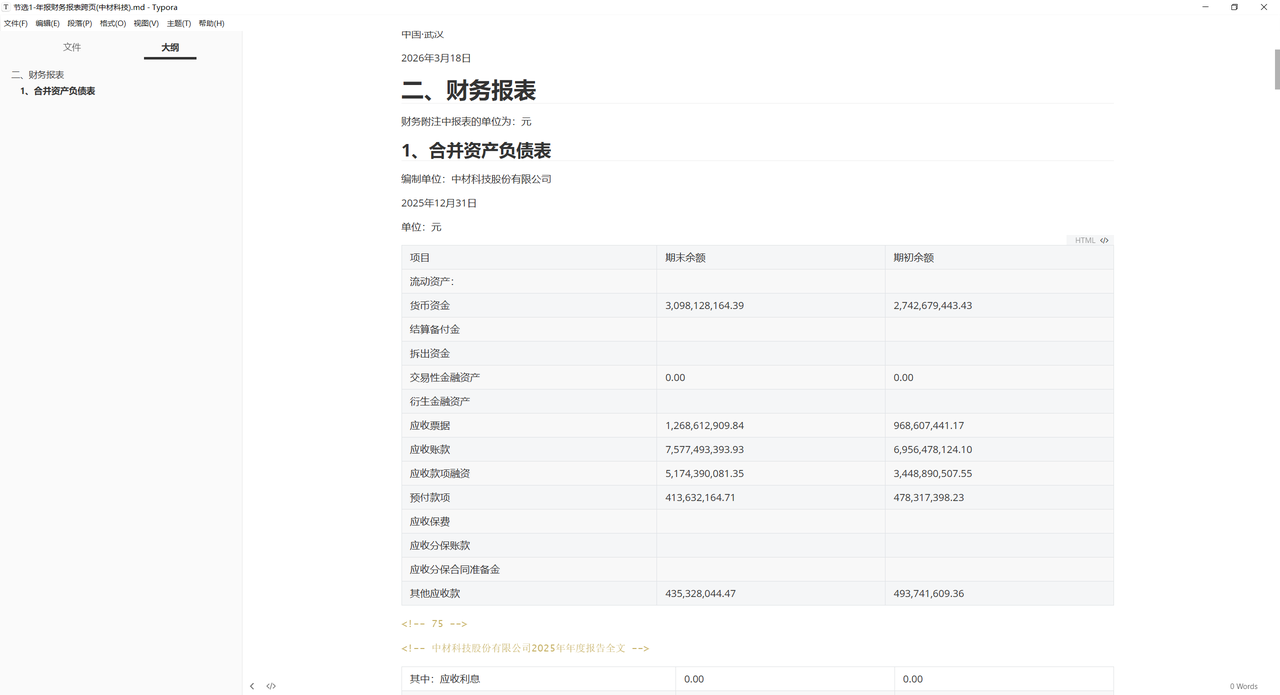
T1 跨页表格对比,左边 PDF 原件密表,右边 xParse 的 table 输出;能够明显看出来TextIn Xparse解析的内容结构非常清晰、干净,是一份非常适合 AI Agent开发 的结构化数据。
第二张画面,T5 招股书里的流程图。
长江存储招股书里有一张研发流程泳道图,研发阶段四个节点,量产阶段两个,上面挂着三个决策点,下面吊着四个 TR 交付节点。这种图对文本层提取是彻底的黑洞,一行都捞不到。A 组的输入里,这段就是一段正文加一片虚无。
xParse 的处理给了我一个惊喜,图作为图片元素保留,但图里的文字被单独 OCR 了出来,挂在图旁边:
<!-- 研发阶段 ←量产阶段→ 立项决策点 计划决策点 量产/可获得性决策点
(Charter) (PDCP) (ADCP) 立项阶段 计划阶段 开发阶段 产品验证阶段
可靠性验证阶段 量产阶段 产品需求及规格冻结 产品设计发布 产品设计冻结
产品量产准入 (TR1) (TR2) (TR3) (TR4) -->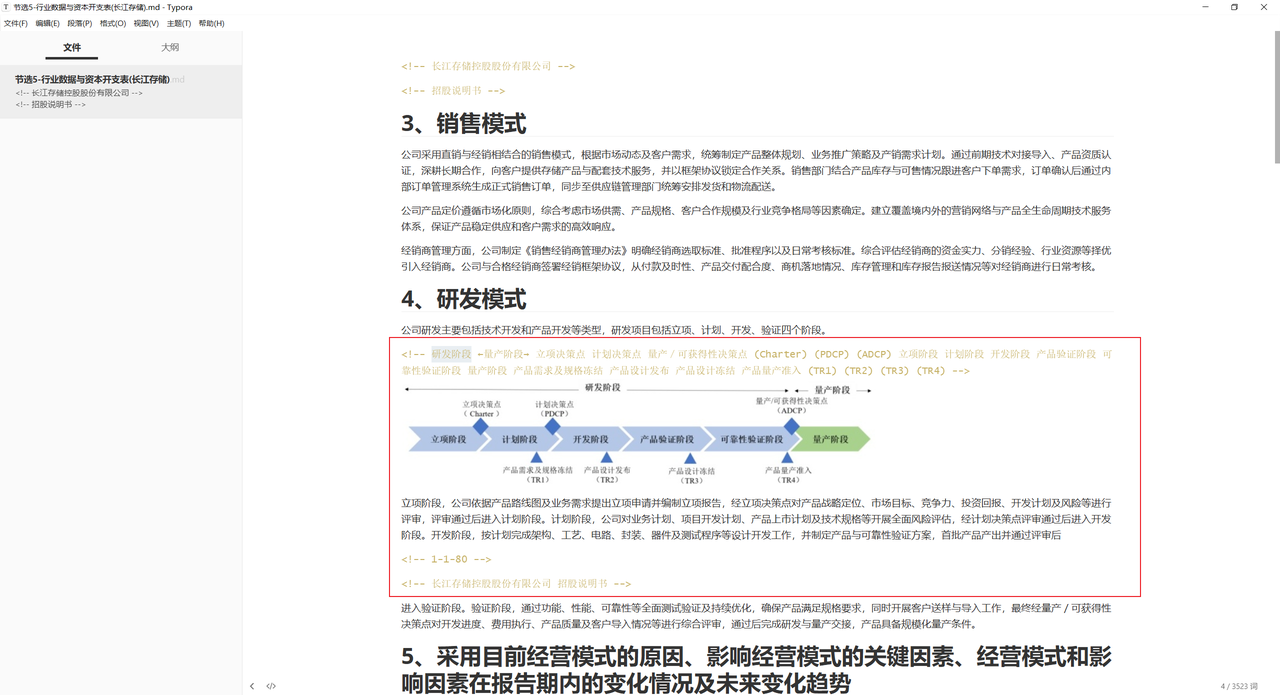
决策点编号 Charter、PDCP、ADCP,交付节点 TR1 到 TR4,全部可检索。图的拓扑关系还是要看图,但图里的信息不再是对模型隐身的。
第三张画面,T7,那份 2012 年的扫描件。
A 组从这 2 页 PDF 里提取到的全部文本,36 个字符。俩页码。正文一个字都没有,因为扫描件没有文本层,那是图片。
xParse 走 OCR 加多模态识别,整份公告全文识别出来,股票简称苏交科、代码 300284、发行后总股本 24,000 万股、五家信息披露网站的域名,一个不落,连落款的签章都作为图片单独提了出来。
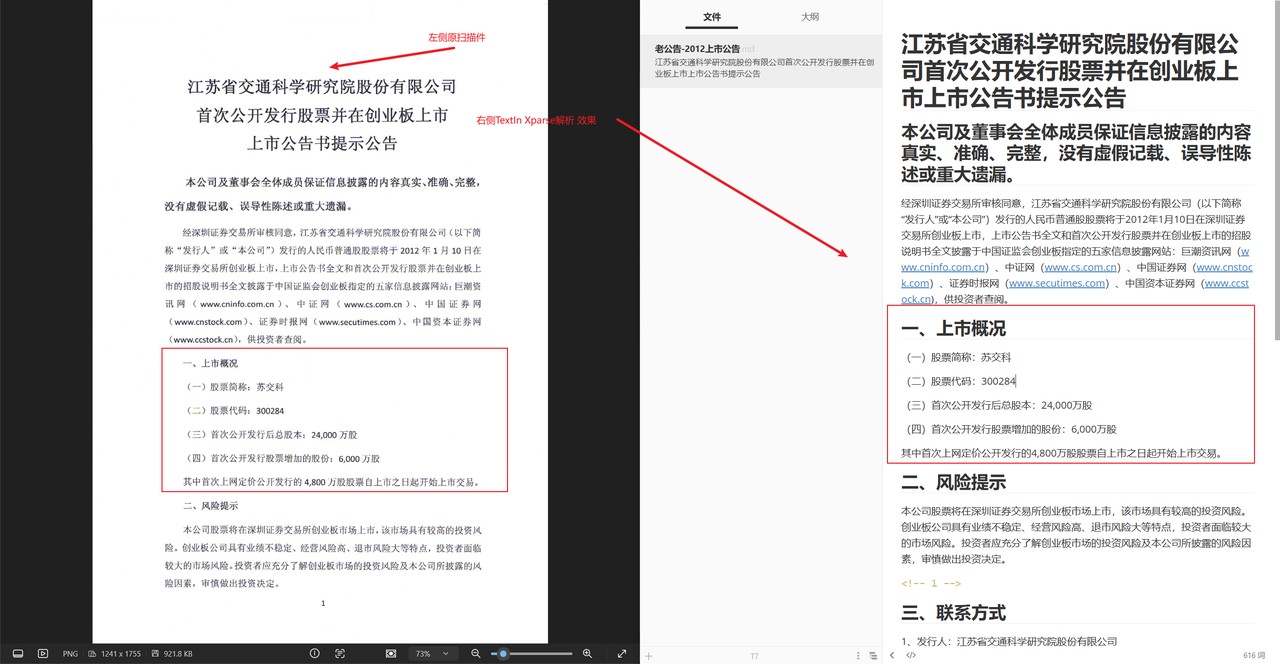
扫描件对比,原件扫描页 vs OCR 出的完整文本
同一个世界,两条链路看到的是两份完全不同的文档。这个前提下,再去比答题,结果其实已经有点注定了。
四、33 道题跑完,逐个单元看战报
每个单元 4 到 7 道固定问题,答案都能和原文逐字核对。按“翻车烈度”从低到高讲,一个一个来。
T6,长江存储三大报表,4 题两组全对。
数字题,科目和数字在文本层里是挨着的,裸读组仔细数数也能数对。xParse 组同样全对,顺手把资产负债表跨了 2 页、各科目在第几页都标了出来。这局平手,但注意,xParse 组的“对”是有结构保证的对,裸读组的“对”是小心翼翼数出来的对,前者敢写进报告,后者得复查三遍。
T1,中材科技年报三大报表,7 题两组全对,但这局有意思。
裸读组不但全对,还自己做了交叉验证,用资产总计等于负债加权益去验算。看起来很美?但它答题时明说了,科目与数字的对应是“按行序推断”的。这是在悬崖边上走对了路,不是路不悬崖。10 页之内运气好,换成 200 页全本、科目更密、合并与母公司报表混着来,这种推断迟早出事。
xParse 组同样全对,而且每道题都带着页码出处,第 75 页货币资金、第 76 页资产总计 65,590,977,996.41,可回溯,可抽查。
而且 xParse 组 非常清晰,定位位置非常精准,左边体现"小心翼翼数数",右边体现"带出处的底气"。
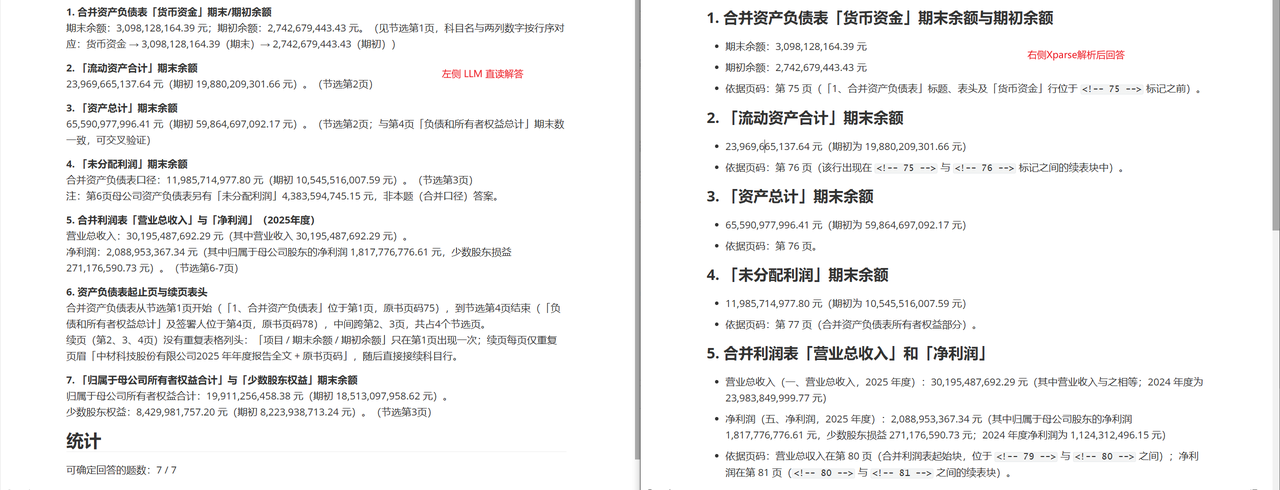
裸读组的推断式回答 vs xParse 组的带页码回答
T3,清华招标,两组都是 2/5,但成色不一样。
有两道题的答案确实不在节选页范围内,这怪我题目设计,两组同等受限,真正拉开质感的是另外的细节。裸读组的输入里,商务评价表“诚信评价”那一行的序号,文本层提取出来是 5,它靠“15+10+5=30”的合计校验才发现这数字不对,应该是 3,出现了单元格错位。xParse 组这边,60/30/10 的总分构成连同九个评分项的每一档分值完整还原,每一条还标着页码出处,评标方法在第 23 页、综合得分公式在第 28 页,想抽查随时一步到位。
T2,北京政采示范文本,2/5 平局,这锅得文档自己背。
我拿到手才知道,政府采购的“示范文本”是个空模板,评分因素是留白的,复选框是没有勾选的。两组都只能答出框架,答不出内容。平局,但这局证明了实验的另一面,输入里没有的信息,谁也变不出来,模型不背锅,解析也不背锅。
T4,上海公安招标,又是表格截断,但这次我验证了原因。
两组都只看到评分细则的前 4 项,分值上限加起来 44 分,离 100 分的标题差着 56 分。我专门翻回原 PDF 查了,第 28 页就是续表,硬件产品选型 14 分、实施方案 14 分……是我节选的时候在 27 页末切了一刀,两组同等挨刀,公平。xParse 组在这局把可见部分的细节抠得更干净,比如“软件系统设计 18 分”下面还分了三个 6 分的子项。
T5,长江存储经营模式,3/5 对 5/5,分水岭来了。
裸读组答出了研发四阶段,答出了销售模式和五项经销商考核,但在“决策点编号”和“TR 节点对应关系”两道题上彻底抓瞎,这些信息全在流程图里,文本层一个字都没有。
xParse 组,全对。Charter、PDCP、ADCP,产品需求及规格冻结对应 TR1、产品设计发布对应 TR2,全靠图旁边那块被保留下来的 OCR 文字。图文混排文档里,图内信息能不能捞出来,直接决定这题是送分题还是绝命题。
T7,苏交科扫描件,0/5 对 4/5,没有悬念的碾压。
裸读组,输入 36 个字符,五题全灭。不是它不会答,是它什么都没看见。
xParse 组效果优势明显,简称、代码、上市日期、股本、五家网站全对,一份 2012 年的纯图扫描件,OCR 加多模态硬是把整页文字捞了回来。
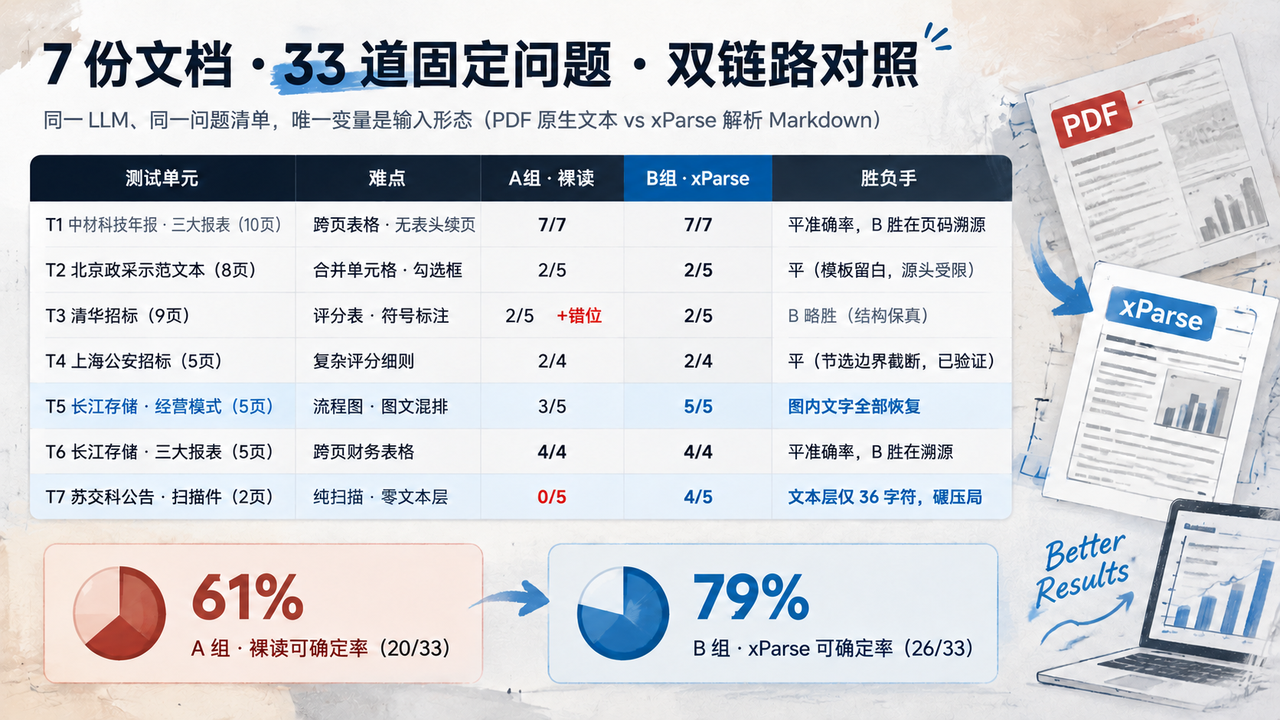
七组数据测完,裸读组 20/33 约 61%,xParse 组 26/33 约 79%。
数字摆在这,但我更想强调数字背后的两种失败。裸读组的失败是“看不见”,扫描件全灭、图内信息全丢,这是物理层面的无解。xParse 组的失败是“看不准”,个别字符、个别符号,这是工程层面可以继续磨的解。一个决定能不能答,一个影响答得多好,性质完全不同。
对了,还有 A′ 组,视觉模型逐页直读那条路。它单页能力其实不俗,密表数字逐字符识别全对,扫描件单页也读得干净。但它有个结构性尴尬,一次只能看一页。跨页的“资产总计”它看不见,得靠人翻页投喂;无表头的续页,列含义靠猜,它把“其中,应收利息”的父科目都猜错了。一份 200 页的年报等于 200 张图,token 成本先不说,这个投喂流程本身就是个新的体力活。单片视力好,没有全局结构感,这条路适合单页问答,不适合整档文档的工作流。
五、为什么 xParse 能做到,拆开看四个关键设计
同样是解析,差距为什么这么大。看了下 xParse 的技术资料,几个关键设计值得单独说。
第一,按页选解析链路。 电子件走原生解析,扫描件走 OCR,复杂视觉版面上多模态模型增强,不是一刀切。所以 T7 那种 2012 年的扫描件和 T1 那种 2026 年的电子件,走的是两条不同的路,各自最优。
第二,表格当结构还原,不当文字流。 版面识别还原行列关系,跨页表格拼接,合并单元格用 rowspan 语义保留。T5 招股书里那张工艺流程表,“晶圆制造”一个分类横跨 11 行、还跨了页,xParse 输出的 table 里,跨页后的续行首列为空、rowspan 延续,这要靠纯文本提取,神仙也还原不出来。
第三,保留位置和来源信息。 解析结果带页码、坐标,输出里那些 <!-- 76 --> 就是页码标记。这是“可追溯”的物理基础,答案能定位到页,质检、审计、回查才有抓手。企业场景里这条比准确率本身还值钱,不可追溯的数字,业务方是不敢用的。
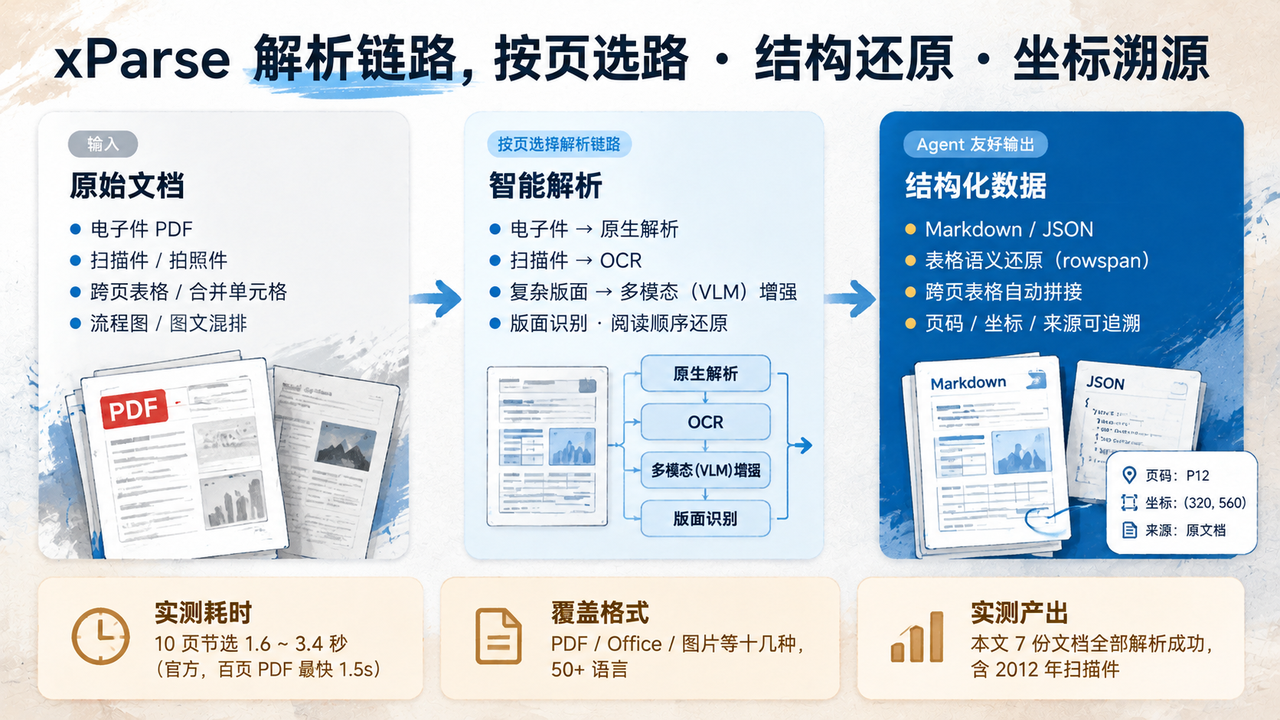
第四,Agent 友好的输出形态。 Markdown 加 JSON,LLM 直接消费,不用再写预处理。我这次全程用的是它的 CLI,一条命令的事:
# 解析 PDF,输出结构化 Markdown(自动走免费额度)
xparse-cli --profile workbuddy parse "节选1-年报财务报表跨页.pdf" \
  --api auto --output T1/
10 页的节选,解析用时 3.2 秒。
四个设计叠在一起,回答的其实是同一个问题,怎么让机器「看懂」一页纸的结构,而不只是「看到」一页纸的文字。实验里那些跨页表格、合并单元格、图内文字的胜局,不是撞大运,是这四层设计各司其职的结果。
六、解析之上,把企业文档变成 Agent 的共享记忆库
实验做到这,其实只回答了一半的问题。
解析把文档变成了干净的结构化数据,但企业里的真问题比“读一份文档”大得多。同一个客户,CRM 里叫 A 公司,合同里叫 A 有限公司,ERP 里是编码 C1024,AI 按字面匹配,三条记录一条都对不上。合同在法务的共享盘,订单在 ERP,交付通知躺在邮箱,每个 AI 应用各自建一套知识库,口径对不上,来源说不清。我在实验里撞到的“合并报表和母公司报表分不清”,就是这个问题最温和的版本。
这就是合合信息这次在 QCon 全球软件开发大会上发布的新东西要解的题,企业知识服务引擎。
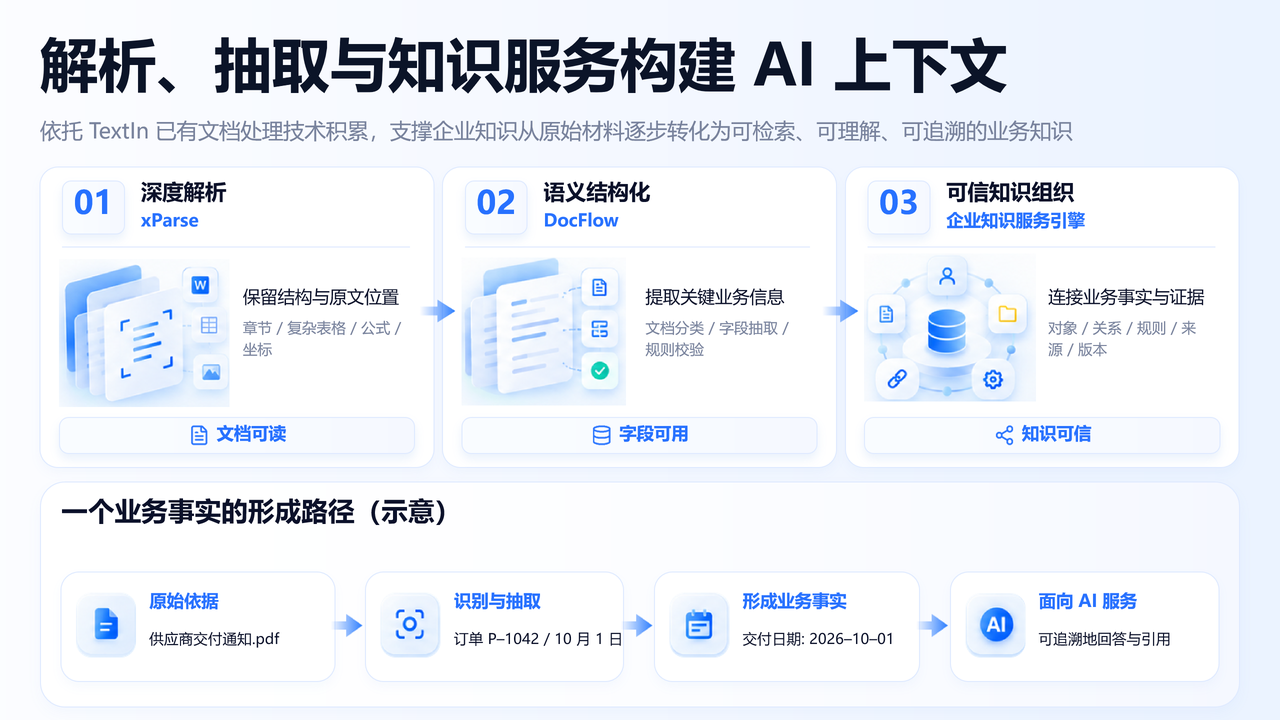
它的思路是把链路拉长,三层递进。TextIn xP**arse 做深度解析,让文档可读,保留结构、复杂内容和原文位置;DocFlow 做语义结构化**,面向混合文档包,拆套分类、字段抽取、规则校验、人工复核,让字段可用;知识服务引擎在这之上做可信知识组织,实体、关系、规则、版本、来源,让知识可信。一份供应商交付通知进来,最后变成的是一条能用的业务事实,订单 P-1042 预计 10 月 1 日到货,置信度 92%,原始邮件、时间、正文片段,整条证据链一路能点回原文。
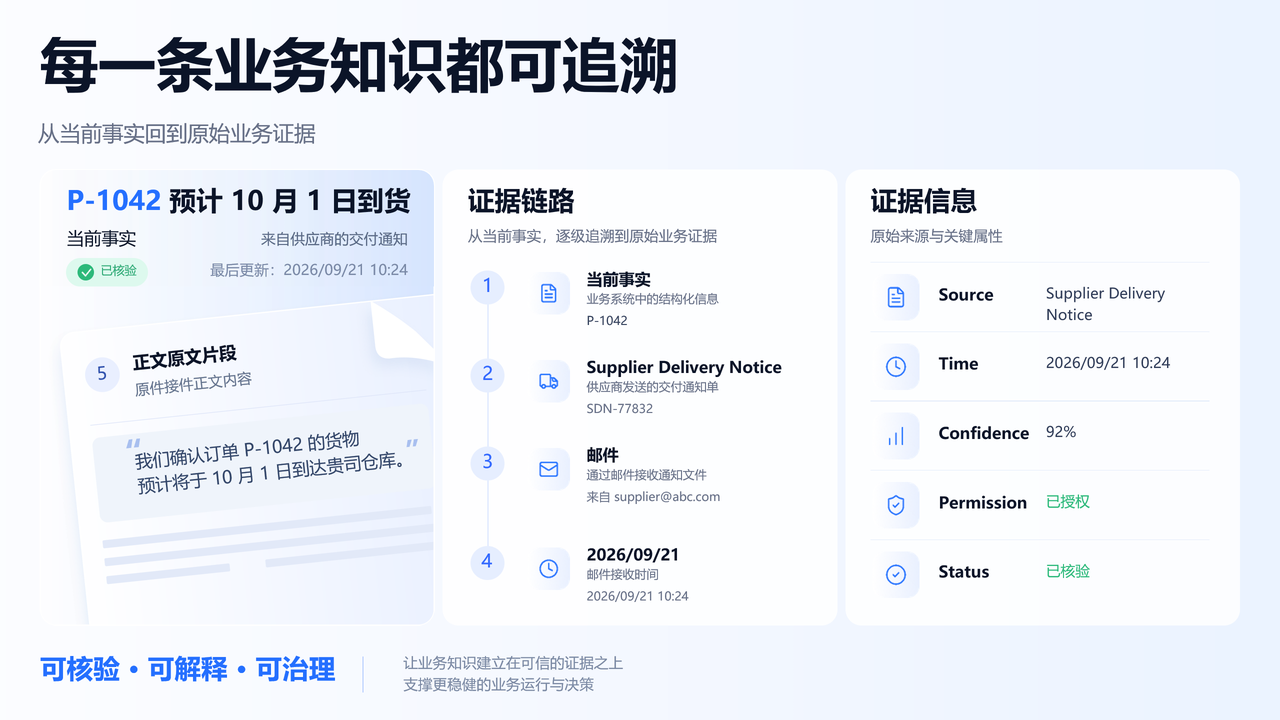
而且这套知识是共享的。一套知识底座,通过问答、API、MCP 协议、SDK 同时喂给多个 Agent,不用每个 AI 应用重建一遍知识库。合同问答、标书检查、金融风控、生产运营,四个场景读的是同一份知识,口径天然一致。发布会 PPT 里那个生产运营的例子我印象挺深,订单准备度 82%,物料缺口、产能冲突、风险预警,全是从订单、BOM、技术协议这些散落文档里攒出来的实时视图,而且每条结论背后都挂着 Evidence 按钮。
说真的,这和我实验里感受是连贯的。解析层解决的是“看得见、看得准”,知识服务引擎解决的是“记得住、说得清、查得到”。前者是后者的地基,没有高质量的解析,后面的知识组织就是沙上筑塔,这也是为什么这次 QCon 的发布,底层站的还是 xParse 这套磨了 20 年的文档能力。
企业知识服务引擎目前还没正式上线,已经开了预约试用,感兴趣的可以提交申请抢先体验。
预约入口,https://b.intsig.com/solution-apply?from=Qcon_20261022
写在最后
回到开头那个说法,Agent 的瓶颈不在智商,在视力。
这轮实验跑完,我基本被说服了,但想补一个更完整的版本。视力有两层,一层是能不能看见,扫描件、图内文字,这层裸模型暂时无解,解析层解决;另一层是看见了能不能拼成结构,跨页、合并单元格、层级归属,这层纯识别不够,要靠版面理解和结构化还原。
再往上一层,是看见并理解之后,这些信息能不能沉淀成组织里所有 Agent 都能持续调用的记忆。那是另一场更大的仗,刚刚在 QCon 上开场。
文末照例交代可复现性。7 份文档全部来自公开渠道,巨潮资讯、上交所、政府公开采购信息,问题清单、两组输入、原始答案文件我都留着,xParse 有每日免费解析额度,想自己跑一遍的朋友,一套脚本加一个下午就够。
有不同结论,欢迎来评论区打脸。
以上,既然看到这里了,如果觉得不错,随手点个赞、收藏、转发三连吧。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号