别再手动攒早报了:一条 Python 流水线,抓取 → AI 摘要 → 自动归档
原创
别再手动攒早报了:一条 Python 流水线,抓取 → AI 摘要 → 自动归档
原创
华东子
发布于 2026-10-24 18:55:51
发布于 2026-10-24 18:55:51
写给每周固定花半小时"刷源、复制、粘贴、排版"攒早报的你:这条流水线我拆成了五个单一职责的步骤,每步能单独验证,跑通之后整条交给 Agent 到点自动跑。代码全部实测可运行,复制就能用。
一、问题场景:攒早报是"隐形全职"
先交代背景。我之前每周要攒一份科技早报给同事看,流程是固定的:开五六个信息源,逐条扫标题,觉得有价值的复制下来,贴进文档,顺手写一句摘要,最后按日期存档。一顿操作,半小时起步。
这件事的问题不在于累,而在于它是"隐形全职":
- 纯重复。每周动作一模一样,没有任何创造性,但必须人盯着;
- 易断更。一出差、一加班就断,断了很难补,因为"上周攒到哪了"只有我知道;
- 不可增长。源从 5 个加到 10 个,时间是线性涨的,永远线性。
这类"每周固定动作、规则明确、结果要归档"的活,正是智能体工作流的经典猎物。本篇用一个真实例子,完整走一遍从手动到自动流水线的全过程。
二、解决方案:五步流水线,先拆后跑
核心思路一句话:把"攒早报"拆成 抓取 → 解析 → 去重 → 摘要 → 渲染归档 五步,每步一个函数、单一职责、可单独验证;全部跑通后,交给 Agent 定时执行。
2.1 全景图:每步的判定标准

flowchart LR
    A["① 抓取 fetch<br />本地文件/URL 逐源容错<br />判定:单源失败不影响全局"] --> B["② 解析 parse<br />RSS/XML 取标题/链接/摘要<br />判定:缺字段的条目丢弃"]
    B --> C["③ 去重 dedupe<br />标题归一化比对<br />判定:同名只留第一条"]
    C --> D["④ 摘要 summarize<br />有 Key 走 AI 无 Key 降级<br />判定:模式必须可见不静默"]
D --> E["⑤ 渲染归档 render<br />生成 Markdown 按日期存<br />判定:输出可复现"]注释(判定标准):五步各自独立——抓取坏了不影响解析,摘要挂了不影响归档。每步的"判定"就是它的自检点,哪步出问题一眼定位,不用回翻整条流水线。
2.2 完整代码(已实测跑通)
只用标准库,零第三方依赖,Python 3.9+ 直接跑(代码用了 list[dict]、tuple[str, str] 等内置泛型注解,3.8 及以下会在定义函数时报 TypeError):
"""
news_pipeline.py —— 科技早报自动流水线(示例代码,已实测可运行)
流程:抓取源 → 解析去重 → 摘要(AI 或本地降级)→ 渲染 Markdown → 按日期归档
依赖:仅 Python 标准库;AI 摘要需自备 OpenAI 兼容 API Key(可选,无则自动降级)
"""
import argparse
import datetime as dt
import json
import os
import re
import urllib.request
import xml.etree.ElementTree as ET
from pathlib import Path

DEFAULT_UA = "Mozilla/5.0 (compatible; NewsPipeline/1.0)"


# ---------- 1. 抓取:支持本地文件与 http(s) URL,逐源容错 ----------
def fetch_source(src: str) -> bytes:
    if src.startswith(("http://", "https://")):
        req = urllib.request.Request(src, headers={"User-Agent": DEFAULT_UA})
        with urllib.request.urlopen(req, timeout=15) as resp:
            return resp.read()
    return Path(src).read_bytes()  # 本地文件(离线/内网数据)


# ---------- 2. 解析:RSS 2.0 ----------
def parse_items(raw: bytes, source: str) -> list[dict]:
    root = ET.fromstring(raw)
    items = []
    for it in root.iter("item"):
        def text_of(tag):
            node = it.find(tag)
            return (node.text or "").strip() if node is not None else ""
        items.append({
            "title": text_of("title"),
            "link": text_of("link"),
            "pub": text_of("pubDate"),
            "desc": re.sub(r"<[^>]+>", "", text_of("description")),  # 去 HTML 标签
            "source": source,
        })
    return [i for i in items if i["title"]]


def dedupe(items: list[dict]) -> list[dict]:
    seen, out = set(), []
    for it in items:
        key = re.sub(r"\s+", "", it["title"])  # 标题归一化去重
        if key not in seen:
            seen.add(key)
            out.append(it)
    return out


# ---------- 3. 摘要:有 Key 走 AI,无 Key 本地降级(不静默) ----------
def ai_summarize(text: str, api_key: str, model: str) -> str:
    body = json.dumps({
        "model": model,
        "messages": [
            {"role": "system", "content": "用一句中文概括下面资讯的核心事实,不超过40字,不夸大。"},
            {"role": "user", "content": text},
        ],
        "temperature": 0.2,
    }).encode("utf-8")
    req = urllib.request.Request(
        "https://api.openai.com/v1/chat/completions",  # 换成你的 OpenAI 兼容端点
        data=body,
        headers={"Content-Type": "application/json", "Authorization": f"Bearer {api_key}"},
    )
    with urllib.request.urlopen(req, timeout=30) as resp:
        data = json.loads(resp.read().decode("utf-8"))
    return data["choices"][0]["message"]["content"].strip()


def fallback_summarize(text: str) -> str:
    sents = re.split(r"[。!?]", text)
    head = next((s for s in sents if s.strip()), "")
    return head[:80] if head else text[:80]


def summarize(item: dict, api_key: str, model: str) -> tuple[str, str]:
    if api_key:
        try:
            return ai_summarize(item["title"] + "。" + item["desc"], api_key, model), "ai"
        except Exception as e:
            print(f"  [warn] AI 摘要失败,本条降级:{e}")
    return fallback_summarize(item["desc"] or item["title"]), "local"


# ---------- 4. 渲染 + 5. 归档 ----------
def render(items: list[dict], summaries: list[tuple[str, str]], out_dir: Path, mode_note: str) -> Path:
    today = dt.date.today().isoformat()
    lines = [f"# 科技早报 {today}", "", f"> 生成方式:{mode_note}", ""]
    for it, (summary, mode) in zip(items, summaries):
        lines += [
            f"## {it['title']}",
            f"- 来源:{it['source']}",
            f"- 链接:{it['link']}",
            f"- 摘要({mode}):{summary}",
            "",
        ]
    out_dir.mkdir(parents=True, exist_ok=True)
    path = out_dir / f"科技早报-{today}.md"
    path.write_text("\n".join(lines), encoding="utf-8")
    return path


def main() -> int:
    ap = argparse.ArgumentParser()
    ap.add_argument("--sources", required=True, help="逗号分隔的本地 rss 文件或 URL")
    ap.add_argument("--out", default="archive")
    ap.add_argument("--top", type=int, default=10)
    ap.add_argument("--api-key", default=os.environ.get("OPENAI_API_KEY", ""))
    ap.add_argument("--model", default="gpt-4o-mini")
    args = ap.parse_args()

    all_items = []
    for src in args.sources.split(","):
        src = src.strip()
        if not src:
            continue
        try:
            raw = fetch_source(src)
            got = parse_items(raw, src)
            print(f"[ok] 源 {src}:抓到 {len(got)} 条")
            all_items += got
        except Exception as e:
            print(f"[fail] 源 {src} 失败:{e}")  # 不静默:坏源要可见

    items = dedupe(all_items)[: args.top]
    results = [summarize(it, args.api_key, args.model) for it in items]
    mode_note = "AI 摘要(OpenAI 兼容 API)" if args.api_key else "本地降级摘要(未配置 API Key)"
    path = render(items, results, Path(args.out), mode_note)

    print(f"[done] 去重后 {len(items)} 条,模式:{mode_note}")
    print(f"[done] 早报已归档:{path}")
    return 0


if __name__ == "__main__":
    raise SystemExit(main())
2.3 实测运行(真实输出,非示意图)
我用托管 Python 3.13 真跑了一遍。测试数据是一份演示样例 RSS(条目内容为虚构演示数据,标注在文件头,换成真实源 URL 即抓线上资讯):
$ python news_pipeline.py --sources sources/demo_a.rss --out archive
[ok] 源 sources/demo_a.rss:抓到 3 条
[done] 去重后 3 条,模式:本地降级摘要(未配置 API Key)
[done] 早报已归档:archive\科技早报-2026-10-17.md
生成的早报长这样(摘要模式、来源、链接一目了然):
# 科技早报 2026-10-17

> 生成方式:本地降级摘要(未配置 API Key)

## 示例:某开源框架发布 2.0 版本,启动速度提升明显
- 来源:sources/demo_a.rss
- 链接:https://example.com/demo-a/news/1
- 摘要(local):演示条目:该版本重构了底层加载逻辑,官方称冷启动时间缩短约四成,并新增了插件热重载能力
几处需要如实说明:
- 上面的运行在"本地降级模式"——测试环境没配 API Key,摘要走的是本地规则(取首句截断)。想要 AI 摘要,命令行加
--api-key sk-xxx(端点换成你的 OpenAI 兼容服务),代码里ai_summarize()就是干这个的,输出会标注摘要(ai)。我没法替你跑 AI 那半段,所以不贴它的输出——你想验证,填上自己的 Key 跑一次即可。另外,--model的默认值只是写作时可用的轻量型号,各服务商在售型号迭代较快,照抄前应按自己账号实际可用的型号调整。 - 坏源容错和去重我也实测了:故意加一个不存在的源,输出
[fail] 源 sources/not_exist.rss 失败:[Errno 2] No such file or directory: 'sources\\not_exist.rss',流水线继续跑完另外 3 条;两条同名标题的条目,去重后只剩 1 条。这两条路径的输出就是第四节踩坑的佐证。 - 解析层只识别 RSS 2.0 的
<item>节点:遇到 Atom 的<entry>或带命名空间的 feed,会一条都取不到。换真实源之前需先确认对方是 RSS 2.0,否则表现是静默的零条目,而非日志报错。 - 本文代码靠缩进定义语句块:从网页或笔记复制时缩进容易丢失,若粘贴后函数体顶格,需先按 Python 规则补回缩进再运行。这属于复制环节的问题,而非代码本身报错。
三、原理解析:为什么这么拆
1. 单一职责,是为了每步能单独"毙掉"。 攒早报这件事,手动做是一个整体,自动化必须拆开——因为每一步的失败模式完全不同:抓取可能超时、解析可能字段缺失、摘要可能接口挂、归档可能磁盘满。拆开后,哪步坏了一眼看出,换那一步就行,不用动整条。
2. 容错要"可见",不能"静默"。 坏源处理上我故意选了 [fail] 打印 + 继续,而不是 try 完装作没发生。静默失败是自动化第一大坑:某天 RSS 挂了,流水线"顺利"跑完生成一份空早报,你一周后才发现——那时已经断更一周了。宁可让流水线吵吵,也不要它安静地骗你。
3. 摘要层做"双模式",是因为依赖要分级。 AI 摘要是"增强项"不是"必需项":有 Key 用 AI,没 Key 本地规则兜底,而且降级必须在输出里标注(摘要(local) vs 摘要(ai))。这样即使 AI 服务挂了,早报照出,只是质量降一档——流水线的可用性不押在单一外部依赖上。
4. 脚本跑通,才是 Agent 接手的起点。 注意:流水线目前还是"你敲命令它跑"。要变成"到点自己跑",下一步才是把它派给智能体(Agent)——WorkBuddy 定时执行脚本、QClaw 早间触发,本质都是"把已验证的确定性步骤外包给自动调度"。步骤没验证就交给 Agent,等于让自动系统放大你的 bug。
四、一些重要提示
如果流水线出问题时,按这张决策树定位,别从头翻代码:
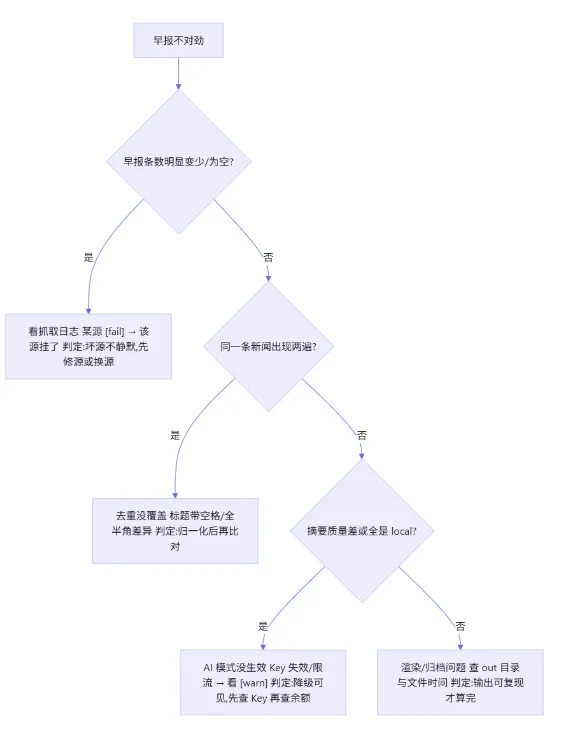
flowchart TD
    E["早报不对劲"] --> Q1{"早报条数明显变少/为空?"}
    Q1 -->|是| C1["看抓取日志<br />某源 [fail] → 该源挂了<br />判定:坏源不静默,先修源或换源"]
    Q1 -->|否| Q2{"同一条新闻出现两遍?"}
    Q2 -->|是| C2["去重没覆盖<br />标题带空格/全半角差异<br />判定:归一化后再比对"]
    Q2 -->|否| Q3{"摘要质量差或全是 local?"}
    Q3 -->|是| C3["AI 模式没生效<br />Key 失效/限流 → 看 [warn]<br />判定:降级可见,先查 Key 再查余额"]
Q3 -->|否| C4["渲染/归档问题<br />查 out 目录与文件时间<br />判定:输出可复现才算完"]注释(判定标准):每个症状先对应一个日志信号(
[fail]/[warn]/ 条数 / 摘要模式标记)——排错的入口永远是日志,不是猜。
这 5 个坑都是这次搭流水线实际踩到的,按踩到的顺序排:
- RSS 的 description 经常带 HTML 标签。 直接渲染进 Markdown 会花掉,甚至把
--sources这类内容冲乱。解法就一行:re.sub(r"<[^>]+>", "", desc),解析时就去干净。 - 抓取必须带 User-Agent 和超时。 不少源对裸
urllib请求直接 403;不设 timeout,某个源卡死会让整条流水线挂起。UA +timeout=15是底线配置。 - 不同源的条目会重复。 同一新闻多个源都转,早报里出现两遍很尴尬。按"归一化标题"去重(去空格后再比对),比按链接去重更稳——同一事件不同源的链接是不同的。
- AI 摘要失败不能让整条流水线崩。 接口超时、Key 失效、限流,任何一条都可能炸。所以
summarize()对单条 try/except:AI 挂了该条降级 + 打 warn,其他条目继续。粒度要细到"条",不是整批。 - 自动化的失败必须是"响的"。 这条最贵:交给 Agent 定时跑之后,人就不盯着了,静默失败 = 慢性断更。跑完必须给明确信号——控制台输出 + 归档文件生成时间,有条件再把"今日 N 条/失败 M 源"推到微信。宁可吵,不要骗。
跑通之后,这条流水线有三个自然的升级方向,顺序别搞反——先"自动跑",再"进知识库",最后"扩源":
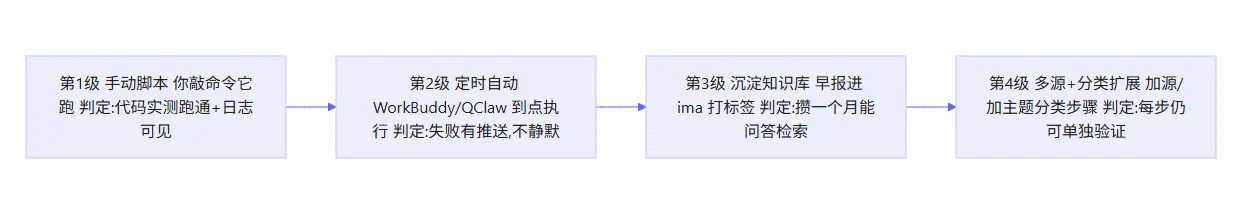
flowchart LR
    L1["第1级 手动脚本<br />你敲命令它跑<br />判定:代码实测跑通+日志可见"] --> L2["第2级 定时自动<br />WorkBuddy/QClaw 到点执行<br />判定:失败有推送,不静默"]
    L2 --> L3["第3级 沉淀知识库<br />早报进 ima 打标签<br />判定:攒一个月能问答检索"]
L3 --> L4["第4级 多源+分类扩展<br />加源/加主题分类步骤<br />判定:每步仍可单独验证"]注释(管控要求):升级顺序的硬规矩是每一步稳定跑至少一周再进下一步——脚本没跑熟就定时,等于让自动系统定时放大 bug。
- 定时自动:把脚本派给 WorkBuddy/QClaw(见 #3、#10 的自动化玩法),设每天早 8 点执行,实现真正的"到点自己跑";
- 沉淀知识库:早报生成后按 #12 的方法归入 ima 知识库打上 #科技资讯 标签,攒一个月就能"问"你这个月的动态——流水线输出的终点不该是文件夹,而是可检索的知识库;
- 多源扩展:
--sources本来就是逗号分隔的,加源只是改参数;进阶可以把"摘要后按主题分类"也做成一个步骤(先想清楚分类规则再拆,别一次加仨)。
披露声明(AI 辅助创作,含 AI 生成内容):本文由作者基于真实的流水线搭建过程撰写,使用 AI 工具辅助起草与润色;文中含 AI 生成内容,经作者审核修订。核心观点、代码设计与踩坑结论均由作者负责。示例代码已用 Python 3.13 实测运行,文中输出为真实运行结果;演示样例 RSS 的内容为虚构演示数据(已在样例文件头标注),AI 摘要模式需读者自备 API Key 运行。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号