向量搜索的「平均召回率达标」是个谎言:有的查询吃不上饭,有的在浪费算力
原创
向量搜索的「平均召回率达标」是个谎言:有的查询吃不上饭,有的在浪费算力
原创
用户10911842
发布于 2026-10-21 22:22:12
发布于 2026-10-21 22:22:12
向量搜索的「平均召回率达标」是个谎言:有的查询吃不上饭,有的在浪费算力
封面图
一句话版本:pgvector 这类向量数据库调到「平均召回率达标」时,不同查询的真实召回率可能一个 0.21 一个 0.99——CMU 的 RCheck 用轻量运行时系统按查询动态增减搜索力度,同等吞吐下平均召回提升 11–93%,多让 8–47% 的查询达标。 |
|---|
概念配图
平均召回率达标,掩盖了什么
现代数据库的向量相似度搜索靠近似最近邻(ANNS):HNSW 建多层图贪心游走,IVFFlat 先聚类再搜最近的几个桶。近似换性能,代价是召回率——该召回的真近邻漏掉了一部分。
运维的常规做法:把索引参数调到「平均召回率达标」(比如 0.85),同时尽量保吞吐。但 CMU 这篇论文指出了一个被忽视的事实:平均值达标,分布可以很宽。在 Twitter 数据 + GloVe 嵌入的 pgvector 实验里,整体平均召回 0.87(过了 0.85 的线),但按嵌入空间位置把查询分群后,有的群平均召回只有 0.21,有的高达 0.99——簇大小还差不多。
这种「查询间召回差异」两头都是损失:
· 低于目标的查询:用户拿到的是残次结果,体验和收入直接受伤;
· 高于目标的查询:花多余算力交付没必要的高质量,白白浪费吞吐。
而且作者验证了:换索引配置、换索引类型、换嵌入模型,这个差异都顽固存在。
RCheck:按查询动态调节搜索力度
思路说出来不复杂——难的查询多用力,容易的查询省着用——难点在于运行时怎么便宜地知道「这条查询处于低召回区还是高召回区」。
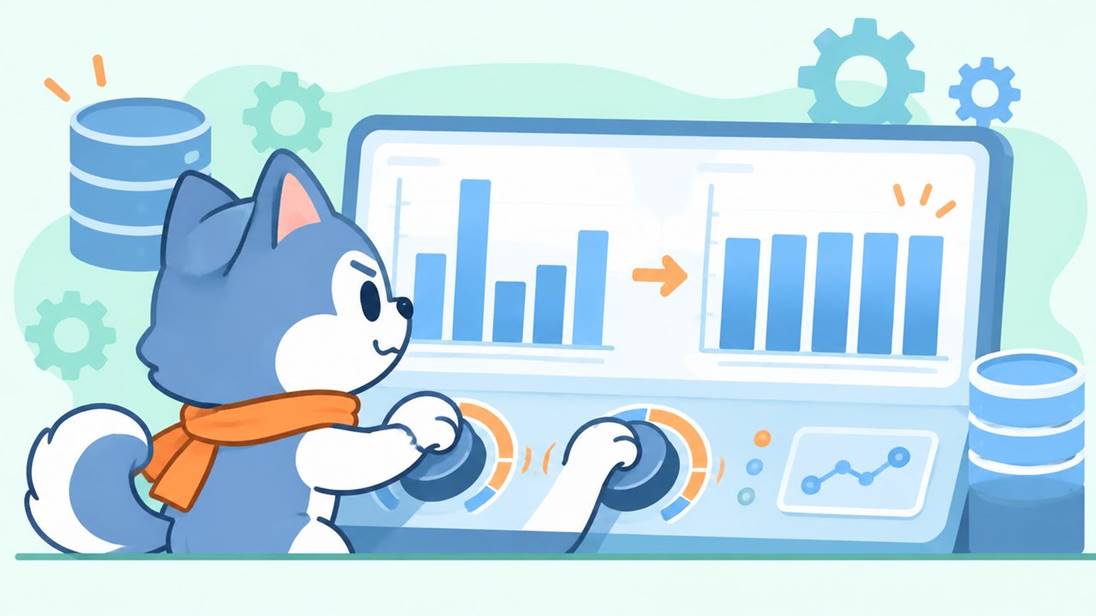
RCheck 的做法:离线用 k-means 把存量向量按嵌入空间位置聚成群(不动索引,只是逻辑分群),运行时把查询映射到群,就知道它落在哪个「召回画像」区域;再配合控制回路反馈,持续监控召回与性能指标,动态调搜索力度参数——HNSW 的 ef_search、IVFFlat 的 nprobes 这类现成旋钮:
· 落在低召回区的查询 → 调大搜索力度;
· 高召回区的查询 → 调小,把省下的算力匀给前者。
全程不改索引结构、不重建数据,纯运行时参数调节,即插即用。
概念配图
成绩:pgvector 上全面占优
用生产级 pgvector 跨多数据集、多索引类型评测:
对比口径 | RCheck 相对全局最优配置 |
|---|---|
同等目标召回 | 吞吐 +7–41% |
同等吞吐 | 平均召回 +11–93% |
达标查询占比 | +8–47 个百分点 |
对我们的启发
一、「平均值达标」不等于「人人都达标」,分布思维该进一切质量监控。 接口延迟、任务成功率、检索质量,凡是用均值设阈值的场景都值得问一句:分位数和分群画像长什么样?均值是报表的蜜糖,是分布的砒霜。
二、贵的判断离线做,便宜的调节在线做。 RCheck 的分群画像离线算好,运行时只做「查询→群」的轻量映射加参数微调。这个「离线重分析、在线轻决策」的分层,是性能敏感系统的通用设计模式。
三、好优化不换地基。 不改索引结构、不迁移数据,只把已有参数从「全局一刀切」变成「按画像分档」——迁移成本为零的优化才最容易在生产上活下来。
论文:Analyzing and Reducing Search Quality Differences in Vector Similarity Search(arXiv:2608.25185,CMU) |
|---|
BuddyMe 每日免费 4500 万 Token,把「监控—归因—调参」的循环交给会干活的伙伴。 |
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号