Milvus 3.0 聚合不准,不是 safe factor 小,而是候选不全
原创
Milvus 3.0 聚合不准,不是 safe factor 小,而是候选不全
原创
术哥
发布于 2026-10-19 20:16:52
发布于 2026-10-19 20:16:52
🚩 2026 年「术哥无界」系列实战文档 X 篇原创计划 第 208 篇,Milvus 最佳实战「2026」系列第 33 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
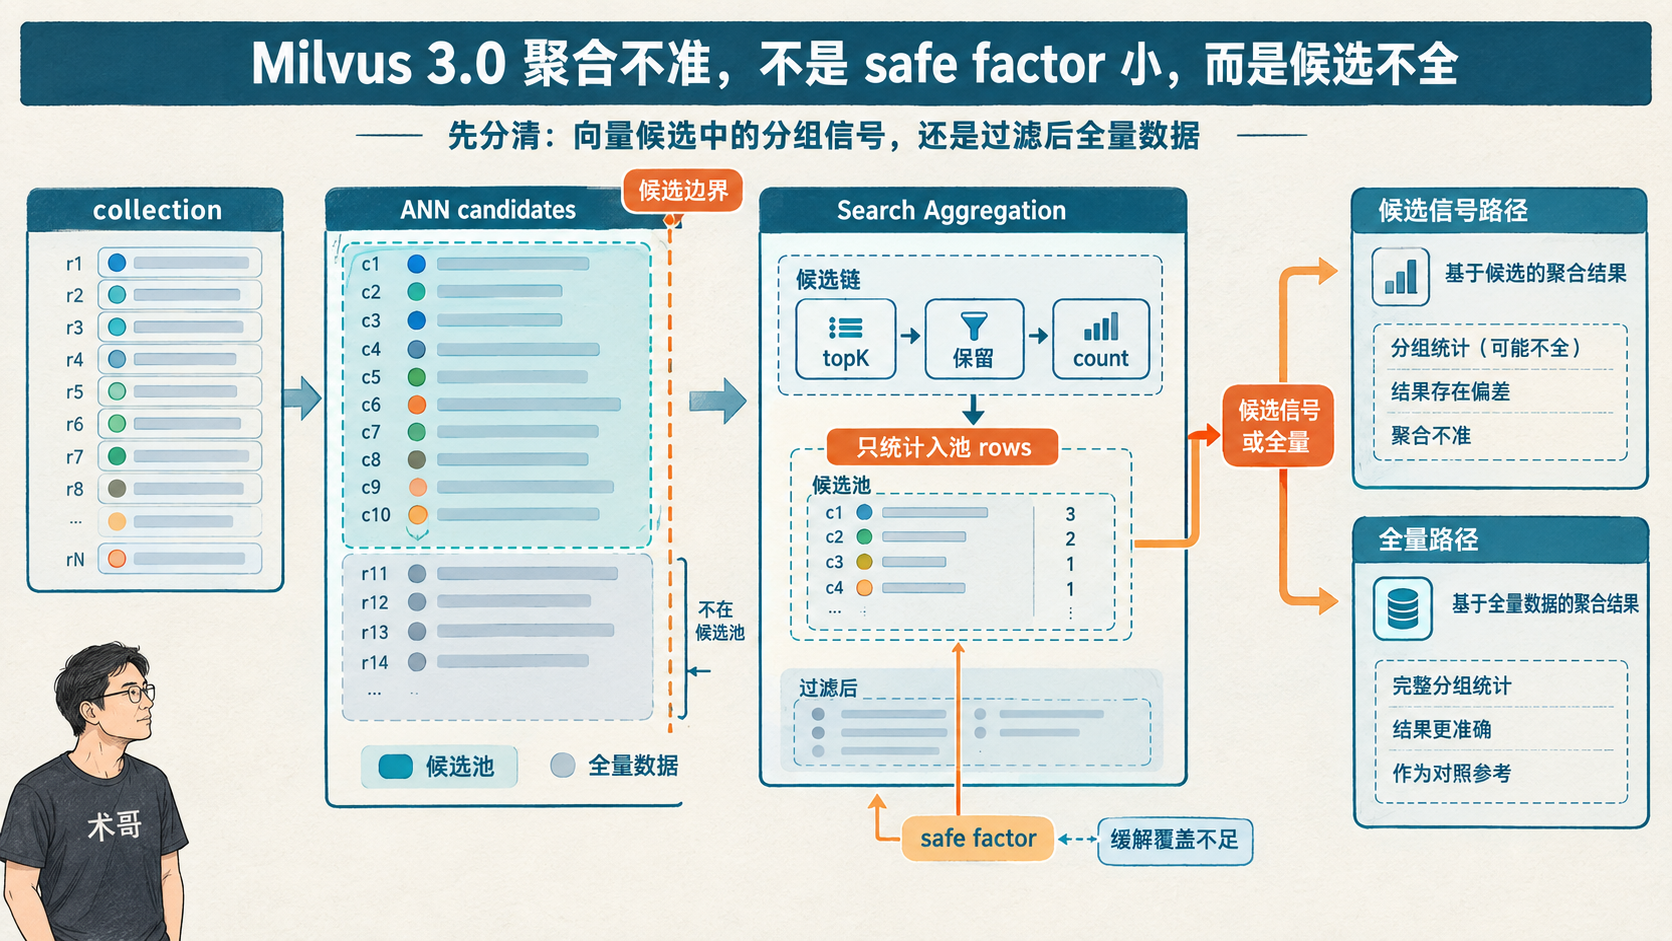
封面
在 Milvus 上做检索后分析,一个常见动作是按字段分组——比如按品牌统计每个品牌命中了多少。这时如果某个确定存在的品牌在结果里没有 bucket:不是 count: 0,而是它像从 collection 里消失了。
这时最容易把问题推给聚合:是不是漏算了?是不是某个参数没有生效?但 Milvus 的 Search Aggregation 的入口并不是一次全量 GROUP BY。它先接受 ANN 检索留下的 candidates,再在这批候选上分组、统计和排序。全量表里的数量,和这里的结果,从一开始就不是在数同一批数据。
要弄清楚结果为什么对不上,先把三个问题分开:一个 key 为什么会没有 bucket,count 和 metrics 到底在统计什么,以及当需求从“看候选里的分布”变成“拿到全量事实”时,应该换哪类路径。
01 先看不存在的 bucket
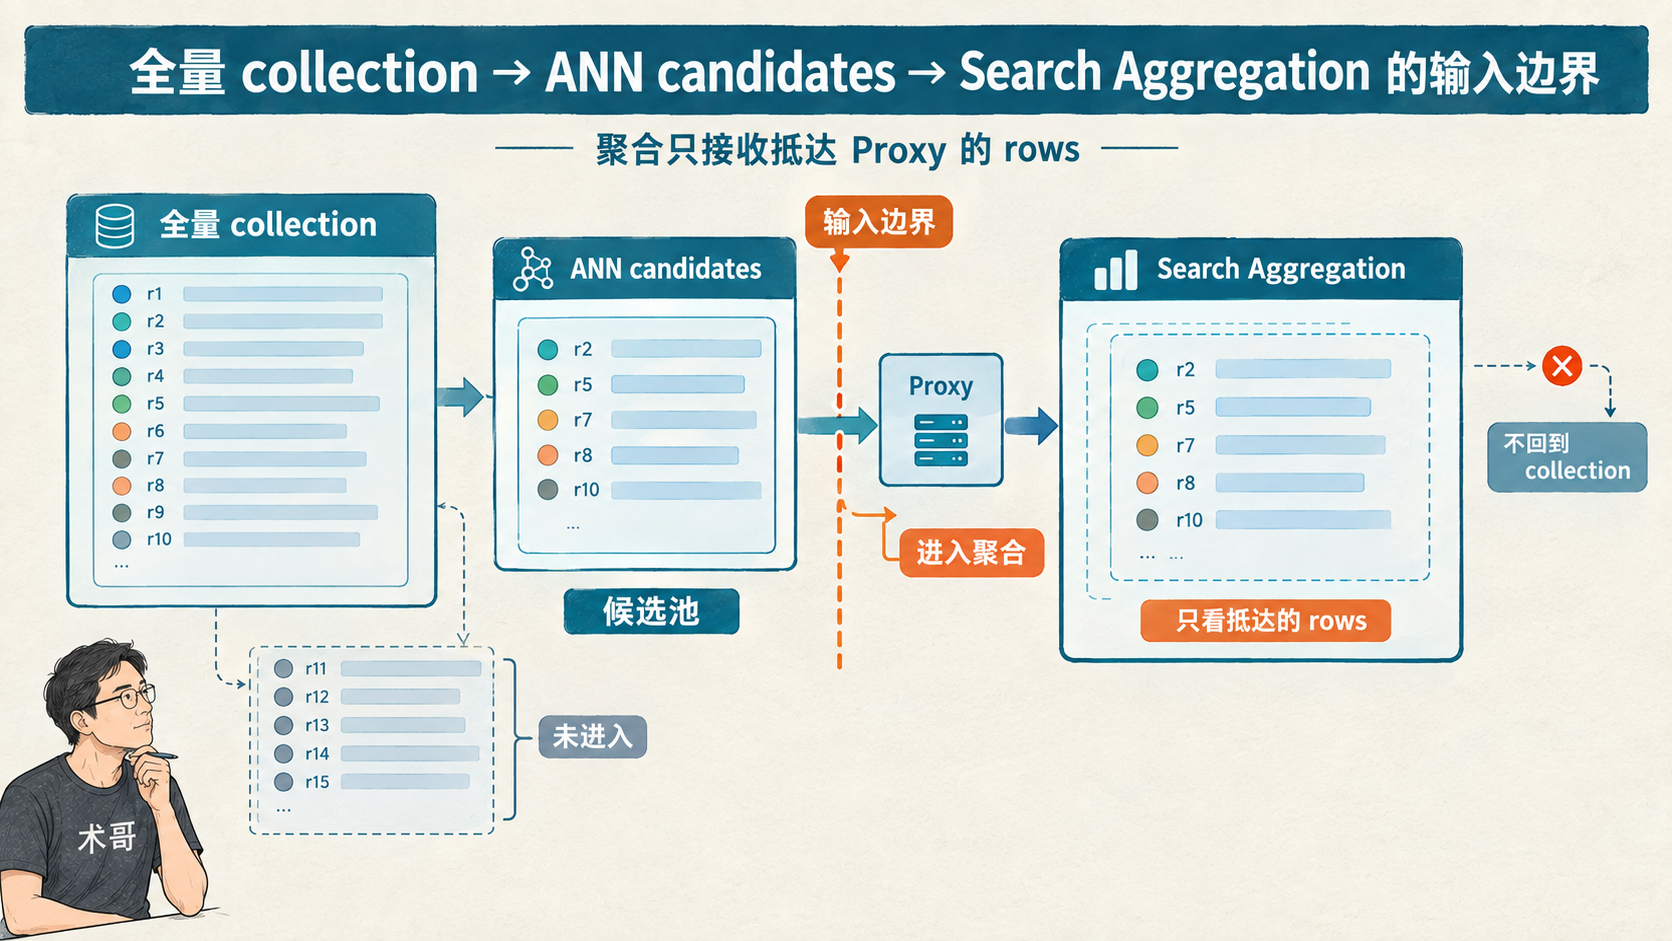
候选边界
普通数据库里的 GROUP BY brand,直觉很简单:把满足条件的行都看一遍,再把相同的 brand 合到一起。所以一个品牌没有返回时,我们会自然地想到两种可能:它的数量是零,或者实现漏算了。
Search Aggregation 的顺序不是这样。入口是向量搜索:先拿到与查询向量接近的 ANN candidates,再按字段把 candidates 组合成 bucket,最后计算并返回结果。Milvus 官方文档把这条链写成 Retrieve candidates、Build buckets、Calculate and return results。聚合发生在检索链路后半段,并没有绕过前面的 ANN 去扫描 collection。
Milvus 分组搜索文档给过一个很具体的后果:一个文档被切成很多 chunk 后,ANN 结果可能先塞进同一文档的多个段落,其他文档因此被忽略。分组之后,同一文档的多个段落被归到同一个 key 下,只占这一个 bucket 里的候选配额,其他文档的候选才有机会进结果;分组可以让返回结果更分散,却不能让没进 ANN 结果的实体突然出现。
Milvus 的标准过滤也没有改掉这个前提。它先过滤实体,再在过滤后的实体中执行 ANN,最后返回前 K 个实体。过滤缩小了搜索范围,却没有把后面的 ANN 变成对过滤结果的全量扫描。
Milvus 源码里的输入边界同样清楚。SearchAggregationComputer 接收的是已经跨 shard reduce 过的 SearchResultData,随后按层级分组、累加 metric、生成 top hits 和子聚合。它处理的是已经抵达 Proxy 的 rows;这个阶段没有回到 collection 补看遗漏行的路径。
bucket 的存在性本身就不保证精确。某个 key 的行如果从未进入 ANN retrieval pool,这个 key 就不可见;结果里没有它的 bucket,也不会出现一个 count: 0 的空桶。
02 候选预算决定你到底在数什么
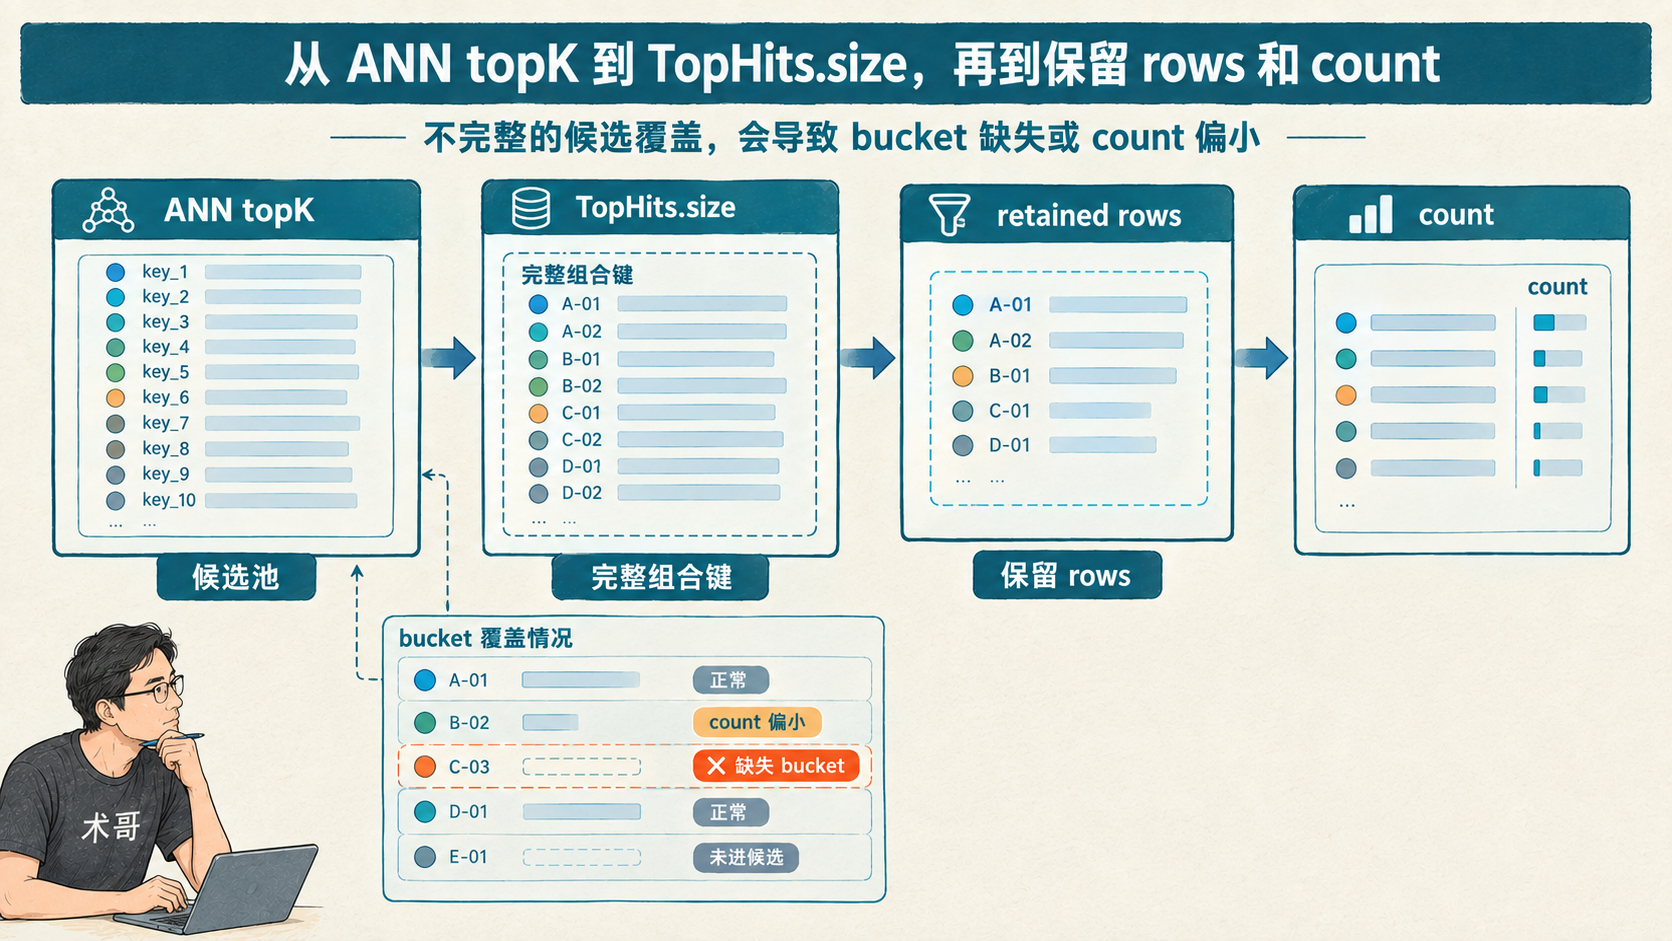
候选计数链
接受了“聚合只看候选”这个前提,接下来要分清几个经常被混在一起的量。
ANN topK 管的是检索入口:最初能进入链路的候选有多少,由它决定。进入聚合树之后,每个 full composite key 能保留多少候选,由整棵聚合树里最大的 TopHits.size 决定——候选预算按 key 给,不是每个 bucket 都固定拿到的保留数。一个管入口,一个管聚合树,不是同一个量。
经过分组和保留,真正送进计算的是 retained rows,返回的 count 与 metrics 都从这些 rows 算出来。如果没有任何 level 配置 top_hits——这里 level 指聚合请求里配置的聚合层级/分组层级——预算就退到下限 1:每个 full composite key 只保留一个候选行。默认配置下每个 key 的 count 只来自这一个保留行,反映的是候选信号,而不是这个 key 在 collection 里的真实行数;默认聚合的 count 可能因此很小。实际部署可能在某层配置了 top_hits 来放大这个预算;有没有配置、配多少,要按部署的配置核查。
为什么明明有这个品牌,统计却对不上?品牌的行可能没有进入 ANN 池,也可能进入了,却在后续候选竞争中没有被保留下来。调整 TopHits.size 只能影响已经进入链路的候选,不能把 collection 里从未进入 ANN 的行补进来。
sub_aggregation 会把同一套限制带到下一层。Milvus 在每个 parent bucket 内继续分组和计算,源码的递归入口就是把当前 bucket 的 bucket.rows 交给下一层 computeLevel。父桶拿到的 rows 如果已经不完整,子桶看到的也只能是这部分;Milvus 设计文档把这种逐层带下去的影响叫“偏差累积”。
嵌套结果沿着父桶留下来的 rows 继续往下算:父桶只保留了一部分候选,子聚合能分组和计数的,也只有这些 rows。
03 safe factor 只能把近似做得更稳
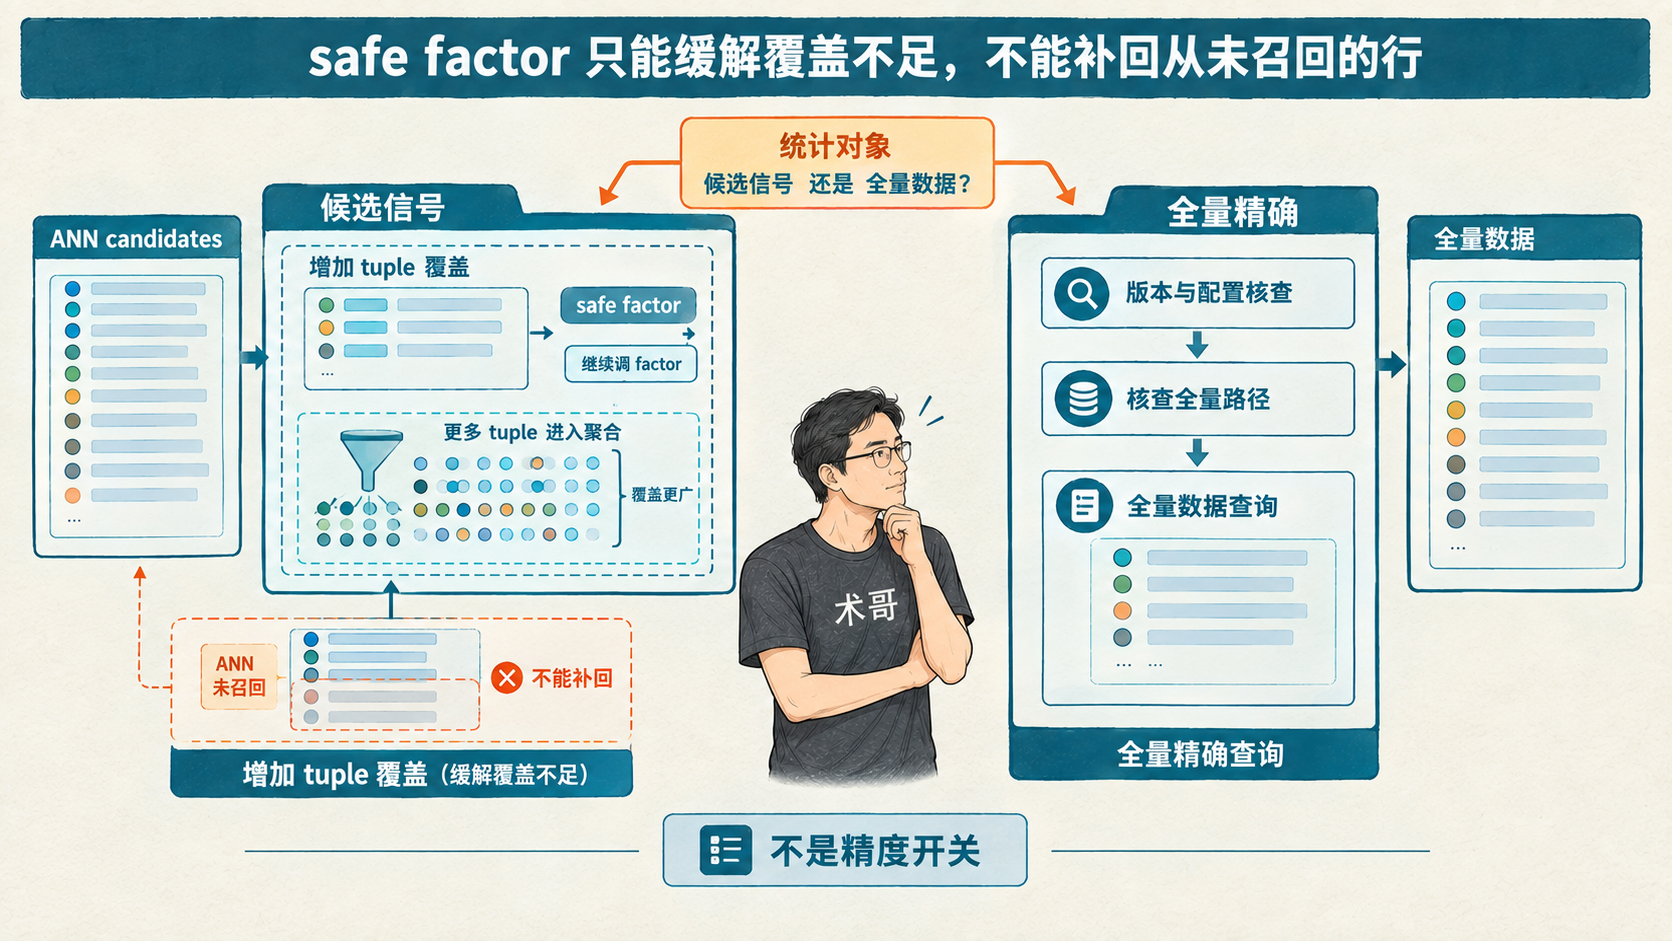
safe factor 与路径选择
Milvus 设计文档对 group_count_safe_factor 的定义,是让 Segcore 多取一些 composite-key tuples,再由 Proxy 做后续的 order 和 size 裁剪。小 bucket 不那么容易被大 bucket 挤出候选池,它针对的是 tuple coverage 不足或候选竞争造成的拥挤。这是设计材料描述的开关用途;这个键在你部署的发行版里是否真实存在,是版本核查要回答的问题(见第 04 节)。
但它没有改变统计对象。ANN 从未召回的行,safe factor 看不到;已经进入链路的 rows,也不会因为 factor 被放大就自动变成全量样本。它能扩大候选覆盖,不能把近似统计变成精确统计;和另一类 knob 一起使用,也只是降低近似误差发生的概率和严重程度。
这也解释了 factor 的适用边界:小 bucket 被大 bucket 挤掉时,放大它是合理的缓解手段;如果需求是全量 count、avg 或 sum,问题就回到了统计对象的选择上。
04 先选统计对象,再决定路径
这套边界不是 Proxy 的疏忽,而是分层取舍。Milvus 设计文档把职责切开:Segcore 做 flat composite-key group-by,QueryNode/Delegator 做跨 segment 的结果合并;metrics、ordering、nested levels 和树形结果由 Proxy 负责。Proxy 可以从 flat composite keys 重建更复杂的树,却只能用它收到的 rows 重建,不能凭空知道那些没穿过 ANN early-stop 的行。
所以,当前 Search Aggregation 回答的是“向量候选中的分组信号”。它适合看检索候选里的品牌或文档分组、代表性结果,以及推荐或 RAG 场景中的低延迟相对排序。这里的 count 和 metric,应当按候选信号理解,而不是按 collection 的全量事实理解。
如果需求是过滤后全量数据的真实数量,或者要给 BI、财务、运营报表提供可审计的 count、sum、avg,问题就已经换了:需要回到你 Milvus 部署的版本,核查另一条 query-side/scalar aggregation 路径。这里不把它写成已确认的 API。至少要核对过滤条件是否一致、字段和聚合函数是否支持、嵌套是否支持,以及最后的一致性语义。
版本核查的证据边界也在这一层:设计文档给 group_count_safe_factor 的默认值是 4,但它只是设计材料中的默认契约;本文核对的源码 commit 82bcce8867c92e7d55f669e034a00dcb0f37d2bc 中,configs/milvus.yaml 没有找到 group_count_safe_factor。这些研究材料不等于任何用户实例的运行版本;核查顺序是,先查你部署版本的配置文档或示例配置里有没有这个键,再确认默认值和是否由 feature flag 控制;研究材料的默认 4 和本文核对的 commit 都不能替你部署的版本回答。
决定路径之前,先把统计对象说清楚:你要的是向量检索留下的候选,还是满足过滤条件的全量数据?前者可以接受候选预算带来的近似;后者要的是满足过滤条件的全量事实。两种需求都叫“聚合”,对应的是系统里两条不同的路径。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号