Matt Pocock Skills 到底怎么选?先想清楚你缺哪个环节
原创
Matt Pocock Skills 到底怎么选?先想清楚你缺哪个环节
原创
术哥
发布于 2026-10-17 15:17:41
发布于 2026-10-17 15:17:41
🚩 2026 年「术哥无界」系列实战文档 X 篇原创计划 第 207 篇,AI 编程最佳实战「2026」系列第 73 篇
大家好,欢迎来到 术哥无界 | ShugeX | 运维有术。
我是术哥,一名专注于 AI 编程、AI 智能体、Agent Skills、MCP、云原生、AIOps、Milvus 向量数据库的技术实践者与开源布道者!
Talk is cheap, let's explore。无界探索,有术而行。
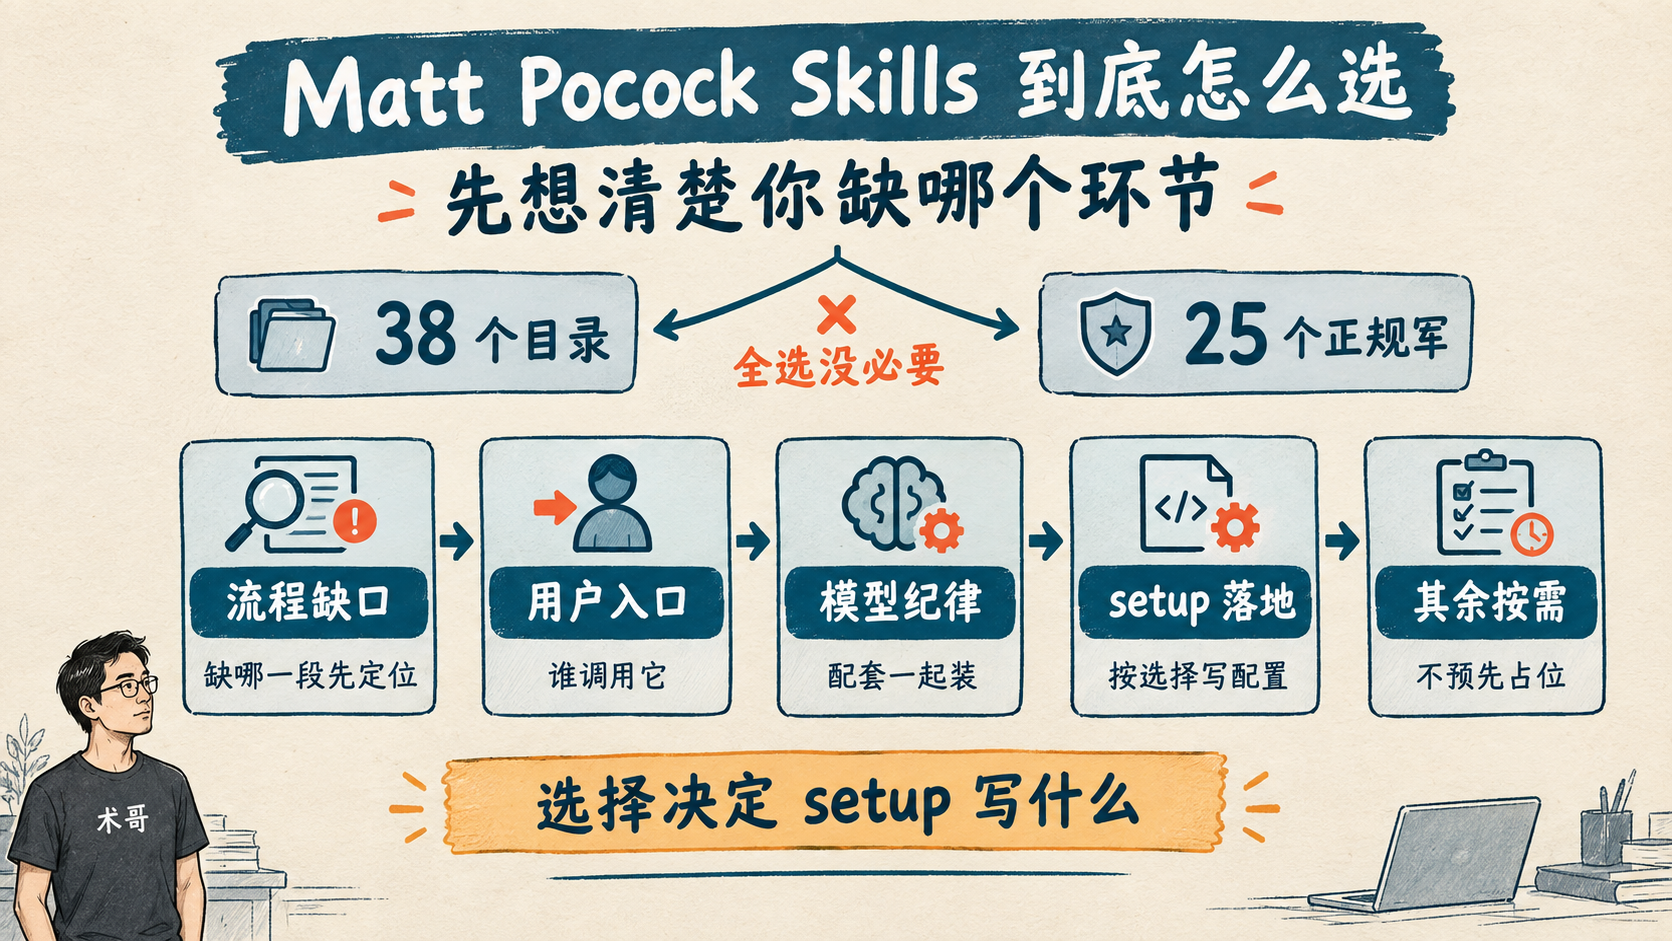
Matt Pocock Skills 选装判断路径
01 安装界面先别急着全选
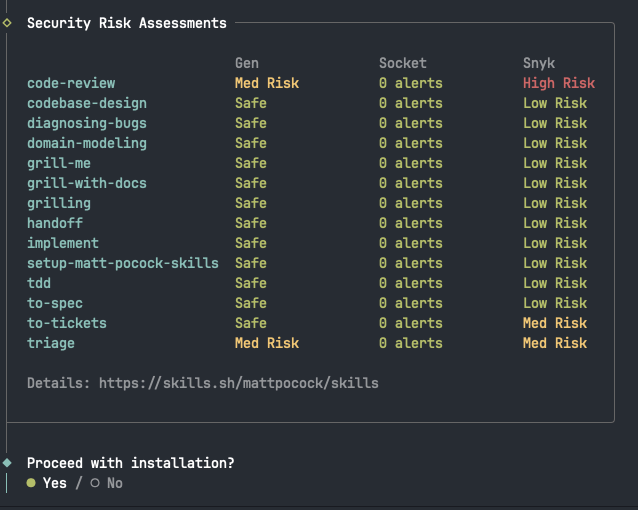
装 Matt Pocock 这套 skills 的时候,你会遇到一个选择界面:一堆技能名字列在那里,往下翻还有一块 Security Risk Assessments 区域,Gen、Socket、Snyk 三列,有的标风险。第一次见到的人通常有两种反应:要么全勾上,图个省心;要么被那几行风险提示吓住,开始怀疑这玩意儿安不安全。
sra
这两个反应都错了方向。我翻了这套技能的源码和文档,发现它的设计里藏着一个反直觉的事实:装哪些,不是按数量挑,而是选择本身会决定 setup(setup-matt-pocock-skills)为你写什么配置。你装了什么,决定了之后跑配置时它问你要什么、写什么文件;你缺了哪个环节,它就少给你配哪一块。
这篇文章把选择拆成三个维度讲:谁调用、主工作流闭环、setup 配置依赖。看完你能给自己一个判断顺序:先想清楚走哪条流程,再决定勾哪些,最后才轮到安全扫描那栏该怎么看。
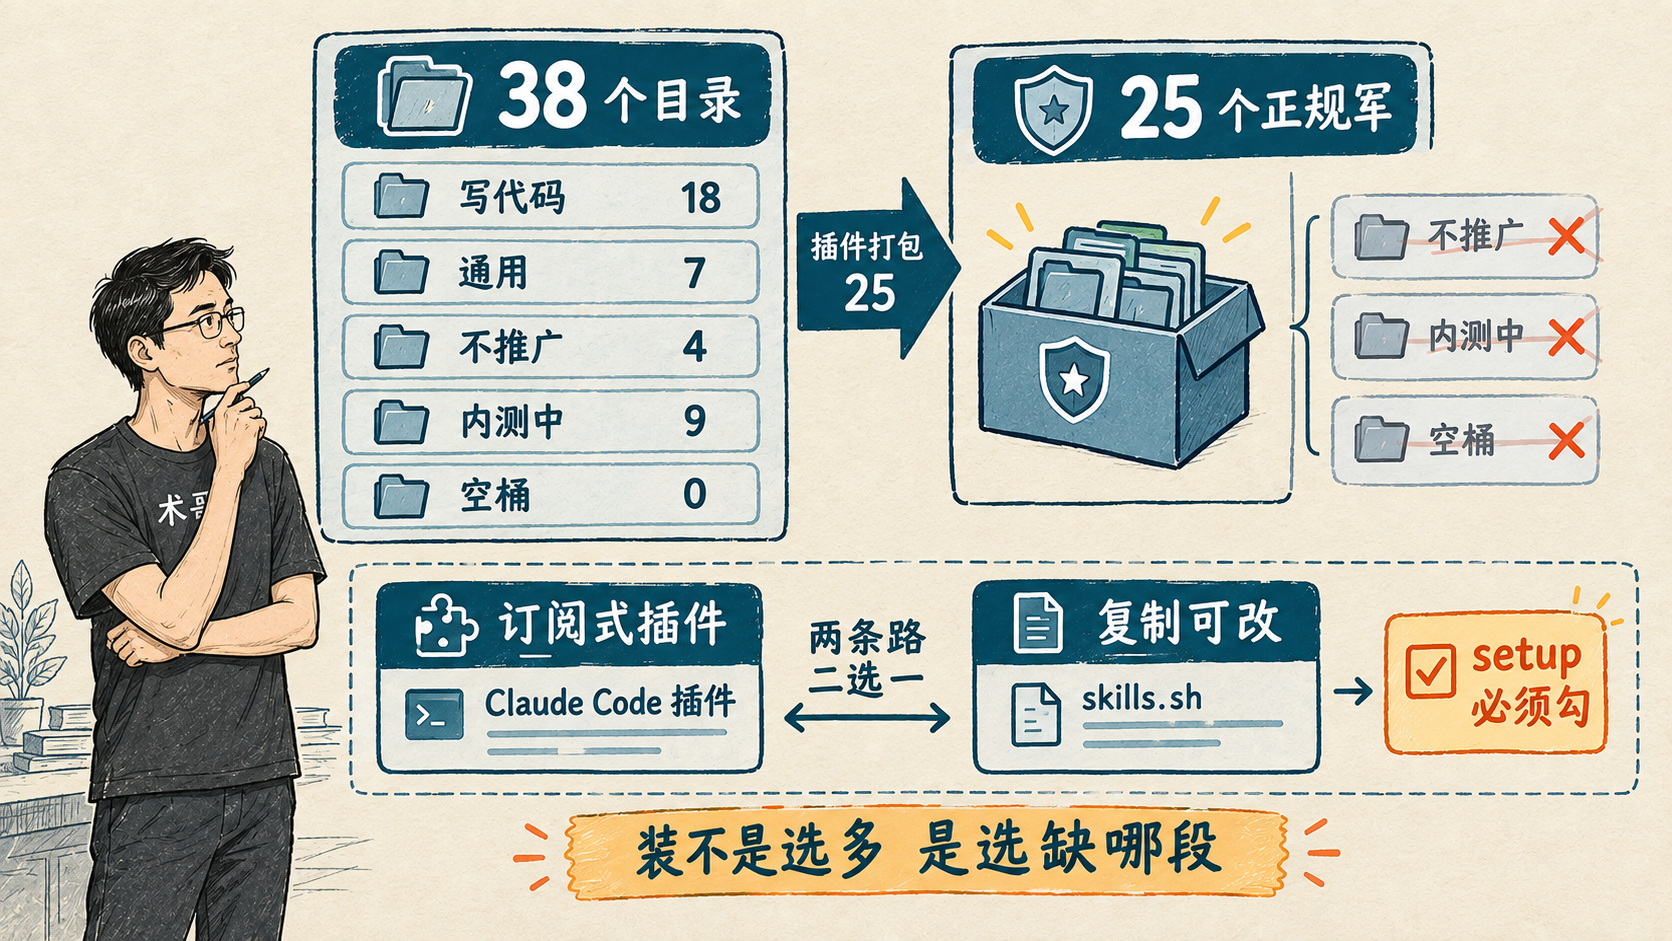
38 个技能与 25 个正规军的边界
02 先分清 38 个技能:25 个是插件主力
先把数量搞清楚。我核对了当前仓库的源码目录(v1.2.3,HEAD c55ee46),并且用安装器实测过一遍(skills.sh 1.7.0,沙箱环境,命令 npx skills@latest add mattpocock/skills),终端输出 Found 38 skills,和我数的目录完全一致:
桶 | 数量 | 定位 |
|---|---|---|
engineering/ | 18 | 日常写代码用的正式技能 |
productivity/ | 7 | 不针对代码的通用工作流 |
misc/ | 4 | README 自述 "not promoted in the plugin",不推广 |
in-progress/ | 9 | beta,README 明确 "excluded from the plugin…can change or disappear without warning" |
deprecated/ | 0 | 空桶 |
一共 38 个 skill 目录。但注意:Claude Code 插件只打包前两桶,.claude-plugin/plugin.json 里正好 25 个。也就是说「正规军」是 25 个,misc 和 in-progress 是作者自己留着、不主动推给你的东西。不需要全选,也根本不建议全选。
再说安装方式,两条路二选一,README 和官方安装块都写了同一句话:装双份 = 每个技能出现两次。
方式 | 命令(按文档原样) | 哲学 |
|---|---|---|
Claude Code 插件 |
| 订阅制:托管、只读、作者发版自动更新 |
skills.sh 复制 |
| 复制进你的仓库,文件归你,可随便改, |
两条路选一条。Codex 和其他 agent 没有官方插件(README 注明原生 Codex plugin 在 roadmap 上),所以基本就是走 skills.sh 这条。无论选哪条,README 都特别强调:安装器让你挑技能的时候,setup-matt-pocock-skills 必须勾上,它是整套工程技能的前置。
至于安装时那张 Security Risk Assessments 三列界面(见本期配图),它出现在选择技能的环节;怎么读,第 07 节专门讲。
User-invoked 与 Model-invoked 的依赖链
03 维度一:先看谁调用,入口和纪律要配套
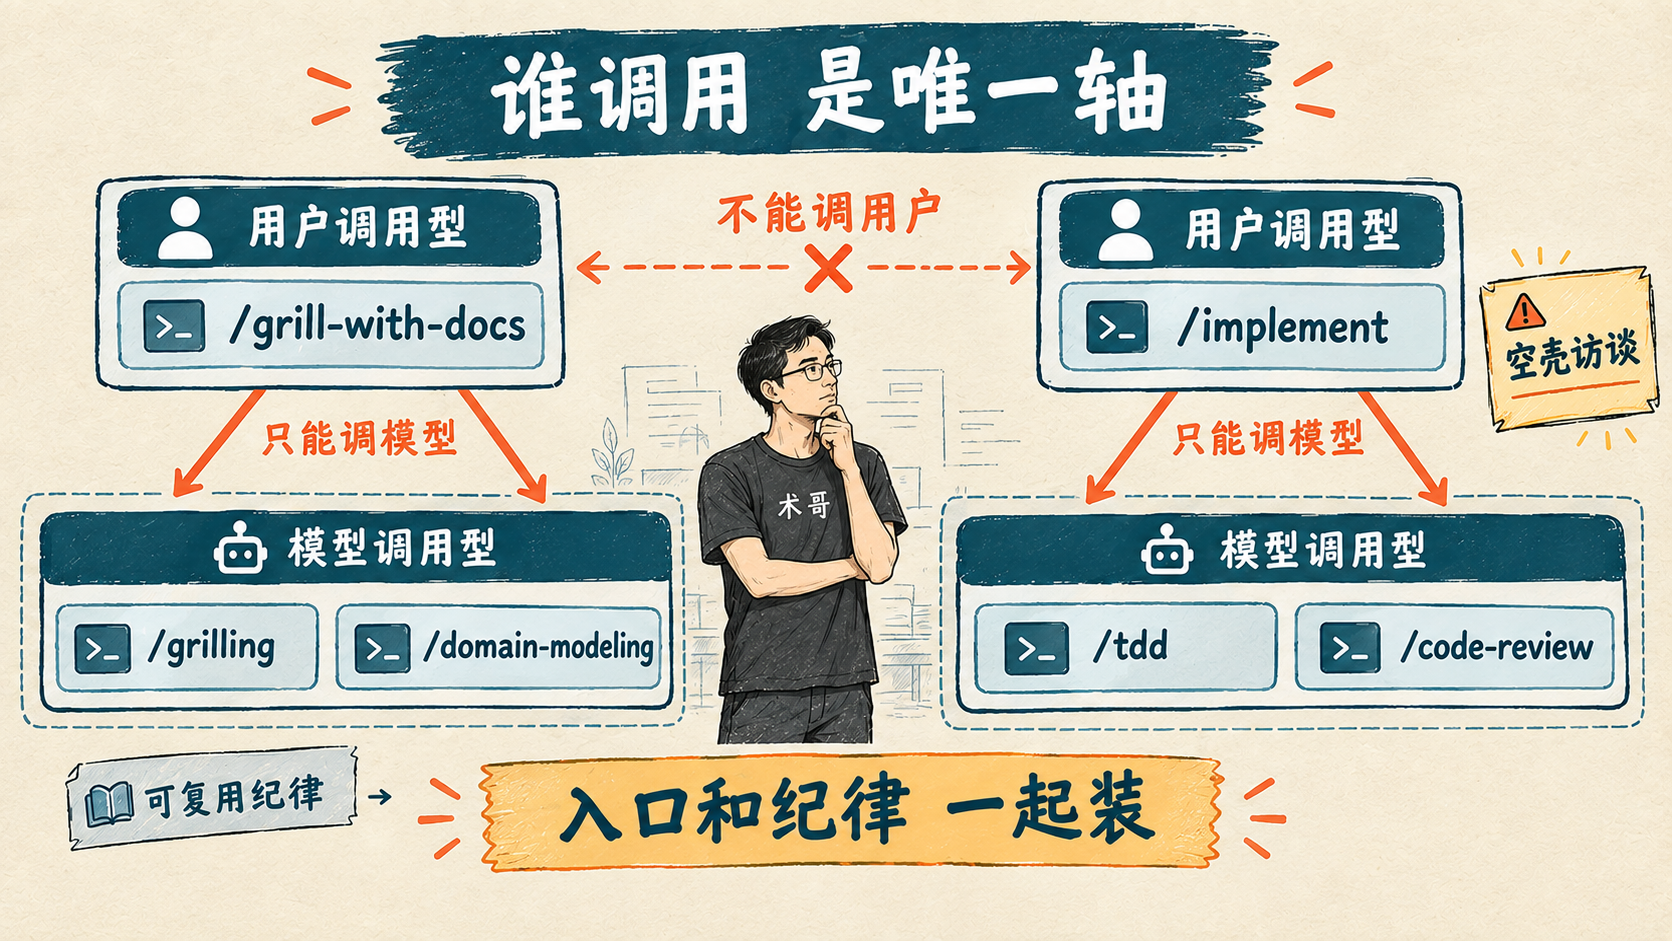
README 的 Reference 给了一个极简划分,原话是 "These split on one axis: who can invoke them":
- User-invoked(用户调用型):只有你在输入框显式打出它的名字才触发,比如
/grill-with-docs。它的职责原文叫 "orchestrate",编排。 - Model-invoked(模型调用型):你随时可以调,模型遇到匹配任务也会自己伸手去取。它的职责是 "hold the reusable discipline",承载可复用的纪律。
技术实现也很直白:User 型在 frontmatter 里写 disable-model-invocation: true(Codex 侧对应 policy.allow_implicit_invocation: false),description 写给人看;Model 型不写这个字段,description 写满触发器措辞,好让模型自动命中。
关键规则只有一条,.agents/invocation.md 里把它当不变式写死:User-invoked 可以调用 Model-invoked,但永远不能调用另一个 User-invoked。
这直接决定了你怎么组合。我从各个 SKILL.md 正文里把调用关系抄出来,依赖图是这样的:
grill-with-docs正文第一句就写着 "Call the Skill tool twice, for 'grilling' and 'domain-modeling'"。它是个拷问式访谈,同时建领域模型;implement正文:"Use /tdd where possible… Once done, use /code-review to review the work. Commit your work to the current branch.",实现→测试→评审→提交一条龙;improve-codebase-architecture调codebase-design拿架构词汇,再对选中的项拷问;tdd遇到接口形态存疑时,也会去调codebase-design;- 而 README 点名:
grilling是 "the reusable interview primitive behindgrill-me,grill-with-docs,triage,wayfinderandimprove-codebase-architecture",一个访谈原语,五个入口共用。
所以选 User 入口,等于连它挂着的 Model 纪律一起选。只装 /grill-with-docs 不装 grilling 和 domain-modeling,你得到的是一个空壳访谈:没人干活、不留文档。只装 /implement 不装 /tdd 和 /code-review,你得到的是让 AI 一通写然后直接提交,跟没装没区别。
04 维度二:按你的研发流程补齐入口
装之前先看它想让你怎么用。ask-matt 就是这 25 个正规军里的官方路由器(engineering 桶的 User-invoked 入口),专门回答“我该用哪个”,它把整张流程图画得很清楚:
主线 idea → ship:
/grill-with-docs:先拷问,把要改的东西问清楚。在仓库里工作时用它,因为它有状态,会把结论写进CONTEXT.md和 ADR;- 如果有个问题必须跑起来才知道答案(状态模型、业务逻辑、UI 长什么样),岔出去:先用
/handoff(productivity 桶的 User-invoked 技能,也是这 25 个之一)把当前对话压缩成交接文档,交给另一个 agent 接着干——开一个新会话、对着这份文档跑/prototype搭一次性原型; - 多会话的大活:
/to-spec把对话综合成规格发到 issue tracker →/to-tickets拆成曳光弹工单(tracer bullet,每张声明自己的阻塞边)→ 逐工单/implement; - 单会话的小活:直接
/implement; - 无论哪条,
/implement内部驱动/tdd(一次一个红绿切片),收尾跑/code-review(标准轴 + 规格轴双轴评审,并行子代理互不污染),然后才提交。
三个 on-ramp(汇入主线的入口):
- 外部 issue 堆起来了(不是你写的工单):走
/triage,把 issue 在分诊角色状态机里流转,产出 agent-ready 简报; - 东西真炸了:走
/diagnosing-bugs,纪律是先用一条“对这个 bug 会变红”的命令建起紧密反馈环,再谈修,最后补回归测试; - 大得一个会话装不下的模糊工程:走
/wayfinder,在 issue tracker 上画决策工单地图,一个个解决,产出的是决策不是交付物,路清了再回到/to-spec。
垫底两个词汇层: /domain-modeling 维护领域语言(CONTEXT.md/ADR),/codebase-design 提供 deep module 设计词汇(module、interface、depth、seam…)。它们不单独跑流程,是给上层技能垫词汇用的。
还有一条上下文卫生规则值得抄进你的习惯:第 1 到 3 步保持同一个 context 窗口不断开,因为拷问、规格、工单要建立在同一份思考上;每个 /implement 则从工单冷启动。窗口的上限它给了一个数:state-of-the-art 模型约 150k tokens 的 "smart zone"。
到这里,你应该已经知道自己缺哪段了。方向总跑偏,就补 1 的拷问层;提交前没人把关,就补 5 的评审收尾;issue 堆着没人分流,就装 /triage。
setup 配置由技能选择决定
05 维度三:setup 的配置,由你的选择决定
这是整套设计里最绕的一环,也是选择维度的收口。
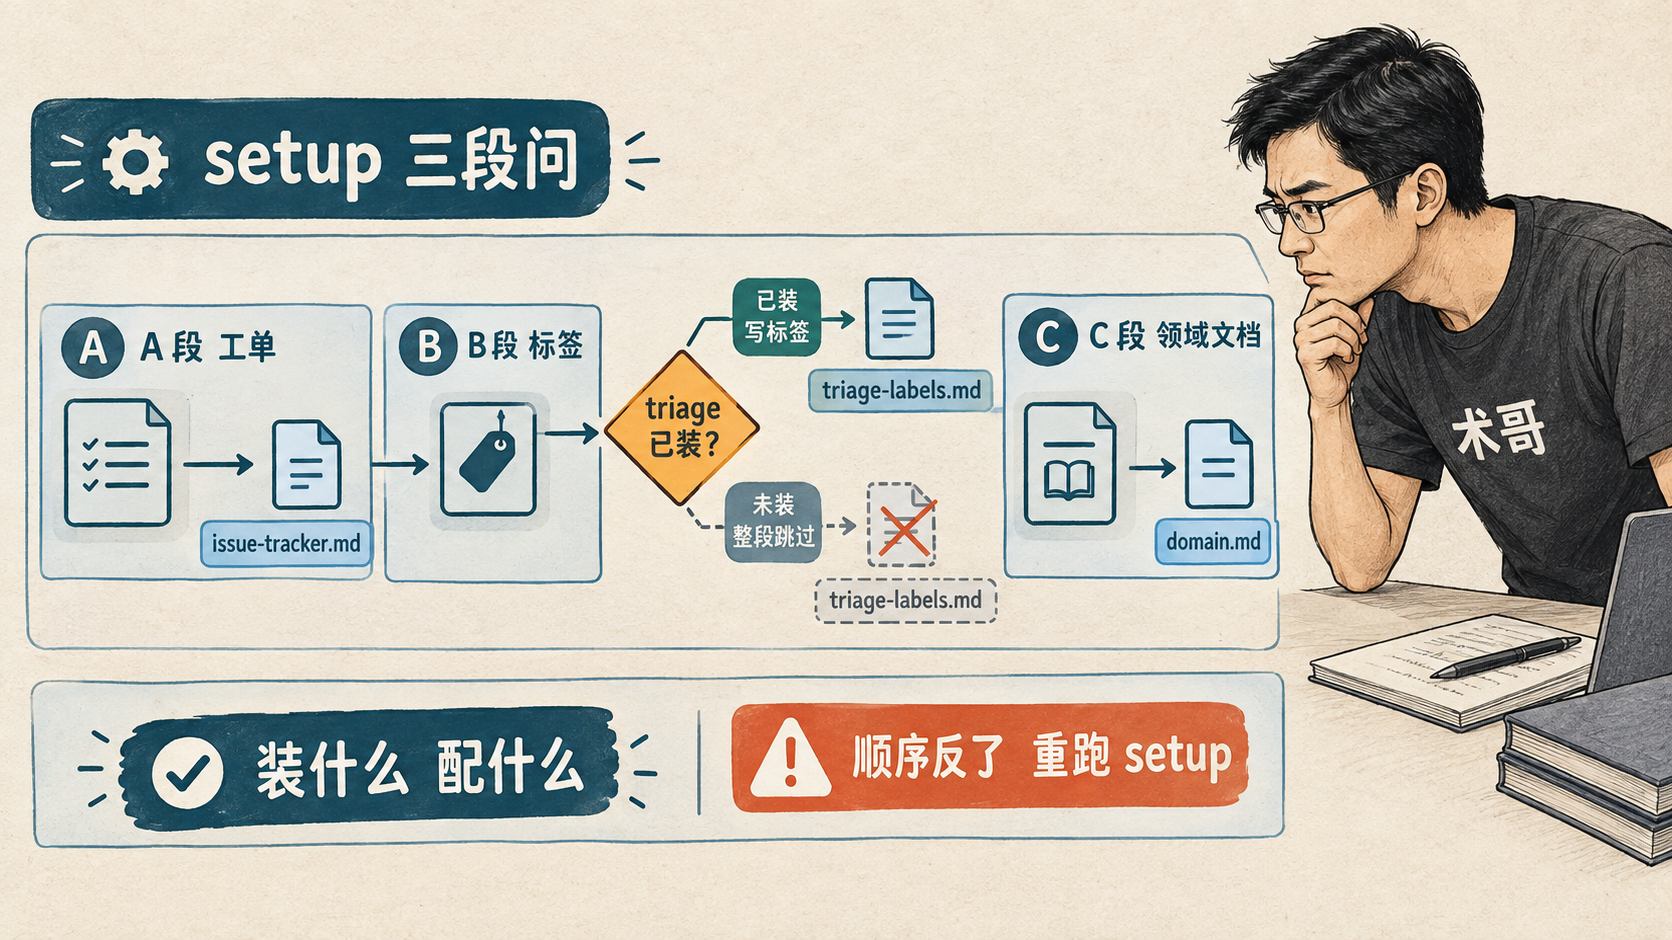
setup-matt-pocock-skills 是 prompt 驱动的配置技能,跟写死的脚本不同,每仓库跑一次。它分三段问,每一段的产出写进 docs/agents/:
- A 段:issue tracker。问你在哪跟踪工单:GitHub(gh CLI)、GitLab(glab CLI)、本地 markdown(
.scratch/<feature>/)、或 Jira/Linear 之类你自己用一段话描述。写docs/agents/issue-tracker.md; - B 段:triage 标签词汇。五个规范角色
needs-triage/needs-info/ready-for-agent/ready-for-human/wontfix,问你要不要用默认值。写docs/agents/triage-labels.md; - C 段:领域文档布局。默认 single-context,一个
CONTEXT.md+docs/adr/,几乎不用问直接写;只有探测到 monorepo 信号(pnpm-workspace.yaml、package.json的 workspaces、有src/的packages/*)才提供 multi-context 选项。写docs/agents/domain.md。
哪一段会被条件跳过,由什么决定?setup 会先探测 triage 装没装。SKILL.md 原话:"Skip this section entirely if the triage skill isn't installed… since an uninstalled skill needs no labels"。落到配置上:你没装 triage,B 段整个跳过,triage-labels.md 不写,CLAUDE.md/AGENTS.md 里的 ### Triage labels 块也一并省略。装了什么,决定配置产出什么,一个字都不多余。
反过来看消费方:to-spec、to-tickets、code-review 都做了同一个约定——缺配置时不自己补,把你推回去先跑 /setup-matt-pocock-skills。措辞各不同:to-spec 和 to-tickets 说“issue tracker 和 triage 标签词汇应该已经提供给你”;code-review 更具体,说“如果 docs/agents/issue-tracker.md 缺失”。三个技能都假设 setup 跑过,缺配置就把你推回去。
把这两头合起来,就是你真正的选择顺序:
- 先定流程(第 04 节):我要跑的是拷问→规格→工单→实现→评审这条主线,还是只需要其中一两段?
- 再选入口和纪律(第 03 节):入口 + 它依赖的 Model 纪律一起装;
- 最后跑 setup(第 05 节):它按你装了的自动配,B 段有 triage 才问标签,C 段有 monorepo 才提供 multi-context 选项。
顺序反了会怎样?先全装再跑 setup,按文档设计你会拿到全套配置,但不少没有对应流程在消费,因为配置是配给你实际跑的流程的。先跑 setup 再补装 triage,B 段当时被跳过,triage-labels.md 没生成,标签配置 setup 只在 B 段写,所以按设计你得重跑一次 setup 才能补上。
06 按场景补装:这些技能什么时候值得选
第 04 节画的是主线、on-ramp 和岔路长什么样;这一节回答更靠前的问题:哪些技能平时不在主线里,什么时候才值得装。前面说的 on-ramp(/diagnosing-bugs、/wayfinder)和主线岔路里的 /prototype 就是这类按场景技能——撞上对应场景才值得装、也才汇入主线;第 04 节讲它们怎么被用,这里讲该不该装,不是重复两遍。装不装,看你近期会不会撞上那个场景:
技能 | 什么时候值得装 |
|---|---|
| 要验证状态模型对不对、UI 长什么样,一次性原型回答设计问题 |
| 要派个后台 agent 去查高可信一手资料,结论存成带引用的 Markdown |
| 疑难 bug、间歇性 flake、性能回退,一次硬仗 |
| 遇到只能人类做的步骤:开通基建、配凭据、走陌生控制台、一次性迁移 |
| 工作量大到单会话装不下,需要决策工单地图 |
| 正在 merge/rebase 冲突里,逐块按意图解决,永不 |
misc 四个 | 用 Claude Code 且怕误操作 git 危险命令(git-guardrails-claude-code);提交前想自动格式化/类型检查/测试(setup-pre-commit);TS 代码里想把 as 断言迁到 shoehorn(migrate-to-shoehorn);建课程练习结构(scaffold-exercises) |
这套随用随装的节奏,跟仓库自己的结构一致:misc 不推广、in-progress 随时可能变,README 都写在明面上。用到哪个场景再补装哪个,不用预先占位。
Gen、Socket、Snyk 三列安全审计
07 安全扫描三列怎么读,别被吓退
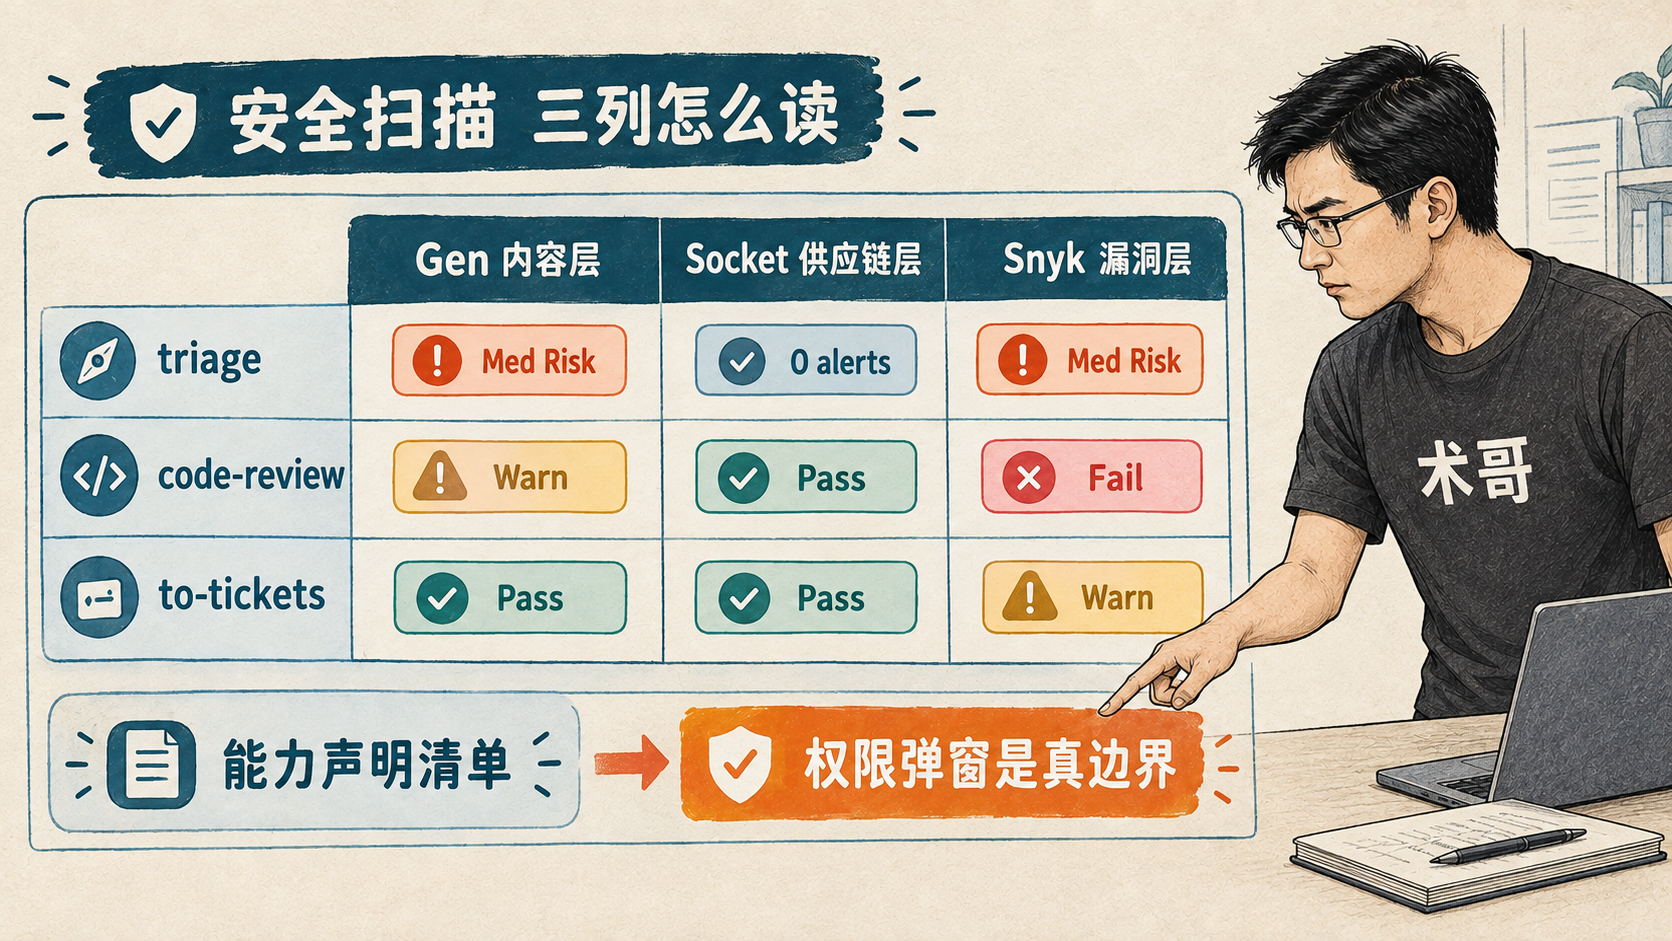
回到开头那张 Security Risk Assessments 界面。三列各有名字,skills.sh 审计页原文叫 "Combined security audit results from Gen Agent Trust Hub, Socket, and Snyk"。三列的等级(Safe/Med Risk、0 alerts、Low Risk 之类)直接抄自审计页与各技能页;每列“查什么”的含义,按审计页所见和公开解读转述:
- Gen(Gen Agent Trust Hub):内容层,看技能提示词声明了哪些会让 agent 执行有副作用操作的能力(跑命令、写文件、调 API、读网络)——这一列等于是“这份提示词声明了哪些能力”;
- Socket:供应链层,查依赖包有没有恶意行为;审计页可见的条目全部 0 alerts(个别技能页写作 Pass);
- Snyk:漏洞层,查技能涉及的代码/命令有没有已知漏洞或危险模式。审计页可见的条目里,Snyk 大多标 Low Risk、个别 Med Risk;本文重点抽出来看的是下表这三行。
这三行的标记我逐条核对过,都有出处,不是误报。被标的是那几个干活最重的技能:
技能 | Gen | Socket | Snyk |
|---|---|---|---|
triage | Med Risk | 0 alerts | Med Risk |
code-review | Warn | Pass | Fail |
to-tickets | Pass | Pass | Warn |
为什么偏偏是它们、又为什么落在各自那一列?
先补一层事实:上面表里 code-review 的非零项压在 Snyk 这一层(Gen Warn / Socket Pass / Snyk Fail,标注来自它的技能页)。跟正文对一下就对上号:triage 要读写 issue tracker(setup 的 A 段就提供 gh/glab/本地 markdown 这些渠道)并对工单做状态流转;code-review 要读 git diff、并行起两个子代理评审;to-tickets 要往 tracker 或本地文件写工单。skills.sh 官方把审计定义为 "assess skills and their contents"——审的是技能内容本身。Snyk 这层评的正是内容里涉及的代码/命令,按审计口径转述,它对“执行命令、并行起子进程”这类指令打分偏高,code-review 声明的那两件事(读 git diff、并行起两个子代理评审)正好撞上,所以 Fail 落在它这层,不是说这个技能自带漏洞。至于为什么 triage 是 Med Risk 而 code-review 是 Fail,skills.sh 只给结果、不给评分依据,这里不猜。
所以这里的判断:技能本质是 SKILL.md 提示词文档,自己不会运行任何东西,扫描审到的只是它声明了什么;真正决定能不能执行的是你给 agent 平台开的权限(allow/ask/deny 那套确认弹窗)。skills.sh 官方文档原话是 "review skills before installing and use your own judgment",装前自己看。风险等级告诉你看哪里,权限弹窗才是安全边界。
08 装之前,用这张清单做最后判断
装之前,你可以按这个顺序自己过一遍(每条都能自检):
- 确定安装路线:Claude Code 插件(订阅)还是 skills.sh(复制可改),只选一条;
- 想清楚你要跑的流程:拷问起步?规格+工单?还是直接实现+评审?对应哪几个 User 入口;
- 把入口依赖的 Model 纪律一起勾上(grill-with-docs→grilling+domain-modeling;implement→tdd+code-review);
- 无论选什么,
setup-matt-pocock-skills必须勾; - 跑
/setup-matt-pocock-skills,按文档预期会依次问 issue tracker、triage 标签、领域文档布局;没装 triage 就不会被问标签; - 把安全扫描三列当“能力声明清单”看:审计页可见条目 Socket 全 0 alerts、Snyk 大多 Low Risk,重点看被标的那几个在声明什么,别急着卸载;
- 场景需求出现时再补装,misc/in-progress 不预先占位。
判断路径一句话:流程缺口 → User 入口 → 配套 Model 纪律 → setup 按选择落地配置 → 其余按需。
09 边界与后续
这篇以源码和官方文档分析为主(v1.2.3 / HEAD c55ee46),其中安装器输出(Found 38 skills)是沙箱实测,其余按文档预期描述。实际体验若有出入,以你跑出来的为准。
仓库迭代很快,CHANGELOG 显示 1.2.3 还在持续发 patch(diagnosing-bugs 加 secret 脱敏、跨 harness 去工具名、wizard 改版等),装完记得留意更新。
后续我会分别验证两条路径:/grill-with-docs 如何把讨论沉淀为 CONTEXT.md 和 ADR;/implement → /tdd → /code-review 如何在真实开发中衔接,以及这条链路容易在哪些环节中断。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号