大语言模型压缩:剪枝、蒸馏与量化
原创
大语言模型压缩:剪枝、蒸馏与量化
原创
晒太阳的蓝金猫
发布于 2026-09-24 15:03:06
发布于 2026-09-24 15:03:06
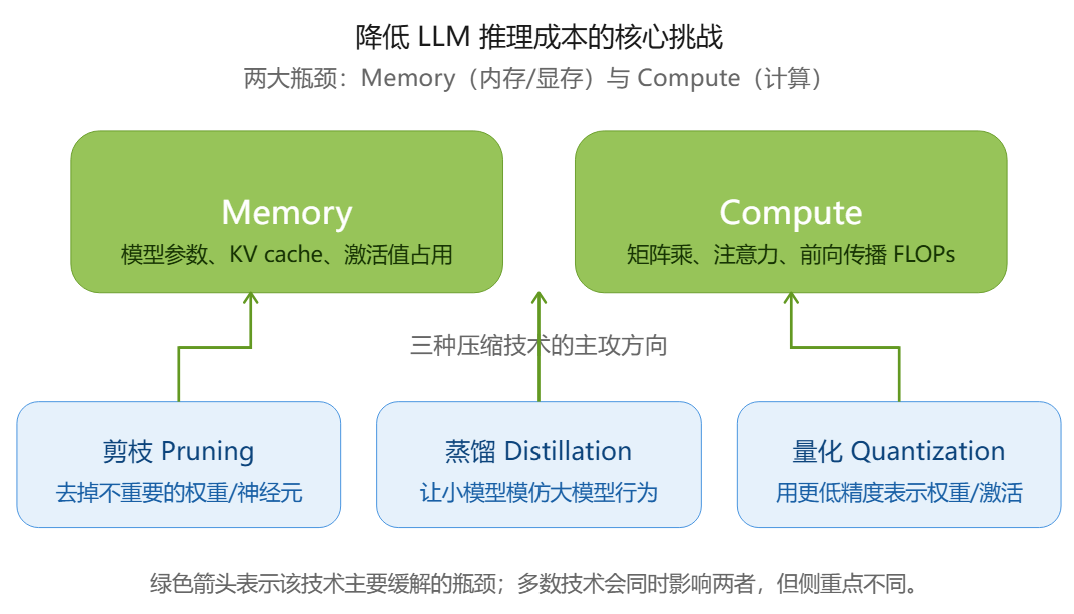
推理降本的两大瓶颈
降低 LLM 推理成本之所以难,是因为它同时受两类瓶颈制约:
瓶颈 | 含义 | 为什么是瓶颈 |
|---|---|---|
Memory(内存/显存) | 模型参数、KV cache、激活值都要占 GPU 显存 | 70B 模型 FP16 约需 140GB+,远超单卡容量(如 4090 24GB、A100 80GB) |
Compute(计算量) | 自注意力、MLP 矩阵乘、前向传播产生大量 FLOPs | 每生成一个新 token 都要过一遍整个网络,延迟与能耗都高 |
GPU 显存为什么不够:两大内存占用
显存(HBM)容量有限且带宽受限(memory-bound)——很多情况下不是算不过来,而是“把权重从显存搬到计算单元”这一步被带宽卡住。推理时显存主要被两块吃掉:
占用 | 性质 | 增长方式 | 典型优化手段 |
|---|---|---|---|
Weights(权重) | 静态 | 模型加载即占满,规模由参数量决定(FP16 约 2 byte/param) | 量化、剪枝、蒸馏 |
KV cache(键值缓存) | 动态 | 随 batch size × 序列长度线性膨胀,长上下文下可反超权重 | GQA/MQA、PagedAttention、KV 量化 |
要点:Weights 是一次性固定开销;KV cache 是随上下文爆炸的动态项。长上下文(32K / 128K)场景中 KV cache 会成为显存杀手,因此单独有一整套 KV cache 优化技术线。
GPU 显存为何是推理瓶颈
两大内存占用:Weights(静态)与 KV cache(动态)
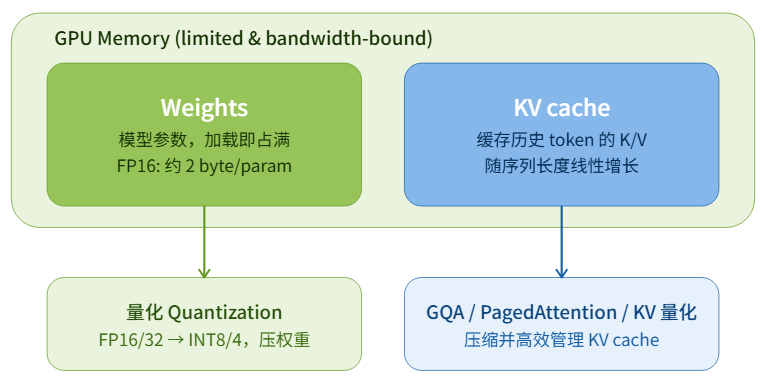
显存有限且带宽受限(memory-bound);权重是静态大头,KV cache 随上下文变长而膨胀——这是压缩的两个主战场。
三种压缩技术
技术 | 做什么 | 主要缓解 | 次要影响 |
|---|---|---|---|
剪枝 Pruning | 去掉不重要的权重 / 神经元 / 层 | Memory(模型体积变小) | Compute(结构剪枝能真正减少运算量) |
蒸馏 Distillation | 训练一个小模型去模仿大模型的输出分布 | Memory + Compute(直接换小模型) | 能力会有损失,需蒸馏技巧补回 |
量化 Quantization | 权重 / 激活从 FP16/FP32 降到 INT8/INT4 | Memory(显存占用与带宽大减) | Compute(低精度运算更快,但需硬件支持) |
速记 & 串联
剪枝减体积,蒸馏换小模型,量化降精度。
- 三者可组合使用:QLoRA、GPTQ、AWQ = 量化 + 高效推理;DistilLLaMA 类 = 蒸馏 + 量化。
- 三种压缩(剪枝/蒸馏/量化)主要打 Weights;KV cache 的压缩是另一套打法(GQA / PagedAttention / KV 量化)。
- 判断框架:看到一种降本手段,先问它省的是 Memory 还是 Compute;若是 Memory,再问主要打 Weights 还是 KV cache。
REF: DLI Course:《The Art of Compressing LLMs: Pruning, Distillation, and Quantization Demystified》
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号