异构数据源同步之数据同步 → DataX 使用细节


简单使用
关于 DataX ,大家可以去看官网介绍:introduction
里面讲到了 DataX 的概况、框架设计、核心架构、插件体系、核心优势,由阿里出品,并在阿里内部被广泛使用,其性能、稳定都是经过了严格考验的。得益于它的框架设计
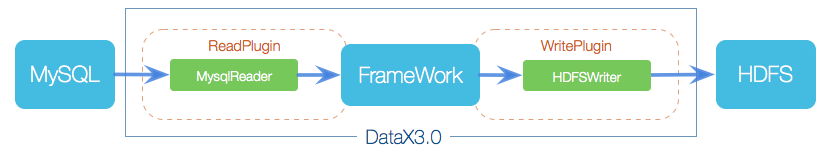
DataX框架设计
- Reader:数据采集模块,负责采集源数据源的数据,并将数据发送给 FrameWork
- Writer:数据写入模块,不断从 FrameWork 取数据,并将数据写入目标数据源
- FrameWork:核心模块,用于连接 Reader 和 Writer,作为两者的数据传输通道,并处理缓冲、流控、并发、数据转换等核心问题
我们很容易实现二次开发,当然主要是针对新插件的开发。DataX 已经实现了非常多的插件
类型 | 数据源 | Reader(读) | Writer(写) | 文档 |
|---|---|---|---|---|
RDBMS 关系型数据库 | MySQL | √ | √ | 读 、写 |
Oracle | √ | √ | 读 、写 | |
OceanBase | √ | √ | 读 、写 | |
SQLServer | √ | √ | 读 、写 | |
PostgreSQL | √ | √ | 读 、写 | |
DRDS | √ | √ | 读 、写 | |
Kingbase | √ | √ | 读 、写 | |
通用RDBMS(支持所有关系型数据库) | √ | √ | 读 、写 | |
阿里云数仓数据存储 | ODPS | √ | √ | 读 、写 |
ADB | √ | 写 | ||
ADS | √ | 写 | ||
OSS | √ | √ | 读 、写 | |
OCS | √ | 写 | ||
Hologres | √ | 写 | ||
AnalyticDB For PostgreSQL | √ | 写 | ||
阿里云中间件 | datahub | √ | √ | 读 、写 |
SLS | √ | √ | 读 、写 | |
图数据库 | 阿里云 GDB | √ | √ | 读 、写 |
Neo4j | √ | 写 | ||
NoSQL数据存储 | OTS | √ | √ | 读 、写 |
Hbase0.94 | √ | √ | 读 、写 | |
Hbase1.1 | √ | √ | 读 、写 | |
Phoenix4.x | √ | √ | 读 、写 | |
Phoenix5.x | √ | √ | 读 、写 | |
MongoDB | √ | √ | 读 、写 | |
Cassandra | √ | √ | 读 、写 | |
数仓数据存储 | StarRocks | √ | √ | 读 、写 |
ApacheDoris | √ | 写 | ||
ClickHouse | √ | √ | 读 、写 | |
Databend | √ | 写 | ||
Hive | √ | √ | 读 、写 | |
kudu | √ | 写 | ||
selectdb | √ | 写 | ||
无结构化数据存储 | TxtFile | √ | √ | 读 、写 |
FTP | √ | √ | 读 、写 | |
HDFS | √ | √ | 读 、写 | |
Elasticsearch | √ | 写 | ||
时间序列数据库 | OpenTSDB | √ | 读 | |
TSDB | √ | √ | 读 、写 | |
TDengine | √ | √ | 读 、写 |
囊括了绝大部分数据源,我们直接拿来用就行;如果如上数据源都未包括你们需要的数据源,你们也可以自实现插件,参考 DataX插件开发宝典 即可
如果只是使用 DataX ,那下载 DataX 工具包 即可,解压之后目录结构如下
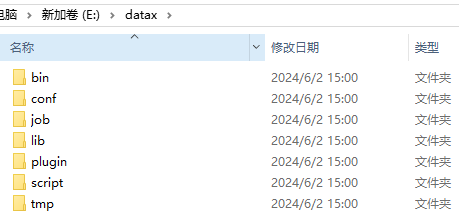
datax目录结构
每个文件夹的作用就不做介绍了,大家去看官网看文档就行;通过 bin 目录下的 datax.py 启动 DataX。
现有 MySQL 数据库 qsl_datax,其上有表 qsl_datax_source
CREATE TABLE `qsl_datax_source` (
    `id` bigint(20) NOT NULL COMMENT '自增主键',
    `username` varchar(255) NOT NULL COMMENT '姓名',
    `password` varchar(255) NOT NULL COMMENT '密码',
    `birth_day` date NOT NULL COMMENT '出生日期',
    `remark` text,
    PRIMARY KEY (`id`)
);
insert into `qsl_datax_source`(`id`, `username`, `password`, `birth_day`, `remark`) values
(1, '张三', 'z123456', '1991-01-01', '张三'),
(2, '李四', 'l123456', '1992-01-01', '李四'),
(3, '王五', 'w123456', '1993-01-01', '王五'),
(4, '麻子', 'm123456', '1994-01-01', '麻子');
需要将表中数据同步到 MySQL 数据库 qsl_datax_sync 的表 qsl_datax_target
CREATE TABLE `qsl_datax_target` (
    `id` bigint(20) NOT NULL COMMENT '自增主键',
    `username` varchar(255) NOT NULL COMMENT '姓名',
    `pw` varchar(255) NOT NULL COMMENT '密码',
    `birth_day` date NOT NULL COMMENT '出生日期',
    `note` text,
    PRIMARY KEY (`id`)
);
该如何实现?
配置 job.json
因为是从 MySQL 同步到 MySQL ,所以我们的 Reader 是 MySQL,Writer 也是 MySQL ,那么配置文件从哪复制也就清楚了。从 MysqlReader 复制 Reader 配置,从 MysqlWriter 复制 Writer 配置,然后将相关参数值配置成我们自己的,mysql2Mysql.json 就算配置完成
{
  "job": {
    "setting": {
      "speed": {
        "channel": 5
      },
      "errorLimit": {
        "record": 0,
        "percentage": 0.02
      }
    },
    "content": [
      {
        "reader": {
          "name": "mysqlreader",
          "parameter": {
            "username": "root",
            "password": "123456",
            "column": [
              "id",
              "username",
              "password",
              "birth_day",
              "remark"
            ],
            "connection": [
              {
                "jdbcUrl": [
                  "jdbc:mysql://192.168.2.118:3307/qsl_datax?useUnicode=true&characterEncoding=utf-8"
                ],
                "table": [
                  "qsl_datax_source"
                ]
              }
            ]
          }
        },
        "writer": {
          "name": "mysqlwriter",
          "parameter": {
            "writeMode": "insert",
            "username": "root",
            "password": "123456",
            "column": [
              "id",
              "username",
              "pw",
              "birth_day",
              "note"
            ],
            "connection": [
              {
                "jdbcUrl": "jdbc:mysql://192.168.2.118:3306/qsl_datax_sync?useUnicode=true&characterEncoding=utf-8",
                "table": [
                  "qsl_datax_target"
                ]
              }
            ]
          }
        }
      }
    ]
  }
}
mysql2Mysql.json 存放到哪都可以,推荐大家放到 DataX 的 job 目录下,方便管理。配置不算复杂,相信大家都能看懂
启动 DataX 进行同步
到 DataX 的 bin 目录下启动命令行窗口,然后执行如下命令
python datax.py ../job/mysql2Mysql.json
当我们看到如下输出,就说明同步成功了
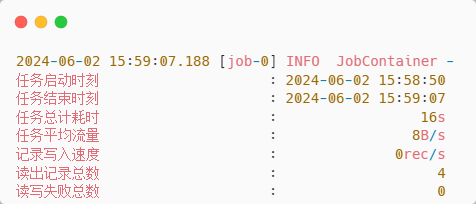
简单使用
需要说明的是
DataX 不支持表结构同步,只支持数据同步,所以同步的时候需要保证目标表已经存在
column
指的就是 job.json 中 reader 和 writer 节点下的 column ,配置需要同步的列名集合;可以配置表的列名,也可以配置常量、表达式,还可以配置 * ,但不推荐配置 *,因为它不便于我们查看列之间的映射关系
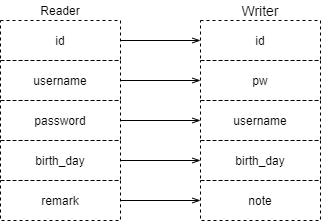
Reader 和 Writer 之间的列是根据顺序进行映射的,而非根据字段名进行映射的,以前面的 mysql2Mysql.json 为例,字段的映射关系如下所示
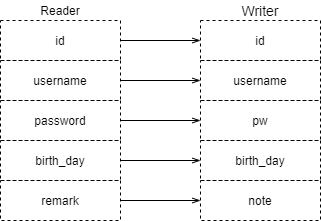
列映射
相当于是根据数组的索引进行映射的,reader_column[n] 映射 writer_column[n],那么问题来了,如果列数不对应会怎么样
-
Reader列数比Writer多 去掉Writer的列pw,然后执行下同步任务,会发现同步异常,提示如下信息 列配置信息有错误. 因为您配置的任务中,源头读取字段数:4 与 目的表要写入的字段数:5 不相等. 请检查您的配置并作出修改. -
Reader列数比Writer少 同样会同步异常,提示信息类似如下 列配置信息有错误. 因为您配置的任务中,源头读取字段数:4 与 目的表要写入的字段数:5 不相等. 请检查您的配置并作出修改.
如果列数一致,但列的顺序没有正确映射,会出现什么情况
- 同步异常
你们是不是有这样的疑问:列数一样,怎么会同步异常?因为存在列类型不匹配,导致数据插不进去,例如我将
Writer中的username和birth_day对调下位置,然后执行同步,会发现同步异常,异常信息类似如下 Date 类型转换错误 - 同步正常,数据却乱了
对调下
Writer的username和pw
datax_使用细节-同步正常_数据乱了
执行同步任务,会发现同步没有出现异常,但你们看一眼目标数据源的数据
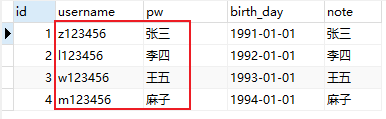
列数相同_数据乱了
很明显脏数据了,这算同步成功还是同步失败?
示例的脏数据很容易能够看出来,如果出现两列很类似的数据,那就麻烦了,等待我们的就是长夜漫漫的 bug 排查之旅
哪个二臂写的代码
table
在 Reader 表示从哪读数据,在 Writer 表示往哪写数据;Reader 和 Writer 都支持配置多个表,但需要保证这些表是同一 schema 结构
个人非常不推荐一个 job 配置多个 table,而是一个 job 一个 table,如果需要同步多个 table,那就配置多个 job 嘛
splitPk
这个配置只针对 Reader
Reader 进行数据抽取时,如果指定了 splitPk,那么 DataX 会按 splitPk 配置的字段进行数据分片,启动并发任务进行数据同步,从而提高同步的效率
那问题又来了,分成多少片了?我已经给大家总结好了
- 若未配置
splitPk,则一个table对应一个task - 配置了
splitPk,table只要 1 个,则分成job.setting.speed.channel * reader.parameter.splitFactor片,每片对应一个tasksplitFactor未配置的情况下,其默认值是 5 - 配置了
splitPk,且table多余 1 个,则对每个table分成job.setting.speed.channel片,每片对应一个task不推荐大家在一个job中配置多个表,所以这种情况了解就好
比较可惜的是,目前 splitPk 仅支持整形数据切分,否则会报错
我们对 mysql2Mysql.json 进行下 splitPk 改造,调整如下 2 项,其他不动
- job.setting.speed.channel 调整成 2
- reader 节点下新增 2 配置项
- reader.parameter.splitPk="id"
- reader.parameter.splitFactor=2
执行同步任务,能看到如下日志
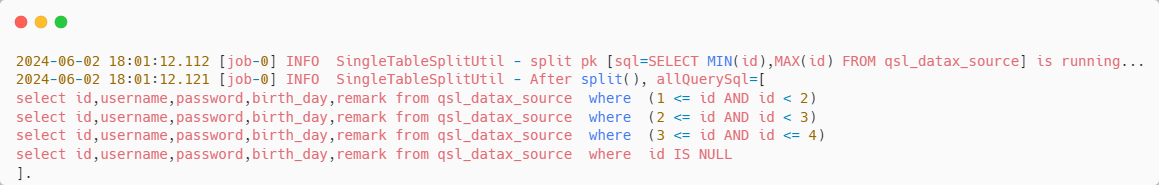
splitPk_日志
仔细看 allQuerySql,4 条 SQL 代表 4 个分片,这个我相信你们都能理解,但是 where id IS NULL 这条 SQL 是什么意思?其实我们仔细思考下就明白了,我们之所以认为 where id IS NULL 没必要存在的原因是我们知道 id 是主键,但 DataX 知道吗,它不知道,所以需要 where id IS NULL 来保证数据不被遗漏。不过话说回来,数据量少的时候,不分片效率比分片要高,这又回到了那个老生常谈的问题了
多线程一定比单线程效率高吗
where
同样只针对 Reader
同 SQL 中的 WHERE 一样,是筛选条件,Reader 根据 column、table、where 拼接 SQL,然后用这个拼接好的 SQL 进行数据抽取。示例演示之前,我们记得将 mysql2Mysql.json 还原成最初的样子,然后补上 where 条件
{
  "job": {
    "setting": {
      "speed": {
        "channel": 3
      },
      "errorLimit": {
        "record": 0,
        "percentage": 0.02
      }
    },
    "content": [
      {
        "reader": {
          "name": "mysqlreader",
          "parameter": {
            "username": "root",
            "password": "123456",
            "column": [
              "id",
              "username",
              "password",
              "birth_day",
              "remark"
            ],
            "connection": [
              {
                "jdbcUrl": [
                  "jdbc:mysql://192.168.2.118:3307/qsl_datax?useUnicode=true&characterEncoding=utf-8"
                ],
                "table": [
                  "qsl_datax_source"
                ]
              }
            ],
			"where": "id < 3"
          }
        },
        "writer": {
          "name": "mysqlwriter",
          "parameter": {
            "writeMode": "insert",
            "username": "root",
            "password": "123456",
            "column": [
              "id",
              "username",
              "pw",
              "birth_day",
              "note"
            ],
            "connection": [
              {
                "jdbcUrl": "jdbc:mysql://192.168.2.118:3306/qsl_datax_sync?useUnicode=true&characterEncoding=utf-8",
                "table": [
                  "qsl_datax_target"
                ]
              }
            ]
          }
        }
      }
    ]
  }
}
执行同步程序,会在日志中看到如下信息
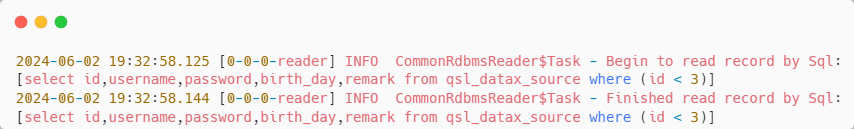
where日志
如果再加上 splitPk ,你们能想到 DataX 的处理逻辑吗,我给你们看一段日志
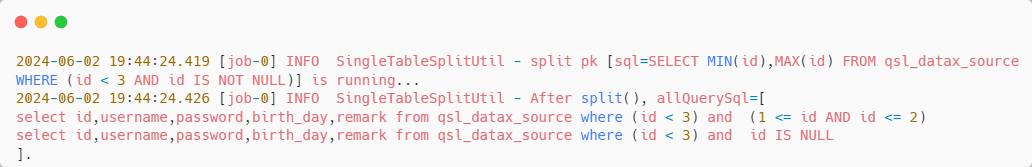
where_splitPk_日志
这段日志,你们看明白了吗
如果不配置 where 或者 where 的值配置空,那么就相当于全量同步;如果正常配置了 where 则相当于增量同步,而这个增量同步是在实际项目中用的比较多的。一旦涉及得到增量,我们是不是得把增量列的值以变量的形式传入值,而 DataX 正好实现了该功能,类似如下进行配置
"where": "id > $startId"
通过启动命令来传入变量值,类似如下
python datax.py ../job/mysql2Mysql.json -p"-DstartId=1"
同步任务出现如下日志,说明变量的值传入正常
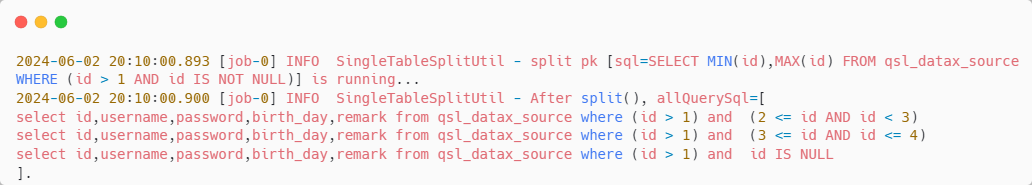
where增量日志
再结合调度平台,那么定时增量同步就实现了
有兴趣的可以去看看 datax-web
querySql
只针对 Reader
table 加 where 能配置的筛选条件还是比较有限,join 也没法满足,所以 querySql 应运而生。querySql 允许用户自定义筛选 SQL
当用户配置
querySql时,Reader直接忽略table、column、where条件的配置,querySql优先级大于table、column、where选项table和querySql只能配置一个,不能同时配置
querySql 同样支持变量,类似如下
{
  "job": {
    "setting": {
      "speed": {
        "channel": 3
      },
      "errorLimit": {
        "record": 0,
        "percentage": 0.02
      }
    },
    "content": [
      {
        "reader": {
          "name": "mysqlreader",
          "parameter": {
            "username": "root",
            "password": "123456",
			"splitPk": "id"
			"splitFactor": 2
            "connection": [
              {
				"querySql": ["select id,username,password,birth_day, 'remark' AS remark from qsl_datax_source where id > $startId"]
                "jdbcUrl": [
                  "jdbc:mysql://192.168.2.118:3307/qsl_datax?useUnicode=true&characterEncoding=utf-8"
                ],
              }
            ]
          }
        },
        "writer": {
          "name": "mysqlwriter",
          "parameter": {
            "writeMode": "insert",
            "username": "root",
            "password": "123456",
            "column": [
              "id",
			  "username",
              "pw",
              "birth_day",
              "note"
            ],
            "connection": [
              {
                "jdbcUrl": "jdbc:mysql://192.168.2.118:3306/qsl_datax_sync?useUnicode=true&characterEncoding=utf-8",
                "table": [
                  "qsl_datax_target"
                ]
              }
            ]
          }
        }
      }
    ]
  }
}
同步日志中会出现如下信息
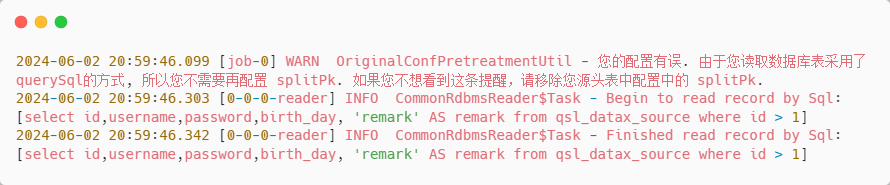
querySql日志
大家可以看到,如果配置了 querySql,那么 splitPk 配置就不生效了
总结
- 大家如果细心的话,会发现我讲得基本都是关于
Reader,实际也确实是Reader配置要复杂很多,至于Writer配置嘛,我相信你们都能看懂,也都会配置,我就不唠叨了 column不推荐配置*,推荐配列名,能更直观的反应映射关系table模式下,单job推荐只配一个table,如果是同步多个table, 推荐配置多个jobsplitPk只支持table模式,实现分片并发获取数据,提高查询效率,但这不是绝对的,小数据量的情况下,可能单任务效率更高where只支持table模式,给查询增加过滤条件,支持变量,可以实现增量同步querySql模式下,table模式不能配置,否则异常,column、where、splitPk即使配置了也不生效;querySql可以实现用户自定义SQL,非常灵活,join查询就可以用querySql来实现
本文参与 腾讯云自媒体同步曝光计划,分享自作者个人站点/博客。
原始发表:2024-06-04,如有侵权请联系 cloudcommunity@tencent.com 删除
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号