如何消除PD分离推理的结构性拥塞?Matrix架构深度解析
原创
如何消除PD分离推理的结构性拥塞?Matrix架构深度解析
原创
星融元Asterfusion
修改于 2026-11-10 17:47:16
修改于 2026-11-10 17:47:16
当大模型推理从单一实例走向大规模GPU集群,AI推理网络的性能瓶颈已不再只是“带宽够不够”,而是流量路径能否匹配业务模型。尤其在PD分离场景中,Prefill与Decode被部署到不同GPU资源池,原本发生在实例内部的KV Cache传递转变为跨服务器、跨交换机传输,网络开始直接影响首Token延迟与服务稳定性。
因此,PD分离下的网络设计不应从“增加多少Spine和链路”开始,而应先回答一个问题:如何把调度器产生的动态P→D通信关系,转化为短路径、低冲突、可预测的网络转发?
为什么PD分离正在重构AI推理网络
Prefill与Decode的资源特征并不相同
大模型推理可以拆分为两个主要阶段:
- Prefill阶段:接收完整Prompt并执行前向计算,生成初始KV Cache。该阶段计算密集,适合通过较大的Batch提高计算效率。
- Decode阶段:基于已有KV Cache逐Token生成输出,执行频率高、访存密集,对持续传输和时延变化更加敏感。
PD分离将两类任务放入独立GPU实例池,使算力配置、批量策略和扩缩容可以分别优化。例如,Prefill池更关注计算能力,Decode池更关注显存容量与带宽;业务方也可以根据Prompt长度、输出长度和并发量动态调整P:D实例配比,而不是将某一固定比例视为通用答案。
不过,计算解耦也意味着数据必须跨池流动。Prefill实例生成的KV Cache需要被送往调度器指定的Decode实例,于是,PD分离在提升资源弹性的同时,也把AI推理网络推到了关键路径上。
KV Cache传输改变了网络流量模型
与训练阶段的All-Reduce等集合通信相比,PD分离场景下的KV Cache传输具有明显差异:
对比维度 | 训练集合通信 | PD分离推理 |
|---|---|---|
流量方向 | 对称、规律 | 非对称,任意P节点指向任意D节点 |
源目关系 | 通信组相对确定 | 由调度器动态决定 |
单流规模 | 相对可预测 | 随模型与上下文长度动态变化 |
负载分布 | 相对均衡 | 可能出现大象流与局部集中 |
性能关注点 | 集合通信完成时间 | P99 TTFT及KV Cache传输尾延迟 |
这里的关键变化不是简单的“流量更大”,而是通信矩阵变得动态。网络无法预先假定哪些Prefill节点会与哪些Decode节点通信,也难以依靠固定轨道长期避开热点。
PD分离场景下,传统网络的三类结构性瓶颈
ECMP哈希极化:总带宽充足,局部链路仍然拥塞
传统Clos/Fat-Tree网络通常使用ECMP进行逐流负载均衡。该机制适合大量、相对均匀的流,但PD分离推理中的KV Cache传输可能形成大流量、长持续时间的“大象流”。
当多条大象流被哈希到同一成员链路时,就会出现典型矛盾:全网仍有不少空闲带宽,个别链路却已持续拥塞。对于Decode实例而言,等待KV Cache完成传输会直接拉长首Token时间,因此局部哈希冲突最终可能表现为业务侧P99 TTFT升高。
动态源目关系:固定优化假设失效
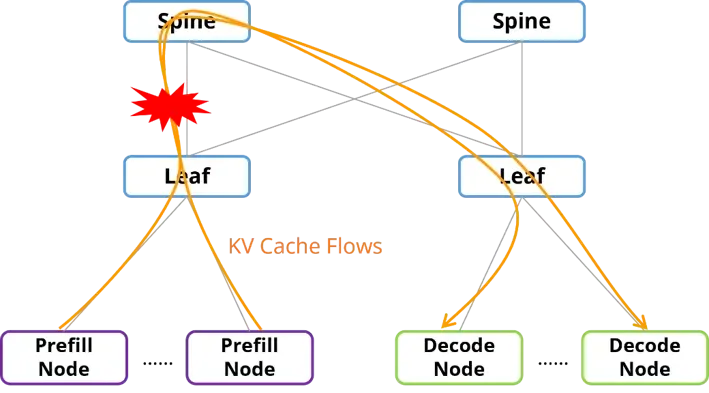
轨道优化网络能够改善特定训练通信模式,但其有效性建立在对流量方向和通信关系的预设之上。PD分离推理的源目关系则由调度器实时决定,Prefill节点和Decode节点可能分布在不同Leaf下,并随实例扩缩容不断变化。
当多个高负载Prefill节点集中在少数Leaf下时,其上行链路可能同时承受大量KV Cache传输。这类热点并非完全来自瞬时突发,而可能源于拓扑结构与动态通信矩阵不匹配。
Spine汇聚与多跳转发:尾延迟被进一步放大
在传统三层Clos架构中,跨Leaf流量通常需要经过Spine层。若PD分离推理以跨Leaf KV Cache传输为主,大量动态流量便会在Spine及相关互联链路汇聚。
即使增加Spine带宽,也只能缓解容量问题,无法改变流量必须经过额外转发层级这一事实。更多跳数还会增加队列、拥塞和故障影响路径,使尾延迟分析更加复杂。
对PD分离场景而言,减少不必要的汇聚层级,与增加单链路带宽同样重要。
面向非对称流量的Matrix网络架构
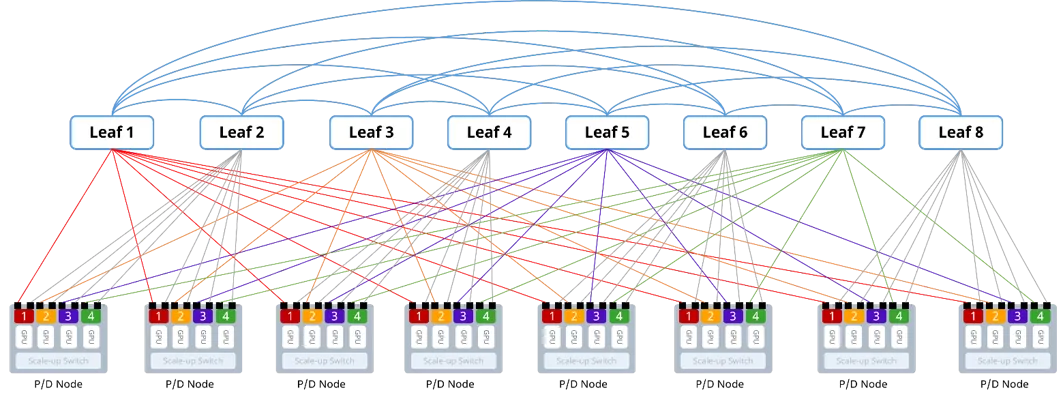
本方案提出的 AsterFabric Matrix 组网(以下简称 Matrix),是专为 PD 分离推理场景设计的网络架构,旨在从网络拓扑层面消除 PD 分离场景下的结构性拥塞,而非依赖上层调度或更复杂的传输层协议,其核心设计理念包括:
- 移除 Spine 层:彻底消除跨 Leaf 流量的汇聚瓶颈,将网络直径从3跳压缩至2跳;
- 完全二部图互联:Leaf 交换机分两组构成两个平面,平面 Leaf 之间 Full-Mesh 全互联,为 KV Cache 传输提供最短且确定的路径;
- 单轨+多轨混合接入:通过正交对偶分区,将结构化的 Prefill/Decode 节点块在底层链路中均匀散开,实现天然负载均衡;
- 确定性路由:每对 GPU 之间仅有一条最优路径,消除 ECMP 哈希冲突。
组网架构简析
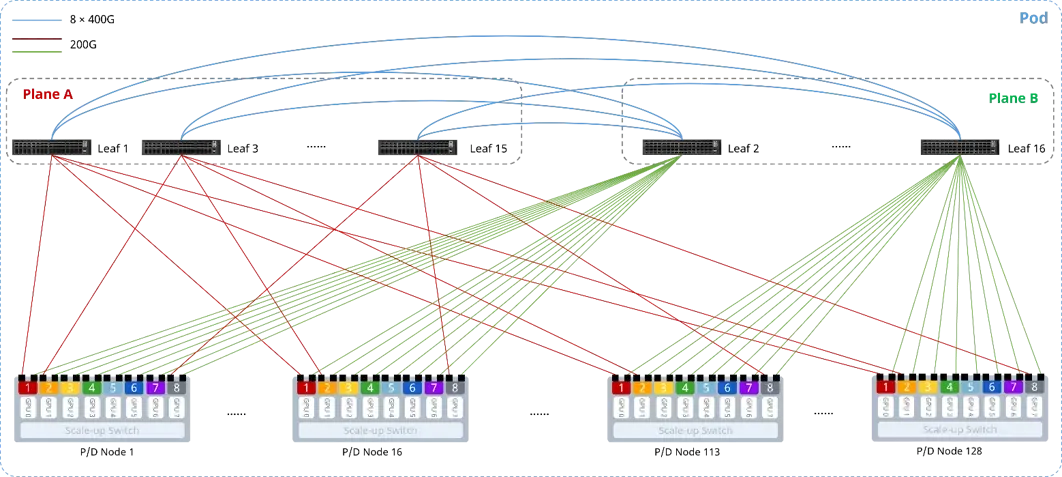
Matrix 架构移除传统 Fat-Tree 架构的 Spine 交换层,将所有 Leaf 交换机均分为数量相等的两组:
- A平面(多轨平面,奇数组Leaf):编号为1, 3, 5, …
- B平面(单轨平面,偶数组Leaf):编号为2, 4, 6, …
两组交换机之间构建完全二部图全互联,任意一台 A 组交换机与所有 B 组交换机均有直连链路,平面内交换机互不连接。
每个 GPU 的双端口网卡分别接入两组交换机:
- 第一端口(多轨端口):按多轨规则接入A平面奇数 Leaf 交换机
- 第二端口(单轨端口):按单轨规则接入B平面偶数 Leaf 交换机
最小组网示例
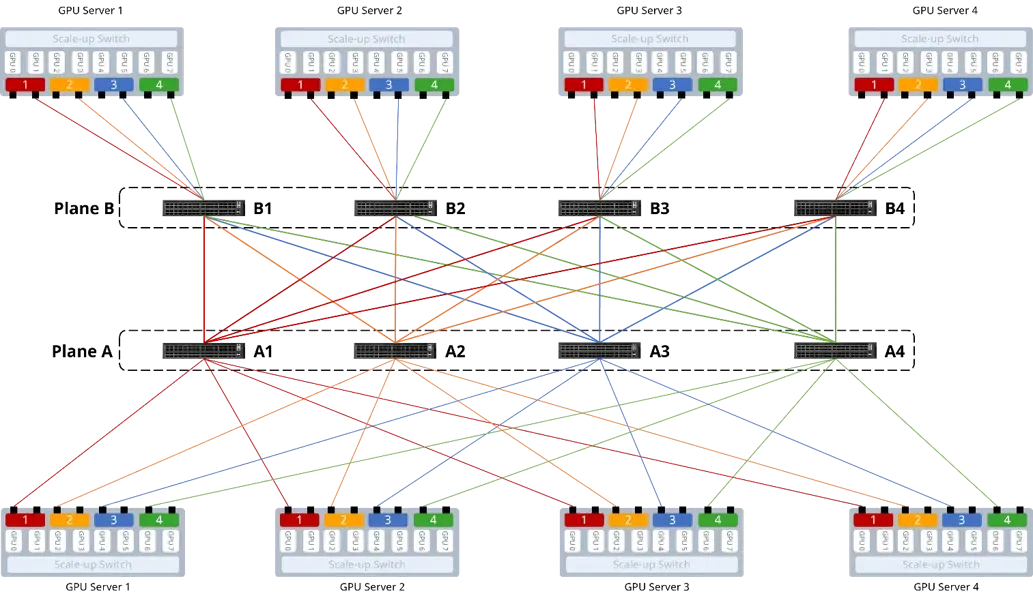
- 组网规模: 4 台 GPU 服务器 + 8 台 Leaf 交换机
- 接入效果: GPU Server 的多轨端口分别接入 A 平面 4 台 Leaf;Server 的单轨端口分别接入 B 平面的 4 台 Leaf;两组 Leaf 之间全互联。
在 Matrix 组网架构下,全网任意 GPU 间转发路径恒为两跳 :
GPU-A → 本组 Leaf → 对组 Leaf → GPU-B对于 PD 分离场景,这意味着任意 Prefill 节点到任意 Decode 节点的 KV Cache 传输,均只需经过 2 台交换机,路径最短且唯一。
流量转发路径
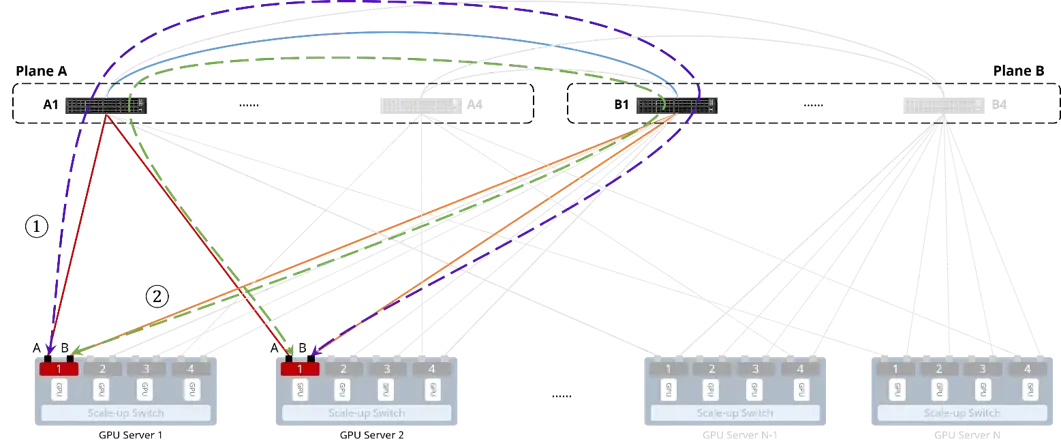
同轨通信:Server 1 的 1 号 GPU 访问 Server2 的 1 号 GPU:
- ① Server 1-1-A → Leaf A1 → Leaf B1 → Server 2-1-B两跳完成转发;
- ② Server 1-1-B → Leaf B1 → Leaf A1 → Server 2-1-A,两跳完成转发。
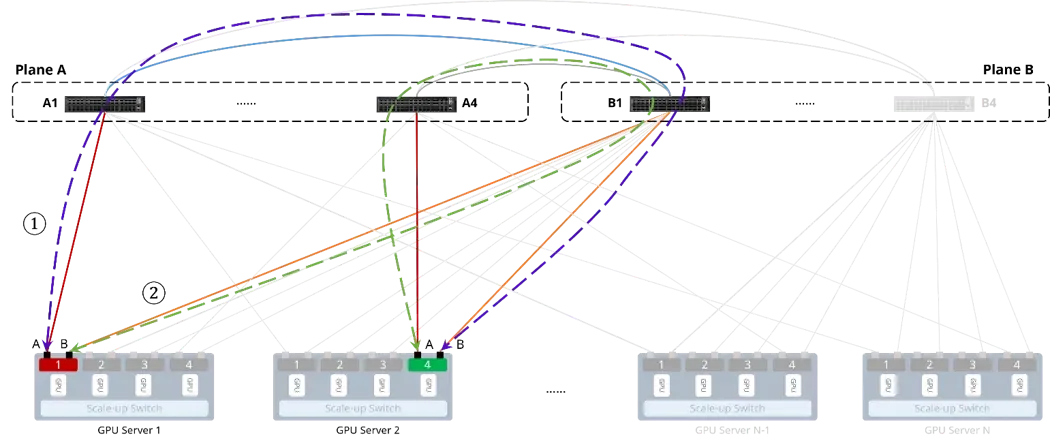
跨轨通信:Server 1 的 1 号 GPU 访问 Server2 的 4 号 GPU:
- ① Server 1-1-A → Leaf A1 → Leaf B1 → Server 2-4-B,两跳完成转发;
- ② Server 1-1-B → Leaf B1 → Leaf A4 → Server 2-4-A,两跳完成转发。
AsterFabric Matrix 关键技术
双端口接入与ARP-to-Host主机路由
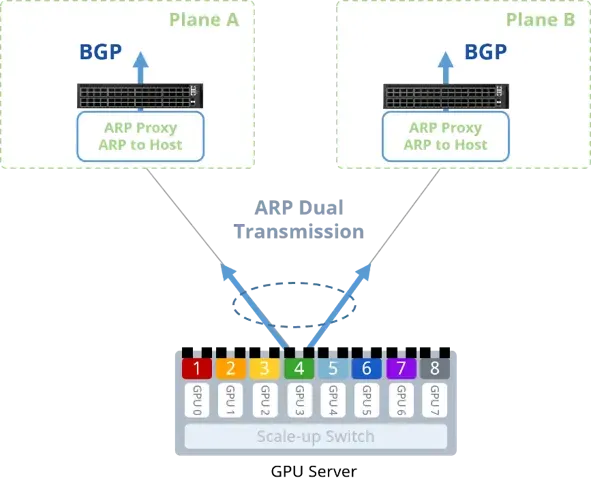
双平面接入不仅是物理布线问题,还要求地址学习和路由发布保持一致。参考方案采用以下机制:
- 服务器网卡以bond模式双上行,分别连接两个平面的Leaf。
- 网卡向两个上行端口双发ARP请求,使两侧Leaf均能学习服务器地址信息。
- Leaf通过ARP-to-Host功能,将ARP表项转换为主机路由。
- Leaf仅向另一平面发布直连GPU主机路由,减少不必要的前缀传播。
通过BGP策略约束转发路径
为了避免流量在同平面绕行或多次跨平面转发,路由策略需要主动限制非目标路径:
- 同组Leaf配置相同AS,并利用BGP AS路径属性过滤不符合要求的路由。
- A、B平面互联接口可采用IPv6 Link-local建立Unnumbered BGP邻居,减少互联地址规划。
- 仅发布必要的Host路由,控制路由表规模并简化故障收敛分析。
BGP在大规模数据中心中的应用方法,可参考权威文档外链建议:IETF RFC 7938《Use of BGP for Routing in Large-Scale Data Centers》。实际部署时,还应通过路由策略测试验证“不会多跳绕行”,而不能只检查邻居是否建立成功。
RoCE网络仍需端到端协同调优
无Spine和确定性两跳并不意味着可以忽略传输层。采用800G RoCE交换机构建AI推理网络时,仍需把服务器网卡、交换机队列、PFC、ECN及拥塞控制参数纳入统一联调。
建议重点监控跨平面链路利用率、队列深度、丢包与拥塞标记,并将这些指标与P99 TTFT关联分析。只有拓扑、路由和RoCE参数共同稳定,短路径优势才能转化为可观测的业务收益。
组网规模与成本:从1K GPU Pod到16K GPU集群
单Pod 1K GPU参考配置
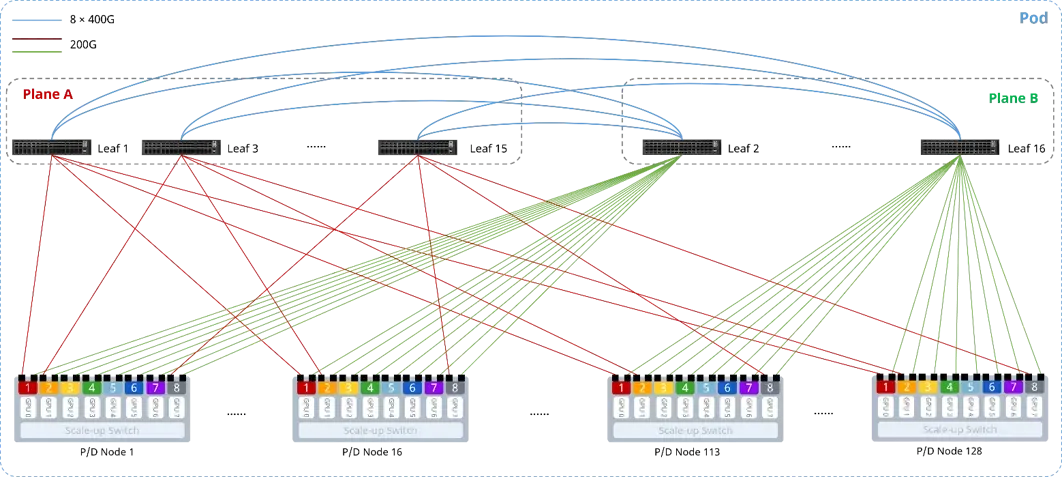
单Pod,1K GPU Matrix 组网
以每台搭载8个GPU的NVIDIA DGX H100服务器为例,单Pod部署16台Leaf,A、B平面各8台。服务器侧采用单GPU双200G接入,即每GPU总接入带宽400Gbps。
Leaf推荐配置为64个800GE端口的RoCE交换机,通过端口拆分提供:
- 128个200G接口,用于连接GPU服务器;
- 64个400G接口,用于A、B平面Leaf互联;
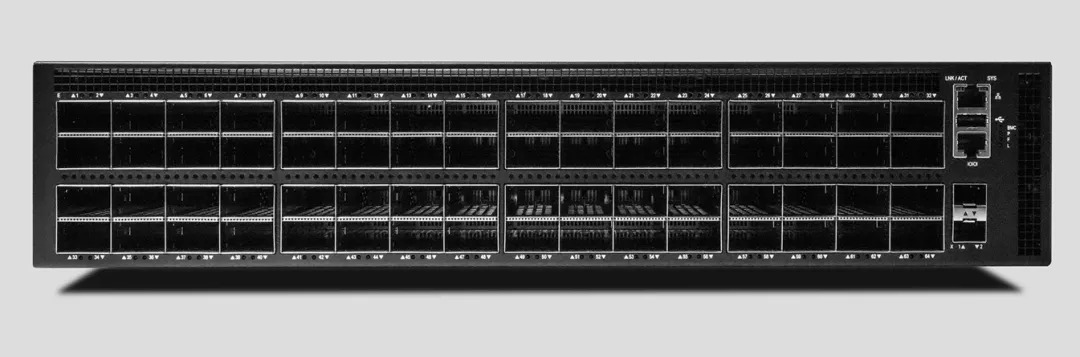
一半端口能力用于服务器接入,另一半用于跨平面互联,以支持1:1收敛比设计。
在该配置下,单Pod可接入128台GPU服务器,即1024个GPU;按照文档规划,最大可扩展至16个Pod,对应约16K GPU规模。
8K GPU集群硬件配置成本对比
以 8K GPU 集群规模为基准,对比AsterFabric ROFT、AsterFabric Dual-Mesh(轨道优化双平面网络)以及 AsterFabric Matrix 三种网络拓扑方案的硬件配置如下:
硬件项目 | ROFT | Dual-Mesh | Matrix |
|---|---|---|---|
交换机 | 192台 | 192台 | 128台 |
800G模块 | 12288个 | 12288个 | 8192个 |
400G模块 | 8192个 | — | — |
200G模块 | — | 16384个 | 16384个 |
线缆 | 12288条 | 12288条 | 10240条 |
在这组特定配置下,Matrix的交换机数量相比另外两种方案减少约33%,硬件成本下降约30%~40%。成本下降的主要来源不是单台设备价格,而是移除Spine后,交换机、部分高速光模块和线缆数量同步减少。
不过,30%~40%应理解为特定BOM下的参考测算,而非所有项目的固定节省比例。正式选型还应纳入光模块采购价格、备件、功耗、机房布线、运维工具及扩容预留,避免只比较交换机数量。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号