#WorkBuddy# 805 张现场码照片:一行 detectAndDecode 只读对 74.78%,还悄悄读错了 38 张
原创
#WorkBuddy# 805 张现场码照片:一行 detectAndDecode 只读对 74.78%,还悄悄读错了 38 张
原创
用户12784192
发布于 2026-10-29 11:06:07
发布于 2026-10-29 11:06:07
#WorkBuddy# 805 张现场码照片:一行 detectAndDecode 只读对 74.78%,还悄悄读错了 38 张
资产盘点季,最容易被当成"已经自动化"的活就是扫二维码。脚本很短,短到只有一行:读图、detectAndDecode、把字符串写进表格。跑完没有报错,进度条 100%,于是所有人都以为这 805 张照片已经变成 805 行数据了。
真实情况是:只读对 602 张(74.78%),读错 38 张(4.72%),剩下 165 张一个字都没读出来。更麻烦的是那 38 张——它们不是"失败",它们返回了一个格式完全合法、肉眼完全看不出问题的码值,混在结果表里,跟正确的行一模一样。
这篇文章把这件事完整跑了一遍:造 805 张合成语料、三级流水线对比、把每个环节的失败原因拆开、最后给出可复制的治理代码。所有数字都来自本机实测,语料和脚本都可复现。
一、语料是怎么造出来的
没有用任何真实照片。用 OpenCV 自带的编码器现场生成 800 个唯一资产码,payload 形如 WBA-2604-B1-00042-VALVE-60926:
- 前 4 段是批号、区域、序号、类型;
- 第 5 段是校验位——前 4 段做 crc32 再对 100000 取模。
然后把码贴到合成"现场照片"上(渐变底 + 随机色块 + 纹理噪声),按 12 类真实退化分别施加:清晰、超小码、小角度倾斜、90° 旋转、透视、高斯模糊、低对比度、椒盐噪声、局部遮挡、低照度、双码同图、强反光。共 805 张(含 4 张中文文件名、5 组同一资产被拍两次的重复图),合计 959.30 MiB。
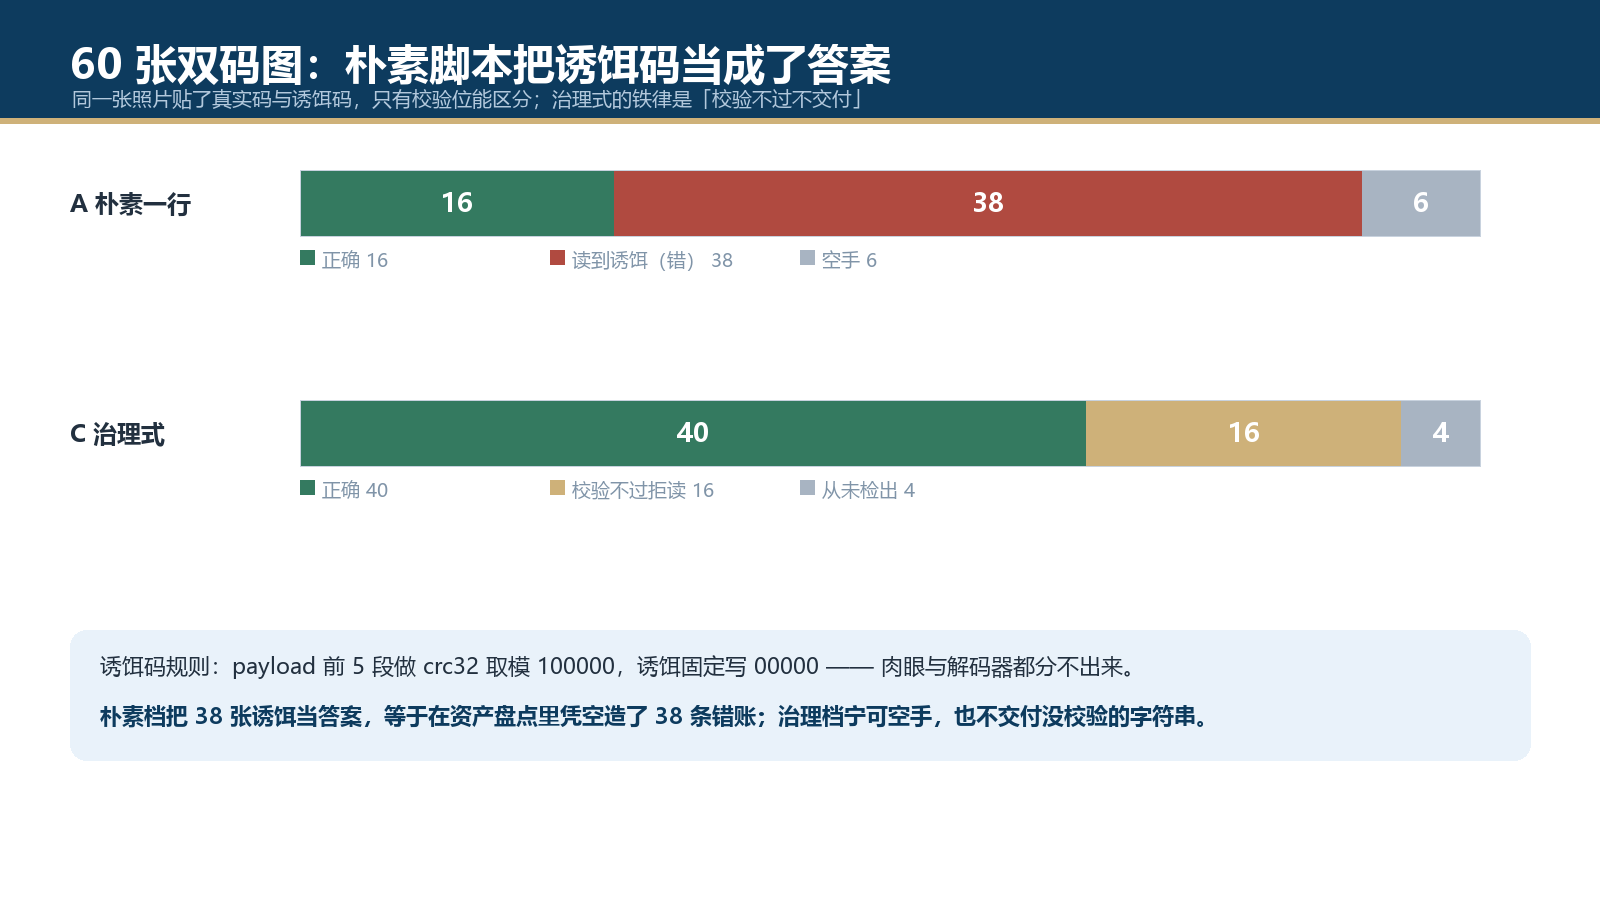
真值表 truth.json 记录每张图的有效码和诱饵码。判分标准只有一个:读出的字符串与有效码逐字符相同才算对,读到诱饵码算"错读",读不出算"空手"。
二、三档流水线的实测结果
档位 | 做法 | 正确 | 正确率 | 错读 | 空手 | 耗时 | 单张 |
|---|---|---|---|---|---|---|---|
A 朴素 | 读图 → 直接 | 602 | 74.78% | 38 | 165 | 70.7 s | 88 ms |
B 半治理 | 灰度 + 4 向旋转 + 2× 放大 | 666 | 82.73% | 41 | 98 | 191.2 s | 238 ms |
C 治理式 | 多预处理 × 多角度 × 分块 + 校验投票 | 708 | 87.95% | 0 | 97 | 961.0 s | 1194 ms |
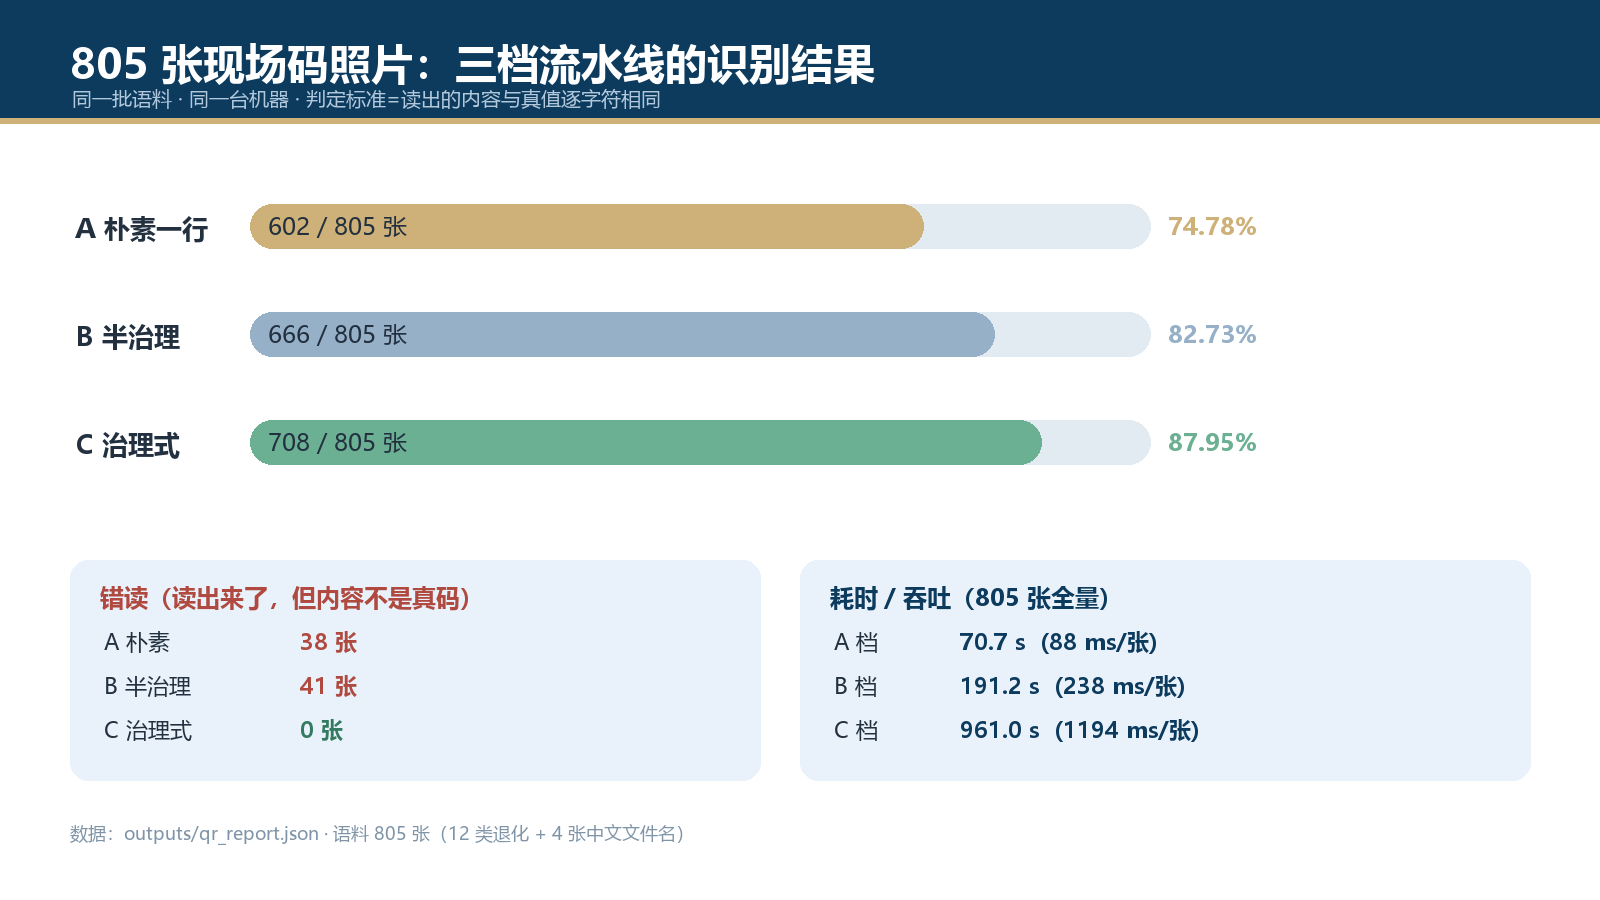
三个数字值得盯住:
- B 档的错读比 A 还多(41 vs 38)。 加了旋转和放大,能读出来的码变多了,但"能读出来"里混进了更多诱饵码。提升召回的同时放大了误报,这是典型的"只优化识别率、不设准入校验"的后果。
- C 档错读归零,靠的不是更强的解码,而是一条策略:校验位不过的字符串一律不交付。 有 16 张它其实读到了诱饵码,但拒绝返回,宁可空手。
- 87.95% 才是这批语料的真实天花板。 剩下 97 张不是"再调调参就能救",后面第四节解释为什么。
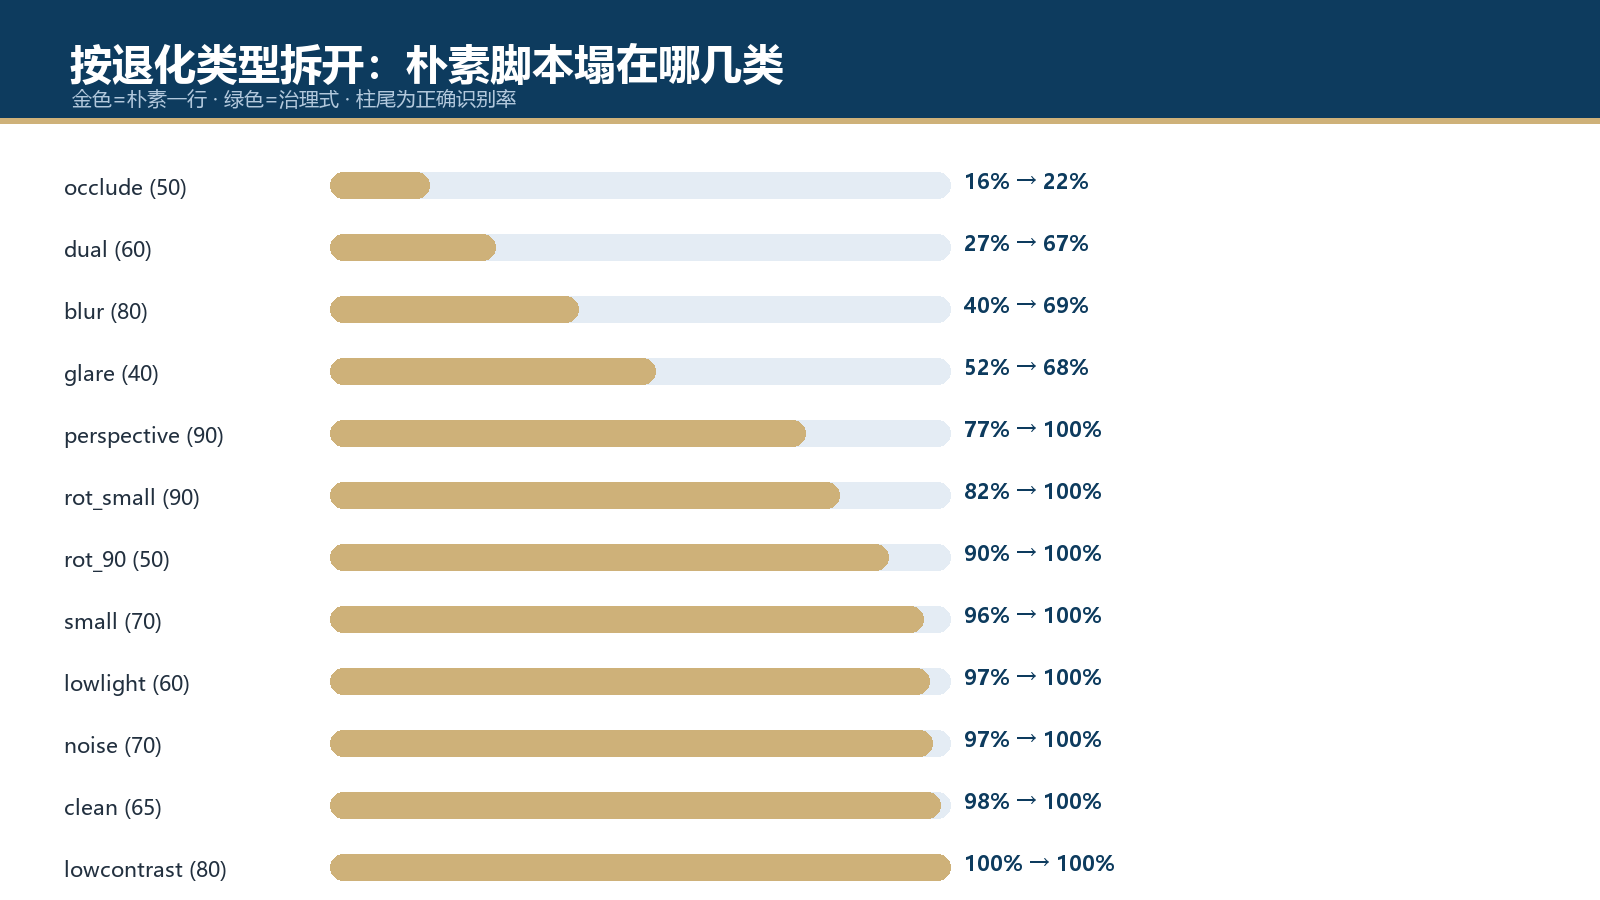
按退化类型拆开看,塌方点非常集中:
退化类型 | 张数 | A 档 | C 档 |
|---|---|---|---|
occlude 局部遮挡 | 50 | 16% | 22% |
dual 双码同图 | 60 | 27% | 67% |
blur 高斯模糊 | 80 | 40% | 69% |
glare 强反光 | 40 | 52% | 68% |
perspective 透视 | 90 | 77% | 100% |
rot_small 小角度 | 90 | 82% | 100% |
rot_90 直角旋转 | 50 | 90% | 100% |
small 超小码 | 70 | 96% | 100% |
lowlight 低照度 | 60 | 97% | 100% |
noise 噪声 | 70 | 97% | 100% |
clean 清晰 | 65 | 98% | 100% |
lowcontrast 低对比度 | 80 | 100% | 100% |
三、四个根因,都是实测出来的
根因一:码的绝对像素太小,检测器直接放弃。 同一个 payload 固定尺寸渲染,只改模块边长:模块 1.4 px 时总边长 52 px,A、C 都读不出;模块 1.8 px(67 px)起 C 能读出、A 仍然空手;模块 3.0 px(111 px)A 依旧失败,模块 6.0 px(222 px)A 才成功。也就是说,A 档的隐性门槛是"码的边长 ≳ 200 px"。照片里远一点、小一点,脚本就静默空手——不报错,只是少一行。
根因二:中心遮挡 5% 就足以让解码器全盘放弃。 拿一个干净码,在正中心贴一块灰色方块,只改面积占比:
遮挡面积 | 0% | 5% | 10% | 15% | 20% | 25% | 30% | 35% |
|---|---|---|---|---|---|---|---|---|
结果 | 读出 | 空 | 空 | 空 | 空 | 空 | 空 | 空 |
注意 5% 就空了。这不是纠错容量的问题——QR 的纠错码本来能扛 7%~30% 的破损。真正的原因是:OpenCV 的 QRCodeDetector 不做擦除标记(erasure decoding),它把被遮住的模块当成"读错的模块",纠错码很快被这些错误字符耗尽。所以 occlude 那 50 张里,C 档也只救回 11 张:29 张确实超出了能力边界,21 张是"信息还在、解码器不会用"。
根因三:解码成功 ≠ 内容正确。 60 张双码图里,大而清晰的诱饵码和小而略糊的真实码同框。A 档读到 16 张真码、38 张诱饵码、6 张空手。诱饵码的 payload 结构、长度、字符集跟真码完全一致,唯一区别是校验位写死 00000。解码器没有任何办法知道哪个是你要的资产——它只负责把图案变成字符串。这 38 张如果直接入库,就是 38 条凭空生成的错账。
根因四:中文路径下 cv2.imread 静默返回 None。 实测 5 个中文命名的文件,cv2.imread 全部返回 None,日志里只有一行 loadsave.cpp:278 ... can't open/read file;改成 np.fromfile + cv2.imdecode 后 5 个全部正常。没有异常抛出,后续 cvtColor(None) 才报错,堆栈指在离真凶很远的地方。
四、治理式流水线:三段递进 + 一条铁律
核心不是"多试几次",而是三件事:分级尝试、校验准入、按票数收敛。
import re, zlib
import numpy as np
import cv2

PAT = re.compile(r"^WBA-\d{4}-[A-Z]\d-\d{5}-[A-Z]+-(\d{5})$")
DET = cv2.QRCodeDetector()

def payload_ok(p: str) -> bool:
    """铁律第一层:结构 + 校验位。不过就是不过。"""
    if not p:
        return False
    m = PAT.match(p.strip())
    if not m:
        return False
    body = p.strip().rsplit("-", 1)[0]
    return "%05d" % (zlib.crc32(body.encode()) % 100000) == m.group(1)

def load_any(path: str):
    """中文/非 ASCII 路径专用:imread 会静默返回 None"""
    buf = np.fromfile(path, np.uint8)
    return cv2.imdecode(buf, cv2.IMREAD_COLOR)

def decode_multi(img):
    """兼容不同版本的 detectAndDecodeMulti 返回值"""
    out = []
    try:
        r = DET.detectAndDecodeMulti(img)
        if r[0]:
            out += [s for s in r[1] if s]
    except Exception:
        pass
    try:
        d, _, _ = DET.detectAndDecode(img)
        if d:
            out.append(d)
    except Exception:
        pass
    return out

def variants(img):
    """预处理族:灰度 / 2× 放大 / CLAHE / 自适应二值 / 反锐化"""
    g = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
    yield g
    yield cv2.resize(g, None, fx=2, fy=2, interpolation=cv2.INTER_CUBIC)
    yield cv2.createCLAHE(clipLimit=3.0, tileGridSize=(8, 8)).apply(g)
    yield cv2.adaptiveThreshold(g, 255, cv2.ADAPTIVE_THRESH_GAUSSIAN_C,
                               cv2.THRESH_BINARY, 41, 9)
    soft = cv2.GaussianBlur(g, (0, 0), 1.1)
    yield cv2.addWeighted(g, 1.7, soft, -0.7, 0)

def rotate(img, ang):
    if ang == 0:
        return img
    h, w = img.shape[:2]
    M = cv2.getRotationMatrix2D((w / 2, h / 2), ang, 1.0)
    return cv2.warpAffine(img, M, (w, h), flags=cv2.INTER_LINEAR, borderValue=255)

def solve(img):
    votes, seen_bad = {}, set()
    # 第 1 轮:预处理族 × 直角四向
    for im in variants(img):
        for ang in (0, 90, 180, 270):
            for p in decode_multi(rotate(im, ang)):
                if payload_ok(p):
                    votes[p.strip()] = votes.get(p.strip(), 0) + 1
                else:
                    seen_bad.add(p.strip())
        if votes:
            break
    # 第 2 轮:小角度纠偏,专治手持拍歪
    if not votes:
        for im in variants(img):
            for ang in (5, -5, 10, -10, 15, -15):
                for p in decode_multi(rotate(im, ang)):
                    if payload_ok(p):
                        votes[p.strip()] = votes.get(p.strip(), 0) + 1
            if votes:
                break
    # 第 3 轮:分块扫描,专治"码在大图角落里很小"
    if not votes:
        h, w = img.shape[:2]
        g = cv2.cvtColor(img, cv2.COLOR_BGR2GRAY)
        for fy in (0.0, 0.35):
            for fx in (0.0, 0.35):
                tile = g[int(fy * h):int(fy * h + 0.65 * h),
                         int(fx * w):int(fx * w + 0.65 * w)]
                if tile.size == 0:
                    continue
                for sc in (2, 3):
                    up = cv2.resize(tile, None, fx=sc, fy=sc,
                                    interpolation=cv2.INTER_CUBIC)
                    for p in decode_multi(up):
                        if payload_ok(p):
                            votes[p.strip()] = votes.get(p.strip(), 0) + 1
                if votes:
                    break
            if votes:
                break
    # 铁律第二层:一票都没有就交白卷,绝不返回 seen_bad 里的任何东西
    return max(votes, key=votes.get) if votes else ""
两个设计点值得说明。
为什么用投票而不是"第一个成功就返回"。 双码图里两个码都可能被读到,投票能选出被多个预处理通道共同确认的那个;单通道偶然读出的字符串票数为 1,自然排不到第一。C 档 60 张双码图从 27% 提到 67%,靠的就是这一步。
为什么最后一层是 return "" 而不是 return seen_bad[0]。 这是整篇文章唯一需要业务方拍板的地方。返回一个校验不过的字符串,上游会当成数据写进库;返回空字符串,上游只会把这张图放进"待人工复核"队列。错读的成本远高于漏读——漏读最多是缺一行,错读是错一行且没人知道。
五、分层调度:87.95% 的识别率,能不能不那么贵
C 档单张 1194 ms,805 张跑 961 秒。直接上 C 档做全量,在几千张的量级上就是不可接受的。于是测了分层调度:先用 A 档全量快速过一遍,只把 A 失败(空手或校验不过)的图送进 C 档。
策略 | 识别率 | 总耗时 | 单张 |
|---|---|---|---|
全量 C 档 | 87.95% | 961.0 s | 1194 ms |
分层:A 全量 + C 兜底 | 87.95% | 823.9 s | 1023 ms |
A 档 203 张失败图里,C 救回 106 张(602 + 106 = 708,与全量 C 完全一致)。耗时只降了 14%,因为救回来的那 106 张恰好就是最费时的(要跑完全部三轮)。
更值得注意的是尾部延迟:C 档中位数 344 ms,p90 已经到 4732 ms,最慢一张 9945 ms(近 10 秒)。A 档中位数 82 ms、p90 111 ms、最慢 345 ms。批处理脚本如果按平均耗时估容量,会被这 1% 的长尾拖垮——要么设单张超时,要么把长尾图直接扔进复核队列。
六、踩坑清单
现象 | 根因 | 解法 |
|---|---|---|
中文/特殊字符路径的图全部读不出,无报错 |
|
|
明明贴得很清楚,就是读不出 | 码的绝对边长 < 200 px,检测器放弃 | 先按 2×/3× 放大再解,或分块放大 |
遮挡一小块就全盘失败 |
| 只能换解码器(如支持 erasure 的实现)或重拍 |
| 不同 OpenCV 版本返回 3 元组或 4 元组 |
|
加了旋转和放大后,错读反而变多 | 只优化了召回,没有准入校验 | 校验位/结构校验,不过不交付 |
结果表里混着"合法但错"的码 | 解码成功被当成业务正确 | 投票 + 校验 + 拒读策略 |
批处理耗时估算离谱 | 长尾(p90 是均值的 4 倍) | 设单张超时,长尾进复核队列 |
七、给 WorkBuddy 的提示词模板
帮我写一个二维码批量识别脚本,要求: 1. 目录里所有 jpg/png,逐张识别,输出 CSV:文件名, 码值, 状态, 耗时ms; 2. 状态只能是三种:ok(校验通过)、reject(读到了但校验不过)、miss(没读到); 3. 码值格式校验:匹配
^WBA-\d{4}-[A-Z]\d-\d{5}-[A-Z]+-(\d{5})$,第 5 段必须等于前 4 段 crc32 对 100000 取模,不过就判 reject,不要把 reject 的值写进码值列; 4. 读取用 np.fromfile + cv2.imdecode,不要用 cv2.imread(中文路径会静默失败); 5. 分级解码:先灰度原图,失败再试 2× 放大、CLAHE、自适应二值、反锐化,每档配 0/90/180/270 四向;仍失败再试 ±5/±10/±15 度;仍失败再分块放大扫描; 6. 同一张图多次读出不同码值时按票数取最高,票数相同则全部判 reject 并标注 conflict; 7. 全部失败的单张超时 10 秒,超时的记 miss 并单独列一张"待重拍"清单; 8. 最后打印:总数、ok/reject/miss 各多少、识别率、错读数(若有)、总耗时、中位与 p90 单张耗时。
模板里第 3 条和第 8 条是关键。前者把"校验不过"变成一等公民,后者逼脚本自己报出"错读数"——一个不敢报错读数的批处理脚本,通常是因为它压根没在判对错。
八、这件事真正的结论
二维码识别的难点从来不在"识别",而在"判对"。detectAndDecode 这一行 API 把 99% 的复杂度藏了起来,代价是它把"读到了"和"读对了"压成了同一个返回值。
805 张语料跑下来,朴素脚本 74.78% 正确、38 张错读;治理式 87.95% 正确、0 张错读;剩下 97 张里,39 张是遮挡、25 张是糊到无法恢复、20 张是双码里的小码读不出、13 张是强反光——这些是采集端的物理问题,任何后处理都救不回来,正确的动作是把它们列成一张"重拍清单"交给现场,而不是继续调阈值硬猜。
把 12% 的不可用老老实实标出来,比把它藏进 100% 的"成功率"里,值钱得多。
本文语料、脚本、真值表均为本机现场生成与实测,与任何真实业务数据无关。测试环境:Windows 11 / Python 3.13.14 / OpenCV 5.0.0 / NumPy 2.5.3。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号