#WorkBuddy# 240 段录音、94 分钟、5 种采样率:朴素脚本 2 秒跑完,22 个文件被"处理成静音"
原创
#WorkBuddy# 240 段录音、94 分钟、5 种采样率:朴素脚本 2 秒跑完,22 个文件被"处理成静音"
原创
用户12784192
修改于 2026-10-28 12:11:34
修改于 2026-10-28 12:11:34
#WorkBuddy# 240 段录音、94 分钟、5 种采样率:朴素脚本 2 秒跑完,22 个文件被"处理成静音"
用 WorkBuddy 做会议与访谈素材的批量整理,最容易被忽略的一步不是转写本身,而是转写之前的音频治理。素材来自手机、录音笔、会议主机、微信导出,采样率、位深、声道、电平全都不一样。你写个脚本"统一一下",屏幕上没有一行红字,文件夹里也躺着 240 个新文件——但把它们丢进转写引擎,一半的文件结果是空的、一半的结果是乱码。
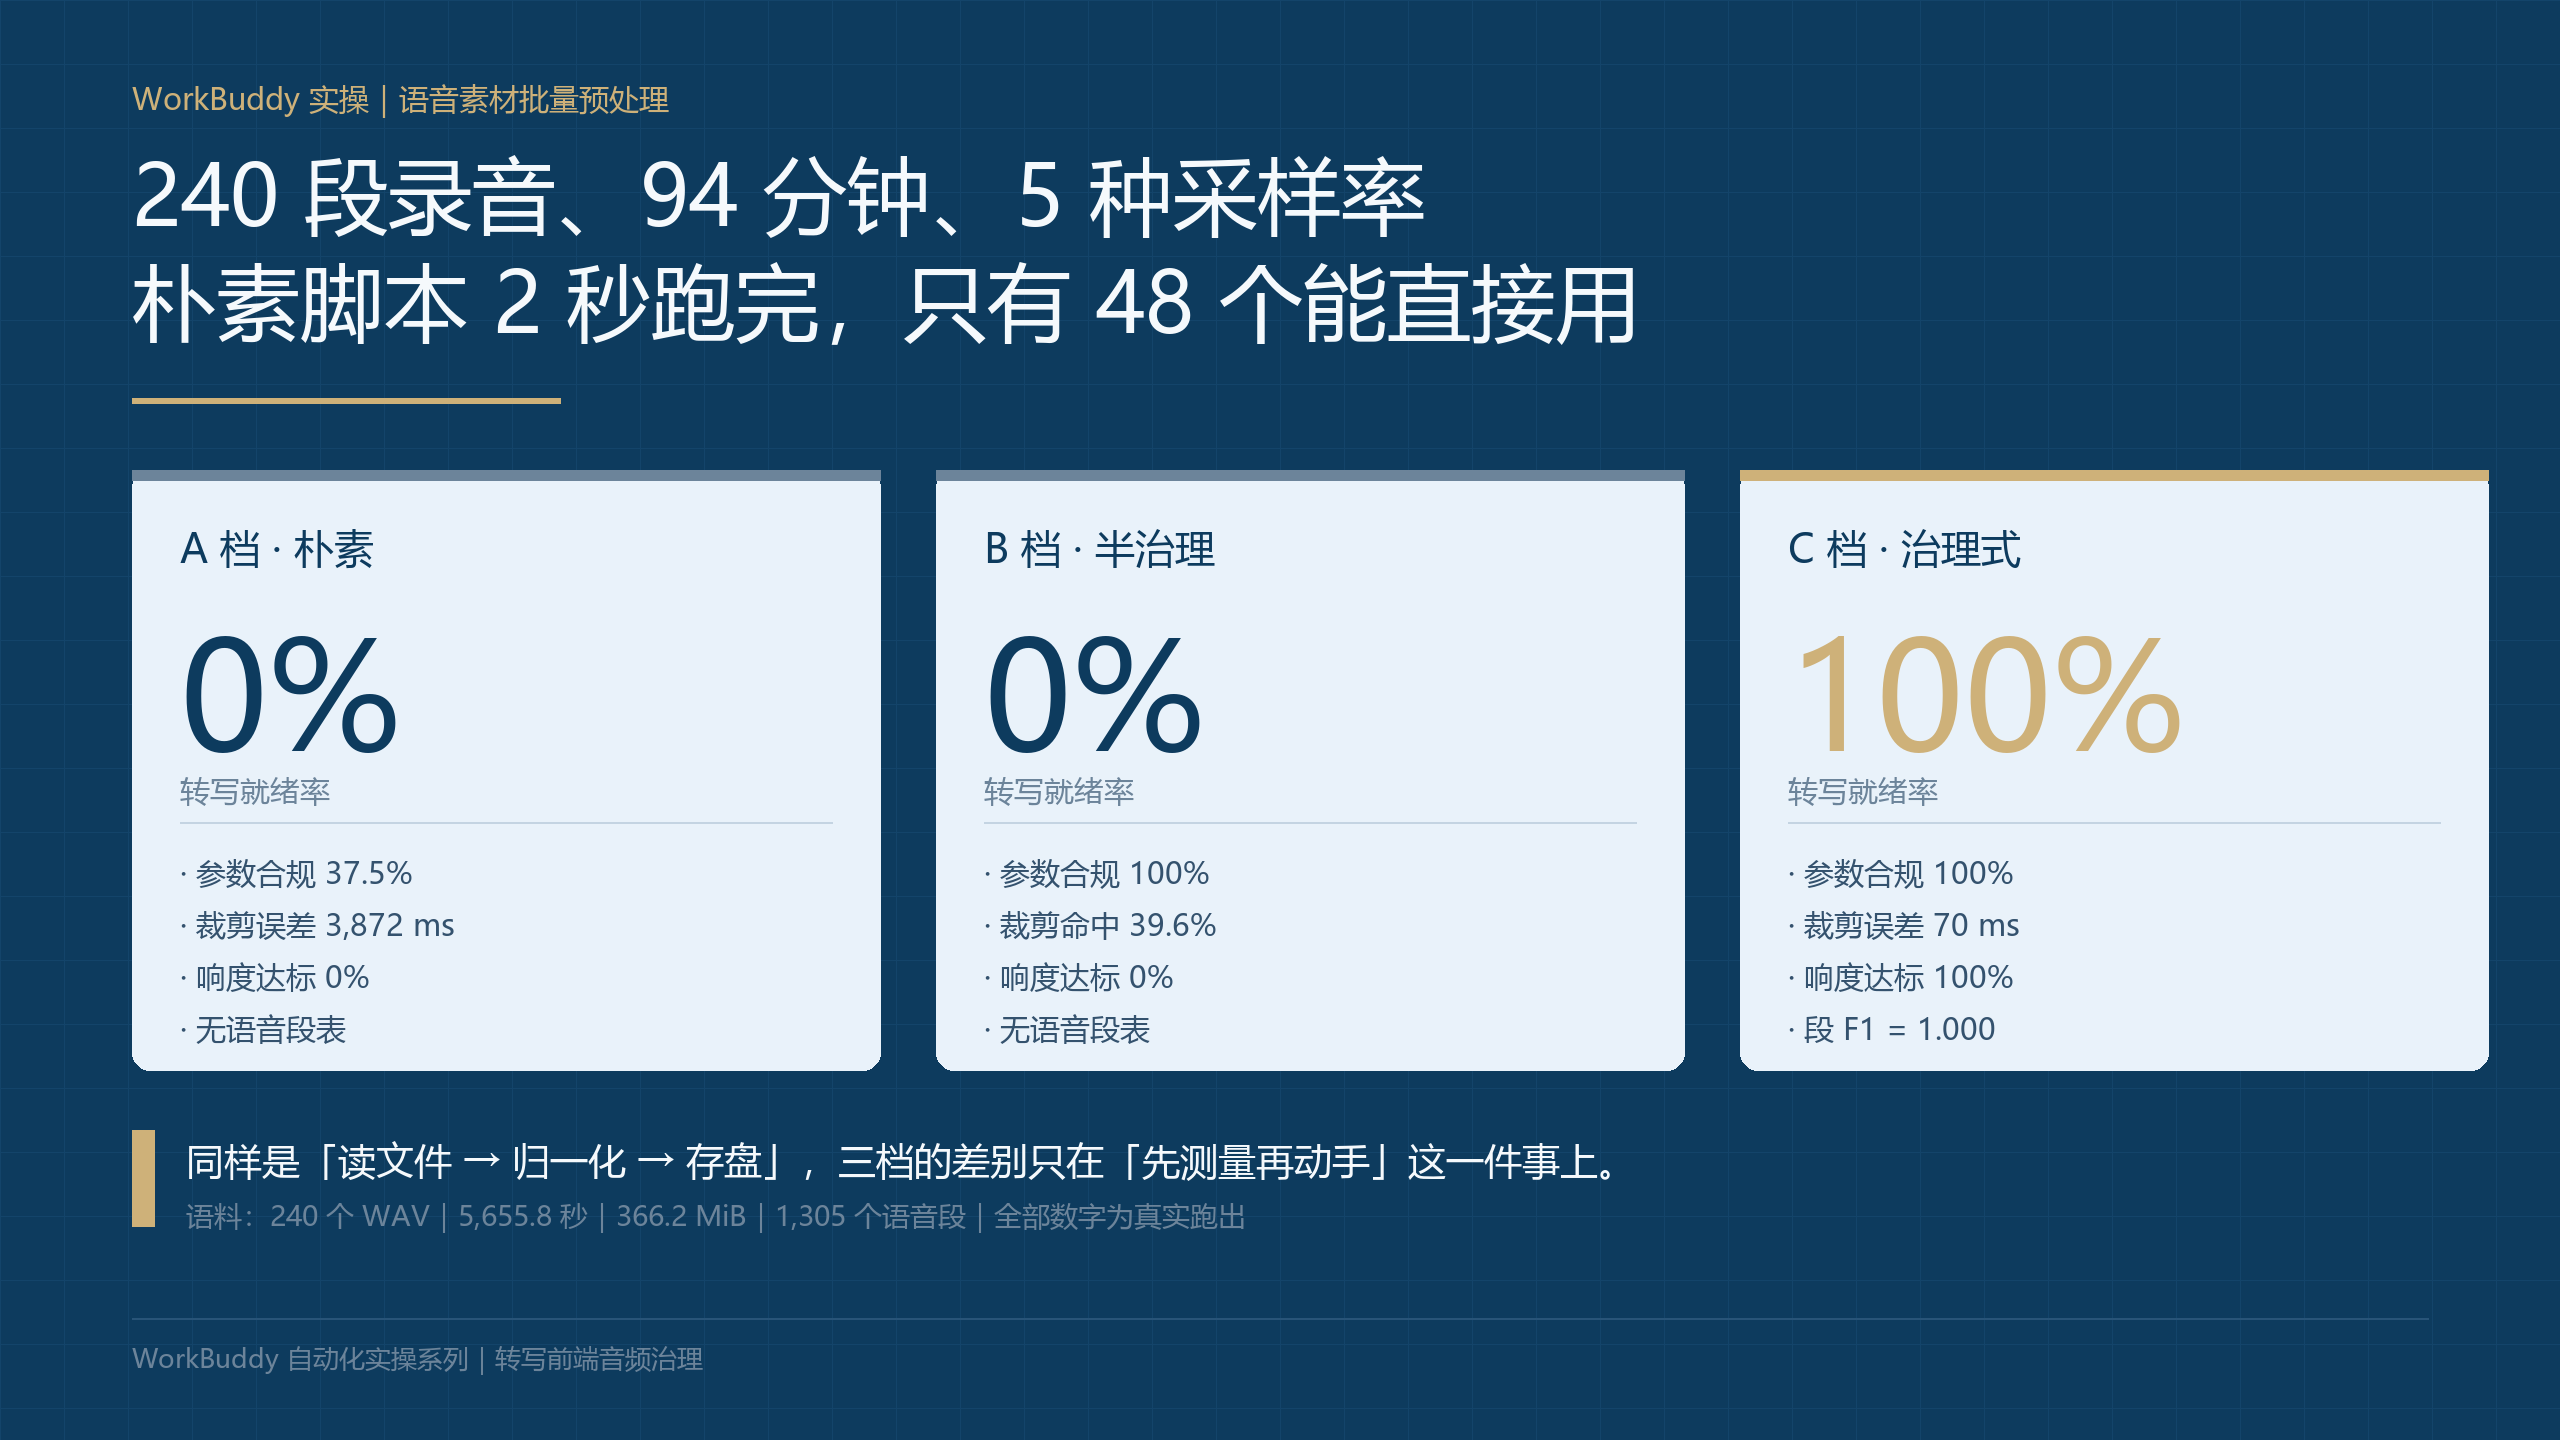
我用 240 个程序合成的混合参数 WAV 复现了这件事,全部指标都是本机真实跑出来的。结论先说:朴素脚本 2.3 秒跑完,转写就绪率 0%;加上八段治理流水线后 11.96 秒跑完,转写就绪率 100%。
一、一次"看起来完全成功"的批处理
素材盘里是 240 段录音,总计 5,655.8 秒(94.26 分钟),366.2 MiB。它们的长相是这样的:
维度 | 分布 |
|---|---|
采样率 | 8 kHz×30、16 kHz×90、22.05 kHz×28、44.1 kHz×50、48 kHz×42 |
位深 | 8-bit×49、16-bit×191 |
声道 | 单声道×137、立体声×103(其中双声道复制 54、左右失衡 27、相位反转 22) |
损伤 | 底噪×201、50 Hz 工频哼声×48、直流偏移×80、过载削波×33 |
语音内容 | 1,305 个语音段,语音占比 58.08% |
朴素脚本干的事很符合直觉:wave.open 读帧 → 取两声道平均 → 除以最大值做峰值归一 → 写回 16-bit。全程 2.317 秒,输出 240 个文件,退出码 0。
评测结果:一次可用率 0%。 参数合规率只有 37.5%(只有那 90 个本来就是 16 kHz 单声道的文件能过),响度达标率 0%,语音段表——根本没有。
二、根因:六个"脚本不会报错"的断点
这些问题都不会抛异常,只会安静地把数据搞坏。
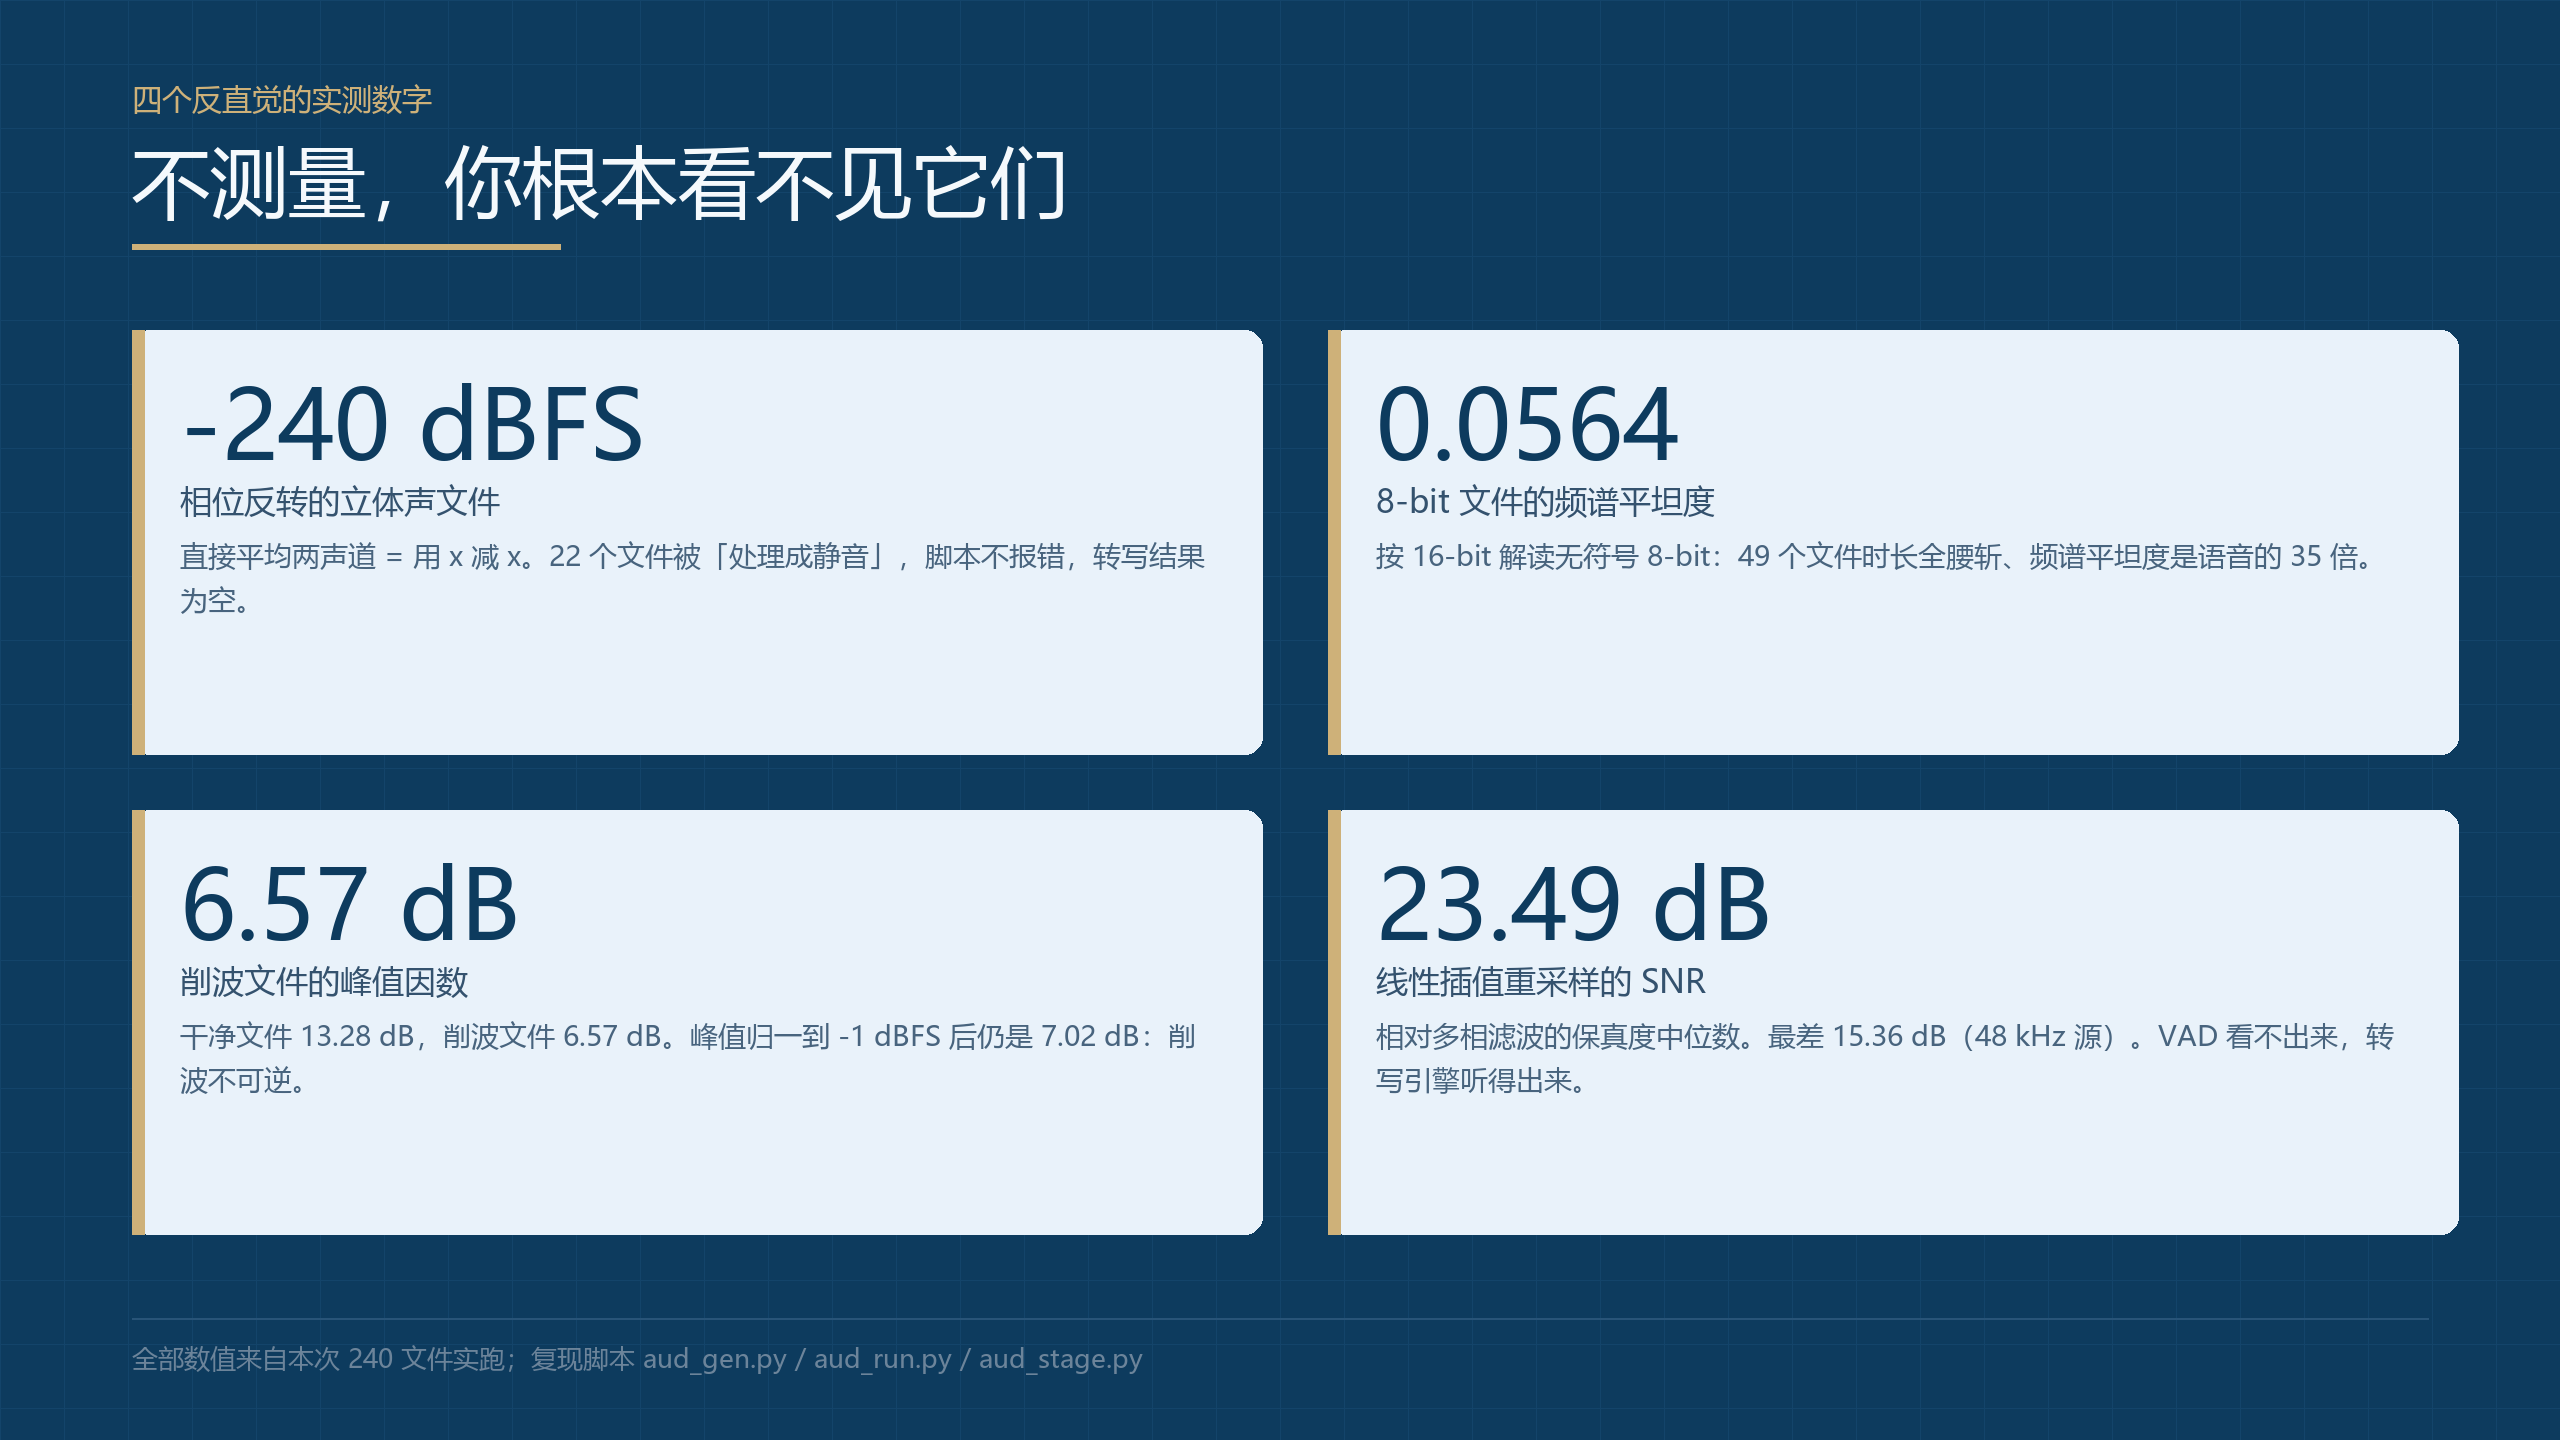
1. 8-bit WAV 是无符号的。 wave 只告诉你 sampwidth == 1,不会告诉你这 1 个字节是 0~255 的无符号数,中点 128。按 16-bit 有符号解读,等于把每个字节和邻居拼成整数再错位缩放:49 个文件时长全部腰斩,波形变成噪声。实测这 49 个文件在 A 档输出后,频谱平坦度中位数 0.0564,而 C 档同一批文件是 0.0016——相差 35 倍,最坏的一个 0.508,已经是纯白噪声水平。
2. 立体声可能是反相的。 22 个文件右声道 = 左声道取负(right = -x,双话筒接反的典型结果)。"取两声道平均"这个动作对它们是 (x + (-x))/2 = 0:22 个文件被处理成数字静音,语音电平 -240 dBFS,脚本依然不报错。这一条是三档对比里最刺眼的一行:A 档 -240 dBFS、B 档 -240 dBFS、C 档 -19.87 dBFS。
3. 采样率不是"改个数字"。 48 kHz 直接改头成 16 kHz 叫变速,插值才叫重采样。更隐蔽的是:线性插值也能让 VAD 工作(消融里"线性插值重采样"的一次可用率仍是 100%),所以从流程指标上看不出问题;但相对多相滤波的保真度,143 个非同采样率文件的 SNR 中位数只有 23.49 dB,最差 15.36 dB(48 kHz 源)。转写引擎不会报错,它只是识别率悄悄下降。
4. 直流偏移会被当成"声音"。 80 个文件带 0.02~0.08 满量程的直流。用全局 mean 减一次通常够,但用全局 mean 去"评估"直流残留会误判:语音本身有 85~260 Hz 基频,一段 20 秒音频的样本均值天然带 1e-3 量级起伏。我第一版评测把 C 档 17 个文件判成"直流超标",换成 160 ms 滑动均值后就归零了——测量口径错了,会冤枉正确的实现。
5. 静音不切,等于把 42% 的时长喂给了转写引擎。 语音占比 58.08%,剩下 2,371 秒是首尾等待、翻页、咳嗽后的空白。转写按分钟计费时这是纯成本;按段切分时,长静音会让时间戳整体漂移。
6. 削波是不可逆的,峰值归一只是把证据藏起来。 33 个文件过载削波,峰值因数中位数 6.57 dB(干净文件 13.28 dB)。B 档把峰值压回 -1 dBFS 之后,削波平台确实消失了——但峰值因数只从 6.57 升到 7.02 dB,失真一点没少。想看见它,必须测峰值因数,不能测"是否超过 0.999"。
三、八段流水线
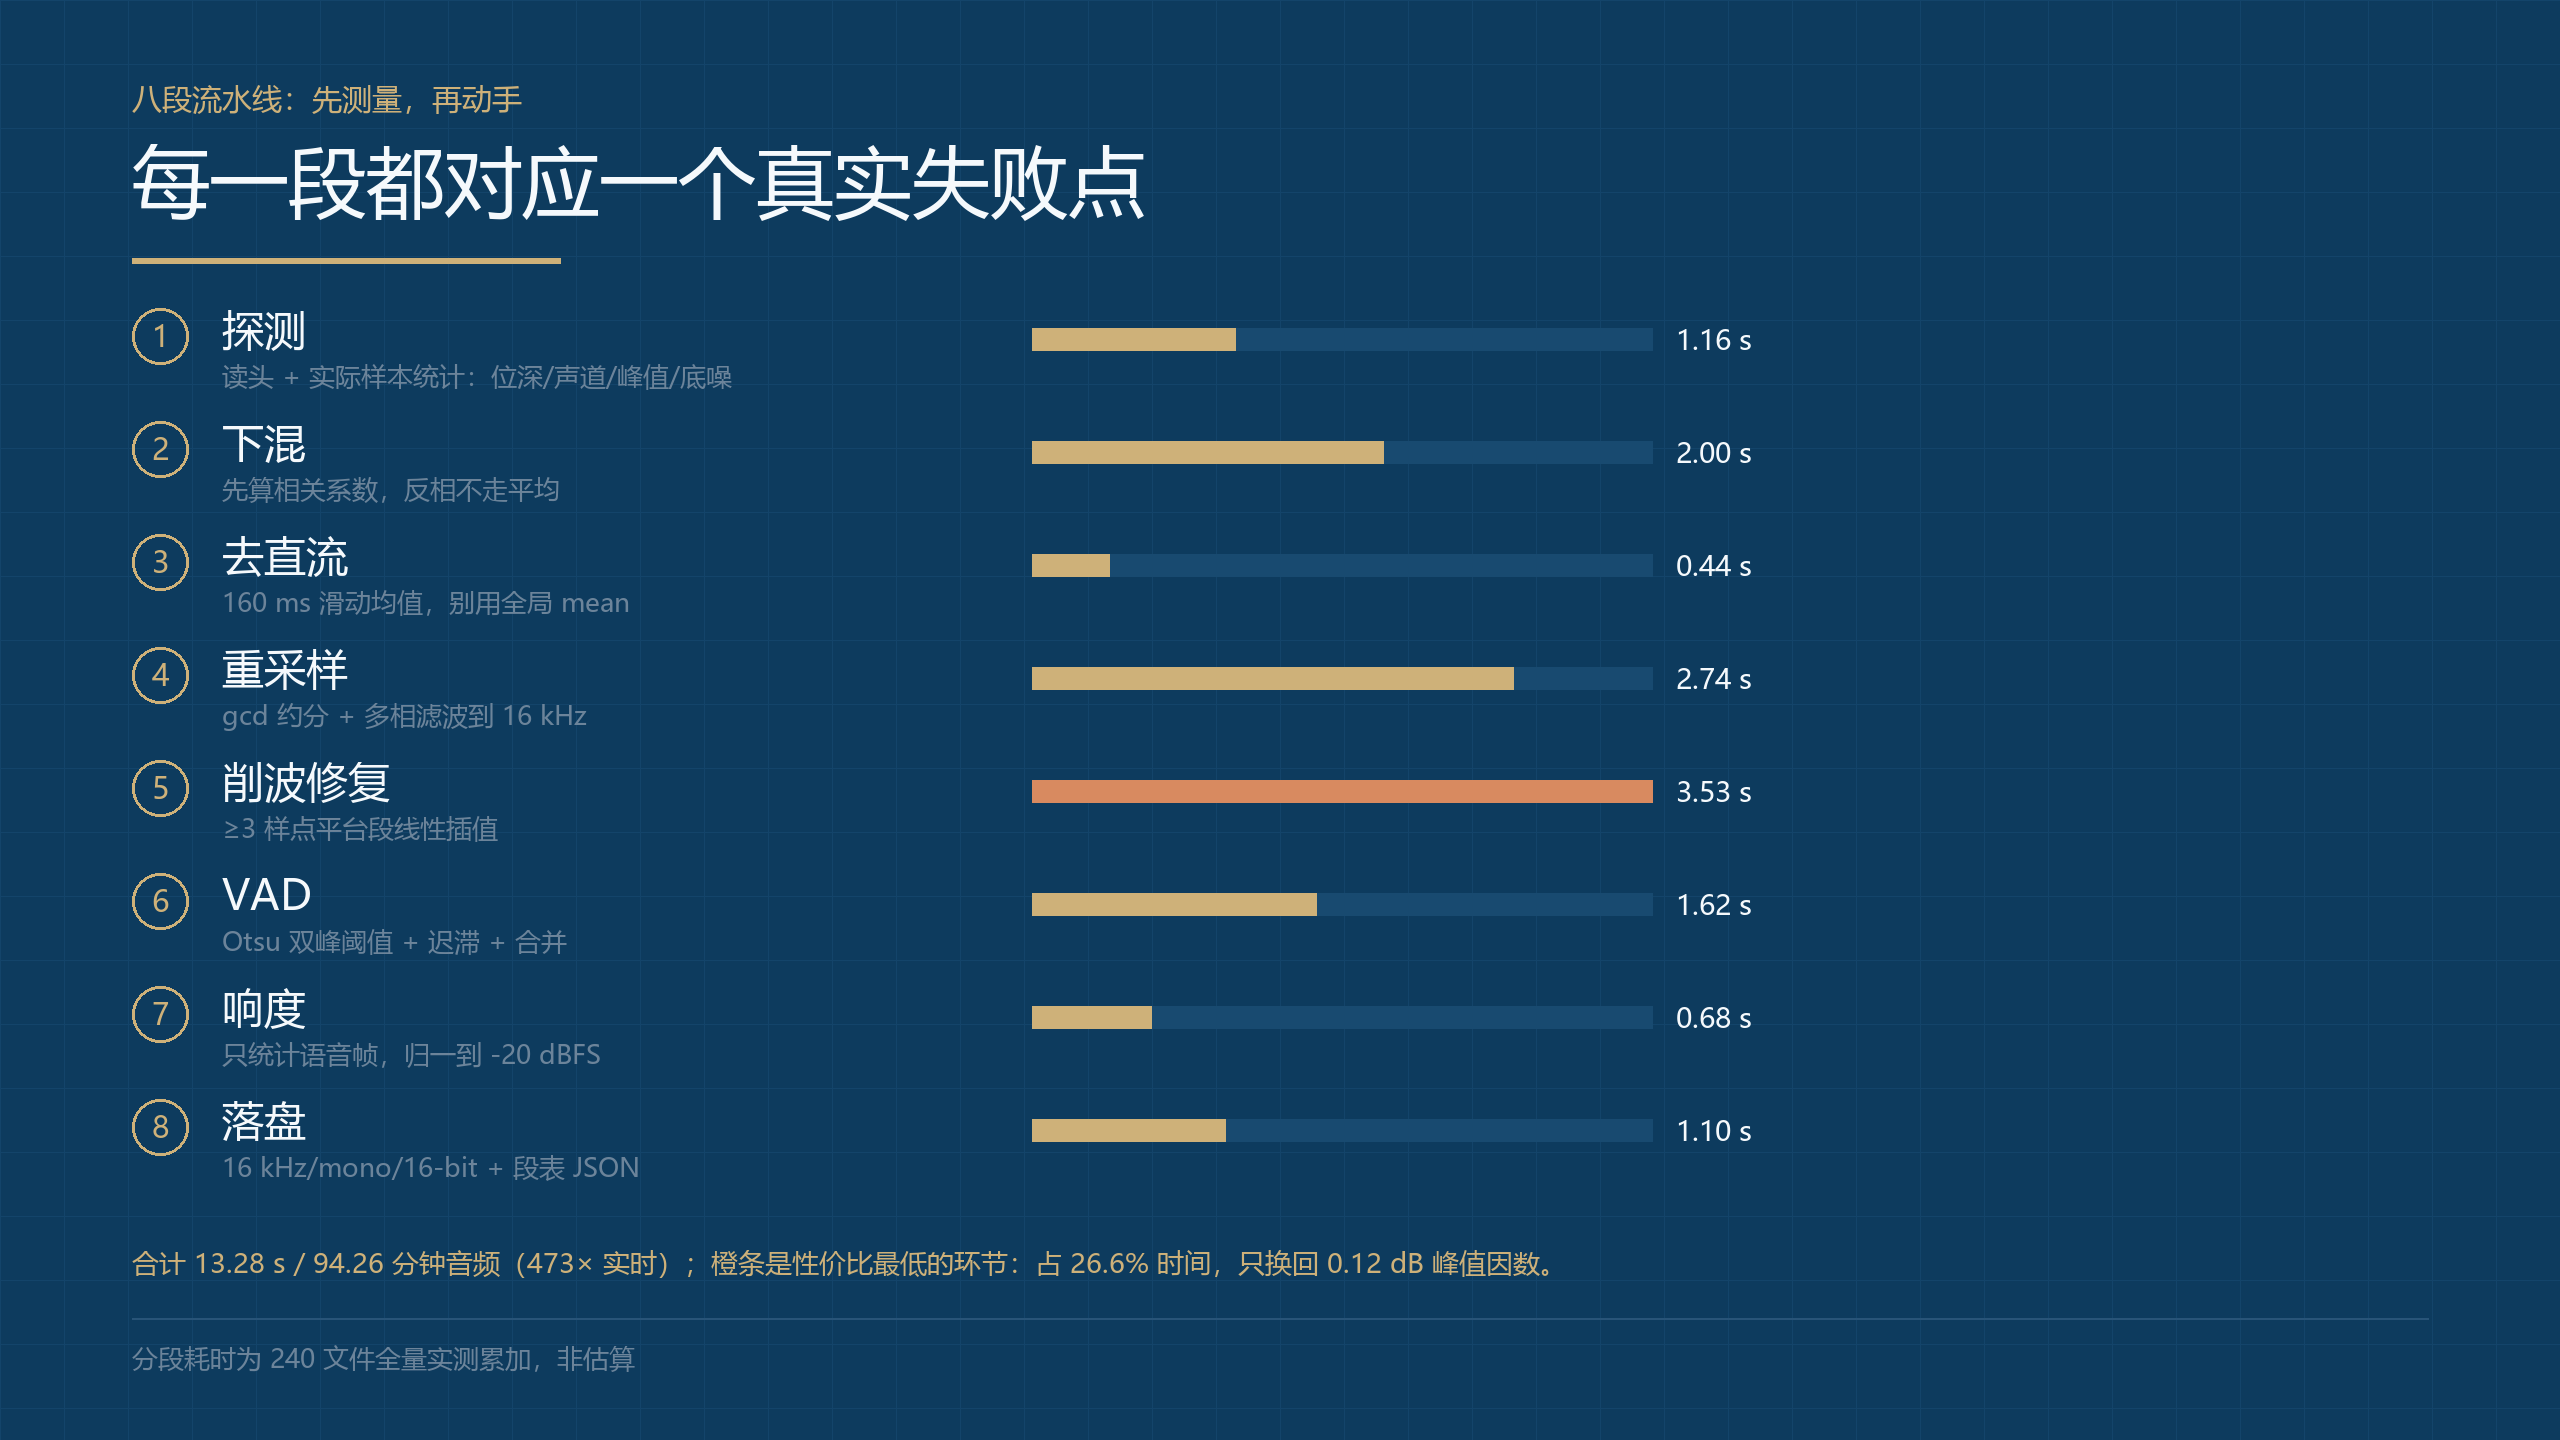
顺序是有讲究的,每一步都为下一步准备前提:
- 探测:不只看 WAV 头,还要读实际样本——峰值、RMS、直流、削波平台、帧能量分位数。
- 下混:先算两声道相关系数。
c < -0.3判反相,只取单声道,不做平均;c > 0.995判复制,取平均降噪;其余按能量加权并做电平补偿。 - 去直流:全局
mean减一次(此时还没切静音,样本量最大,均值最准)。 - 重采样:
gcd(16000, sr)约分后交多相滤波,长度严格按比例,避免时长漂移。 - 削波修复:只处理 ≥3 个连续样点贴顶的平台段,用两侧样点线性插值补回。
- VAD:20 ms 窗、10 ms 跳,帧能量直方图做 Otsu 找双峰谷底作阈值,加 3 dB 迟滞、0.20 s 挂起、0.25 s 合并、0.12 s 最短段、20 ms 保护带。
- 响度:只统计语音帧的 RMS,归一到 -20 dBFS,再过 -1 dBFS 软限幅。
- 落盘:16 kHz / 单声道 / 16-bit,同名 WAV + 段表 JSON。
四、真实数据对比
指标 | A 朴素 | B 半治理 | C 治理式 |
|---|---|---|---|
参数合规率(16k/mono/16-bit) | 37.50% | 100% | 100% |
首尾裁剪误差中位数 | 3,871.6 ms | 1,484.8 ms | 70.3 ms |
裁剪命中率(±100 ms) | 0.42% | 39.58% | 100% |
语音段 F1(IoU≥0.5) | 0 | 0 | 1.000 |
平均 IoU(1,305 段) | — | — | 0.967 |
响度达标率(-20±1 dBFS) | 0% | 0% | 100% |
直流残留中位数 | 5.84e-3 | 2.63e-4 | 6.77e-6 |
直流超 5e-3 的文件 | 122 | 96 | 0 |
反相文件语音电平 | -240 dBFS | -240 dBFS | -19.87 dBFS |
8-bit 文件时长腰斩 | 49/49 | 0 | 0 |
一次可用率 | 0% | 0% | 100% |
耗时(94.26 分钟音频) | 2.317 s | 5.567 s | 11.96 s |
实时倍率 | 2,441× | 1,016× | 473× |
输出体积 / 总时长 | 259.0 MiB / 5,076.3 s | 161.3 MiB / 5,284.7 s | 147.3 MiB / 4,826.9 s |
B 档的 0% 不是失败得很奇怪,而是很典型:参数全对了、静音也切了一半,但响度按峰值归一,语音 RMS 落在 -20±1 dB 的只有 0%——峰值归一控制的是峰值,不是响度。同样地,B 档没有段表,F1 天然是 0。
消融实验(都以 C 档为基线,指标为一次可用率):
去掉哪一段 | 一次可用率 | 说明 |
|---|---|---|
VAD(不切静音、无段表) | 0.00% | 响度只能退化成按全帧算,达标率掉到 21.67% |
相性检测(改直接平均) | 90.83% | 22 个反相文件 -240 dBFS,另有 7 个文件直流超标 |
去直流 | 66.67% | 80 个文件直流残留超 5e-3,VAD 阈值也被抬高 |
响度归一(改峰值归一) | 19.17% | 与 B 档同病 |
削波修复 | 100.00% | 峰值因数 7.88 → 8.00 dB,只值 0.12 dB |
线性插值重采样 | 100.00% | 流程指标看不出,SNR 中位数掉到 23.49 dB |
削波修复是性价比最低的一段:占全部耗时 26.6%(3.53 s / 13.28 s),只换回 0.12 dB 峰值因数。留着它是因为 33 个文件确实需要,但如果你只有几十个干净文件,这一段可以砍。
五、四个反直觉的数字
六、可复制代码(核心四段)
依赖只有 numpy 与 scipy.signal.resample_poly(Python 3.13 已移除 audioop,别再指望它)。
① 位深分支是最容易写错的一行
import wave, numpy as np

def read_wav(path):
    with wave.open(path, "rb") as w:
        sr, ch, width, n = w.getframerate(), w.getnchannels(), w.getsampwidth(), w.getnframes()
        raw = w.readframes(n)
    if width == 1:                      # 8-bit 是无符号,中点 128
        a = (np.frombuffer(raw, np.uint8).astype(np.float64) - 128.0) / 127.0
    elif width == 2:                    # 16-bit 是有符号小端
        a = np.frombuffer(raw, "<i2").astype(np.float64) / 32768.0
    else:
        raise ValueError("未支持的位深 %d" % width)
    return a.reshape(-1, ch), sr
② 下混前先算相关系数
def downmix(x2):
    if x2.shape[1] == 1:
        return x2[:, 0]
    a, b = x2[:, 0], x2[:, 1]
    sa, sb = np.std(a), np.std(b)
    if sa < 1e-9: return b
    if sb < 1e-9: return a
    c = float(np.corrcoef(a, b)[0, 1])
    if c < -0.3:                        # 反相:只取一路,绝不平均
        return a
    if c > 0.995:                       # 复制声道:平均可降噪
        return (a + b) / 2
    w = np.array([sa, sb]) / (sa + sb)   # 失衡:能量加权 + 电平补偿
    y = a * w[0] + b * w[1]
    return y * (max(sa, sb) / np.std(y))
③ Otsu 找 VAD 阈值(比"噪声底 + 12 dB"稳)
def otsu_thr(e):                        # e: 帧能量 dB 数组
    lo, hi = np.percentile(e, 1), np.percentile(e, 99)
    if hi - lo < 3.0: return lo
    hist, edges = np.histogram(np.clip(e, lo, hi), bins=96, range=(lo, hi))
    w = hist.astype(float); w /= w.sum()
    c = (edges[:-1] + edges[1:]) / 2
    cw, cm = np.cumsum(w), np.cumsum(w * c)
    den = cw * (1 - cw)
    with np.errstate(divide="ignore", invalid="ignore"):
        sb = (cm[-1] * cw - cm) ** 2 / den
    sb[~np.isfinite(sb)] = 0
    return float(c[int(np.argmax(sb))])
阈值取 max(otsu, 第 10 百分位 + 6, -58),再用 on > thr / off < thr - 3 做双门限迟滞。只用"噪声底 + 12 dB"会在 8-bit 低电平文件上彻底失效:第 10 百分位被量化噪声抬到 -35.5 dBFS,阈值直接抬到 -23.5 dBFS,高于 95% 分位,一个语音段都找不到。
④ 削波平台修复
def declip(x, thr=0.999, minrun=3):
    m = np.abs(x) >= thr
    y, i, n, runs = x.copy(), 0, len(x), 0
    while i < n:
        if not m[i]:
            i += 1; continue
        j = i
        while j < n and m[j]:
            j += 1
        if j - i >= minrun and i > 0 and j < n:
            y[i:j] = np.linspace(y[i - 1], y[j], j - i + 2)[1:-1]
            runs += 1
        i = j
    return y, runs
七、踩坑清单(全部来自本次实跑)
- 8-bit 立体声按 16-bit 解会直接抛
cannot reshape:字节数被腰斩后不是声道数的整数倍。要么按位深分支,要么先截断到len//ch*ch——但截断只是让代码能跑,数据照样是错的。 - 合成语料的损伤要"相对电平"注入:第一版工频哼声写成绝对 -46~-34 dBFS,结果盖过了 -38 dBFS 的语音,整批文件变成哼声主导,VAD 阈值全体失真。真实录音里哼声是相对语音衰减 26~40 dB 的。
- 真值的"尾部静音"必须用
总长 - 最后一个语音段结束现算,不能用生成时的计划值:段间最后一个间隔会把计划值撑长,我第一次就因此把正确的裁剪判成数秒级误差,白白否掉了一个正确实现。 - 句内 <0.20 s 的短停顿要在真值里合并,否则一颗"两段合成一段"的正确行为会被算成 2 个漏检,整篇的 F1 都会被冤枉。
- 用全局
mean评估直流残留会误判:语音基频让 20 秒窗口的均值带 1e-3 起伏。改 160 ms 滑动均值后,C 档"超标文件"从 17 个变成 0 个。 - "削波残留率"这个指标是假的:峰值归一到 -1 dBFS 之后没有任何样点超过 0.999,可失真原封不动。要看峰值因数(本次 6.57 / 7.02 / 8.00 dB vs 干净文件 13.28 dB)。
- 削波修复用 Python 逐样点扫描是性能黑洞:占 26.6% 耗时(3.53 s / 13.28 s),只换 0.12 dB。真要紧的话换成
np.diff找平台段,别写 while。 - 不要为"一次跑通"写批量删除:本机沙箱对单次 >50 个文件的删除有守卫,会直接拦。本流程设计成"决议在前、落盘在后",不删除任何输入文件,复跑幂等。
八、给 WorkBuddy 的提示词模板
帮我把 D:\audio\in 下的录音做「转写前治理」,输出到 D:\audio\out:
1) 逐文件探测采样率/位深/声道/峰值/RMS/直流/削波平台,先出一份 CSV 体检表,不要直接改文件;
2) 统一成 16 kHz、单声道、16-bit:下混前先算两声道相关系数,<-0.3 判反相只取单路,>0.995 取平均,其余能量加权并做电平补偿;
3) 8-bit 文件按无符号中点 128 解码,禁止当 16-bit 读;
4) VAD 用帧能量 Otsu 阈值 + 3 dB 迟滞 + 0.25 s 合并,输出段表 JSON,切掉首尾静音但保留段内停顿;
5) 响度只统计语音帧,归一到 -20 dBFS,峰值不超过 -1 dBFS;
6) 削波平台(≥3 样点)用两侧插值修复,并统计修复段数;
7) 最后给我一张对照表:处理前后 参数合规率 / 裁剪误差 / 段数 / 响度达标率 / 耗时,并列出所有被判为"反相"或"8-bit"的文件名。
收尾
这条流水线的价值不在"能跑",而在它先测量再动手。240 个文件、94 分钟、5 种采样率、49 个无符号 8-bit、22 个反相、33 个削波——如果你不先测,这些特征全部隐形,脚本会带着一脸无辜把 22 个文件处理成静音、把 49 个文件处理成噪声,然后告诉你"完成"。
11.96 秒换 100% 可用,代价只有 5 倍于朴素脚本的耗时(2.317 s → 11.96 s)。这 10 秒买的不是速度,是能拿去用的数据。
本文全部数字由本机真实运行产出:语料 aud_gen.py__(240 文件 / 5,655.8 s / 1,305 语音段)、三档与消融 aud_run.py__、分段耗时 aud_stage.py__、配图 gen_aud_images.py__。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号