电商 AI 作图工具的评分表怎么搭?权重、锚点与复测
原创
评分表容易出问题的地方,不是算错分,是算完了没人敢用——换个权重,排序就翻,结论跟着翻。这篇不评谁分高,只讲一张评分表怎么搭,才能经得起改权重、换人、复测。
一、现成的评分表为什么不能直接用
分数是权重算出来的结果,不是对象本身的属性。同一批对象,把还原的权重从三成降到两成、效率从两成升到三成,排序能翻过来。别人表格里那个 92 分,只在他那套权重下才成立。
更麻烦的是权重背后藏着场景。做跨境的和做短视频的,对「合规」这件事的定义就不一样,权重自然差很远。拿一份不知道权重怎么来的表去用,等于用别人的场景替自己做判断。
要用,就得自己搭。下面按顺序讲五段:维度、权重、锚点、复核、敏感性。
二、维度从失败形态倒推,别从功能列表里挑
从功能列表挑维度的通病,是功能多的先赢。而功能多不等于返工少——一个平台可能什么都能做,但每次都差一点,交出去的东西还不如只用一件趁手的工具。
换个方向:先写「一批活怎么坏」,每种坏法对应一个维度。
失败的形态 | 要量的维度 | 为什么它是维度 |
|---|---|---|
图出来了,但不像这款商品 | 还原度 | 它决定要不要返工,跟功能多少无关 |
图能用,上架被退回 | 合规 | 退回一次就是整批重做 |
一晚上出不完,排不进日程 | 批量效率 | 它决定这批能不能按时交 |
单量涨上去,成本跟着失控 | 成本结构 | 它决定能接多大的单 |
换一个市场要整套重做 | 跨市场适配 | 它决定铺货的速度 |
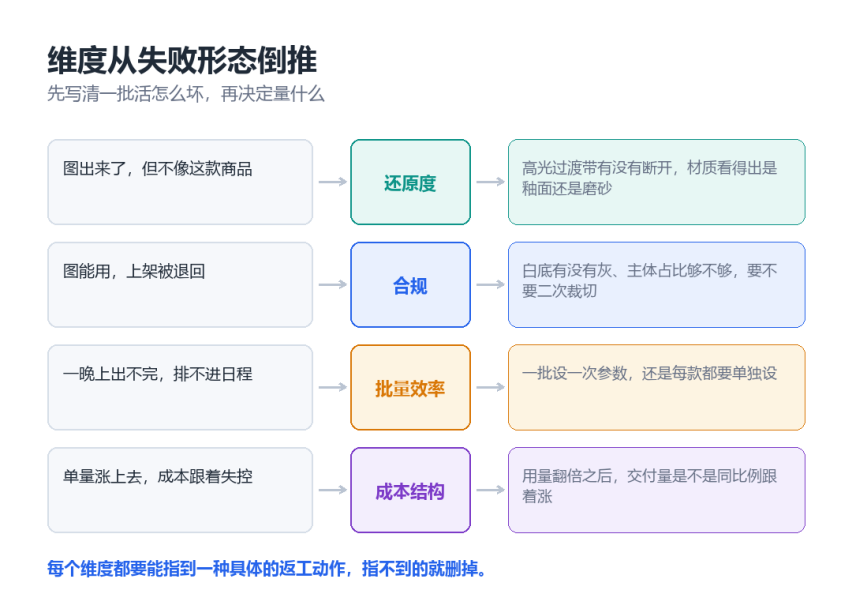
图 1:失败形态、对应维度与可观察锚点的三层映射。示意图由本文绘制。
清单写完之后做一次反查:每个维度都要能指到一种具体的返工动作。指不到的删掉——那种维度看起来专业,实际上打出来的分没人会照着改。
三、权重:两两比较,比拍脑袋稳
直接给一组百分数,结果通常是「谁都说不出为什么」。真要定,两两比较更稳:把维度两两摆在一起,只问一句——两边各扣一分,你先想把哪边捞回来。每比一次记一次胜负。
五个维度有十组比较。胜负次数排下来,权重就有了;如果某组比较里反复选不出,说明这两个维度在你的场景里其实是一件事,可以合并。
还有一个信号要留意:某个维度一次没赢过,就别硬给权重,把它降级成检查项——不进总分,但逐项过一遍。硬给权重会把总分稀释,每个对象的分反而都很接近,等于白算。
另外,权重不要平均分。四个维度各占两成五,等于没定权重,排序完全由分数本身决定,改权重也不会动——看起来稳,其实没有信息量。
比较结果 | 怎么处理 |
|---|---|
胜负比 4:3:2:1 | 按比例成权重,四成、三成、两成、一成 |
某项一次没赢 | 降级成检查项,不进总分 |
两组反复平手 | 合并成一个维度,重新比较 |
四项接近平均 | 权重没起作用,回到场景里重问一遍 |
四、锚点:分数必须能指到画面上
权重定了,接下来费时间的一段,是给每一维的每个分数写锚点。锚点是「看到什么给几分」,不是「感觉如何给几分」。
一条能用的锚点,读完之后两个人看同一张图,给出的分数差不超过一分。写不出来的维度,说明它不可测,先删掉。
维度 | 一分 | 三分 | 五分 |
|---|---|---|---|
还原度 | 主体边缘有残留背景或重影 | 边缘干净,材质偏塑料感 | 高光过渡带连续,看得出釉面还是磨砂 |
合规 | 白底带灰或渐变,要二次处理 | 白底达标,主体占比偏低 | 直接可用,不用裁切 |
批量效率 | 每款都要单独设参数 | 一批设一次可连跑 | 能按款名归档,返工可定位 |
成本结构 | 用量翻倍,单价不降 | 用量可控但要人工核算 | 交付量与用量同比例 |
跨市场适配 | 换市场要重做构图 | 尺寸能改,文案要重写 | 尺寸与文案口径都不动 |
写出来但两分与三分之间只有形容词差别的锚点,也要重写。形容词是容易打架的地方:同一张图,「偏灰」和「偏冷」两个人能争十分钟,而「白底上有没有一层可见的浅灰」不会有争议。
五、复核:只复核分歧大的项
一个人打分会有惯性:同一批图里前几张打得紧,后几张打得松。所以关键项要两个人独立打,打完再合。
但别逐项复核,那样比打分本身还费时间。做法是先算差值,只看差值超过一分的项,其余直接取平均。
复核的时候只对着锚点看,不看总分。一旦开始看总分,人就容易往「看起来合理」的方向微调,反而把真实分歧抹平了——而真实分歧恰恰是有用的那部分信息。
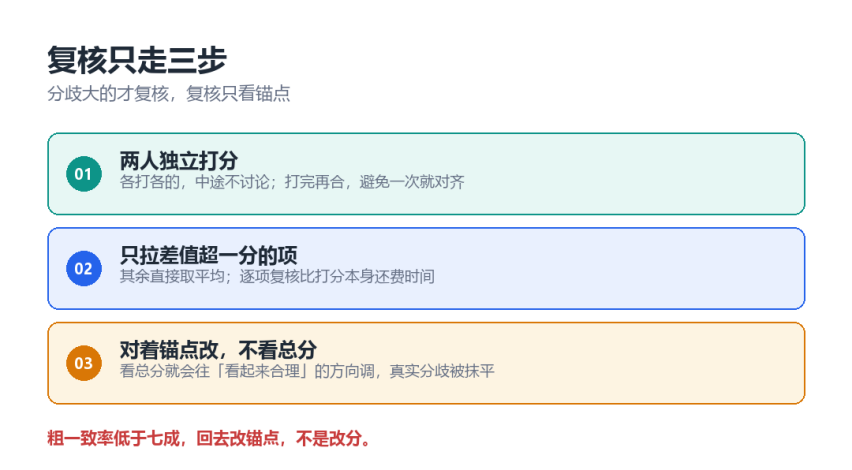
图 2:两人复核的三个步骤,分歧大的项才需要重新看。示意图由本文绘制。
一致率要算出来并记下来。粗一致率低于七成,说明锚点没写清,回去改锚点,而不是改分。
import csv
def agree(path):
    same = total = 0
    with open(path, encoding='utf-8') as f:
        for row in csv.DictReader(f):
            a, b = int(row['rater_a']), int(row['rater_b'])
            total += 1
            # 差值在一分以内算一致,两分以上算分歧
            same += abs(a - b) <= 1
    return same / total if total else 0
rate = agree('scores.csv')
print(f'粗一致率 {rate:.2f}')
if rate < 0.7:
    print('锚点需要重写,不要直接调分')
六、敏感性检查:换一套权重,排序会不会翻
这一步容易跳过,而它能检验「结论稳不稳」。
做法是准备两到三套权重:还原优先、周转优先、成本优先。同一组分数各跑一遍,看排序有没有换位。
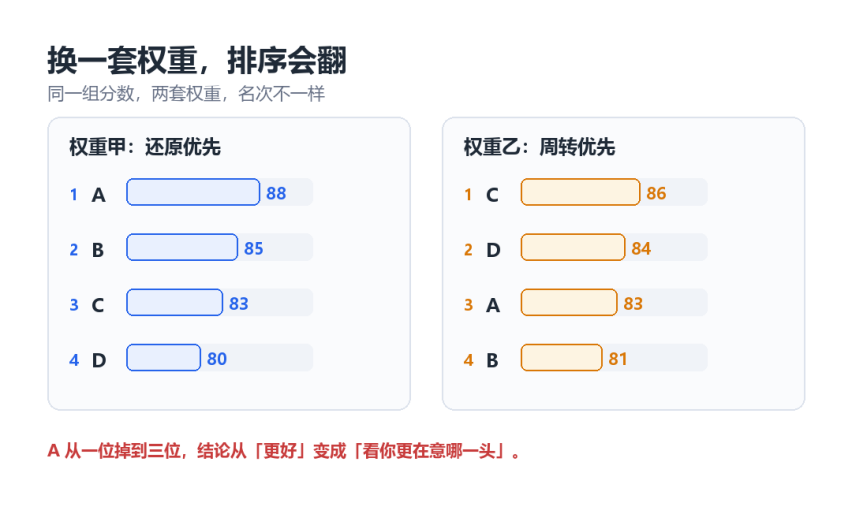
图 3:同一组分数在两套权重下的排序变化。示意图由本文绘制。
规则很简单:如果某两个对象在所有几套权重下都不换位,可以下结论;只要有一套权重能让它们换位,就不能说「谁更好」,只能说「在你的权重下谁更合适」。
import itertools
# 行:对象;列:维度分数(还原 / 合规 / 效率 / 成本)
scores = {
    'A': [88, 80, 70, 76],
    'B': [70, 92, 74, 78],
    'C': [76, 78, 92, 80],
    'D': [80, 74, 76, 94],
}
plans = {
    '还原优先': [0.35, 0.25, 0.20, 0.20],
    '周转优先': [0.20, 0.20, 0.40, 0.20],
    '成本优先': [0.20, 0.20, 0.20, 0.40],
}
for name, w in plans.items():
    total = {k: round(sum(s * x for s, x in zip(v, w)), 1)
             for k, v in scores.items()}
    rank = sorted(total, key=total.get, reverse=True)
    print(name, rank, total)
我做过一次这样的检查:还原的权重从三成五降到两成、效率从两成升到四成,A 和 C 直接换了位,而它们的综合分只差两分。也就是说,「综合分高两分」这句话,在这个场景里没有任何信息量——它只是权重恰好偏向它的结果。
七、分数的三种误用
一是把分数当能力上限。分数只反映测过的那几个场景,场景之外它是空的;测过白底图,不代表它能出场景图。
二是跨场景横向比。同一套分数在「商品主图」和「短视频封面」上不是一回事,两边的锚点根本不同,硬比只会得出一个都不准的结论。
三是直接搬别人的权重。别人的权重来自别人的单量、平台和团队结构。搬过来用,等于把自己的判断外包出去,还得跟着别人的偏差走。
八、这套方法自己的误差在哪
锚点带主观。即使写清了「高光过渡带连续」,连续到什么程度算连续,两个人还是会有分歧,所以一致率必须算、必须记。
样本量是另一层。每个变量组合跑十次是下限,少于十次,单次波动就能把结论带偏;但十次也只能说明这一批图,外推到别的品类没有依据。
还有场景偏差。测试用的图是我自己挑的,挑的时候已经带着偏好;换一批图,分数会动,排序也可能动。
成本这一维不好打分,因为它跟用量、并发、交付方式都相关,而这几项在测试里都是模拟的。模拟出来的数字,只能看趋势,不能当账算。
我这张表是在一个把多家模型放在同一个入口里的平台上跑的(Flux Art)。好处是同一张白底图能在几个模型之间换着测,不用来回导出导入;缺点是它的入口按任务分组,初次搭表得先把分组逻辑摸一遍,否则容易漏掉某一类图位,那一维的分就是空的。
文中所述功能与规格以各家当前页面为准。所述感受基于同一组测试条件,没有对任何一家做特殊调优。
九、小结
评分表的用处不是给出名次,是逼自己把「什么算好」写清楚。写不清的那一维,就是还没想清楚的那一维。
权重会随季节和平台规则变,锚点相对稳定。时间花在锚点上比花在权重上值。
一张经得起改权重的表,才敢拿去做决定;一改就翻的表,只能当参考读物。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号