EDR 上线后告警反而没人看?安全告警疲劳的成因与四级降噪实践
原创
EDR 上线后告警反而没人看?安全告警疲劳的成因与四级降噪实践
原创
卓豪终端管理
发布于 2026-10-26 16:30:27
发布于 2026-10-26 16:30:27
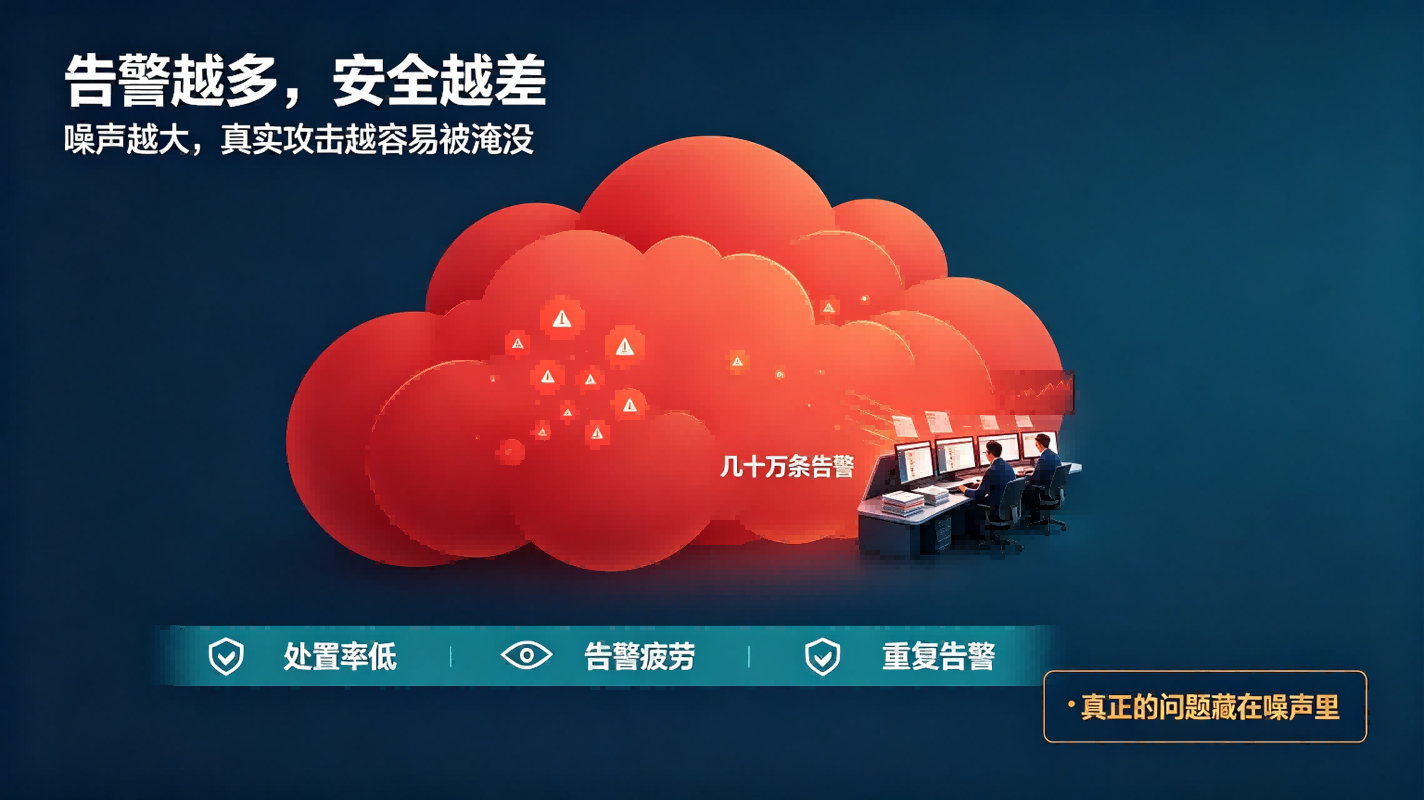
上了 EDR 之后,很多安全团队都遇到一个反直觉的结果:告警越多,安全越差。一台终端每天几百条检测,一千台就是几十万条原始事件,团队就那么几个人,真实处置率往往不到 5%。更糟的是——当“狼来了”喊多了之后,真正的攻击反而在噪声里被淹没。行业调研显示,企业级安全运营中心平均每天接收超过 4400 条告警,但分析师只来得及认真处理其中约三分之一。
一、为什么告警越多,安全反而越差
首先是处置率暴跌。告警量远超处理能力,队列越积越长,从告警触发到有人来看的时间被不断拉长。
其次是告警疲劳。长期暴露在高频噪声下,分析师会对告警“脱敏”——熟悉的告警被条件反射式关闭,真实威胁混在同样的模式里被一起放过去。有调研显示,超过六成安全团队承认曾忽略过事后被证实为真实的告警。
再次是重复淹没。同一个恶意样本在几百台设备上触发,就生成几百条几乎一样的告警。这不是几百个问题,只是一个问题被放大了几百倍。
最后是上下文缺失。一次失败登录、一次异常外联、一次敏感目录写入,分开看都只是“可疑”,连在一起才是一次完整的入侵——但大多数告警系统不会帮你把它们连起来。
这四个循环互相强化:噪声越多,人越疲劳;越疲劳越容易漏;漏了越不敢关规则,噪声也就越多。
二、什么是“终端告警降噪阶梯法”
解决告警疲劳,方向不是造更强的检测引擎——引擎越强,告警只会越多。正确方向是造一套逐级收敛的漏斗:每天数万条原始事件,经基础筛选形成数百条安全告警,再经聚合、定级、关联收敛为几十条威胁,最后经人工研判,剩下的真实事件往往只有个位数。
漏斗每一层对应一个明确动作:聚合是把同根因告警合并,N 条变 1 条;定级是按资产重要性和危害度排序,决定先看谁;关联是跨终端、跨时间,把孤立信号串成攻击链;抑制是让已知安全行为不再告警,从源头消音。
三、四级阶梯怎么落地
聚合级:把同哈希、同手法、同父进程的告警合并成一条事件,并标注受影响的主机数量。一条“该样本已波及 87 台主机”的事件,远比 87 条独立告警更容易判断严重程度。注意聚合要做到跨规则、跨设备的归并,而不是简单的字段去重。
定级级:优先级等于资产重要性、行为危害度和时间紧迫度三者的乘积。落地时需要准确的资产清单,给每台设备打上“核心、重要、一般”标签。团队有限的时间,应先花在核心资产的高危事件上。
关联级:这是价值最高也最难的一层。把几分钟内跨来源的信号——失败登录、成功登录、异常外联、敏感目录写入——合并成一个事件,而不是四张独立工单。时间窗口建议从 5 到 15 分钟起步,再根据误合并情况调整。
抑制级:运维脚本定时扫描、备份任务批量读文件这些“已知安全”行为,不需要反复告警。但抑制是把双刃剑,规则本身必须可审计、可复核:为什么抑制、谁审批的、什么时候到期复核,都要写清楚,否则一次错误的抑制就是一次真实的漏报。
四个环节各管一段:聚合解决重复淹没,定级解决处置率暴跌,关联解决上下文缺失,抑制解决告警疲劳本身。
四、支撑这套方法需要哪些能力
不需要绑定任何特定产品,一套能跑通降噪阶梯法的工具链,通常需要五类通用能力。
一是多维度终端行为采集,覆盖进程、文件、网络、注册表等关键事件维度,且历史数据要保留足够时长以支撑关联分析。
二是集中汇聚与过滤,有统一的控制台,支持按设备组、严重级别和时间范围过滤,避免分析师在多套日志系统间来回切换。
三是资产清单联动,事件能自动关联资产的重要性标签,让定级有数据可依。
四是可编排的告警规则,支持自定义规则、按级别路由给对应团队,并对已知安全行为提供白名单机制。
五是审计与回溯,每条聚合、抑制规则都有完整的操作记录,便于复盘与复核。
如果现有工具链在某一项上明显薄弱,那一项就是下一步优先补齐的方向。
FAQs
1. 降噪会不会把真告警也压掉?
有这个风险,所以关键在两级保险:抑制规则可审计、有到期复核;聚合和关联是合并不是丢弃,原始数据随时可回溯。
2. 团队没有 SOC,只有一两个安全运维,还适用吗?
更适用。人力越少越不能耗在重复告警上,可先做见效最快的聚合和抑制,关联后置。
3. 怎么衡量降噪有没有效果?
看三个指标的趋势:告警总量、真实处置率、平均研判时长。降噪做得好,两个月内告警总量会明显下降,后两项同步改善。
结语
攻防的胜负不只取决于谁检测得更准,还取决于谁能先看见真问题。告警降噪阶梯法的价值,是帮安全团队把有限的注意力,从 99% 的噪声里夺回来——让每一条需要人看的告警,都值得被看。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号