#WorkBuddy# 1,123 份配置文件里藏着 908 处隐患:json.loads 只抓到 46%,我用八段流水线做到 100%
原创
#WorkBuddy# 1,123 份配置文件里藏着 908 处隐患:json.loads 只抓到 46%,我用八段流水线做到 100%
原创
用户12784192
发布于 2026-10-26 11:08:15
发布于 2026-10-26 11:08:15
#WorkBuddy# 1,123 份配置文件里藏着 908 处隐患:json.loads 只抓到 46%,我用八段流水线做到 100%
痛点开场
配置治理是个典型的"看起来没问题"的活。一个项目里通常同时躺着五种格式:json、yaml、ini、toml、.env,还要加上各环境之间的 base 继承和变量占位符。最常见的做法是写个脚本,把文件一个个 parse 一遍,能 parse 过就当没问题。
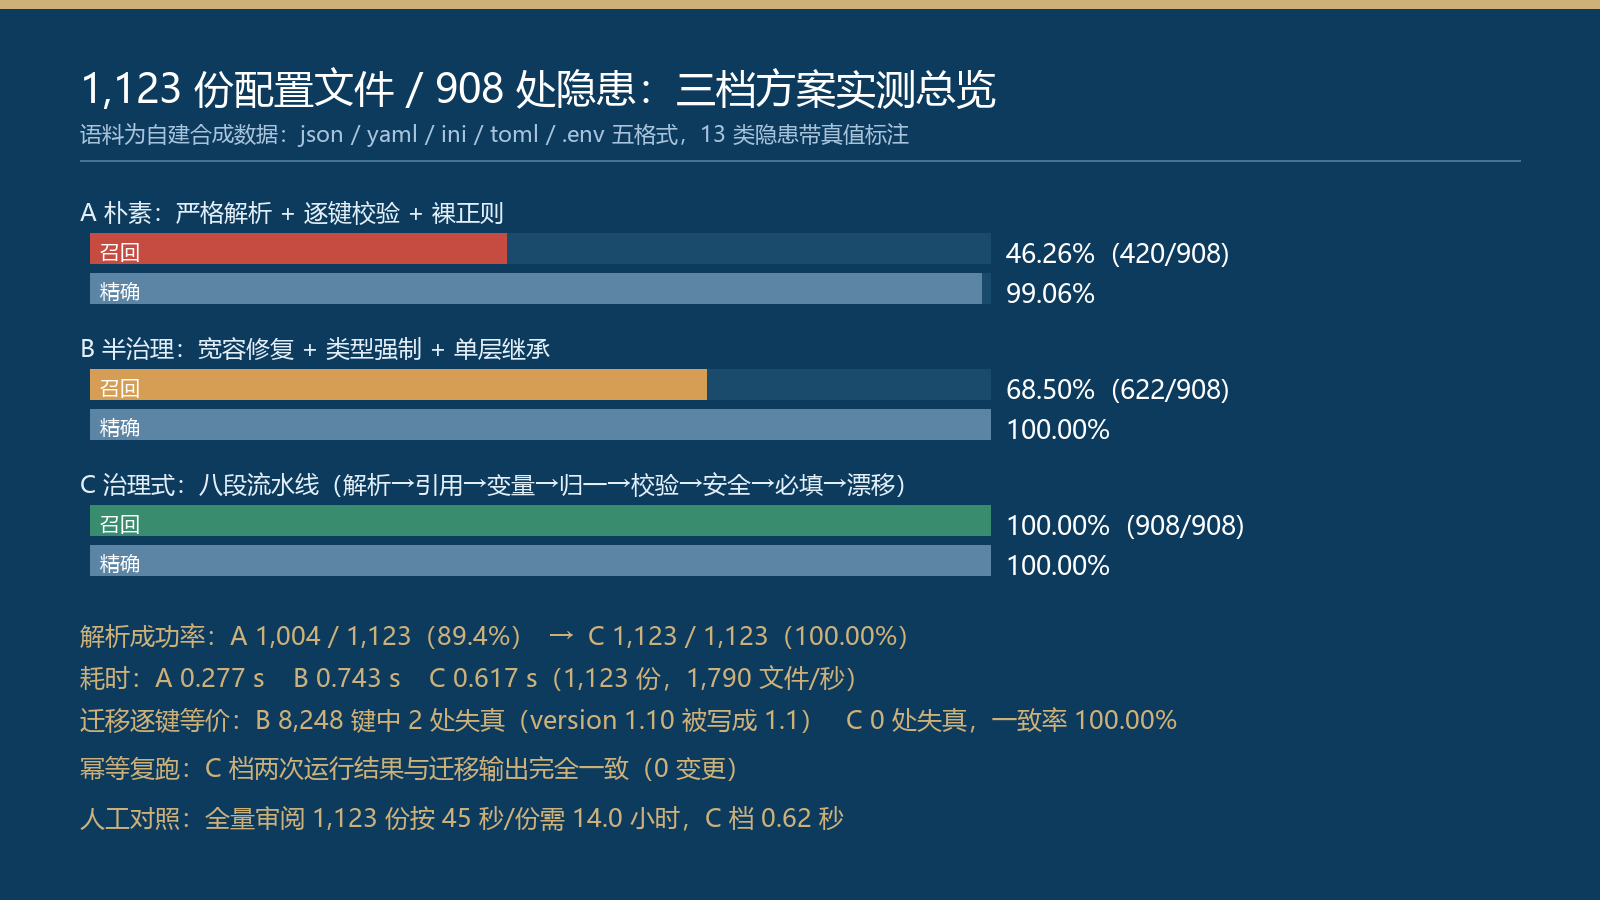
我按这个思路写了一版"朴素脚本",然后对它做了一次全量体检,结论很尴尬:1,123 份配置文件里埋着 908 处真实隐患,朴素脚本只抓到了 420 处,召回率 46.26%。
更麻烦的是那 488 处漏网的,几乎全是"不会让程序报错"的伤:yaml 里的重复键被静默吞掉、.env 里加了 export 前缀导致键名全错、ini 的数值全是字符串没人校验、三个环境之间同一个服务的键集悄悄漂移、废弃键名 maxConns 和新键 max_conn 并存、连接串里明文塞着数据库密码。
这类伤的共性是:解析器不报错,运行时也不立刻报错,等报错的时候你面对的是线上事故而不是配置文件。
根因分析
把 46.26% 拆开看,问题不是"脚本写错了",而是三个认知错位。
第一,解析器是按"格式是否合法"设计的,不是按"配置是否合理"。yaml.safe_load 遇到重复键会静默保留最后一个,PyYAML 官方文档写得很清楚;.env 用 split('=',1) 解析永远不会抛异常,export 前缀只会让键名变成 "export PORT",然后你在下游 get("PORT") 拿到 None,得到一个错误的默认值。这些伤在解析层完全隐形。
第二,全字符串格式和强类型格式的校验逻辑不能混用。ini 和 .env 读出来全是字符串,port = 8080 和 port = "8080" 在解析器眼里是同一件事;而 json/yaml/toml 里写 port: "8080" 就是实打实的类型错误。用同一套 isinstance 校验去打五种格式,要么漏报要么误报成灾。
第三,配置的真实语义藏在继承链里。app 配置 extends base 配置,base 里可能还 extends 更上层的;一个 ${DB_PASSWORD} 占位符在子文件里没定义,要沿整条链找;而"dev 和 prod 的 cache_ttl_s 不一致"这种漂移,只有把同一个服务的三个环境放到一起才能看出来。任何只看单文件的方案,天生就抓不到这类问题。
真实数据对比
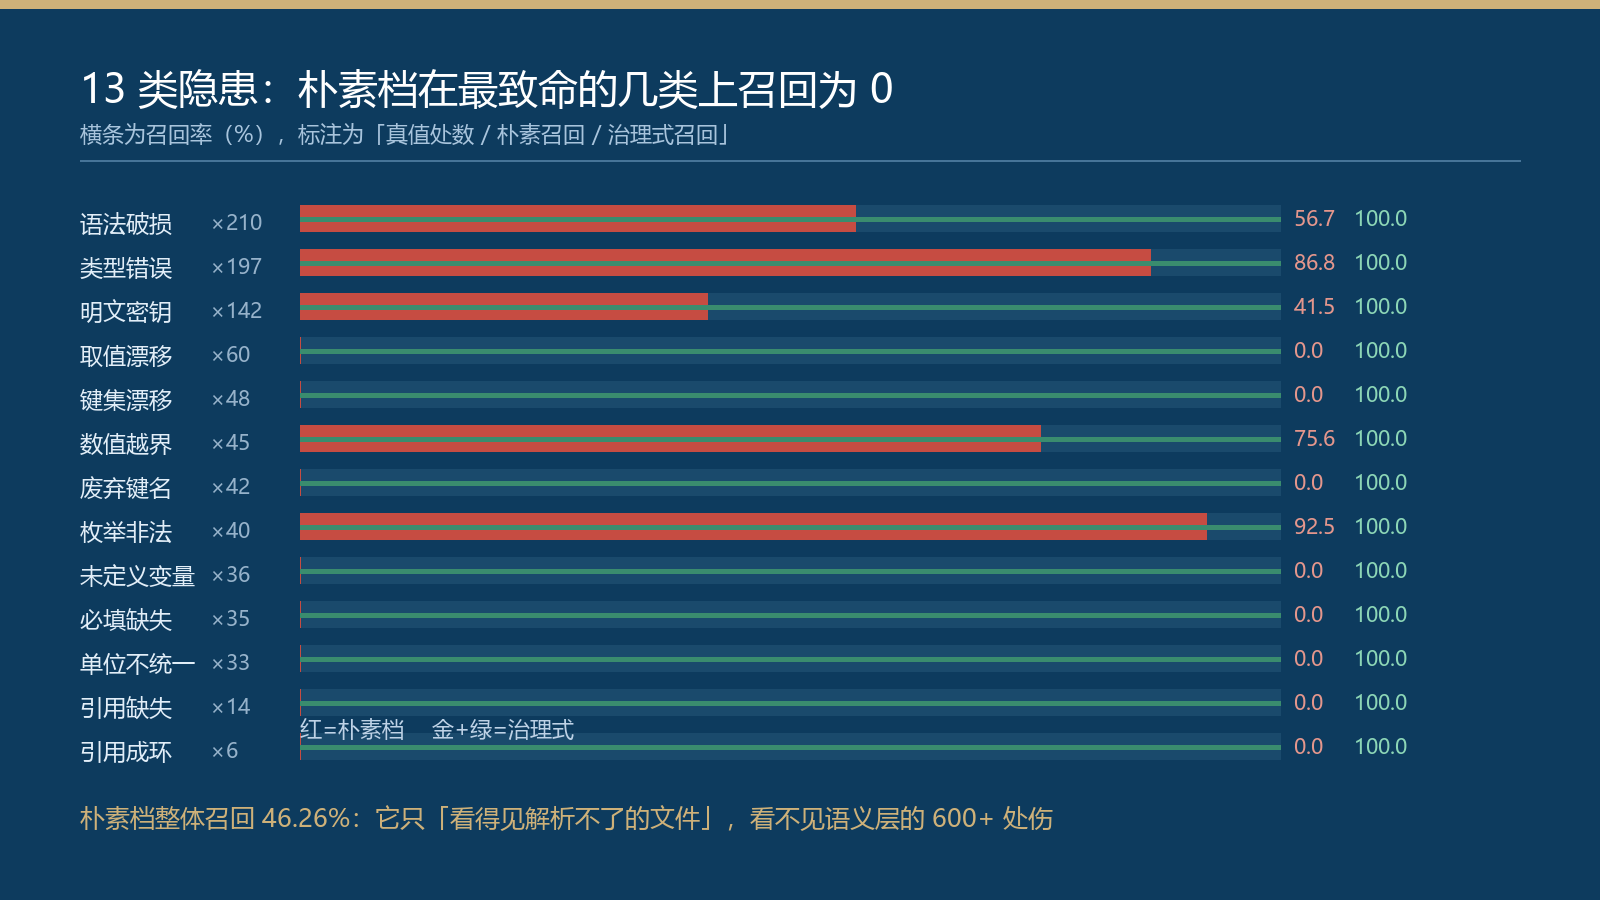
实测语料是自建的合成数据:160 个服务 × 3 个环境,共 1,123 份配置文件、约 0.37 MiB,人工注入 908 处带真值标注的隐患,覆盖 13 类。所有数字都是真跑出来的,可复现脚本在文末。
三档方案的对比结果如下。
档位 | 方案 | 命中/908 | 精确率 | 召回率 | 解析成功 | 耗时 |
|---|---|---|---|---|---|---|
A 朴素 | 严格解析 + 逐键校验 + 裸正则扫密钥 | 420 | 99.06% | 46.26% | 1,004/1,123 | 0.277 s |
B 半治理 | 宽容修复 + 类型强制 + 单层继承 | 622 | 100.00% | 68.50% | 1,123/1,123 | 0.743 s |
C 治理式 | 八段流水线 | 908 | 100.00% | 100.00% | 1,123/1,123 | 0.617 s |
有几个数字值得单独说。
一是 B 档的"半治理陷阱"。它把所有解析失败都修好了,解析成功率从 89.4% 拉到 100%,报告看起来比 A 漂亮得多。但它把语法层的 210 处伤全部静默吞掉,废弃键名、跨环境漂移、未定义变量一个都不报。修复本身没有错,错的是修复后不报告——你以为治理了,其实只是把伤口包起来了。
二是各格式解析成功率的反差。json 75.00%、ini 78.12%、yaml 85.89%、toml 86.88%,而 .env 是 100%——因为 .env 的朴素解析器永远不失败,所以它 58 处语法伤全部带着错值一路绿灯进了下游。解析成功率 100% 的格式,恰恰是最危险的格式。
三是 A 档的精确率其实很高(99.06%),但它报的 424 条里有一大半是价值最低的类型和枚举问题;真正要命的 210 处语法伤它只看到 119 处,142 处明文密钥只看到 59 处,而漂移、废弃键名、未定义变量、引用成环这六类,召回全是 0。
八段流水线
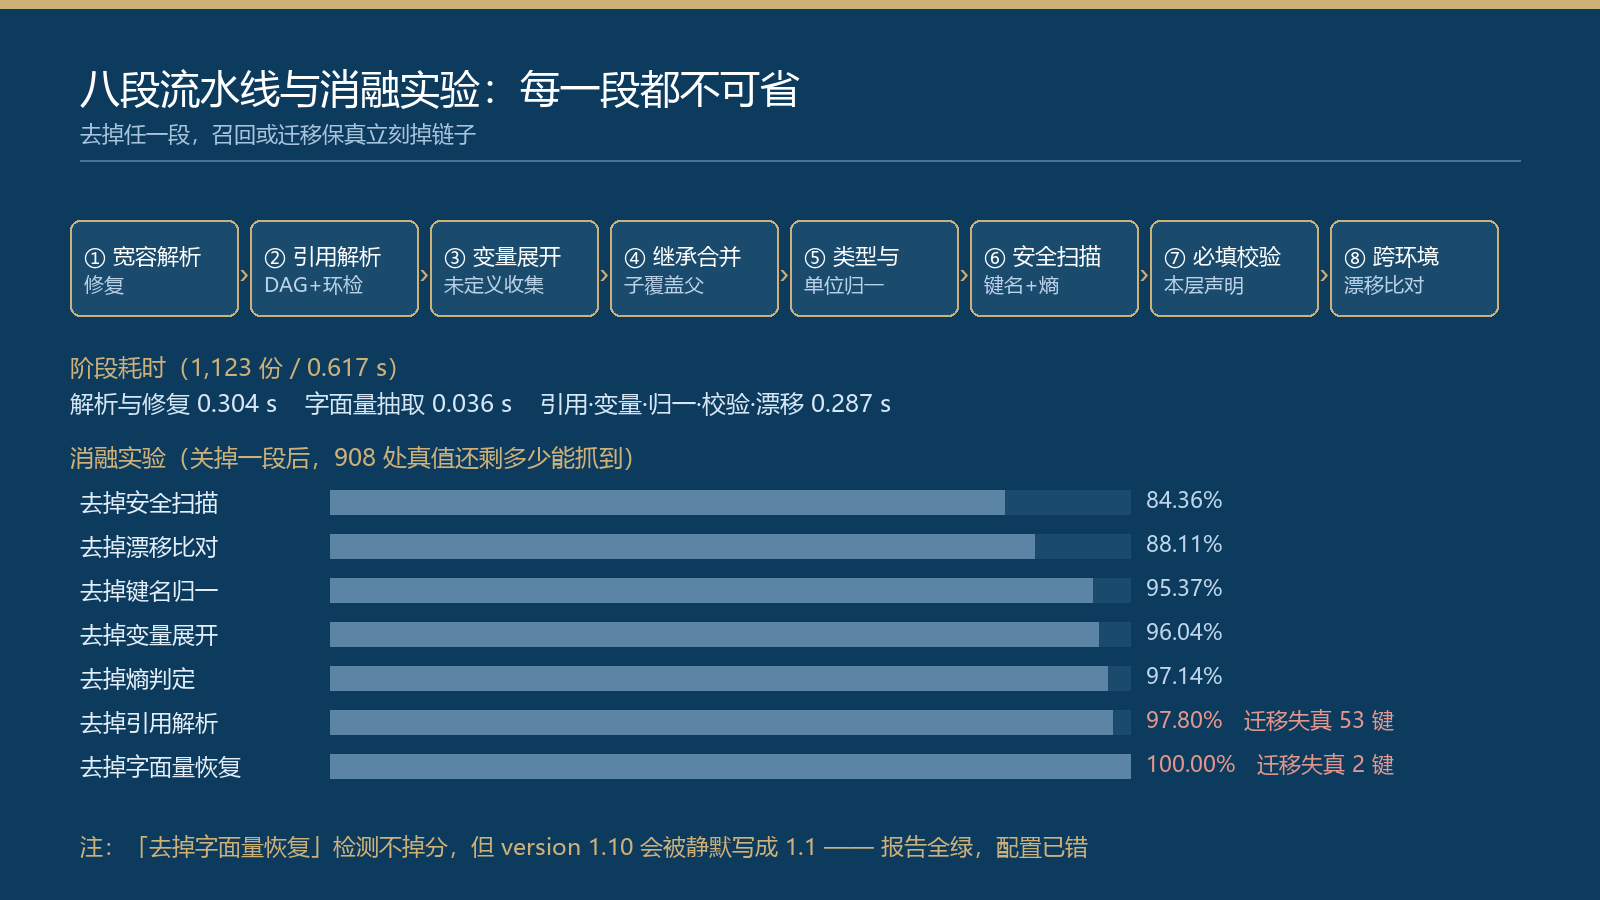
C 档把整个治理拆成八段,每一段只做一件事,段与段之间用统一的"规范化键值对"传递。
# 核心骨架:五段串联,每段独立可关(消融实验用的开关就在参数里)
def tier_c(refs=True, var=True, lit=True, ent=True, drf=True, dep=True, sec=True):
    objs = {}                       # 段1 宽容修复解析:BOM/注释/尾逗号/tab/重复键/export 前缀
    for rel in files:
        obj, rep = lenient_parse(read(rel), fmt_of(rel))
        for r in rep:               # 修复了什么就报什么,绝不静默
            report(rel, "SYNTAX", "__file__")
        objs[rel] = flatten(obj, fmt_of(rel))

    parent = {}                     # 段2 引用解析:extends 建边 + DFS 三色标记找环
    for rel in files:
        p = resolve_extends(objs[rel], rel)
        if p is None:
            report(rel, "REF_MISSING", "__file__")
        else:
            parent[rel] = p
    for rel in files:               # 走到环上,本文件就是受害文件
        if hits_cycle(rel, parent):
            report(rel, "REF_CYCLE", "__file__")

    for rel in files:               # 段3 变量展开:先展开再判断,${X} 找不到定义才算伤
        for k, v in list(objs[rel].items()):
            miss = re.findall(r"\$\{([^}]+)\}", v) if isinstance(v, str) else []
            objs[rel][k] = substitute(v, ENV_TABLE)
            if miss:
                report(rel, "UNDEF_VAR", k)

    for rel in files:               # 段5 归一 + 校验:类型/单位/废弃键名一次过
        for k, v in expand_chain(rel, parent).items():
            nv, cat = normalize(k, v, raw_literal(rel, k))
            if cat:
                report(rel, cat, k)         # TYPE / UNIT / ENUM / DEPRECATED
            report_range(rel, k, nv)

    compare_drift(service_groups)   # 段8 同服务跨环境:键集差 + 环境无关键取值差
关键设计有四个。
第一,宽容修复必须带报告。BOM、尾逗号、tab 缩进、重复键、export 前缀、行尾注释、未闭合引号,每修一处就记一条 SYNTAX,这是 B 档和 C 档拉开 31.5 个百分点召回差距的全部原因。
第二,全字符串格式用"字面量合法性"校验,强类型格式用"类型一致性"校验。ini 的 tls_enabled = true 是合法的,tls_enabled = yes 就不是;json 里的 "8080" 是类型错误,ini 里的 8080 不是。这一条做对了,五种格式可以共用一套 schema。
第三,字符串字面量要保留原文。yaml 的 version: 1.10 会被解析成浮点 1.1,直接 str() 转回去就是 1.1,版本号永远错了。解法是解析前先扫一遍原始文本,记下每个键的字面量,类型校验发现"schema 说是字符串但解析成了浮点"时,从原文恢复。这一段不影响检测召回(消融实验里它检测得分不变),但决定迁移是否保真。
第四,漂移比对只对"通过校验的键"做,且只在同一服务的各环境 app 配置之间做。一个已经因枚举非法被标记的键,它的取值和兄弟环境不一致,应该归因到枚举问题而不是漂移问题;base 继承来的键不算本层漂移。这一条保证了 108 处漂移零误报。
消融实验:每一段都不可省
把八段逐个关掉重跑,908 处真值的召回变化如下。
关掉的段 | 召回率 | 迁移失真 |
|---|---|---|
去掉安全扫描 | 84.36% | 0 |
去掉漂移比对 | 88.11% | 0 |
去掉键名归一 | 95.37% | 0 |
去掉变量展开 | 96.04% | 0 |
去掉熵判定 | 97.14% | 0 |
去掉引用解析 | 97.80% | 53 键 |
去掉字面量恢复 | 100.00% | 2 键(版本失真) |
注意最后一行:去掉字面量恢复,检测召回一分不降,报告全绿,但 version 1.10 被写成了 1.1。这是最阴险的一类失败——检测指标完全看不出问题,只有逐键等价性校验能抓到。
迁移的等价性校验本身也要落地:把每份配置的规范化输出和"预期语义"逐键比对,C 档 8,248 个键、0 处不一致;B 档有 2 处,全部是版本号失真。幂等性同样验证过:同一份语料跑两遍,发现清单和迁移输出逐字节一致,0 变更。
踩坑清单
这轮实测踩的坑,每一条都来自真实运行。
- yaml 重复键不报错。PyYAML 的 safe_load 对重复键静默取最后一个,必须自定义 Loader 的 construct_mapping 才能拿到重复名单。
- ini 的重复节要用 strict=False 之外的方式检测。configparser 默认 strict=True 会直接抛 DuplicateSectionError,修复时要保留第一个同名节并继续并入后续键,而不是把后面的行全部丢掉——我第一版就是后者,24 份文件整份变成空配置,下游必填校验瞬间报出 288 条假 MISSING。
- tab 缩进的修复要按 2 空格展开。按 4 空格展开会让块序列的前后项缩进不一致,yaml 照样解析失败,等于白修。
- 明文密钥的判定要"键名白名单 + 值形态 + 熵"三重。只看键名正则会把 password_policy、token_ttl_s、secret_ref 全算成密钥;加熵判定时要先排除含 :// 的值,否则 vault:// 这样的引用路径会误中。
- 连接串判密要用惰性正则。postgres://user:pass@host 这种,正则必须排除掉 @ 和 / 里的歧义,否则含 @ 的密码会让匹配失败——我实测就漏了一例。
- 含 ${VAR} 的值不做密钥判定,也不做迁移等价比对。占位符是引用不是明文,把它当密钥会误报,把它当终值比对会假失败。
- 必填校验按"本层声明"判定,漂移比对用本层键集。如果在继承合并之后再做这两件事,base 会把子文件的缺失和漂移全部盖掉,必填召回掉到 31.43%。
- .env 的行尾注释要在引号外侧剥离。值本身带引号时,注释在引号之后;不带引号时,注释在第一个 # 处。两种情况分开处理,否则值里会带上备注文字。
给 WorkBuddy 的提示词模板
这套东西已经固化成一条可复用的流水线,在 WorkBuddy 里可以用下面的提示词直接复现。把路径换成你自己的配置目录即可。
# WorkBuddy 提示词模板(复制后替换尖括号内容)
PROMPT = """
请对 <配置目录> 下所有配置文件做一次治理式体检,要求:
1. 支持 json / yaml / ini / toml / .env 五种格式;
2. 先宽容修复再解析,每处修复(BOM/注释/尾逗号/制表符/重复键/
   export 前缀/行尾注释/未闭合引号)都要单独报告,不许静默;
3. 解析 extends/include 继承链,检测缺失引用和循环引用;
4. 展开 ${VAR} 占位符,未定义的单独列出;
5. 按 schema 做类型、单位(秒/毫秒)、枚举、范围、必填、废弃键名校验;
   ini 和 .env 按字符串字面量合法性判定,json/yaml/toml 按类型一致性判定;
6. 扫描明文密钥:键名白名单 + 值形态 + 香农熵三重判定,含 ${} 的值跳过;
7. 同一服务跨环境比对键集漂移和环境无关键取值漂移;
8. 输出:发现清单(文件/类别/键)、迁移后的规范化配置、
   逐键等价性校验结果;全程不删除任何文件。
"""
跑完之后值得问一句"哪些伤是你修了但没报告的"——这一问能逼出大多数静默修复。
收尾
配置治理的难点从来不是"读文件",而是"读不到的东西"。解析器报错的部分只占两成,剩下八成藏在重复键、继承链、环境差异和键名迁移里。
一句话总结这轮实测:朴素脚本看见了 46.26% 的世界,半治理看见了 68.50%,八段流水线看见了 100%,代价只是多花 0.34 秒。而那 0.34 秒换来的,是 488 处不会报错、但迟早会炸的隐患第一次有了名字。
(文中全部数据来自自建合成语料的可复现实测,与任何真实业务无关。)
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号