pdf转word怎么转,文字版直接导出,扫描版先做文字识别再转
原创
pdf转word怎么转,文字版直接导出,扫描版先做文字识别再转
原创
软领
发布于 2026-10-26 09:37:29
发布于 2026-10-26 09:37:29
PDF 转 Word 的通行做法,是用转换工具把文件导出成 DOC 或 DOCX:文字版基本能整份转成可编辑的 Word,段落、表格大致保持原样;扫描版整页都是图片,得先做文字识别再转。
多数转换失败都落在两件事上——没分清手上这份 PDF 是哪一类,或者输出格式选得不对。跟 PDF 本身坏没坏关系不大,不必急着重排一遍。下面这套流程在 Windows 10/11 上实测可用,硬件和系统环境都不需要动。
适用系统:Windows 10/11。最后更新:2026-10-25。
不少人是在这一步卡住的:PDF 用阅读器打开一切正常,转成 Word 后整页就是一张图片、一个字也选不中,或者 Word 弹「文件已损坏,无法打开」。这两件事的根子在同一个地方,就是这份 PDF 到底是文字版还是扫描版。判定清楚再动手,扫描版该先做文字识别就先做,能省掉一整轮返工。
先分清手上这份 PDF 是哪一类
文字版转出来能直接改字改段落;扫描版转出来往往只有图,或者一片乱码。动手前先分清是哪一种,后面选格式、定页面范围都能一次到位。
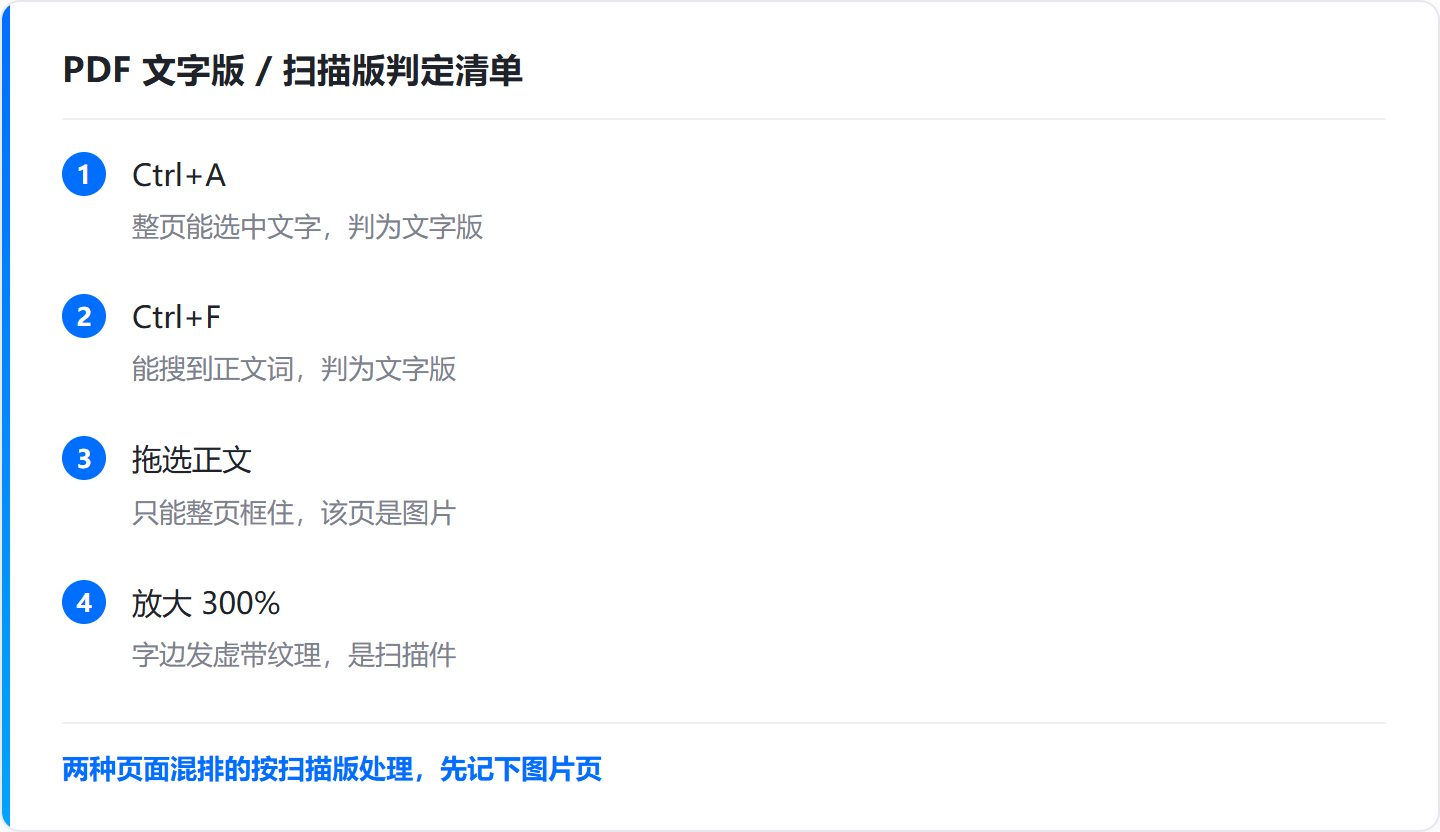
判定清单
- 用阅读器打开 PDF,按
Ctrl+A看能不能整页选中文字,正文整块变蓝基本就是文字版 - 按
Ctrl+F搜一个正文里肯定出现的词,能定位并高亮的是文字版,提示无结果的多半是扫描版 - 用鼠标拖选一段正文,光标拉不动、只能整页框住,可以判定这一页是图片
- 把页面放大到 300% 看字的边缘,笔画发虚、带纸张纹理的是扫描件,字边干净平滑的是文字版
- 一份文档里两种页面都有时,按扫描版处理,先记下哪几页是图片,后面按页设置范围
这里有个容易误判的地方:有些 PDF 正文带文本层,页眉页脚或插图却是图片,Ctrl+A 能选中正文并不代表整页都是文字。这种情况以正文能不能选中为准,页眉页脚那几块小图在 Word 里重新插一次就行,不必整页重做。
文字版和扫描版的差别
文字版里存的是字符和矢量字形,转换工具读得出来,段落、表格、编号基本能按原样落到 Word 里;扫描版存的是像素,工具看不到文字,只会把整页当图片贴过去。
判定清楚再挑格式,转出来不对的地方会少很多。
一份文档里两种页面混排时,先只转文字版那几页,图片页单独导出成图片做识别,最后把两段结果拼回去,比整份硬转省事得多。
加文件、定范围、选格式
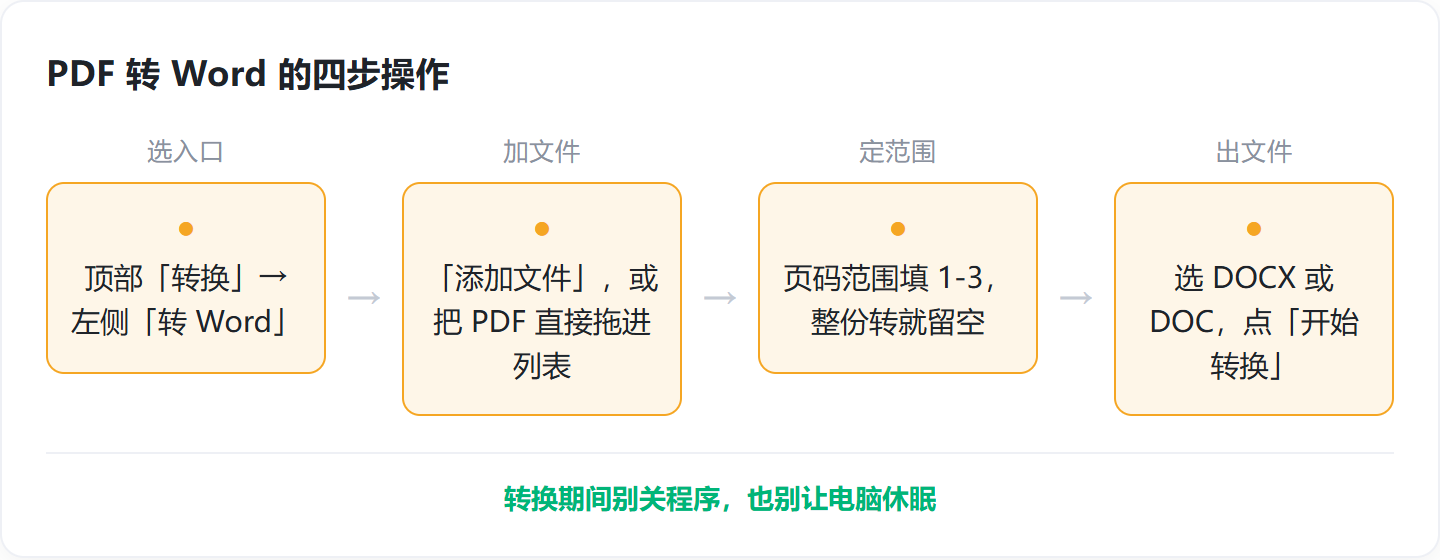
入口在顶部「转换」标签里,选定「转 Word」再用「添加文件」把 PDF 送进列表。这一步做对了,后面才有得转。
添加文件并核对页数
- 打开转换工具,点顶部「转换」标签,PDF 转 Office 这类入口都集中在这一栏
- 在左侧功能里选择「转 Word」,多数工具进入后默认选中的就是它
- 点右下角「添加文件」,在弹出的窗口里选中要转的 PDF;也可以直接把文件拖进转换列表
- 加好的 PDF 会列在转换列表里,文件名和页数都能看到,先核对是不是要转的那一份
- 页数多或文件大时,等列表把页数读全再往下走,避免后面漏页少转
文件送进列表后再核对一次页数,比转完发现少了十几页要省事得多。
圈定要转换的页码范围
整份转可以直接跳过这一步。只要其中几页时,先在列表里把范围圈出来,省得转出一份用不上的长 Word。
- 在转换列表里点开刚加入的 PDF,可以逐页预览整份文档
- 只需要其中几页时,在页码范围里填区间,例如
1-3;不连续的页写1,4,6 - 整份都要转就留空,默认全部页面参与转换
- 页数多的先翻一遍目录再定范围,把封面、空白页、附录排除掉
- 填完返回转换列表,再确认一次选中的页数和预期一致
范围填好再点转换,输出文件夹里就不会堆一堆转了一半的废文件。
选输出格式并开始转换
- 在输出格式里选
DOCX或DOC - 确认输出文件夹,默认是工具给出的路径,也可以点「浏览」改到桌面,转完方便找
- 点右下角「开始转换」,转换过程中不要关掉程序,也别让电脑休眠
- 转换完成后在列表里点「打开文件夹」,用 Word 打开转出来的文件
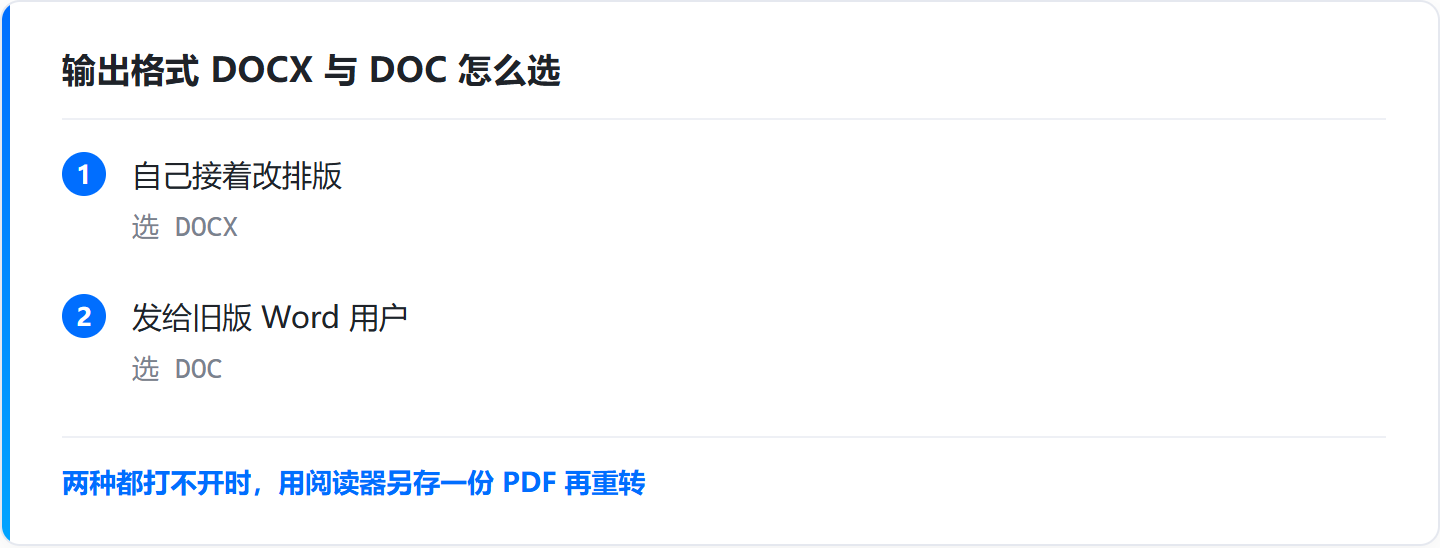
格式怎么挑看后面谁来用这份文件:接着自己改排版就选 DOCX,兼容新版 Office;要发给用旧版 Word 的同事就选 DOC,打开时不容易提示版本问题。
输出文件夹里已经有同名 Word 时,先把它挪走或者改个名,避免新版直接盖掉上一版。
转完先检查这三处
转完在 Word 里翻一遍再存档,这三处都正常,文件就能直接拿去用了。
- 段落:有没有连成一片,换行和缩进还在不在
- 表格:有没有错行、串列,合并单元格有没有散掉
- 公式和图片:有没有丢失,位置有没有跑偏
检查的时候顺手另存一份副本,改坏了还能退回到转换完的原始版本,不用从头再转。
扫描版与文件打不开的处理
这两类结果最常见,也最容易被误认为是 PDF 坏了。
- 转出来整页都是图片、正文一个字也选不中:说明原件是扫描版,转换工具只能把页面当图片搬过去。这时先把 PDF 按页导出成图片,做一次 OCR 文字识别,再把识别出的文字导出成 Word。识别结果要人工过一遍,数字、标点和生僻字最容易出错。
- 文件打不开,提示「文件已损坏」:重转一次,并把输出格式从
DOCX换成DOC,多半能打开。常见原因是转换中途关过程序或电脑进了休眠,文件没写完,跟 PDF 本身有没有问题关系不大。
常见问题
pdf转word怎么转才能保住原来的排版
选带版式还原的转换工具,输出格式用 DOCX,转完在 Word 里逐页核对段落、表格和页眉页脚。手工复制粘贴最容易把表格、编号弄乱,反而更费时间。
扫描版转完文字选不中,要重新打一遍吗
不用。先在阅读器里按 Ctrl+A 确认整页选不中,说明是图片,做一次 OCR 把图里的字提取出来,再导出成 Word。识别结果没法直接照用,数字和标点要逐页核对。
表格错行、图片丢了怎么处理
先看原件表格是不是多行合并的复杂排版,换成另一种输出格式(DOCX 换 DOC)再转一次通常能好些。图片丢失时,先在阅读器里确认图片本身能正常显示,再重转,别直接去改转出来的 Word。
只想转其中几页,范围在哪里设
在转换列表里点开这份 PDF,在页码范围里填区间,例如 1-3;不连续的页写 1,4,6。整份都要转就留空,默认全部页面参与转换。
转换完提示文件已损坏,是 PDF 本身的问题吗
多半跟 PDF 无关,常见原因是转换中途关过程序或电脑进了休眠,文件没写完。删掉重转一次,并把输出格式从 DOCX 换成 DOC 再试;两种都打不开,用阅读器另存一份 PDF 后重转。
这套流程覆盖不到的地方
- 打开就要输密码、或者被禁止复制的 PDF,得先在阅读器里解开权限另存一份,再走上面的流程
- 手写体、竖排内容、低分辨率拍照件的识别准确率明显下降,转出来的 Word 基本要重排
- 图表、公式密集的排版,Word 里多半还要再调一轮,别指望一次到位
- 一份文件里扫描页和文字页混排时,按页拆开分别处理,比整份硬转省事
- 单页尺寸特别大(图纸、海报类)的 PDF,拆成小块再转比整页转更好控制结果
按这套流程走一遍,多数 PDF 都能拿到一份能直接用的 Word;中途卡住的话回头看第 1 步,多半是文字版和扫描版判断反了。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号