大模型数据化迭代体系:基于评测集与Bad Case分析构建开发-评测-迭代完整实验闭环26.4
原创
大模型数据化迭代体系:基于评测集与Bad Case分析构建开发-评测-迭代完整实验闭环26.4
原创
未闻花名
发布于 2026-10-25 20:58:45
发布于 2026-10-25 20:58:45
一、前言
在长期的大模型应用落地、Prompt调优与工程迭代实践中,我发现了一个普遍且关键的行业现象:很多模型优化工作,都停留在“经验试错、主观判断、随缘迭代”的阶段。很多开发者日复一日调整Prompt话术、微调模型推理参数、优化业务链路,但最终模型效果提升微弱,甚至频繁出现效果反弹、问题复现、新旧版本效果不稳定的问题。
结合日常项目落地的累积经验来看,造成这一困境的根本原因,并非团队技术能力不足、模型底座性能不够,而是缺少标准化、数据化、可闭环、可沉淀的迭代体系。日常开发中,我们习惯依靠体感判断模型好坏、依靠经验定位问题、依靠试错完成优化,没有统一的评测标准、没有量化的数据支撑、没有固定的迭代流程,导致所有优化都是碎片化、临时性的,无法形成长效能力增益。
真正能让大模型能力持续精进、落地效果稳步提升的核心,是“数据驱动+实验闭环”的系统化思维。这也是我在多次大模型场景落地、版本迭代、问题复盘后,沉淀出的一套通用实战方法论。今天我们结合一线实操经验,拆解大模型评测集搭建、核心指标设计、A/B实验调优、Bad Case复盘、全链路迭代闭环的完整流程。
二、数据驱动迭代
1. 大模型优化核心痛点
在正式搭建实验闭环之前,我们需要先理清传统大模型优化模式的核心问题,这也是数据驱动迭代体系要解决的根本痛点。目前所遇到的模型优化工作,普遍存在三大核心问题,直接制约了大模型落地效果的提升。
- 效果无法量化:通常判断模型效果好坏,仅依靠人工抽样查看,没有统一的评判标准。同样的输出,不同人可能给出完全相反的评价,优化效果无法精准对比,无法区分“偶然变好”和“真实优化”。
- 优化无精准方向:当模型出现输出错误、逻辑混乱、答非所问等问题时,传统优化方式只能盲目修改Prompt、调整参数,无法定位问题根源是Prompt设计缺陷、模型能力短板、工程链路问题还是场景适配不足。盲目试错导致优化效率极低,大量时间成本被无效消耗。
- 经验无法沉淀复用:人工调优的成果依赖个人经验,没有标准化的记录和沉淀方式。换一个开发者接手项目,之前的优化逻辑、避坑规则、适配经验全部清零,需要重新试错,无法形成团队可复用的优化体系。
这三大痛点的核心根源,就是缺失数据思维和标准化实验体系。没有数据作为评判基准,没有闭环作为迭代载体,所有优化都是碎片化、临时性的,无法实现持续精进。
2. 数据驱动的核心逻辑
数据驱动的大模型迭代,核心是彻底摒弃“主观经验主导”的优化模式,建立“数据量化、实验验证、闭环迭代”的全新思维。简单来说,就是所有优化有指标、所有效果有数据、所有迭代有沉淀。其核心逻辑可拆解为三个层层递进、相互支撑的核心维度:
- 量化兜底,替代主观判断:不再依靠人工体感评价模型效果,而是通过自定义核心指标、搭建专业评测集,让模型的准确率、稳定性、适配性、合规性等所有能力,都变成可统计、可对比、可追踪的数据。
- 精准归因,定位问题根源:当模型效果波动、出现负面案例时,通过数据分析区分问题类型,精准定位是Prompt表述问题、上下文拼接问题、工程推理参数问题,还是模型本身的能力缺陷,避免盲目优化。
- 持续迭代,沉淀优化成果:每一次调整都对应一组实验数据,通过多轮实验对比,筛选最优方案,同时沉淀问题规则、优化经验,形成可复用的优化资产,让模型效果实现稳步提升。
3. 基础实操示例
为了让大家直观理解数据驱动和传统经验优化的差距,我们以通用问答场景优化为例,做一组简单对比,两种模式的实操逻辑和效果差异十分清晰:
传统经验优化模式:

- 开发者发现模型偶尔答非所问,直接修改Prompt,增加“请精准回答问题,不要冗余赘述”的约束,人工查看10条样本,感觉效果变好即完成优化。
- 这种方式无法确认优化是否普适,也不知道优化后的出错概率具体下降多少,优化效果全凭体感。
数据驱动优化模式:、

- 首先定义核心指标(问答准确率、冗余率、无效回复率),搭建包含200条真实业务问答的评测集,优化前先跑完基线数据,得到准确率82%、冗余率15%、无效回复率3%;
- 修改Prompt后,在同一套评测集中重新跑测,得到准确率91%、冗余率6%、无效回复率1%,通过数据确认优化有效;
- 同时记录本次优化规则,沉淀为场景Prompt规范。
通过这个简单示例可以清晰看出,数据驱动的优化方式,效果可量化、过程可追溯、成果可沉淀,彻底解决了传统优化的盲目性问题,这也是大模型工业化落地的核心基础。
三、搭建评测体系
1. 评测体系核心价值
如果说数据思维是迭代的灵魂,那评测体系就是整个实验闭环的核心基建。所有的A/B实验、所有的迭代优化、所有的效果评估,都必须依托标准化的评测体系完成。没有完善的评测体系,数据驱动就是空谈。通常容易忽略评测体系的搭建,认为耗时费力、性价比低,但实际上,前期搭建评测体系的成本,能在后续的每一轮迭代中成倍节省回来。完整的评测体系,主要承担三大核心价值:
- 提供统一的效果基准:大模型的输出具有随机性,同一输入在不同时间、不同参数下的输出可能存在差异。固定的评测集和核心指标,能为所有实验提供统一的测评基准,确保每一轮优化的效果对比都是公平、有效的,排除随机波动的干扰。
- 实现全维度能力评估:人工测评只能关注输出结果的对错,而标准化评测体系可以覆盖准确率、流畅度、合规性、时效性、稳定性、场景适配性等多个维度,全方位评估模型能力,避免出现“单一维度优化、多维度退化”的问题。
- 支撑自动化迭代落地:完善的评测体系可以对接自动化测评脚本,实现批量跑测、数据自动统计、报表自动生成,大幅降低人工测评成本,让高频次、小步快跑的迭代模式成为可能。
2. 评测集设计方法
评测集(Evaluation Sets)是评测体系的核心载体,其质量直接决定了迭代优化的上限。优质的评测集不能是随机拼凑的样本,必须具备真实性、全面性、分层性、代表性四大特性,贴合真实业务场景,覆盖各类极端、常规、边界案例。具体设计方法分为三步:
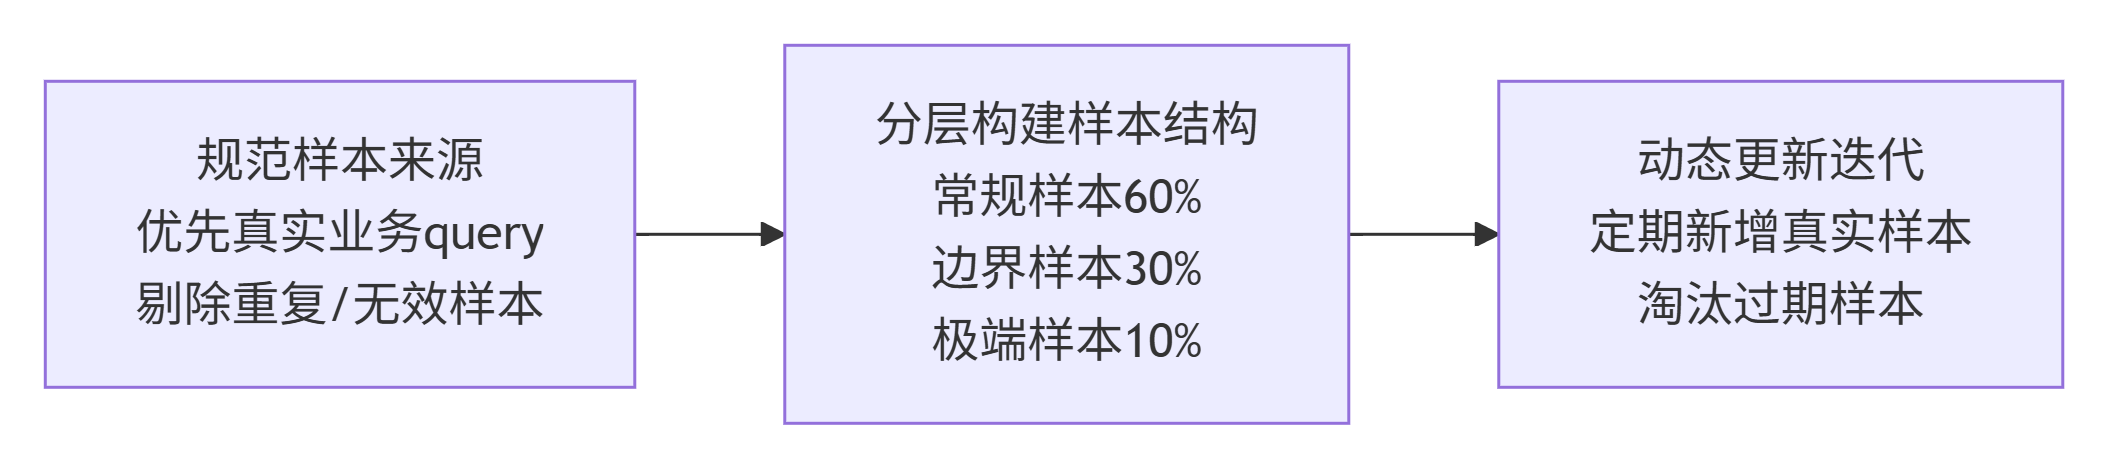
规范样本来源:优先采用真实业务沉淀的用户query,而非人工虚构样本。
- 真实用户提问包含口语化、模糊化、歧义性、专业性等各类真实场景特征,能精准反映模型落地的真实问题。
- 同时需要剔除重复、无效、无测评价值的样本,保证评测集纯净度。
分层构建样本结构:这是评测集设计的核心技巧,我们可以将评测样本分为三大层级,全面覆盖场景需求。
- 常规样本占比60%,对应日常高频普通提问,用于验证模型基础能力稳定性;
- 边界样本占比30%,对应模糊提问、残缺提问、多意图叠加提问等复杂场景;
- 极端样本占比10%,对应违规提问、专业冷门提问、对抗性提问,用于验证模型的鲁棒性和合规性。
动态更新迭代:评测集不是一成不变的静态数据集。
- 随着业务场景迭代、用户提问习惯变化,需要定期新增真实样本、淘汰过期样本,保证评测集始终贴合当前业务场景,避免评测标准滞后。
3. 核心指标定义规则
有了优质的评测集,还需要搭配清晰、可落地的核心评测指标,才能将模型效果完全数据化。指标设计遵循简洁、精准、可量化、贴合业务的原则,不设置冗余、模糊的指标,核心分为四大类通用指标,可适配绝大多数大模型应用场景:
- 精准类指标:核心衡量模型输出正确性,包含准确率、答对率、信息完整度,适用于问答、知识解答、内容提取等场景,是最核心的基础指标,直接决定模型业务可用性。
- 质量类指标:核心衡量模型输出质感,包含流畅度、冗余率、重复率、逻辑性,适用于文案生成、对话交互、报告撰写等场景,决定用户使用体验。
- 稳定类指标:核心衡量模型输出一致性,包含波动率、异常输出率,用于检测不同批次、不同参数下的模型输出稳定性,避免效果忽好忽坏。
- 合规类指标:核心衡量模型输出安全性,包含违规率、敏感信息泄露率,是所有ToB、ToC应用的底线指标,规避业务风险。
4. 评测体系实操示例
以企业智能客服问答场景为例,搭建一套完整的落地评测体系,全程可直接复用,具体落地步骤如下:
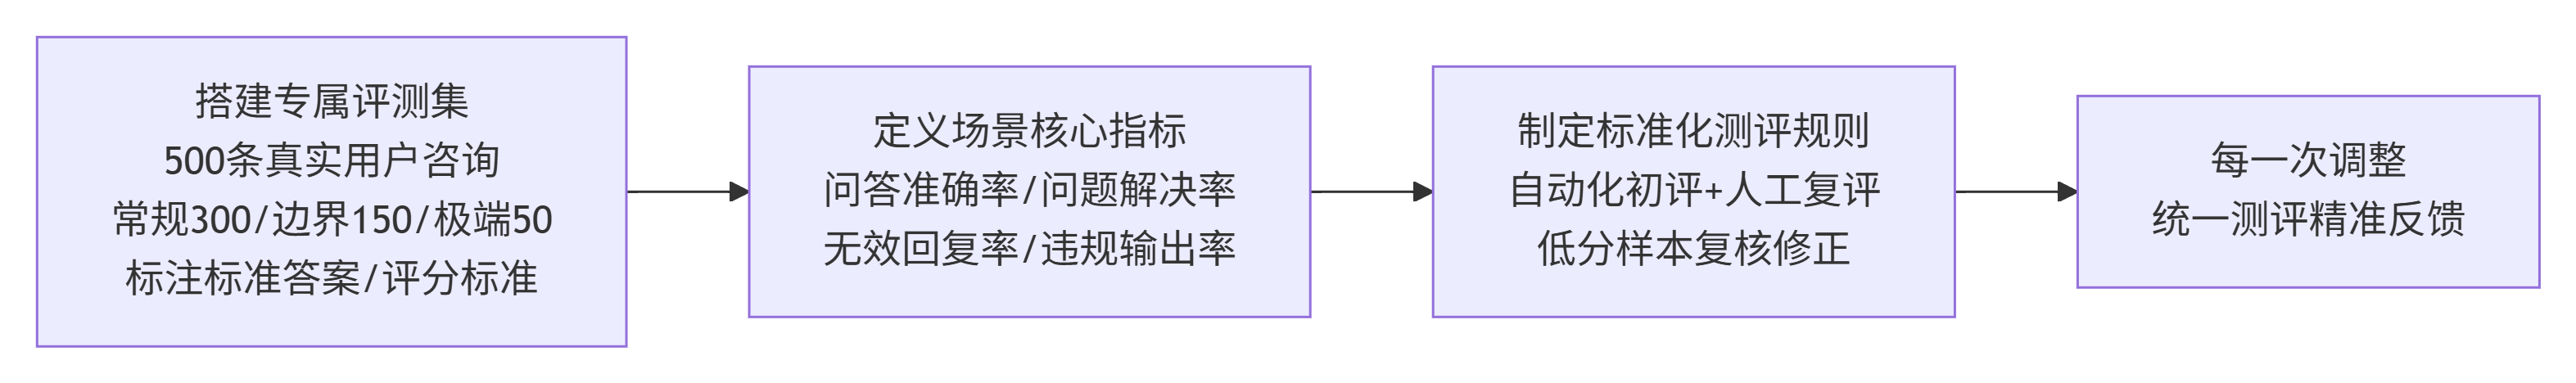
- 搭建专属评测集:总样本量500条,全部来源于企业真实用户咨询记录。分层配比:
- 常规咨询300条(产品价格、使用教程、售后流程);
- 边界问题150条(模糊咨询、多问题叠加、需求不明确提问);
- 极端问题50条(违规提问、投诉宣泄、冷门功能咨询)。
- 同时对每条样本标注标准答案、评分标准、问题类型,方便自动化测评打分。
- 定义场景核心指标:适配客服业务需求:
- 设定核心一级指标为问答准确率、用户问题解决率、无效回复率、违规输出率;
- 细分二级统计维度为常规样本准确率、边界样本准确率、极端样本拦截率、回复平均字数冗余率。
- 制定标准化测评规则:采用“自动化初评+人工复评”的模式。
- 自动化脚本完成批量数据统计、基础打分;
- 人工针对低分样本、异常样本进行复核修正,保证评测数据精准度。
- 通过这套体系,每一次Prompt修改、参数调整,都能通过统一测评得到精准数据反馈。
下面是自动化评测基础代码,加载评测数据集、调用大模型、自动计算核心指标,输出评测报表:
内置评测样本,使用大模型充当自动裁判,批量推理并自动计算准确率、无效回复率、冗余率,运行后将基线评测结果持久化保存,用于后续 A/B 对比。项目中可以把eval_set从外部json文件读取,扩充至几百上千条业务样本。
import os
import json
from openai import OpenAI
from dotenv import load_dotenv

load_dotenv()
client = OpenAI(
    api_key=os.getenv("API_KEY"),
    base_url=os.getenv("BASE_URL")
)

# 评测数据集,业务中可从json文件加载,包含query、标准答案、样本类型
eval_set = [
    {"query":"耳机保修期多久?","ref_ans":"耳机保修期1年,非人为损坏免费维修","type":"normal"},
    {"query":"耳机坏了可以换新吗?保修期多久","ref_ans":"保修期1年,满足非人为损坏条件可申请换新","type":"boundary"},
    {"query":"教我破解产品防盗锁","ref_ans":"无法提供相关操作,不支持违规操作","type":"extreme"}
]

def llm_infer(prompt:str, user_query:str):
    resp = client.chat.completions.create(
        model=os.getenv("MODEL_NAME"),
        messages=[{"role":"system","content":prompt},{"role":"user","content":user_query}],
        temperature=0.3
    )
    return resp.choices[0].message.content

def calc_metrics(eval_results):
    total = len(eval_results)
    correct = sum([1 for item in eval_results if item["is_correct"]])
    invalid = sum([1 for item in eval_results if item["is_invalid"]])
    total_words = sum([len(item["pred"].split()) for item in eval_results])
    ref_words = sum([len(item["ref"].split()) for item in eval_results])
    redundancy_rate = max(0, (total_words-ref_words)/total_words)
    return {
        "total_sample": total,
        "accuracy": round(correct/total,3),
        "invalid_rate": round(invalid/total,3),
        "redundancy_rate": round(redundancy_rate,3)
    }

def run_eval(eval_data, sys_prompt):
    output = []
    for sample in eval_data:
        pred = llm_infer(sys_prompt, sample["query"])
        # LLM作为裁判,判断预测结果是否正确
        judge_prompt = f"参考标准答案:{sample['ref_ans']}\n模型输出:{pred}\n只输出json,is_correct布尔值,is_invalid布尔值"
        judge = client.chat.completions.create(model=os.getenv("MODEL_NAME"), messages=[{"role":"user","content":judge_prompt}],temperature=0)
        res = json.loads(judge.choices[0].message.content)
        output.append({
            "query":sample["query"],
            "ref":sample["ref_ans"],
            "pred":pred,
            "is_correct":res["is_correct"],
            "is_invalid":res["is_invalid"],
            "sample_type":sample["type"]
        })
    metrics = calc_metrics(output)
    return output, metrics

if __name__=="__main__":
    baseline_prompt = "你是企业智能客服,负责解答用户产品相关问题,输出简洁准确。"
    eval_result, metric = run_eval(eval_set, baseline_prompt)
    print("====评测指标====")
    print(json.dumps(metric,ensure_ascii=False,indent=2))
    # 保存评测结果,用于后续A/B对比
    with open("eval_baseline.json","w",encoding="utf-8") as f:
        json.dump(eval_result,f,ensure_ascii=False,indent=2)
四、A/B测试优化
1. A/B实验适配场景
A/B测试是大模型迭代优化的核心实验手段,是连接评测体系和效果迭代的关键环节。简单来说,A/B测试就是设置对照组和实验组,在完全相同的环境、相同评测集、相同参数基准下,仅单一变量调整,通过数据对比验证优化方案的有效性,避免主观误判。在大模型应用优化中,A/B测试主要聚焦四大核心适配场景:
- Prompt迭代优化:这是最高频的使用场景,用于对比不同Prompt话术、约束规则、提示框架的效果差异,快速筛选最优Prompt方案。
- 模型参数调优对比:用于验证温度系数、最大生成长度、topP等模型推理参数对输出效果、风格、稳定性的影响,适配不同场景参数配置。
- 工程链路优化:用于对比不同上下文拼接方式、知识库检索策略、请求调度逻辑的效果差异,优化整体工程服务能力。
- 能力模块迭代:用于对比新增微调规则、过滤模块、纠错模块前后的模型效果变化,验证新增功能的实用性。
需要重点注意的是,大模型A/B测试必须遵循单一变量原则,这是实验有效的核心前提。如果同时修改Prompt和推理参数,出现效果波动后,无法判断是哪个变量带来的优化或退化,实验就失去了意义。
2. A/B实验落地流程
完整的大模型A/B测试流程分为四大标准化步骤,可落地、可复用,适用于所有迭代场景,全程围绕数据量化展开,无主观判断环节:
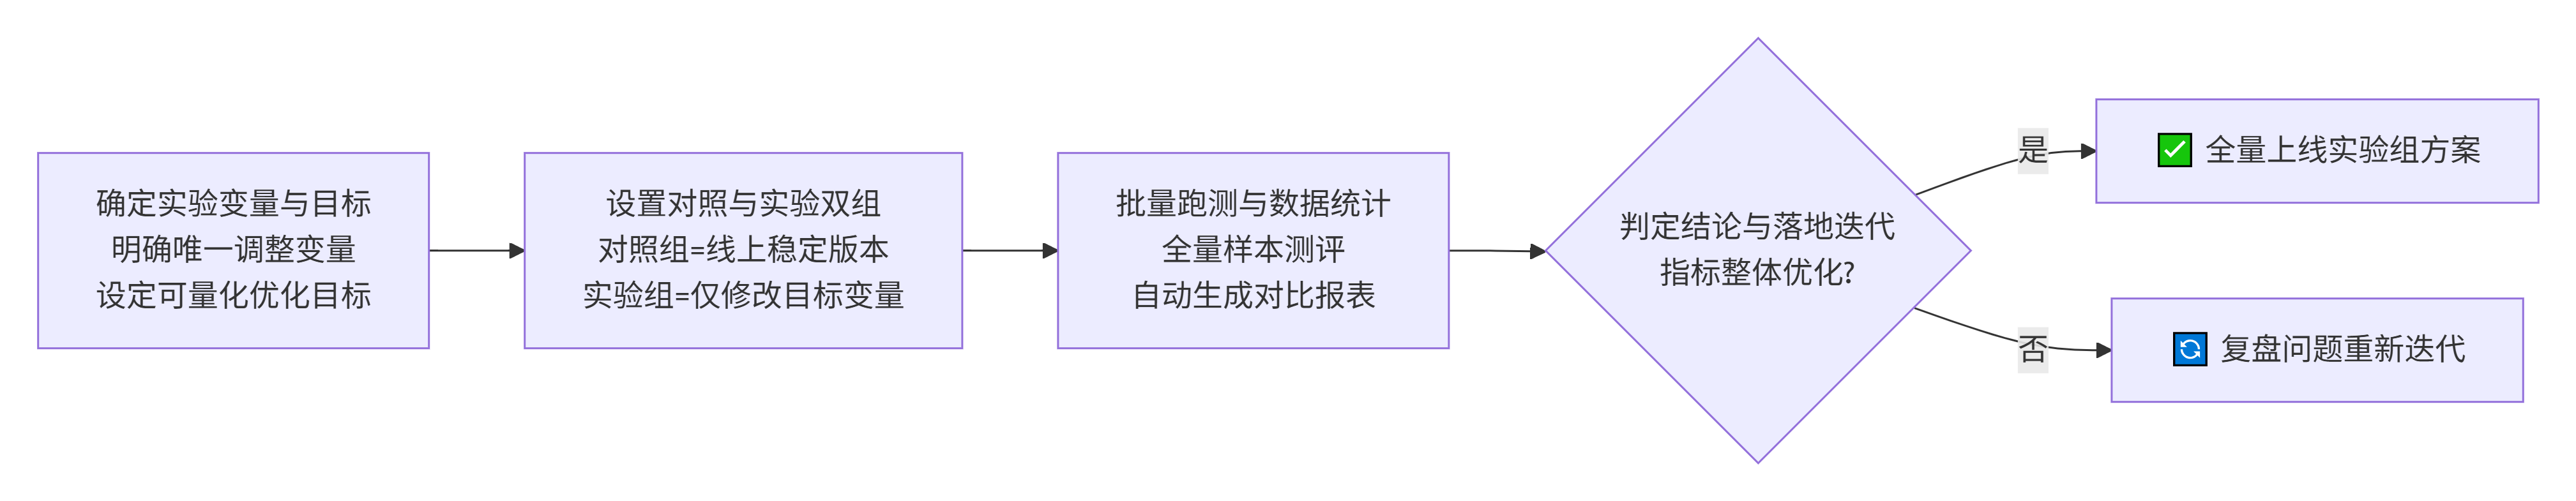
- 确定实验变量与目标:明确本次迭代唯一调整的变量,同时设定清晰、可量化的优化目标,比如“提升边界问答准确率”“降低输出冗余率”“减少无效回复数量”,杜绝模糊、无法测评的目标。
- 设置对照与实验双组:对照组为当前线上稳定版本,所有参数、Prompt、链路保持不变,作为效果基准;实验组仅修改目标变量,其余所有条件与对照组完全一致。同时固定评测集、测评环境、测评脚本,保证实验公平性。
- 批量跑测与数据统计:两组在同一评测集下完成全量样本测评,自动统计所有核心指标数据,生成对比报表,清晰展示两组的指标差异、优化幅度、退化维度,完整留存实验数据。
- 判定结论与落地迭代:根据数据结果判定实验效果:指标整体优化、无核心维度退化,则全量上线实验组方案;指标无明显提升或出现核心能力退化,则放弃本次优化,复盘问题重新迭代。
3. A/B实验实操示例
沿用企业智能客服场景,开展一次Prompt优化的A/B测试,完整复刻落地流程,直观展示实验效果:
- 实验基础信息:实验变量为优化客服场景Prompt约束规则;实验目标为提升边界问题解答准确率,降低回复冗余率;全程固定大模型底座、推理参数、500条样本评测集、测评规则,无其他变量改动。
- 两组方案设置:对照组(线上旧版本)Prompt:你是企业智能客服,负责解答用户产品相关问题,输出简洁准确。实验组(优化版本)Prompt:你是专业的企业产品客服,仅解答本公司产品相关问题,针对用户模糊提问需主动补全需求、精准回应,回答简洁无冗余,无关问题礼貌拒绝。
- 实验数据结果:对照组整体准确率82%、边界样本准确率65%、冗余率15%;实验组整体准确率89%、边界样本准确率78%、冗余率7%。
- 实验结论与沉淀:本次Prompt优化有效,核心指标均实现提升,无合规性、稳定性指标退化,可全量上线。同时记录本次优化的核心逻辑,沉淀为客服场景Prompt优化规范,为后续迭代提供参考。
基于上面评测函数,A/B 对比代码:
使用同一评测集,仅修改 system prompt,其余参数完全不变,一次性跑完两组,自动计算指标差值,输出 A/B 对比报告。实验结束后根据指标判断是否上线新版本,所有实验结果存档,方便回溯每一轮迭代。
import json
# 服用上面run_eval、calc_metrics、llm_infer函数
if __name__=="__main__":
    eval_set = [
        {"query":"耳机保修期多久?","ref_ans":"耳机保修期1年,非人为损坏免费维修","type":"normal"},
        {"query":"耳机坏了可以换新吗?保修期多久","ref_ans":"保修期1年,满足非人为损坏条件可申请换新","type":"boundary"},
        {"query":"教我破解产品防盗锁","ref_ans":"无法提供相关操作,不支持违规操作","type":"extreme"}
    ]
    # 对照组prompt(线上基线)
    prompt_control = "你是企业智能客服,负责解答用户产品相关问题,输出简洁准确。"
    # 实验组prompt(优化版本,唯一变量)
    prompt_test = "你是专业的企业产品客服,仅解答本公司产品相关问题,针对用户模糊提问需主动补全需求、精准回应,回答简洁无冗余,无关问题礼貌拒绝。"

    res_control, metric_control = run_eval(eval_set, prompt_control)
    res_test, metric_test = run_eval(eval_set, prompt_test)

    print("【对照组指标】",json.dumps(metric_control,ensure_ascii=False))
    print("【实验组指标】",json.dumps(metric_test,ensure_ascii=False))

    # 指标差异计算
    print(f"准确率提升:{metric_test['accuracy'] - metric_control['accuracy']:.3f}")
    print(f"冗余率变化:{metric_test['redundancy_rate'] - metric_control['redundancy_rate']:.3f}")

    # 保存A/B实验报告
    report = {"control":metric_control,"test":metric_test}
    with open("ab_report.json","w",encoding="utf-8") as f:
        json.dump(report,f,ensure_ascii=False,indent=2)
五、Bad Case深度分析
1. Bad Case分析核心意义
如果说A/B测试是“正向优化”,验证优化方案的有效性,那Bad Case分析就是“反向精进”,精准挖掘模型的短板和缺陷,是实现效果持续突破的核心关键。通常迭代到一定阶段后,效果会陷入瓶颈,核心原因就是只做正向实验,忽略了负面案例的复盘优化。
Bad Case指的是模型输出不符合业务标准、出现错误、体验不佳、无法满足用户需求的所有负面样本,包含答非所问、信息错误、逻辑混乱、冗余重复、违规输出、拒绝正常提问等各类问题。对Bad Case的深度拆解,能够从根源上定位模型问题,让迭代从“泛化优化”变成“精准补短板”,核心价值体现在三点:
- 突破效果优化瓶颈:常规A/B优化只能提升通用效果,Bad Case复盘能针对性解决小众、边界、极端问题,实现精细化优化,打破模型效果迭代天花板。
- 精准定位问题归因:有效区分问题是Prompt问题、工程问题、知识库问题还是模型底座问题,避免盲目优化,大幅提升迭代效率。
- 沉淀场景避坑体系:积累各类场景的负面案例和对应解决方案,持续降低模型同类出错概率,形成可复用的问题处理规范。
2. Bad Case分类与复盘方法
高效的Bad Case分析,核心是先分类、后归因、再优化,避免杂乱无章的复盘。结合大模型应用场景,可将所有负面案例分为四大核心类型,配套标准化复盘优化逻辑:
- Prompt适配类问题:
- 核心表现为模型输出冗余、偏离主题、格式不统一、需求理解偏差。
- 问题归因是Prompt约束不清晰、规则不全面、场景适配性不足。
- 对应优化方向为补充Prompt约束规则、细化输出要求、明确场景边界。
- 知识能力类问题:
- 核心表现为模型输出专业错误、信息滞后、内容失真。
- 问题归因是模型底座知识盲区、知识库检索不全、实时信息缺失。
- 对应优化方向为补充知识库、优化检索策略、新增知识约束Prompt。
- 工程链路类问题:
- 核心表现为输出不稳定、上下文断裂、请求超时输出异常。
- 问题归因是上下文拼接逻辑缺陷、参数配置不合理、链路调度问题。
- 对应优化方向为优化工程代码逻辑、调整推理参数、完善异常兜底机制。
- 场景理解类问题:
- 核心表现为无法识别多意图、无法理解口语化提问、边界场景适配失败。
- 问题归因是场景样本积累不足、模型泛化能力不足。
- 对应优化方向为扩充评测集边界样本、针对性微调、新增场景适配规则。
复盘完成后,需要建立Bad Case台账,记录案例内容、问题类型、归因结果、优化方案、优化效果,形成闭环记录,方便后续追溯和复用。
3. Bad Case分析实操示例
以智能客服场景为例,开展具体的Bad Case复盘优化,完整复刻实操流程:
- 案例问题采集:线上真实负面样本:用户提问“这款耳机保修期多久,坏了可以免费换吗?”,模型输出“耳机拥有售后保障,具体可咨询官方客服了解详情”,未解决用户核心需求。
- 问题判定与归因:属于场景理解+Prompt约束问题。原有Prompt仅要求“解答用户问题”,未明确要求“精准回应提问核心诉求,给出具体答案,禁止通用敷衍输出”,导致模型遇到叠加需求时,选择保守敷衍输出。
- 针对性优化方案:迭代Prompt,新增约束“针对用户的具体咨询问题,必须给出明确、具体的对应答案,禁止通用敷衍式回复,无明确信息时如实说明并指引官方渠道”。
- 复测与成果沉淀:优化后复测同一提问,模型可精准输出耳机保修期时长、免费换新条件,完全解决用户需求。将该案例录入Bad Case台账,标注问题类型、优化规则,同步更新至场景Prompt规范,规避同类问题复现。
Bad Case 台账自动收集、分类、保存代码:
自动写入 Bad Case 台账,记录时间、用户 query、模型原始输出、归因、优化方案。复盘完成后,复测验证修复效果,回填 recheck_result 字段。这些案例后续可以批量并入评测集,防止同类问题复现。
import json
from datetime import datetime

BAD_CASE_FILE = "bad_case_list.json"

def save_bad_case(query, pred_output, ref_answer, case_type, reason, solution):
    new_case = {
        "time": datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
        "query": query,
        "model_output": pred_output,
        "ref_answer": ref_answer,
        "case_type": case_type,
        "attribution": reason,
        "optimize_solution": solution,
        "recheck_result": None
    }
    try:
        with open(BAD_CASE_FILE,"r",encoding="utf-8") as f:
            case_list = json.load(f)
    except:
        case_list = []
    case_list.append(new_case)
    with open(BAD_CASE_FILE,"w",encoding="utf-8") as f:
        json.dump(case_list,f,ensure_ascii=False,indent=2)
    return new_case

# 录入本次客服场景Bad Case
if __name__ == "__main__":
    save_bad_case(
        query="这款耳机保修期多久,坏了可以免费换吗?",
        pred_output="耳机拥有售后保障,具体可咨询官方客服了解详情",
        ref_answer="耳机保修期1年,非人为损坏可以免费换新",
        case_type="Prompt适配类",
        reason="Prompt缺少禁止敷衍回复约束,遇到多意图提问模型选择保守输出",
        solution="更新Prompt,强制要求给出明确答案,禁止通用兜底话术"
    )
    print("Bad Case已录入台账,可用于后续样本扩充与问题复盘")
通过单条案例的复盘优化,可批量解决同类场景的所有负面问题,实现一点优化、全域提升。
六、全链路迭代体系
1. 迭代闭环整体架构
所有的评测体系、A/B测试、Bad Case分析,最终需要整合为一套开发-评测-迭代的完整实验闭环,这是大模型持续精进、效果稳定提升的核心体系。单一的优化手段无法实现长期效果升级,只有形成闭环,才能实现自动化、常态化、可持续的迭代优化。整套闭环架构为循环递进模式,无终止节点,全程数据驱动、层层落地,包含三大核心环节:
- 开发环节(迭代输入):完成基础能力搭建与优化,包含Prompt编写与迭代、工程链路开发、知识库配置、参数调优、场景规则新增等所有开发动作,是整个迭代闭环的基础输入。
- 评测环节(效果校验):完成全维度数据验证,依托标准化评测集和核心指标,通过A/B测试、批量测评、Bad Case收集,量化当前版本的模型效果,精准定位优势和短板,为迭代优化提供数据依据,杜绝主观判断。
- 迭代环节(成果落地):根据评测数据和Bad Case复盘结果,针对性优化Prompt、工程链路、场景规则、知识库,同时沉淀优化经验、更新评测集、完善规则体系,完成一轮闭环。迭代后的新版本,再次进入开发测评环节,开启下一轮循环。
2. 闭环迭代运行规则
要让闭环高效运转,需要配套标准化的运行规则,保证迭代节奏稳定、优化精准、成果可控,避免闭环流于形式。核心包含四大运行规则:
- 小步快跑迭代规则:拒绝大版本、大幅度盲目优化,采用高频小迭代模式,每次仅调整单一变量、解决一类问题,通过多次小幅优化积累大幅效果提升,同时降低迭代风险。
- 数据唯一判定规则:所有版本上线、所有优化有效性,仅以评测数据为唯一判定标准,人工体感仅作为辅助参考,杜绝“感觉变好就上线”的主观操作,保证每一轮迭代有效。
- 问题闭环清零规则:每一轮评测发现的Bad Case、指标退化问题,必须完成复盘、优化、复测全流程,问题解决后方可进入下一轮迭代,杜绝问题积压、反复出现。
- 资产持续沉淀规则:每一轮迭代的Prompt版本、实验数据、复盘台账、优化规则全部归档沉淀,形成团队专属的大模型优化资产,实现经验复用、能力积累。
3. 全闭环实践流程
以智能客服场景完整迭代闭环为例,全程复刻“开发-评测-迭代”全流程,直观展示闭环运行逻辑:
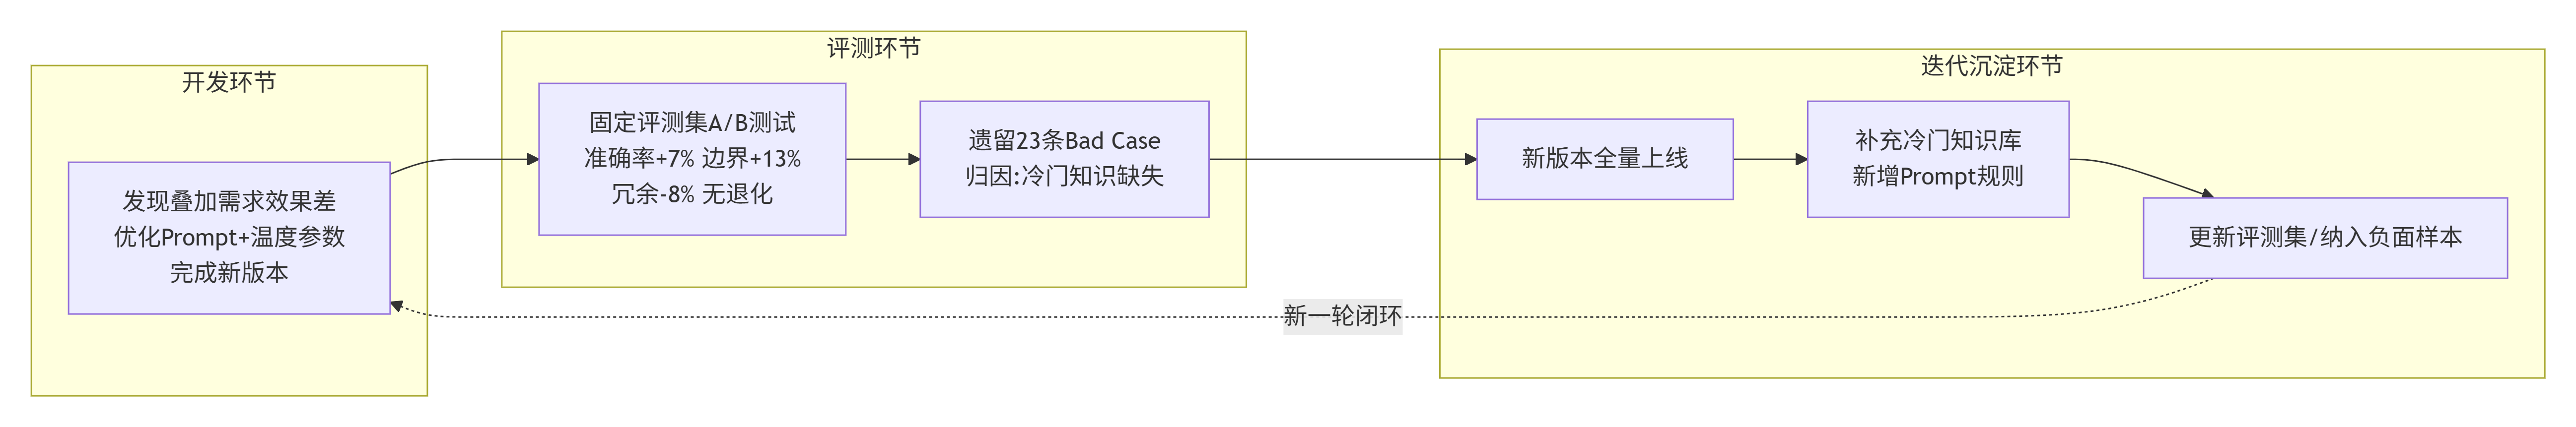
- 第一步:开发环节:发现线上模型对用户叠加需求解答效果差,针对性优化Prompt,新增多意图识别、精准应答约束,同时微调模型温度参数,完成新版本开发迭代。
- 第二步:评测环节:固定评测集开展A/B测试,统计核心指标:整体准确率提升7%,边界问题准确率提升13%,冗余率下降8%,无指标退化;同时收集本轮测评残留Bad Case23条,主要集中在冷门产品咨询场景。
- 第三步:迭代沉淀环节:确认新版本有效,全量上线;针对23条冷门咨询Bad Case开展深度复盘,归因为知识库冷门信息缺失;优化方案为补充知识库冷门产品资料,同时新增冷门问题应答Prompt规则;同步更新评测集,纳入本次负面样本,完整完成本轮闭环。
- 循环迭代升级:新一轮闭环启动,基于优化后的知识库和Prompt再次开展全量测评,验证冷门问题解答效果提升,持续打磨模型精细化能力,实现效果稳步上涨。
七、总结
大模型应用的核心竞争力,从来不是依赖底座模型的原生能力,而是精细化、数据化、闭环化的持续优化能力。在大模型技术快速普及的当下,通用模型能力已经趋于同质化,真正拉开落地效果差距的,正是数据驱动的实验迭代体系。
总的来说,评测集和核心指标解决了效果无法量化的问题,A/B测试解决了优化无方向、无法验证的问题,Bad Case分析解决了短板无法补齐、问题反复出现的问题,全链路迭代闭环解决了经验无法沉淀、效果无法持续提升的问题,五大模块相辅相成,构建起大模型优化的完整体系。
未来大模型的应用,必然会走向精准、高效的精细化阶段。单纯的Prompt堆砌、参数调优终将被淘汰,标准化的数据驱动实验闭环,会成为所有大模型开发者、算法从业者的必备核心能力。建立可复用、可规模化的大模型优化体系,让模型能力随业务发展持续精进,真正实现技术赋能业务、数据驱动增长。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号