pdf压缩后不清晰,先关图片重采样再锁回 300dpi,实测体积只多两成
原创
pdf压缩后不清晰,先关图片重采样再锁回 300dpi,实测体积只多两成
原创
软领
发布于 2026-10-25 09:34:17
发布于 2026-10-25 09:34:17
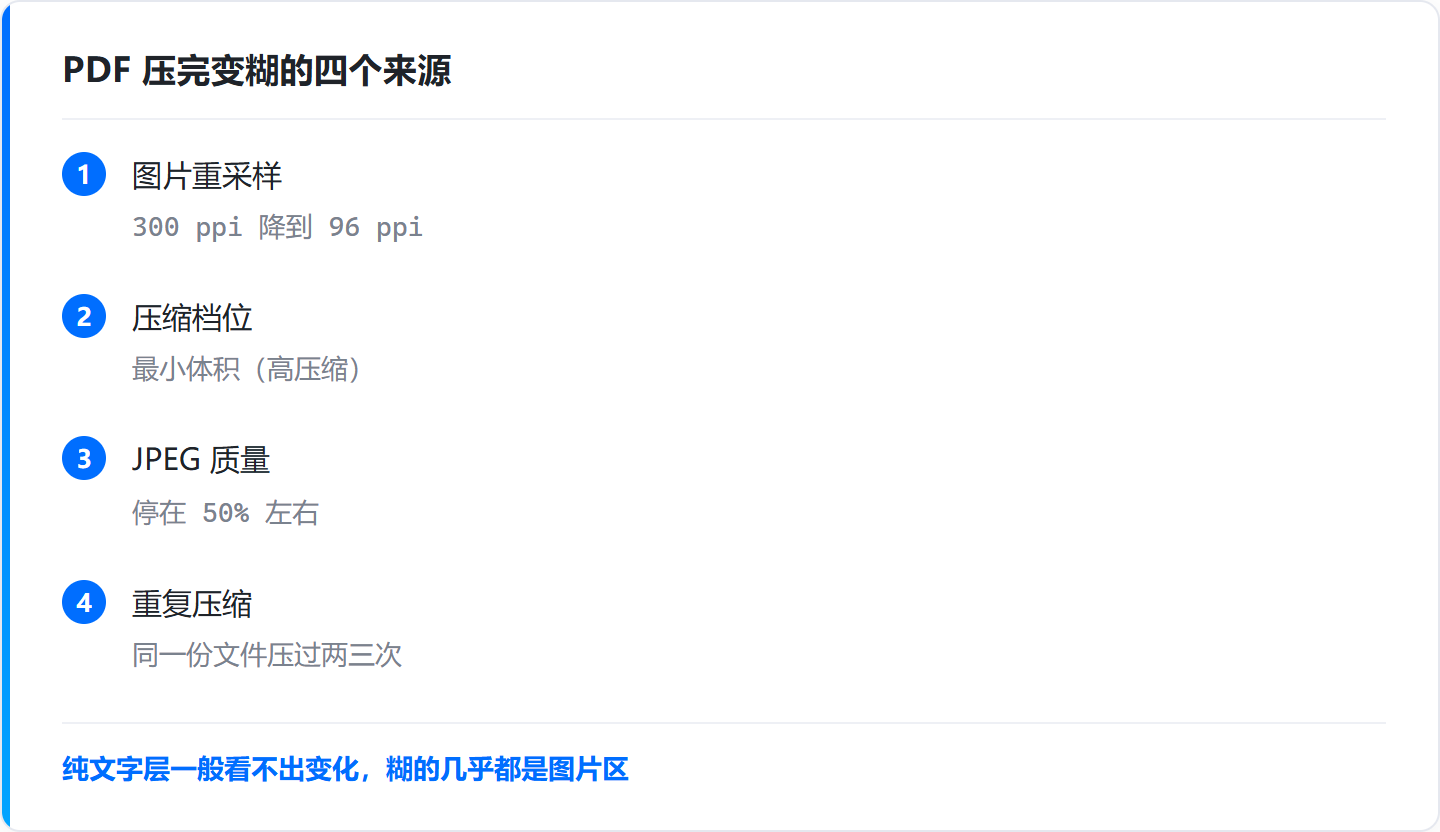
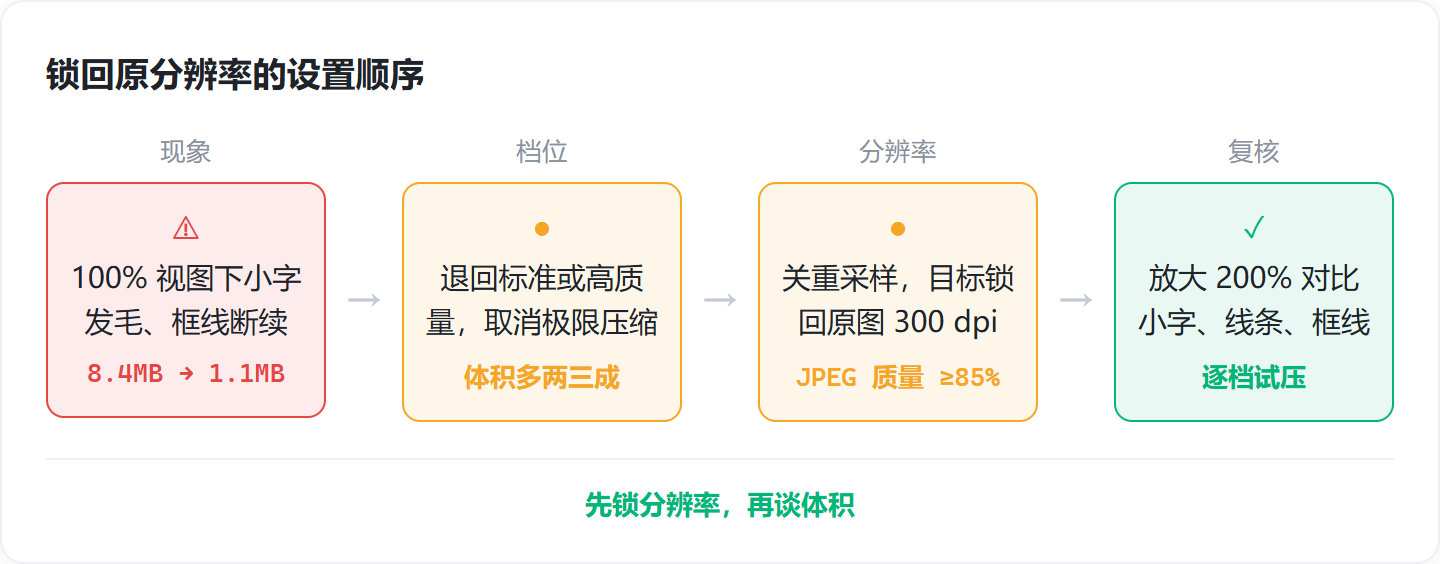
一份 300 ppi 的扫描页,压完在 100% 视图下小字发毛、表格框线断续,文档属性里的图片分辨率掉到 96 ppi,体积从 8.4MB 缩到 1.1MB。糊掉的几乎都是图片区,纯文字层一般看不出变化。
这类模糊多数出在压缩设置本身,原始文件大多没坏。留一份未压缩母本重新压一遍,清晰度通常能找回一大部分,不用把整份文档重做。
下面这些操作在 Windows 10/11 上实测可用,最后更新:2026-10-24。
压完为什么会糊
直接的一环是压缩时把内嵌图片重新采样,分辨率降到 150 dpi 甚至 72 dpi。像素被重算一遍,丢掉的部分补不回来。除此之外还有几种常见来源:
- 压缩档位选了「最小体积(高压缩)」:算法优先砍体积,画面发虚常常就是这一步造成的
- 图像质量(JPEG 质量)停在 50% 左右:高频细节被量化掉,小字边缘先出问题
- 勾了「转换为灰度」「降低色彩位深」「二值化」:彩色图和细线图会明显变样
- 同一份文件反复压:每压一轮都掉一层画质,块状噪点会累积
300 ppi 的扫描页压到 96 ppi 之后,放大到 200% 看小号文字和表格框线,差别一眼能看出来。
先分清是图片糊还是文字糊
先判断糊在哪一层,再回头对照压缩设置里的图片选项,比反复重压同一个文件有效得多。图片区糊、文字层清楚,问题基本落在图片选项上;连正文小字也发虚,说明整份文件被转成了 JPEG 或者整体降了位深,处理方式不一样。
- 只有图片和表格框线发虚:查重采样、目标分辨率、JPEG 质量这三项
- 正文小字也开始发毛:查有没有「全文转 JPEG」「降低位深」这类全局选项
- 扫描页糊、其余页正常:把扫描页拆出来单独处理
- 越压越糊:先停手,从原始母本重来
方法一:压缩级别退回标准或高质量
导入文件之后先别追求最小体积。「最小体积(高压缩)」改成「标准」或「高质量」,体积可能只多出两三成,清晰度却能回来一大截。
- 打开 PDF 压缩功能,先把手边那份原始未压缩的母本留好,再导入压完发糊的文件
- 在压缩级别 / 压缩质量一栏,把「最小体积(高压缩)」改成「标准」或「高质量」
- 取消勾选「极限压缩」「强力压缩」这类以省体积为目标的选项
- 重新执行一次压缩,输出成新文件名,不要覆盖原文件
- 把新文件和母本同屏放大到 100%,对比文字边缘和图片细节有没有发虚
- 还是偏糊就再往上一档逐档试压,直到体积和清晰度都能接受
每轮试压都从母本导出,不要在上一轮的输出件上接着压。
方法二:关掉内嵌图片重采样,锁定原始分辨率
图片被下采样到 150 dpi 或 72 dpi,是画面变糊里很直接的一环。压缩设置里凡是带「自动」「按屏幕质量优化」字样的勾选项,先全部取消,再手动把目标分辨率锁回原图那一档。
- 进入压缩设置里的「图片」或「图像」选项页
- 找到「重采样 / 下采样 / 目标分辨率」一栏,把 150 dpi 改成「保持原样」或 300 dpi
- 关闭「自动压缩图片」「按屏幕质量优化」「智能降质」这类默认勾选项
- 把图像质量滑块拉到 85% 以上,不要停在 50% 左右
- 检查有没有勾上「转换为灰度」「降低色彩位深」,需要彩色就一并取消
- 重新压缩后放大到 200%,重点看小号文字、线条图和表格框线
方法三:按页拆分,只压体积大的页面
一份 30 页的标书里,往往只有五六页扫描图和插页占了大头。把这几页拆出来单独处理,剩下的文字页原样保留,清晰度和体积都能兼顾,也避免一刀切把整份文件压糊。
- 先用 PDF 的拆分 / 提取页面功能,把文件按页或按章节拆成几个小文件
- 对拆出来的页面单独做图片压缩,质量档位选高,不要选最小体积那一档
- 把压好的页面按原页序合并成一个完整 PDF
- 放大对比各页:糊掉的页面回退用原始页,只有体积大的页面留压缩版
- 确认页数、书签和页码没在拆分合并过程中错位
方法四:无损压缩,图片层单独设高质量 JPEG
文字层走无损算法、图片层单独定质量,比整份文件一起降质更容易保住清晰度。Flate(ZIP)这类无损方式只在编码上做文章,像素一个不动,文字边缘不会发虚。
它对重复内容多的表格和纯文字页效果明显,对已经压过一轮的 JPEG 大图作用有限,大图仍然要靠图片质量档来控制。
- 在压缩方式 / 压缩算法里选 Flate(ZIP)这类无损方式,避免把全文转成 JPEG
- 图片格式设为「保留原格式」,或者把 JPEG 质量给到 90
- 关闭「降低位深」「二值化」「转灰度」这类省体积选项
- 重新导出后看文件体积,文字边缘应该不再发虚
- 如果体积反而变大,说明这份文件没什么可无损压缩的空间,回到方法一调级别
方法五:压不动就只压该压的部分
必须清晰的页原样留着,只管附件和大图,这是体积实在降不下来时的兜底做法。反复压换不来更小的体积,只会一层层吃掉画质。
- 在 PDF 属性 / 文档信息里看图片数量和分辨率,判断体积大头在哪
- 只对嵌入附件、大尺寸截图做处理,正文文字页不动
- 体积仍超标就拆成两个文件分批发送
- 始终保留一份未压缩原件作为母本,之后每轮压缩都从它开始
什么情况下不适用
文件形态 | 建议做法 | 结果 |
|---|---|---|
纯文字页为主 | Flate(ZIP)无损压缩 | 体积仍能减掉一部分 |
扫描页占多数 | 关重采样 + 锁 300 dpi,档位选高质量 | 体积多两三成 |
只有几页是大图 | 按页拆开,只压这几页 | 其余页没有损失 |
已经压过两三次 | 回原始母本重来 | 压缩件本身救不回 |
母本已经删掉 | 去邮件附件或云盘历史版本里找原件 | 没有别的办法 |
几条边界:
- 无损压缩之后体积反而变大是正常的,说明文件本身没什么冗余可挤
- 线条图和表格框线对压缩比较敏感,放大对比时先看这两处
- 体积和清晰度是一对取舍,同一档位在不同文件上的表现差别很大,没有一刀切的数值
常见问题
pdf压缩后不清晰还能还原吗?
从压缩件本身还原不了,重采样丢掉的像素没有备份。母本还在就重新压一次;母本已经删掉,只能去邮件附件或云盘历史版本里找回原件。
pdf压缩级别调到多少才不会模糊?
没有固定数值。先把图片目标分辨率设成保持原样或 300 dpi,JPEG 质量给到 85% 以上,体积还能接受就别再往下调。
扫描件压缩后文字发虚怎么办?
扫描页整页就是一张图,被下采样到 150 dpi 以下文字就会发毛。关掉重采样、分辨率留 300 dpi,或者把扫描页拆出来用高保真档压。
PDF 里的图片保留多少 dpi 才清晰?
屏幕上 100% 查看,150 dpi 勉强够用;要打印或者放大看细节,留 300 dpi。原件本来就是 300 ppi 的,别让压缩把它降到 150 dpi 以下。
同一份 PDF 压了两次,是不是越压越糊?
是。有损压缩每一轮都会再丢一层信息,两轮之后小字和图片噪点明显变差,压缩件本身回不到第一版的样子。
相关阅读
- 图片压缩后变模糊,回到原图重压,截图改存 PNG
- 压缩包压完还是很大,只小几百 KB 多半是源文件压不动
- 压缩文件失败排查,从源文件占用到磁盘权限依次看
- PDF 太大了怎么缩小不改变质量,先把压缩档位退回上一档
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号