AI 模型选型:调用量第一的模型,能力榜排第 17
原创
AI 模型选型:调用量第一的模型,能力榜排第 17
原创
用户12769047
发布于 2026-10-24 15:56:04
发布于 2026-10-24 15:56:04
十月的两组榜单摆在一起看,结论有点反直觉:OpenRouter 上 10 月 1 日到 22 日调用量第一的 DeepSeek V4.1 Flash 跑出 102.2 万亿 token,但在 Artificial Analysis 的智能指数榜上只排第 17 位,45.1 分。而智能指数第一的 Claude Opus 5.5 拿了 57.6 分,调用量 19 万亿,排第 10。两者差了 5.4 倍用量、12.5 个智能分。这不是榜单出错,而是两套坐标系在量两件不同的事:一个量"实际被用了多少",一个量"上限有多高"。做 AI 模型选型时把它们混着看,是最常见的翻车起点。
一、两组数字放在一起,反差有多大
调用量月榜:Flash 版本霸榜
数据来源是 OpenRouter 的真实 token 调用量,统计区间 2026 年 10 月 1 日至 10 月 22 日。
排名 | 模型 | 开发商 | 累计调用量 |
|---|---|---|---|
1 | DeepSeek V4.1 Flash | DeepSeek | 102.2 万亿 |
2 | GLM 5.3 Flash | Z.ai | 38.9 万亿 |
3 | MiMo V2.6 Flash | 小米 | 31.9 万亿 |
4 | Space Bunny Alpha | Stealth | 28 万亿 |
5 | DeepSeek V4.1 Flash(另一条目) | DeepSeek | 26.7 万亿 |
6 | Hy4 Preview | 腾讯 | 25.9 万亿 |
7 | Step 5 Preview | 阶跃星辰 | 22.3 万亿 |
8 | GPT 6 Luna | OpenAI | 22.2 万亿 |
9 | Nemotron 3 Ultra 550B A55B(免费) | NVIDIA | 19.7 万亿 |
10 | Claude Opus 5.5 | Anthropic | 19 万亿 |
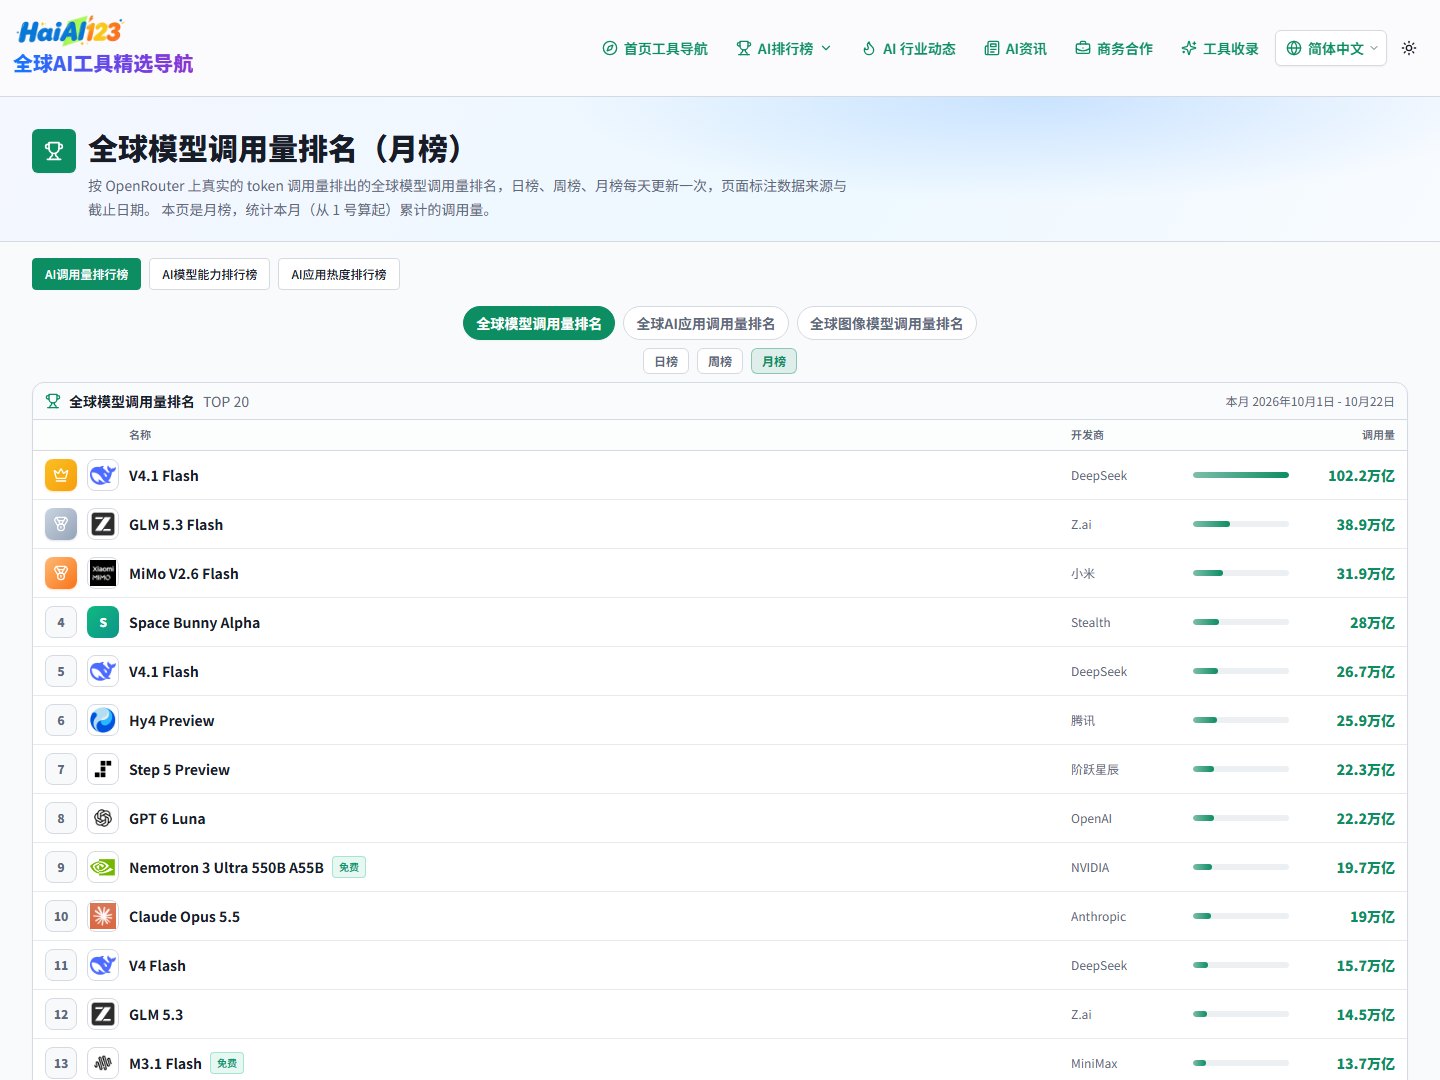
全球模型调用量排名月榜:DeepSeek V4.1 Flash 以 102.2 万亿 token 居首,Claude Opus 5.5 以 19 万亿排第 10(数据来源:HaiAi123,OpenRouter 真实 token 用量,统计区间 2026 年 10 月 1 日至 22 日)
智能指数榜:前十四名没有一个中国模型
数据来源是 Artificial Analysis 的评测指数与竞技场 Elo,更新于 2026 年 10 月 24 日,价格是该厂商直连的每百万 token 报价。
排名 | 模型 | 智能指数 | 输入 / 输出价格 |
|---|---|---|---|
1 | Claude Opus 5.5 | 57.6 | $4 / $20 |
2 | Claude Sonnet 5.5 | 56.0 | $2 / $10 |
3 | Muse Wonder Full | 55.8 | — |
4 | Claude Fable 5.1 | 53.4 | $10 / $50 |
5 | GPT-6 Astra | 52.7 | $10 / $50 |
6 | Gemini 4 Argon | 52.6 | $2 / $10 |
7 | Muse Wonder | 52.4 | $4 / $20 |
8 | GPT-6.1 Sol | 51.8 | $2 / $10 |
9 | Claude Opus 5 | 50.8 | $5 / $25 |
10 | Claude Fable 5 | 49.6 | $10 / $50 |
15 | MiMo-V2.6-Pro | 46.3 | $0.44 / $0.87 |
17 | DeepSeek V4.1 Flash 1017 | 45.1 | $0.3 / $1.2 |
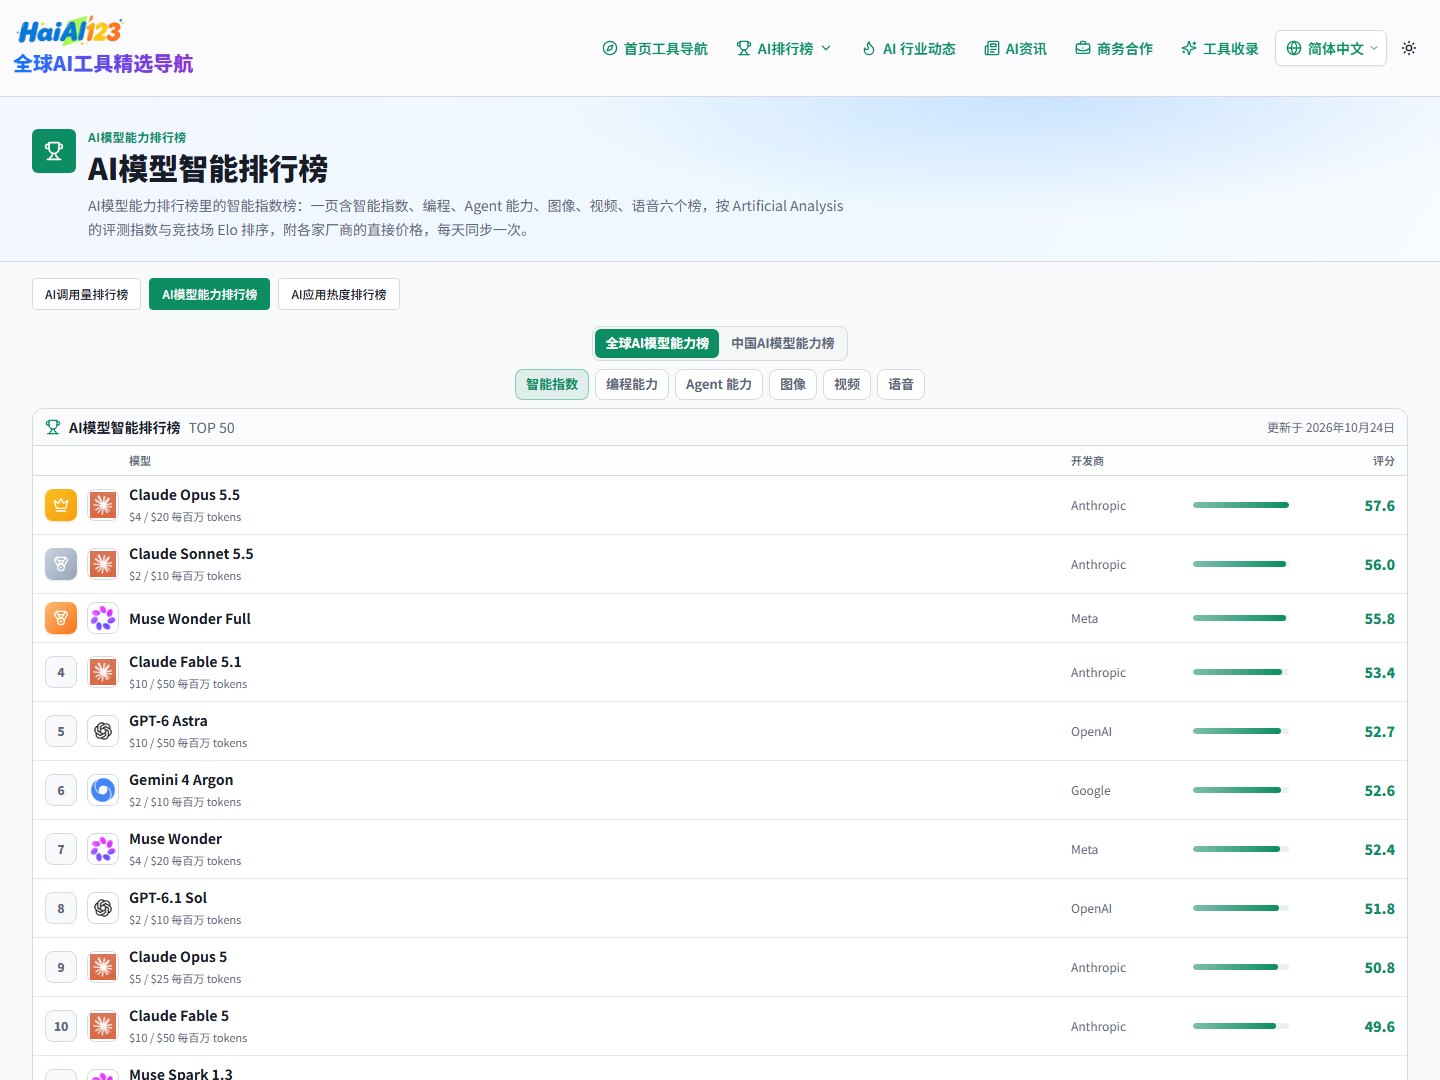
AI 模型智能指数榜:Claude Opus 5.5 以 57.6 分居首,前十名全部为海外模型,中国模型最早出现在第 15 位的小米 MiMo-V2.6-Pro(数据来源:HaiAi123,Artificial Analysis 评测指数与竞技场 Elo,更新于 2026 年 10 月 24 日)
三个必须看清的反差
反差一:调用量冠军在能力榜上排第 17。 DeepSeek V4.1 Flash 拿了 102.2 万亿 token,是第二名的 2.6 倍,但在智能指数上比 Claude Opus 5.5 低 12.5 分。这个分差在智能指数榜上意味着十多个身位。
反差二:能力冠军的用量不到冠军的五分之一。 Claude Opus 5.5 的 19 万亿只占 DeepSeek V4.1 Flash 的 18.6%,排在第十。
反差三:调用量前十有 6 个中国模型,智能指数前十有 0 个。 这条对比最容易被误读成"能力不行",但把它和价格放在一起看,答案完全不同:中国模型的智能指数集中在 43–46 分区间的第 15 到第 20 位,价格是 $0.3–$1.4 的输入价,而前十名里最便宜的一档也要 $2 输入 / $10 输出。
二、背离是怎么产生的
2.1 调用量衡量的是"够用且付得起",不是"最强"
一个模型被调用 102 万亿 token,说明大量业务场景在它上面跑得通、账算得过来,不代表它在难题上表现最好。调用量是成本、延迟、稳定性、可用性、生态成熟度的合成结果,智能指数只是其中一个变量,而且往往不是权重最高的那个。
把两边的价格拉出来算一笔:Claude Opus 5.5 输出价 $20,DeepSeek V4.1 Flash 输出价 $1.2,差 16.7 倍。一个日均消耗 10 亿输出 token 的应用,用前者每天烧 2 万美元,用后者每天烧 1200 美元。当任务本身对智能指数的要求落在 45 分就能覆盖的区间,这 16 倍差价没有任何理由去付。
2.2 Flash 和轻量版才是调用量的主力
调用量前 13 名里,带 Flash、Luna、Preview 这类轻量或预览标识的占了 7 席。这不是巧合:同一家的旗舰版和 Flash 版往往共享架构,差在参数规模、推理预算和定价。业务方先用 Flash 跑通链路,只在难点上切旗舰版,是当前最主流的用法。
还有一个信号值得注意:免费模型进了前 15。NVIDIA 的 Nemotron 3 Ultra 550B A55B 以 19.7 万亿排第 9,MiniMax M3.1 Flash 以 13.7 万亿排第 13,两个都标着免费。这说明调用量榜里有一块需求是纯粹被价格驱动的——它不是"能力选型",是"成本选型"。
2.3 Agent 场景把成本敏感度进一步放大
看应用侧的周榜(统计至 2026 年 10 月 22 日):
排名 | 应用 | 本周请求量 | 本周 token 量 |
|---|---|---|---|
1 | Claude Code | 3386.1 万次 | 5.4 万亿 |
2 | Kilo Code | 873.9 万次 | 2.4 万亿 |
3 | DeepSeek Harness | 689.4 万次 | 1.5 万亿 |
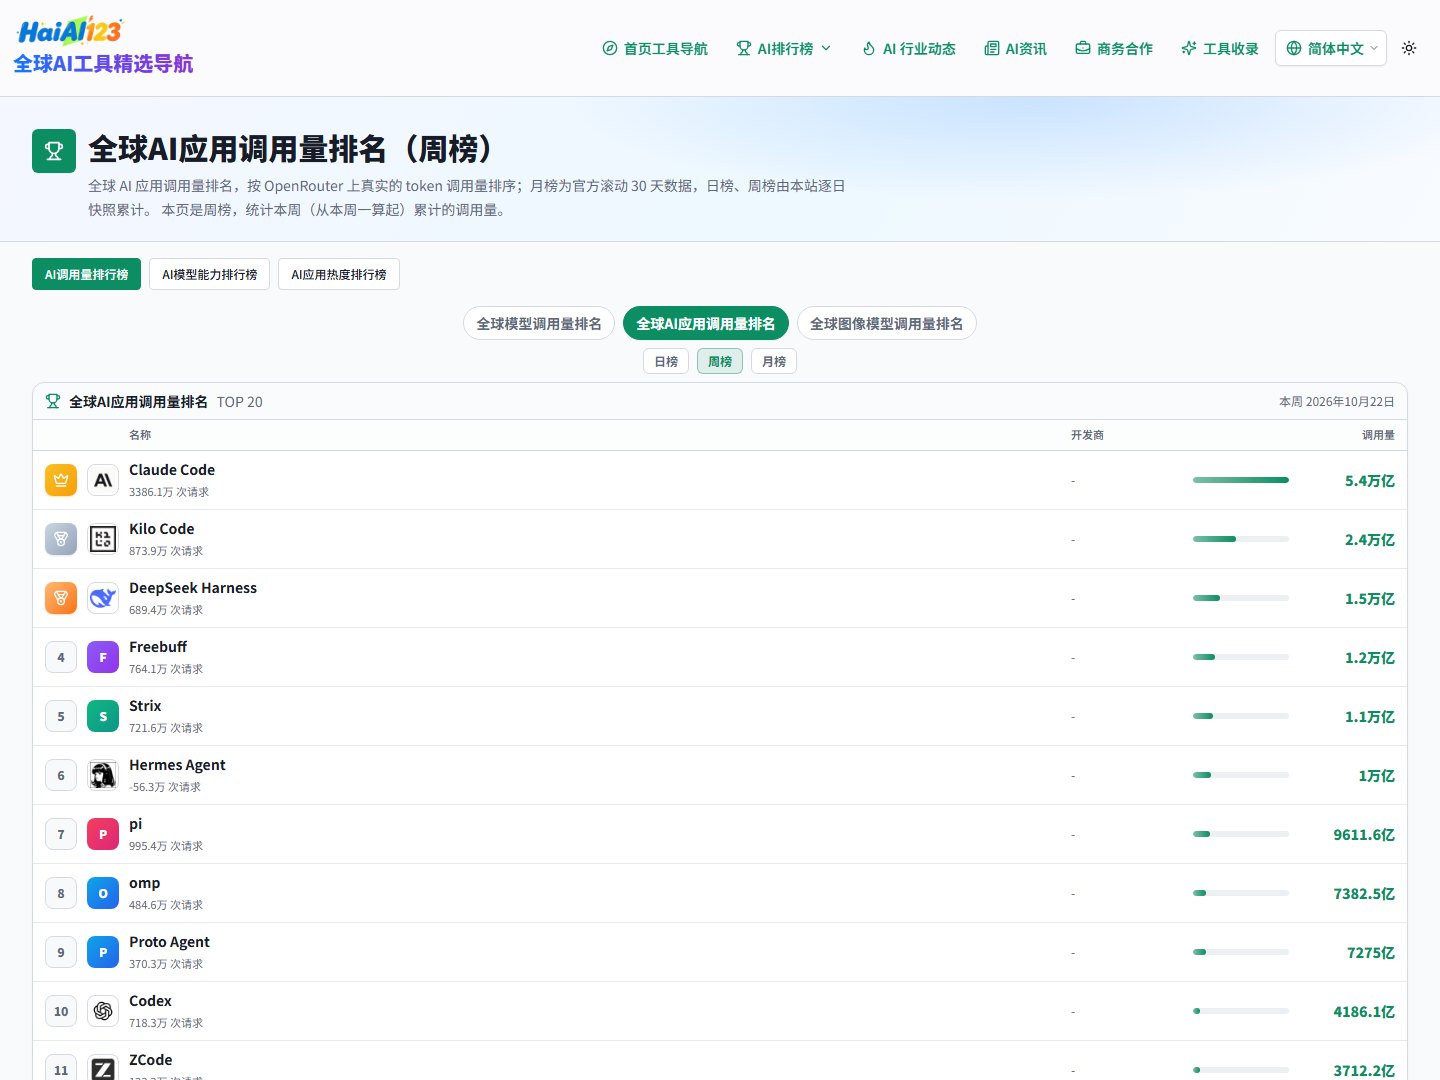
全球 AI 应用调用量周榜:Claude Code 以 3386.1 万次请求、5.4 万亿 token 居首,Kilo Code 与 DeepSeek Harness 分列二三位(数据来源:HaiAi123,OpenRouter 真实 token 用量,统计至 2026 年 10 月 22 日)
Claude Code 的请求量是 Kilo Code 的 3.9 倍,但 token 量只有 2.25 倍。换算下来,Claude Code 单次请求平均消耗的 token 更少——这是典型的 Agent 型负载特征:请求频次高、单次上下文相对短、工具调用密集。这类负载对单价极度敏感,因为它不是"偶尔问一次",而是"连续跑几百轮"。一个百分点,单价的差异会在整条流水线上放大成数量级的成本差。
三、比"哪个最强"更有用的指标:每分智能多少钱
把智能指数除以输出单价,能得到一个更贴近决策的比值——每提升 1 分智能,要付多少美元。
模型 | 智能指数 | 输出价(每百万 token) | 每分智能成本 |
|---|---|---|---|
Claude Opus 5.5 | 57.6 | $20 | $0.347 |
Claude Sonnet 5.5 | 56.0 | $10 | $0.179 |
Gemini 4 Argon | 52.6 | $10 | $0.190 |
Muse Spark 1.3 | 48.1 | $4.25 | $0.088 |
小米 MiMo-V2.6-Pro | 46.3 | $0.87 | $0.019 |
DeepSeek V4.1 Flash 1017 | 45.1 | $1.2 | $0.027 |
蚂蚁百灵 Ling 3.1 Flash 1019 | 43.9 | $0.9 | $0.021 |
这张表能读出一条很实用的结论:从 45 分往上爬的每一分,价格都在指数级上涨。 46.3 分的 MiMo-V2.6-Pro 每分智能成本 $0.019,57.6 分的 Claude Opus 5.5 是 $0.347,相差 18 倍,而智能指数只高了 11.3 分。
所以选型时真正该问的不是"哪个模型最强",而是"我的任务需要多少分,超过这个分的部分我愿不愿意付 18 倍价钱"。绝大多数内容生成、摘要、分类、结构化抽取、常规代码补全任务,45 分档完全够用;只有在长链推理、复杂重构、高难度数学与竞赛级编程上,那 11 分的差距才会真实体现成产出质量的差异。
四、五步选型法
第一步,先定能力下限,不是能力上限。 拿 20–30 条真实业务样本(不是公开跑分题),从最便宜的模型开始往上试,记录通过率。找到通过率跨过 85% 的那一档就停下,不要继续往上堆。这一步能砍掉大部分不必要的成本。
第二步,算单位成本,算全链路的。 不要只看输入价。一次请求的实际成本 = 输入 token × 输入价 + 输出 token × 输出价 + 重试次数 × 单次成本。Agent 类应用的输出占比高、重试率高,输出价才是主导项。
第三步,按场景匹配结构能力,而不是分数。 长上下文、结构化输出(JSON mode / function calling)、多模态输入、流式延迟,这四项在榜单分数里体现不出来,但会直接决定你的工程能不能跑。选型时先做一次结构能力验证,再谈分数。
第四步,做 A/B 实测,用你自己的评测集。 公开跑分和你的业务分布之间永远有 gap。同一批样本跑两个候选模型,人工或规则判优劣,取实际胜率。这一步花一天,能避免上线后花一个月返工。
第五步,留降级路径。 主模型和备用模型必须能在一个配置项里切换,且两者的输出格式要能被同一层解析器消费。这是应对涨价、限流、下线的唯一保险。十月这一个月里,能力榜和调用量榜的位次变动就足够说明问题。
五、常见问题
Q1:调用量榜能当能力榜用吗?
不能。调用量反映的是成本与可用性驱动下的集体选择,能力榜反映的是评测上限。一个模型调用量高只能说明它"够用且便宜",不能说明它"更强"。两者要分开看,交叉看。
Q2:为什么中国模型调用量高,智能指数却排不进前十?
不是同一个维度上的竞争。中国模型的智能指数集中在 43–46 分,价格在 $0.3–$1.4 输入价这一档;前十名集中在 49–57.6 分,价格 $2–$10 输入价。两者的定位不同:一个打性价比区间的规模用量,一个打能力上限的高价值任务。在 45 分够用的场景里,前者是理性选择。
Q3:免费的模型能用吗?
能,且已经有实证。NVIDIA Nemotron 3 Ultra 550B A55B 和 MiniMax M3.1 Flash 都进了调用量前 15。但免费通常伴随限流、无 SLA、随时调整策略的风险,适合做实验、批处理和容错度高的任务,不适合做核心链路。用之前先确认它的限流阈值和可用性承诺。
Q4:价格越贵就越好吗?
只在"你需要那部分能力"时成立。Claude Opus 5.5 比 MiMo-V2.6-Pro 贵 23 倍(输出价 $20 对 $0.87),智能指数高 11.3 分。如果你的任务在 46 分档就能达到 85% 通过率,多付的 23 倍买到的边际收益接近于零。
Q5:智能指数差 1 分,实际差别有多大?
在这个区间里,1 分不是线性收益。从 45 到 46 可能只是某个子项的小幅提升,从 56 到 57.6 往往对应更难任务上的显著改善。判断方法不是看分数差,而是看你自己的评测集通过率差——这两者经常不成比例。
Q6:榜单多久看一次比较合理?
月榜看趋势,周榜看异动,日榜只在你要做即时切换时看。位次变动频繁是常态,不要因为单周波动就改架构。真正值得触发重新选型的信号是:主模型涨价、限速策略变化、新版本在你的评测集上通过率提升超过 5 个百分点。
Q7:国产模型和海外模型怎么搭配?
常见做法是分层:用国产高性价比模型承接大规模常规请求,用海外高智能模型处理少量高价值难题,中间用路由层按任务难度分发。这样既能压住成本,又不牺牲关键任务的产出质量。前提是两边的输出格式要统一,否则路由层会变成新的维护负担。
以上榜单数据来自 HaiAi123(haiai123.com) 的 AI 排行榜,调用量榜取 OpenRouter 真实 token 用量、每日更新,能力榜取 Artificial Analysis 评测指数与竞技场 Elo、每日同步,两榜都标注统计区间与截止日期,可自行核对原始数值。
需要说明的是,榜单是决策的起点而不是结论。同一份数据,做批量摘要的和做复杂代码重构的,读出来的最优解完全不同。真正决定选型质量的,永远是你自己那 20 条业务样本的通过率。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号