AI 怎么找出多道错题的共同错因?错题透镜归因链路拆解
原创
封面
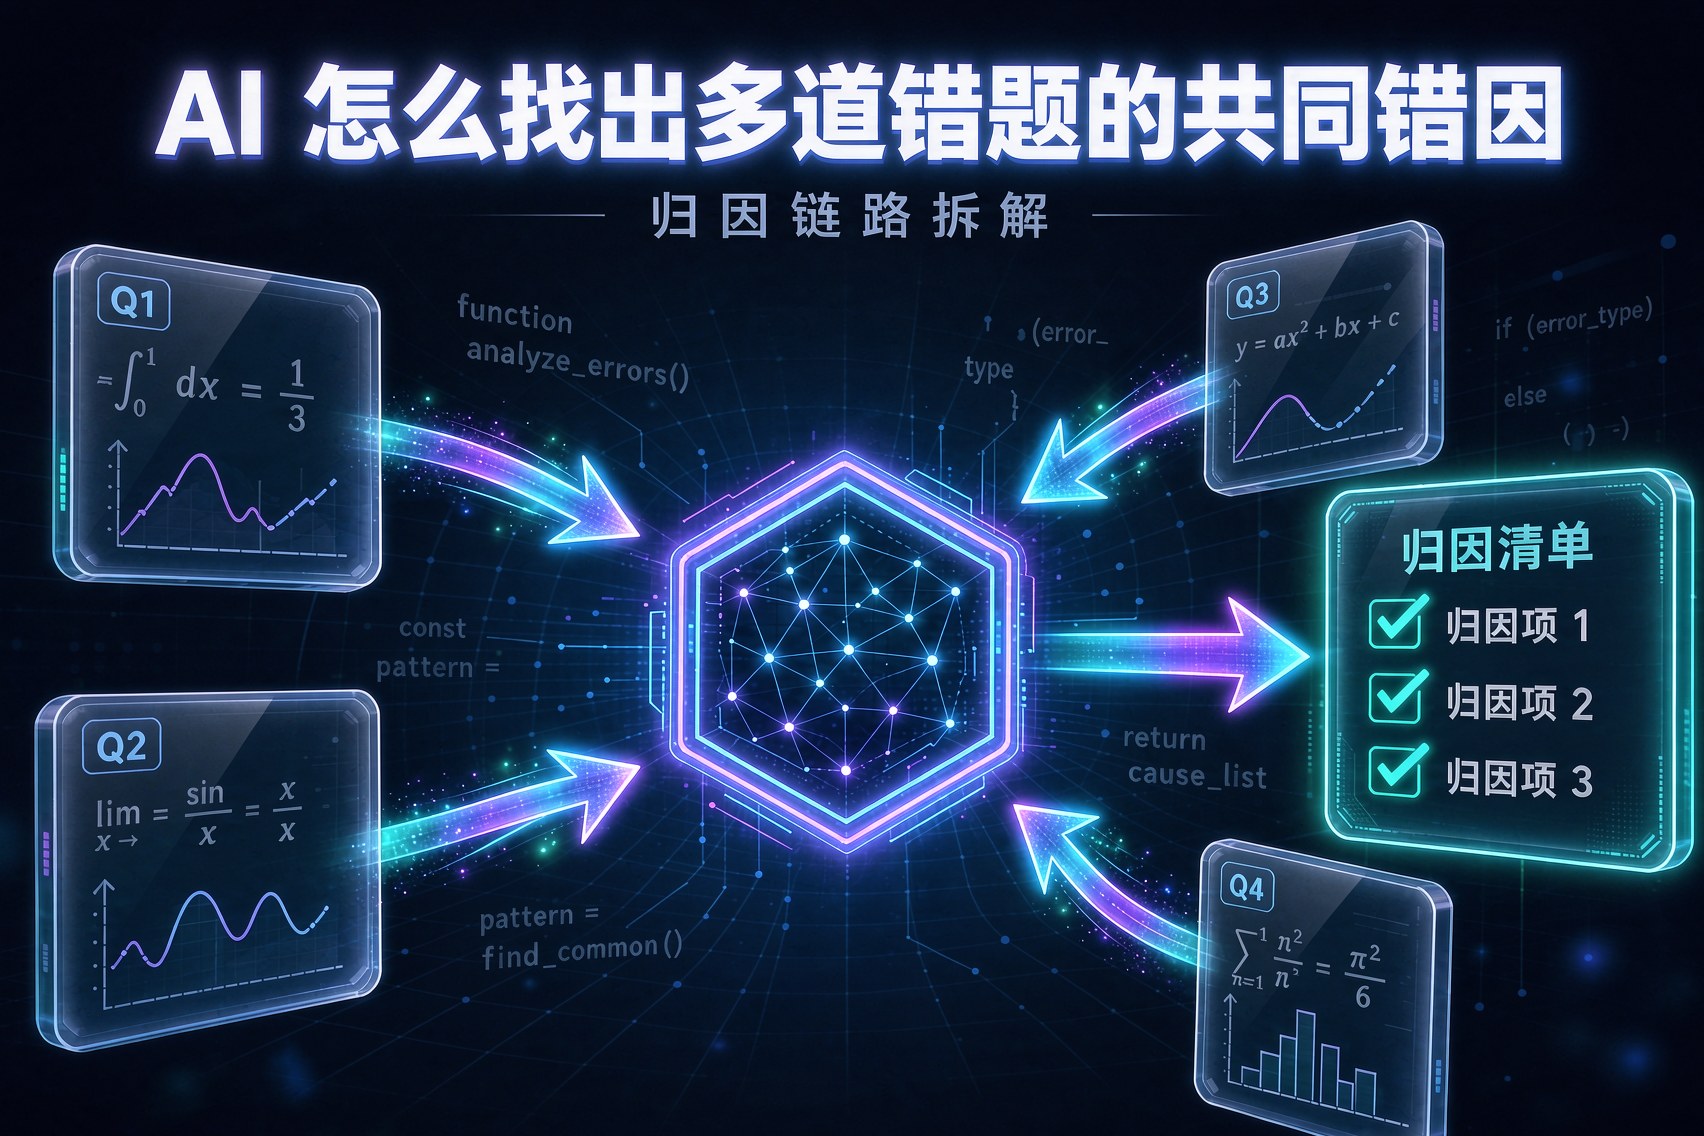
多题归因工具怎么选,看它把「AI 怎么找出多道错题的共同错因」拆成什么样的链路。错题透镜的方案是四段流水线:摄入清洗、标签抽取、归并与断点定位、补练清单生成,每段各有输入、输出和工程难点;本文逐段拆解,并附 Python 实现与 15 道数学错题的真实运行结果。
一、整条链路:四段流水线
输入是一叠错题照片,输出是一份按优先级排好的共同断点清单,四个阶段各自把上一段的输出变成下一段更结构化的输入:
阶段 | 输入 → 输出 |
|---|---|
① 摄入与清洗 | 照片 → 题目记录(题干/作答) |
② 错因标签抽取 | 题目记录 → 层级+知识点+错误环节+置信度 |
③ 归并与断点定位 | N 条标签 → 断点列表与得分排序 |
④ 补练清单生成 | 断点排序 → 按类练习与优先级 |
为什么分四段而不是一把梭:错误是看不见的状态,哪一步没想通照片里没写着,只能从作答痕迹反推——智能辅导研究的经典做法正是把「掌握没掌握」当隐变量、每次作答当观测来反推1,分段也便于逐段验收。
二、阶段一:题目摄入与清洗
输入是家长拍的照片,输出是每道题一条结构化记录,这段做三件事:
- 识别双通道:题干是印刷体、作答是手写体,模型与置信度不同,分开识别再合并,避免手写答案混进题干。
- 题干与作答分离:按版面切出题干区、作答区、批改区;红笔批改与学生字迹同为手写,混进作答就会把「老师打的叉」当成学生的推理。
- 脱敏:姓名、学校、学号入库前替换为匿名编号,照片元数据一并剥离——归因要的是作答内容,不是孩子是谁。
难点在识别误差:分式、上下标、不等号的错误率明显偏高,所以识别结果带置信度下传,低置信度的题保留原图入口供回看——第一段就承认「我看不准」。
三、阶段二:错因标签抽取(规则 + 模型混合)
输入是题目记录,输出是每题一条错因标签,要同时回答「错在哪一层」和「错在哪一步」:
{
  "knowledge": "导数与不等式恒成立",
  "layer": "逻辑/审题",
  "error_step": "分类讨论边界不清",
  "evidence": "b≤1 的情形里出现 b≥1 的标注",
  "confidence": 0.86
}三个关键字段缺一不可:layer 落在固定枚举(概念核心/逻辑·审题/执行·规范),error_step 从错因字典选取或经字典校验,confidence 是抽取可信度——层级不固定,跨题统计没有分母,字典不收口归并就是空谈。
抽取用规则加模型混合:能程序判定的交给规则(答案对错、步骤缺失、端点是否代回、定义域是否检验),需要理解作答语义的交给模型(放缩方向反了、分类条件写反、结论与推导不符)。
难点有三个:标签噪声(同一现象写成「漏解」「没讨论」「情况不全」)、层级漂移(同类错误这次记概念下次记审题)、模型误判(把跳步但正确的推理判错);对策是字典强制枚举、层级挂固定判据表、低置信度进复核队列——核心是让 100 道题的标签像同一个人写的。
四、阶段三:跨题归并与知识断点定位(链路的核心)
输入是 N 条错因标签,输出是归并后的断点排序:这些标签里,哪些其实说的是同一件事?
分两步。归并先用同义词字典对齐别名(「漏解」「情况不全」归到「分类讨论边界不清」),字典没收编的用字符相似度兜底,过阈值判为同一断点。打分按「支持题数 × 平均置信度 × 层级权重」排序:题数看是否反复,置信度压噪声,层级权重让逻辑类略高于执行类——工作记忆容量有限,未自动化的步骤持续占用认知资源,错误因此集中在特定环节反复出现2。
最小实现如下,输入逐题标签,输出按得分降序:
import difflib

LEVEL_W = {"概念核心": 1.0, "逻辑/审题": 1.2, "执行/规范": 0.8}
ALIAS = {"分类讨论边界不清": ["分类漏解", "分界点混淆", "情况讨论不完整"],
         "逻辑验证缺失": ["结论未回代检验", "充分性未验证"]}

def same_break(tag, name):
    if any({tag, name} <= ({k} | set(a)) for k, a in ALIAS.items()):
        return True
    return difflib.SequenceMatcher(None, tag, name).ratio() >= 0.72

def locate(per_q):
    groups = []
    for tag, layer, conf in per_q:
        for g in groups:
            if same_break(tag, g[0]):
                g[1].append((layer, conf))
                break
        else:
            groups.append([tag, [(layer, conf)]])
    ranked = []
    for name, items in groups:
        n = len(items)
        conf = sum(c for _, c in items) / n
        lw = sum(LEVEL_W[lay] for lay, _ in items) / n
        ranked.append((name, n, round(n * conf * lw, 2)))
    return sorted(ranked, key=lambda x: -x[2])

per_q = [("分类讨论边界不清", "逻辑/审题", 0.84),
         ("分类漏解", "概念核心", 0.79),
         ("情况讨论不完整", "逻辑/审题", 0.76),
         ("逻辑验证缺失", "逻辑/审题", 0.82),
         ("结论未回代检验", "逻辑/审题", 0.80),
         ("逻辑链条断裂", "逻辑/审题", 0.81)]

for name, n, score in locate(per_q):
    print(f"{name}   支持 {n}/6  得分 {score}")
6 条演示标签的输出:
分类讨论边界不清   支持 3/6  得分 2.71
逻辑验证缺失   支持 2/6  得分 1.94
逻辑链条断裂   支持 1/6  得分 0.97
排序已经给出答案:前两个断点吃掉 5/6 条标签,其余是零散单点。断点不是凭空发明的知识点,而是多道题的错误证据共同指向的同一处缺失。
难点在跨题对齐:同义归并收不全,阈值高了漏并、低了错并,低置信度标签还会灌水;粒度更要守住下限——15 道题归出 2 个断点可执行,归出 12 个等于没归。
五、阶段四:补练清单生成
输入是断点得分排序,输出是家长能照做的练习安排,三条规则顺序不能反:
- 按断点出清单:每个断点配一组同类型变式题,2~3 道代表题就够,不必把 15 道错题原样重做。
- 按得分定优先级:得分靠前的先练,它覆盖题最多、层级最高;单点错误排最后,甚至不专项练。
- 每组练完就回测:同断点的变式题连续做对才从清单划掉,否则下轮继续排前面。
第三条有实证支撑:主动提取知识比重读笔记和解析更能形成稳定保持3,按断点分类让每次提取都打在同一个缺口上。难点是断点名与题库标签的对齐,以及防止重复推题——同一组变式题连推三轮,练到的是熟题不是缺口。
六、真实运行结果:15 道高中数学错题跑完这条链路
拿一份错题透镜的真实分析报告检验链路:一名高中生的 15 道数学错题,横跨概率、导数、三角函数、立体几何。表面看是散的——负二项分布、导数恒成立、三角函数极值、符号函数不等式,几乎一题一个知识点。
链路第三段收口后,报告的诊断总结写的是:
表面错在负二项分布、导数恒成立、三角函数极值等不同知识点,但根本原因是分类讨论边界不清和逻辑验证习惯缺失。最高优先级突破口:训练「相邻项比值法」和「驻点充分性验证」,建立从单调性分析到结论验证的完整逻辑链。
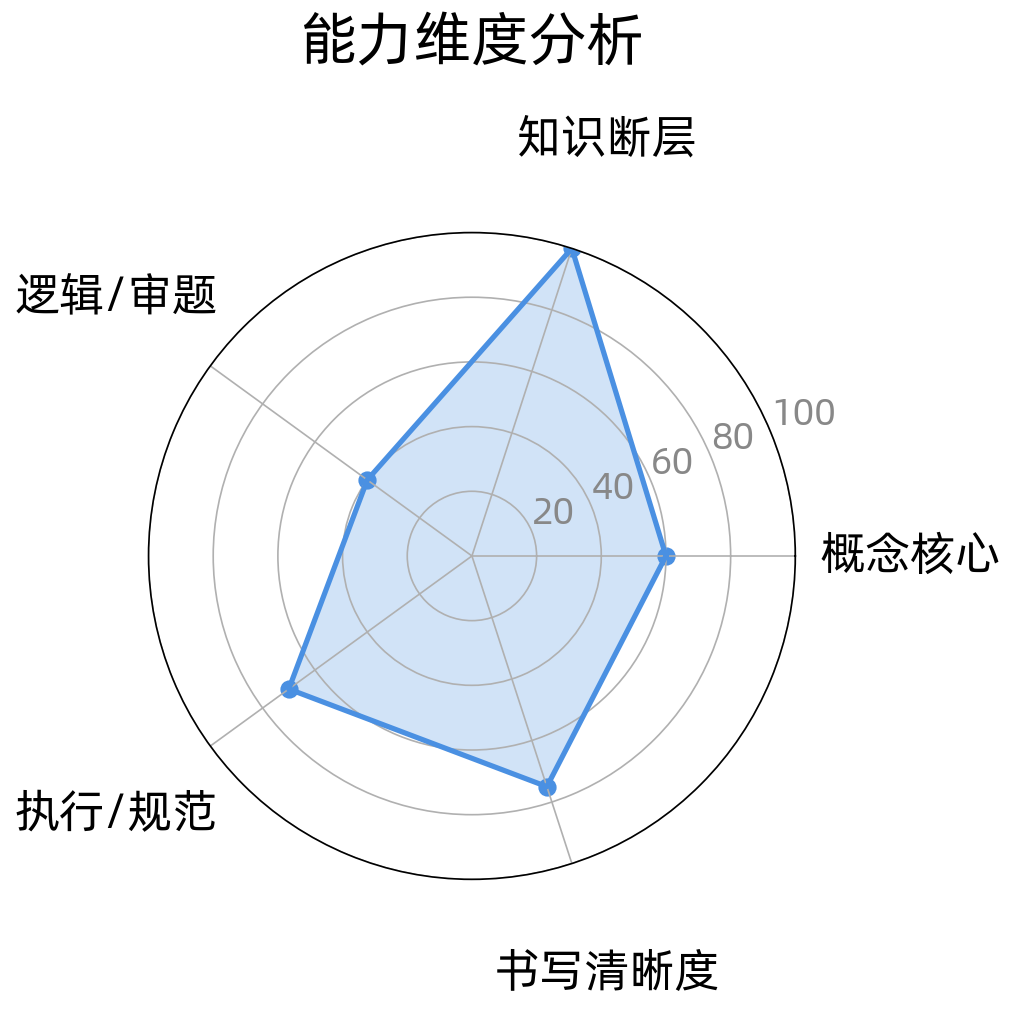
15 条标签归并成 2 个共同断点:分类讨论边界不清、逻辑验证习惯缺失,并带出 5 个薄弱知识点——含参分类讨论的边界意识、离散概率最值的相邻项比值法、导数恒成立的完整逻辑链、三角函数化简与极值点验证、符号函数不等式的符号分析。层级分布上,概念核心 7 道、逻辑审题 7 道、执行规范 1 道,错因高度集中在前两层。
雷达图
知识断层 100 分、概念核心 60 分、逻辑审题 40 分——前置基础扎实,缺口几乎全落在逻辑链上。只看单题时,第 1 题的负二项分布和第 14 题的三角函数毫无关系——是标签抽取先统一口径,归并才把它们压到同一断点,补练也才只需两类任务:分类讨论三问的习惯,和「求导→判号→验证」的完整逻辑链。
需要说明,链路结论是模型基于作答痕迹的推断参考,不是诊断终审——置信度低的标签仍要家长或老师结合原卷确认,再决定练什么。
七、总结
带走三点。第一,AI 找共同错因是四段流水线:清洗把图片变记录,标签抽取把记录变证据,归并把证据变断点,补练把断点变动作。第二,胜负手在标签口径与跨题对齐:口径统一了归并才有意义,断点得分(题数 × 置信度 × 层级权重)直接决定补练顺序。第三,15 道散题收口成 2 个断点,说明这套拆解能把「逐题补」变成「按断点补」;工具输出是推断参考,练什么仍由人拍板——错题透镜这类产品的价值,就是把四段链路自动化,让人只留最后一步判断。
常见问题解答(FAQ)
Q1:多题归因工具怎么选?评估时该重点看什么?
A:看它有没有一条讲得清的归因链路,而不是只看结论页。可拆成四个问题:清洗是否区分题干与作答,标签有没有固定层级和字典,多题标签能否归并成少数断点并给出得分排序,补练清单按断点还是按题目生成。四段都说得清输入输出,结论才可复核。
Q2:AI 抽出来的错因标签到底准不准?
A:单条标签永远是概率性的,所以每条都带置信度和卷面依据,靠两个机制兜底:标签只能落在固定字典与层级枚举里,噪声写法进不来;低置信度样本进人工复核,结果保留原图可回看。判断工具可不可信,就看它敢不敢把置信度和「错在卷面哪一处」一起展示——敢展示的,误判才藏不住。
Q3:断点归并会不会把不同的错误错并成一个?
A:会,所以归并用双重判据:同义词字典先收口确定的别名,字符相似度只做兜底且阈值保守(示例取 0.72)。粒度也有下限——15 道题归出 2 个断点可执行,归出 12 个等于没归。补练前把断点对应的题目抽查一遍,是成本最低的校验。
参考资料
1 知识追踪:程序性知识是怎么一步步被学会、并能被预测掌握程度的——Corbett 与 Anderson 1994 年发表于《User Modeling and User-Adapted Interaction》
2 解题时的认知负荷会直接影响学习效果——Sweller 1988 年发表于《Cognitive Science》的研究
3 检索练习(主动回想)对记忆的巩固作用最关键——Karpicke 与 Roediger 2008 年发表于《Science》的研究
相关阅读
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号