一个奶茶店排队仿真的完整实录:WorkBuddy 负责「听懂人话」,状态机负责「别撒谎」。
原创
一个奶茶店排队仿真的完整实录:WorkBuddy 负责「听懂人话」,状态机负责「别撒谎」。
原创
大盘鸡拌面
发布于 2026-10-24 12:21:37
发布于 2026-10-24 12:21:37
事情是这样的
上周三下午三点,店里没客人,老板坐在高脚凳上刷差评。
差评内容高度一致:「等了二十分钟」「出杯太慢」「不会再来了」。
我们店不大。中午 12 点到 1 点那一小时,单子能把两个制作台压死;收银台只有一个,点单平均 40 秒,做一杯平均 100 秒。老板的原话是:
「再招个人开个收银台,不就快了吗?」
我当时没接话。因为我心里有个直觉:这钱花下去,大概率没用。但「直觉」这玩意儿不能拿去跟老板吵架,得拿数字。
于是我用一个下午,搭了个仿真。
先说清楚我的底子:我不是运筹学出身,SimPy 是那天现学的。真正让我把这事儿做完的是 WorkBuddy,但它帮我的方式,跟我一开始想的完全不一样。
一、我踩的第一个坑:让 AI 直接给结论
我最初的提问是:「我们店中午一小时来 130 个客人,1 个收银台 2 个制作台,顾客平均要等多久?」
WorkBuddy 回得特别快,特别像样。它搬出排队论的公式,算了算,说大概 6 到 8 分钟。
听起来没毛病对吧?问题是,这个数我没法验证。
而且它默默替我做了一堆假设:到达是泊松过程、服务时间服从指数分布、没有顾客会中途走人、店从第一分钟起就是满负荷运转。
这四条里只要有一条不对,结论就飘了。而我们店的真实情况是:顾客等超过 15 分钟真的会退款走人;中午那一小时的到达量差不多是平时的两倍;开门第一分钟店里空空荡荡。
所以后来我把规矩定死了:WorkBuddy 可以写代码、可以解释结果、可以帮我加指标,但它不能替我产生数字。 数字必须来自我自己跑出来的日志。
这话听着像废话。但你真用起来就知道,这条边界特别容易糊 —— 因为 AI 给的数字太顺了,顺到你懒得去跑。
二、这活儿到底谁干
我花了半天才想明白一件事:这不是「AI 帮我做仿真」,而是「AI 和状态机分工」。
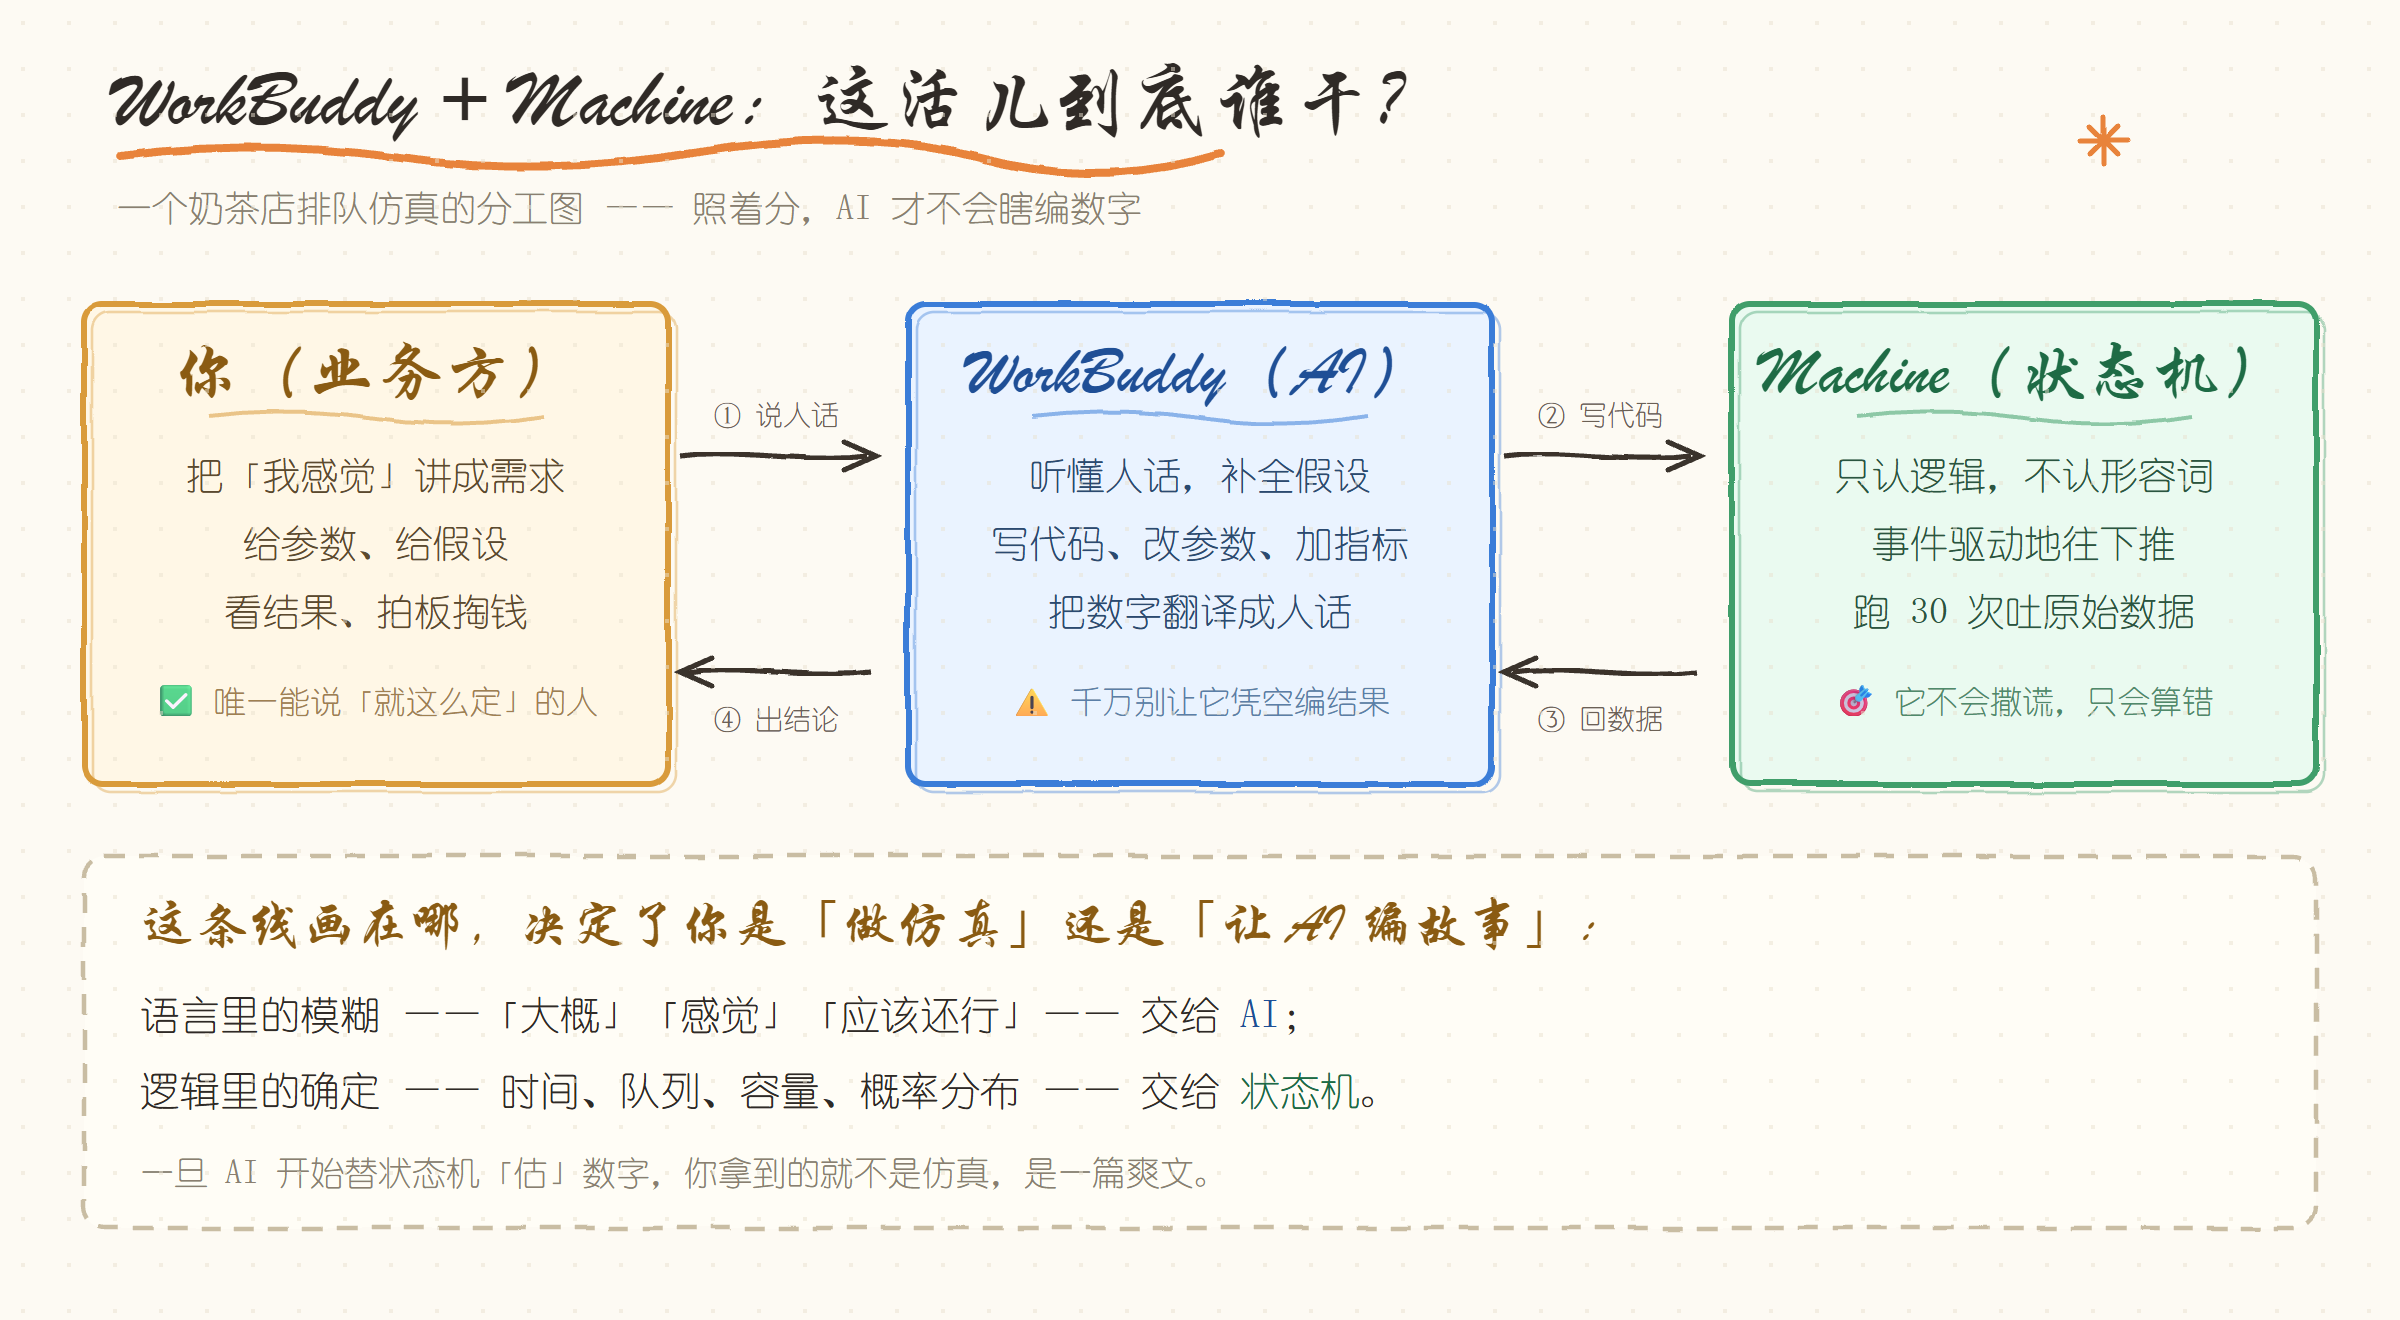
左边是你,中间是 WorkBuddy,右边是状态机。四根箭头构成一个闭环:
- 你把「我感觉中午特别忙」翻译成一句能落地的话(几点到几点、大概多少人、几个工位);
- WorkBuddy 把它变成能跑的代码;
- 状态机一声不吭地跑,跑完吐出一堆原始数据;
- WorkBuddy 再把那堆数据翻译回人话,你听完拍板。
关键在于那条分界线:语言里的模糊交给 AI,逻辑里的确定交给状态机。
一旦 AI 开始替状态机「估」数字,你拿到的就不是仿真,是一篇爽文。
具体跑起来是什么节奏?大概是这样一圈一圈磨的:
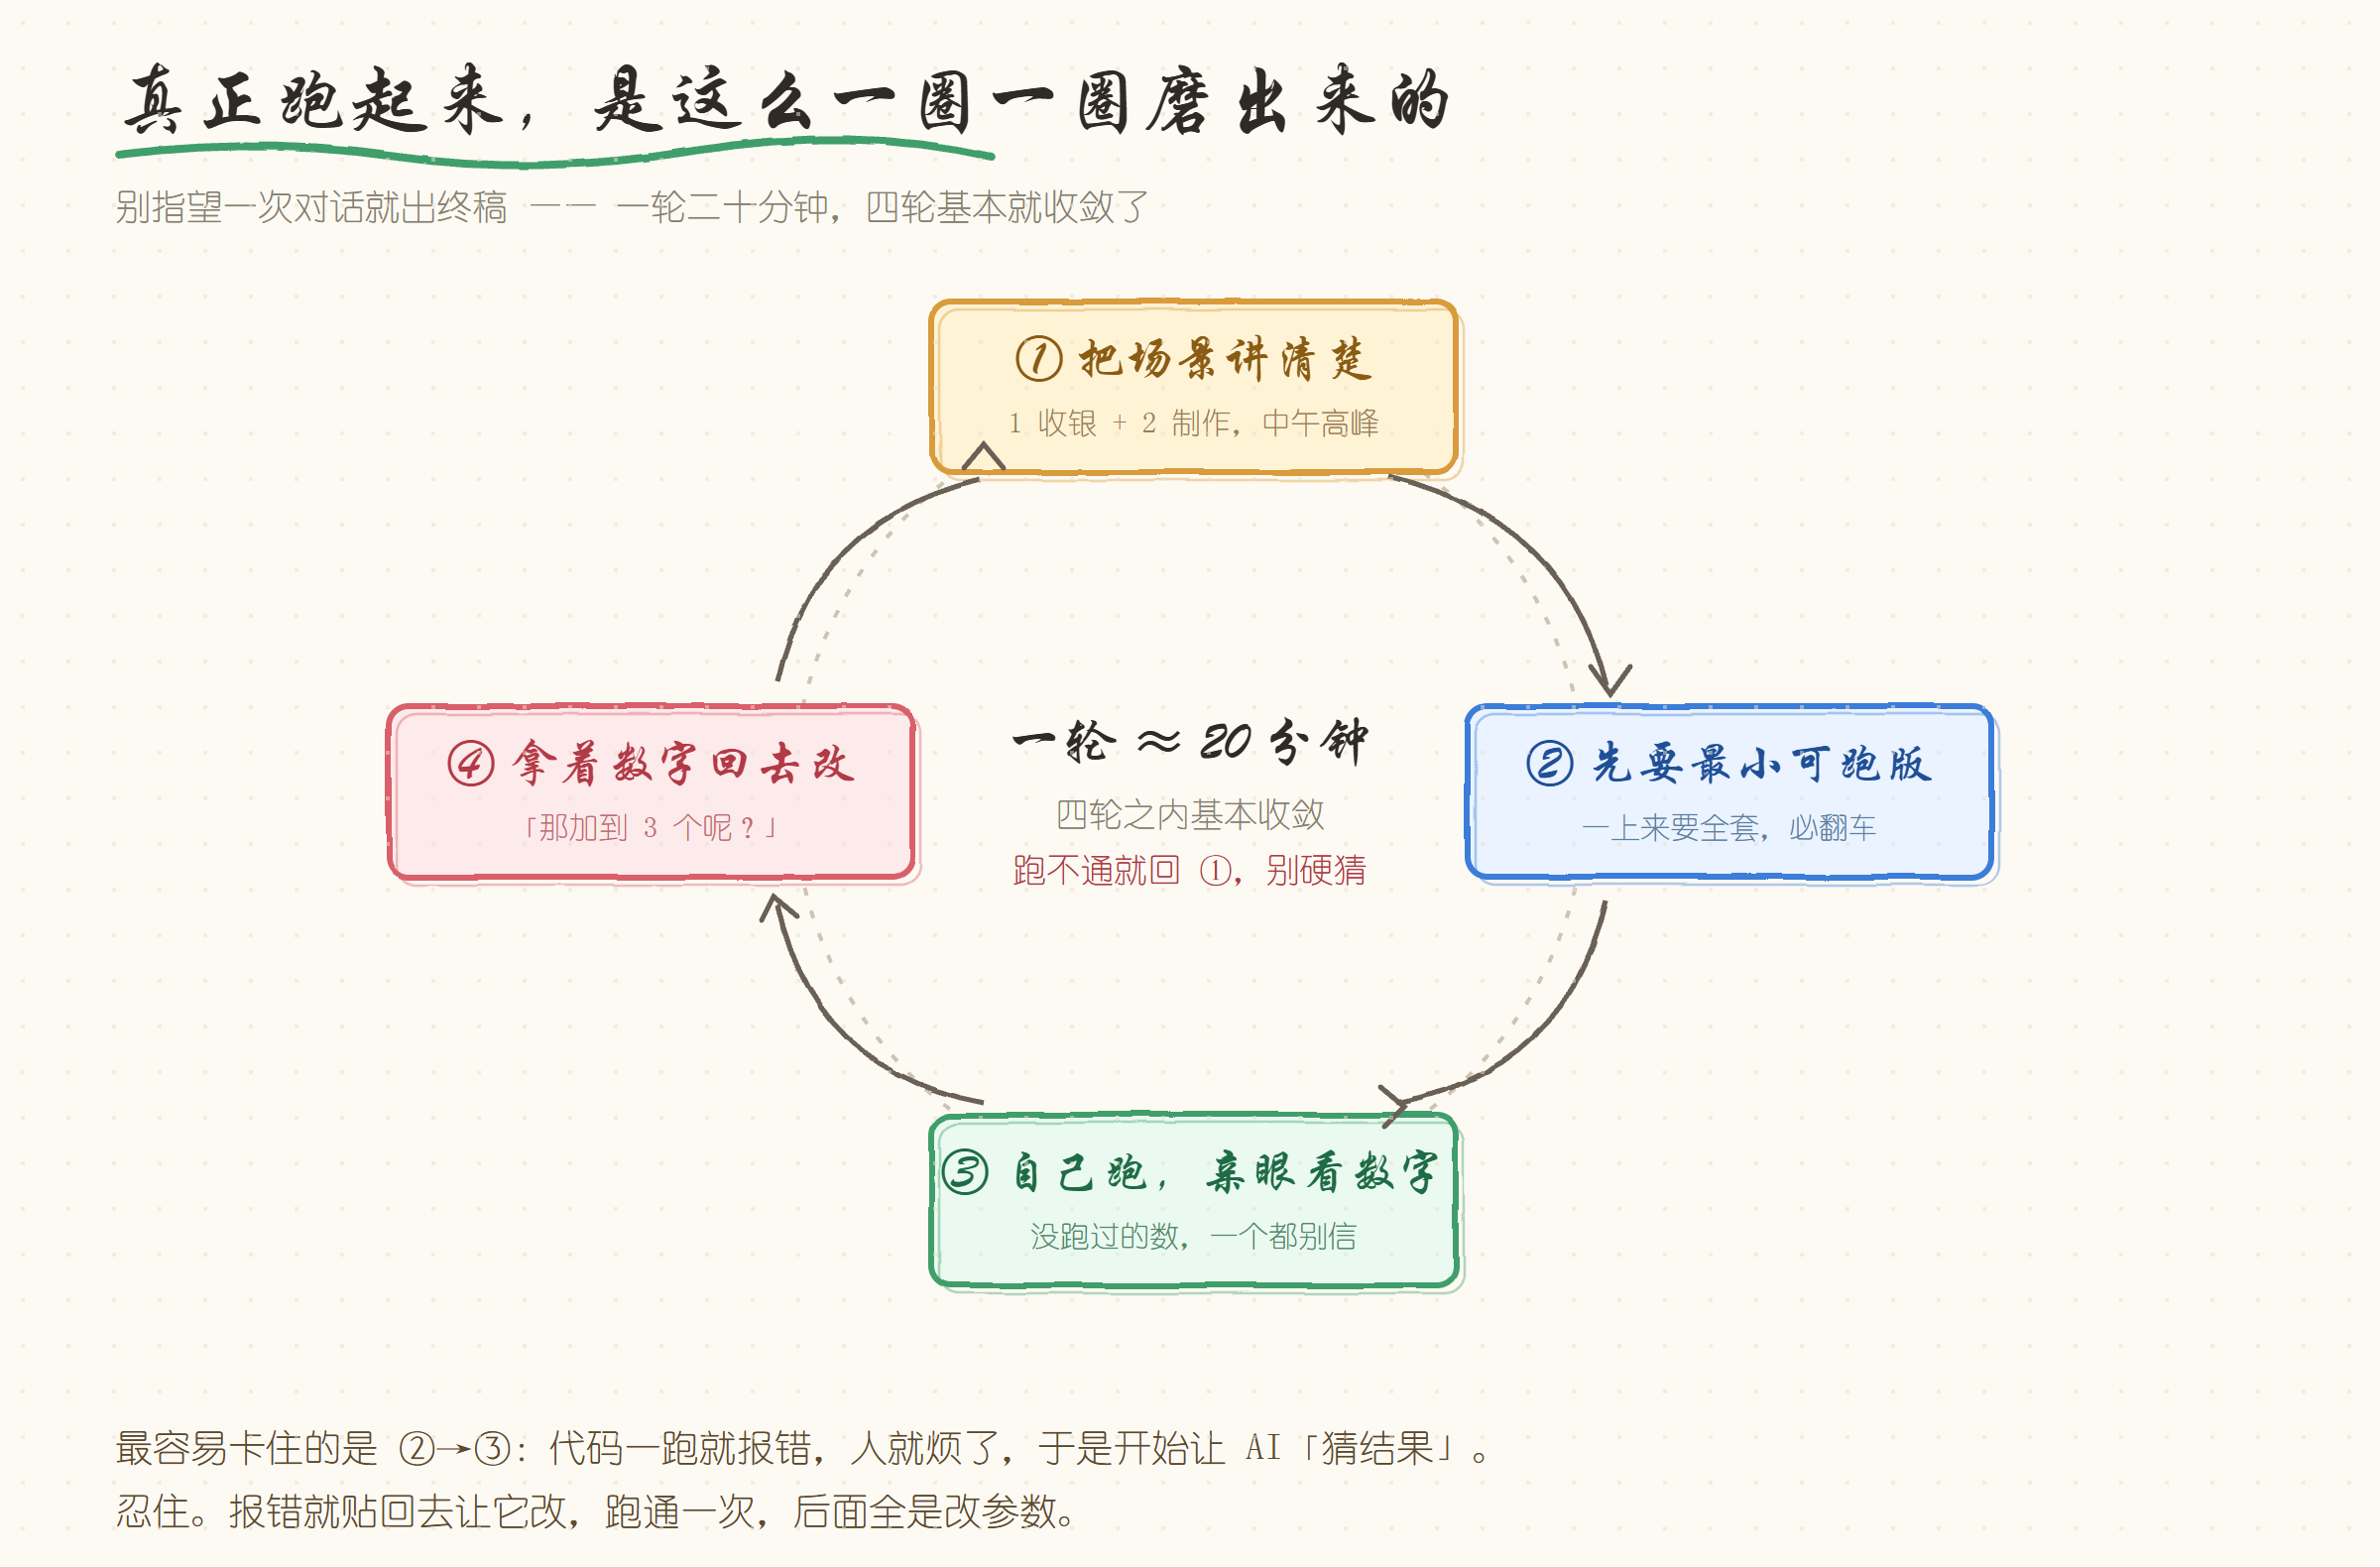
最容易卡住的是第 ② 步到第 ③ 步之间。代码一跑就报错,人就开始烦,然后你就想走捷径:直接问 AI「那大概是多少」。
忍住。报错就原样贴回去让它改。跑通第一次之后,剩下的全是改参数,快得很。
三、把「排队」翻译成状态机
真正让代码有骨架的,是这张图。我在纸上画的,比代码先出来:
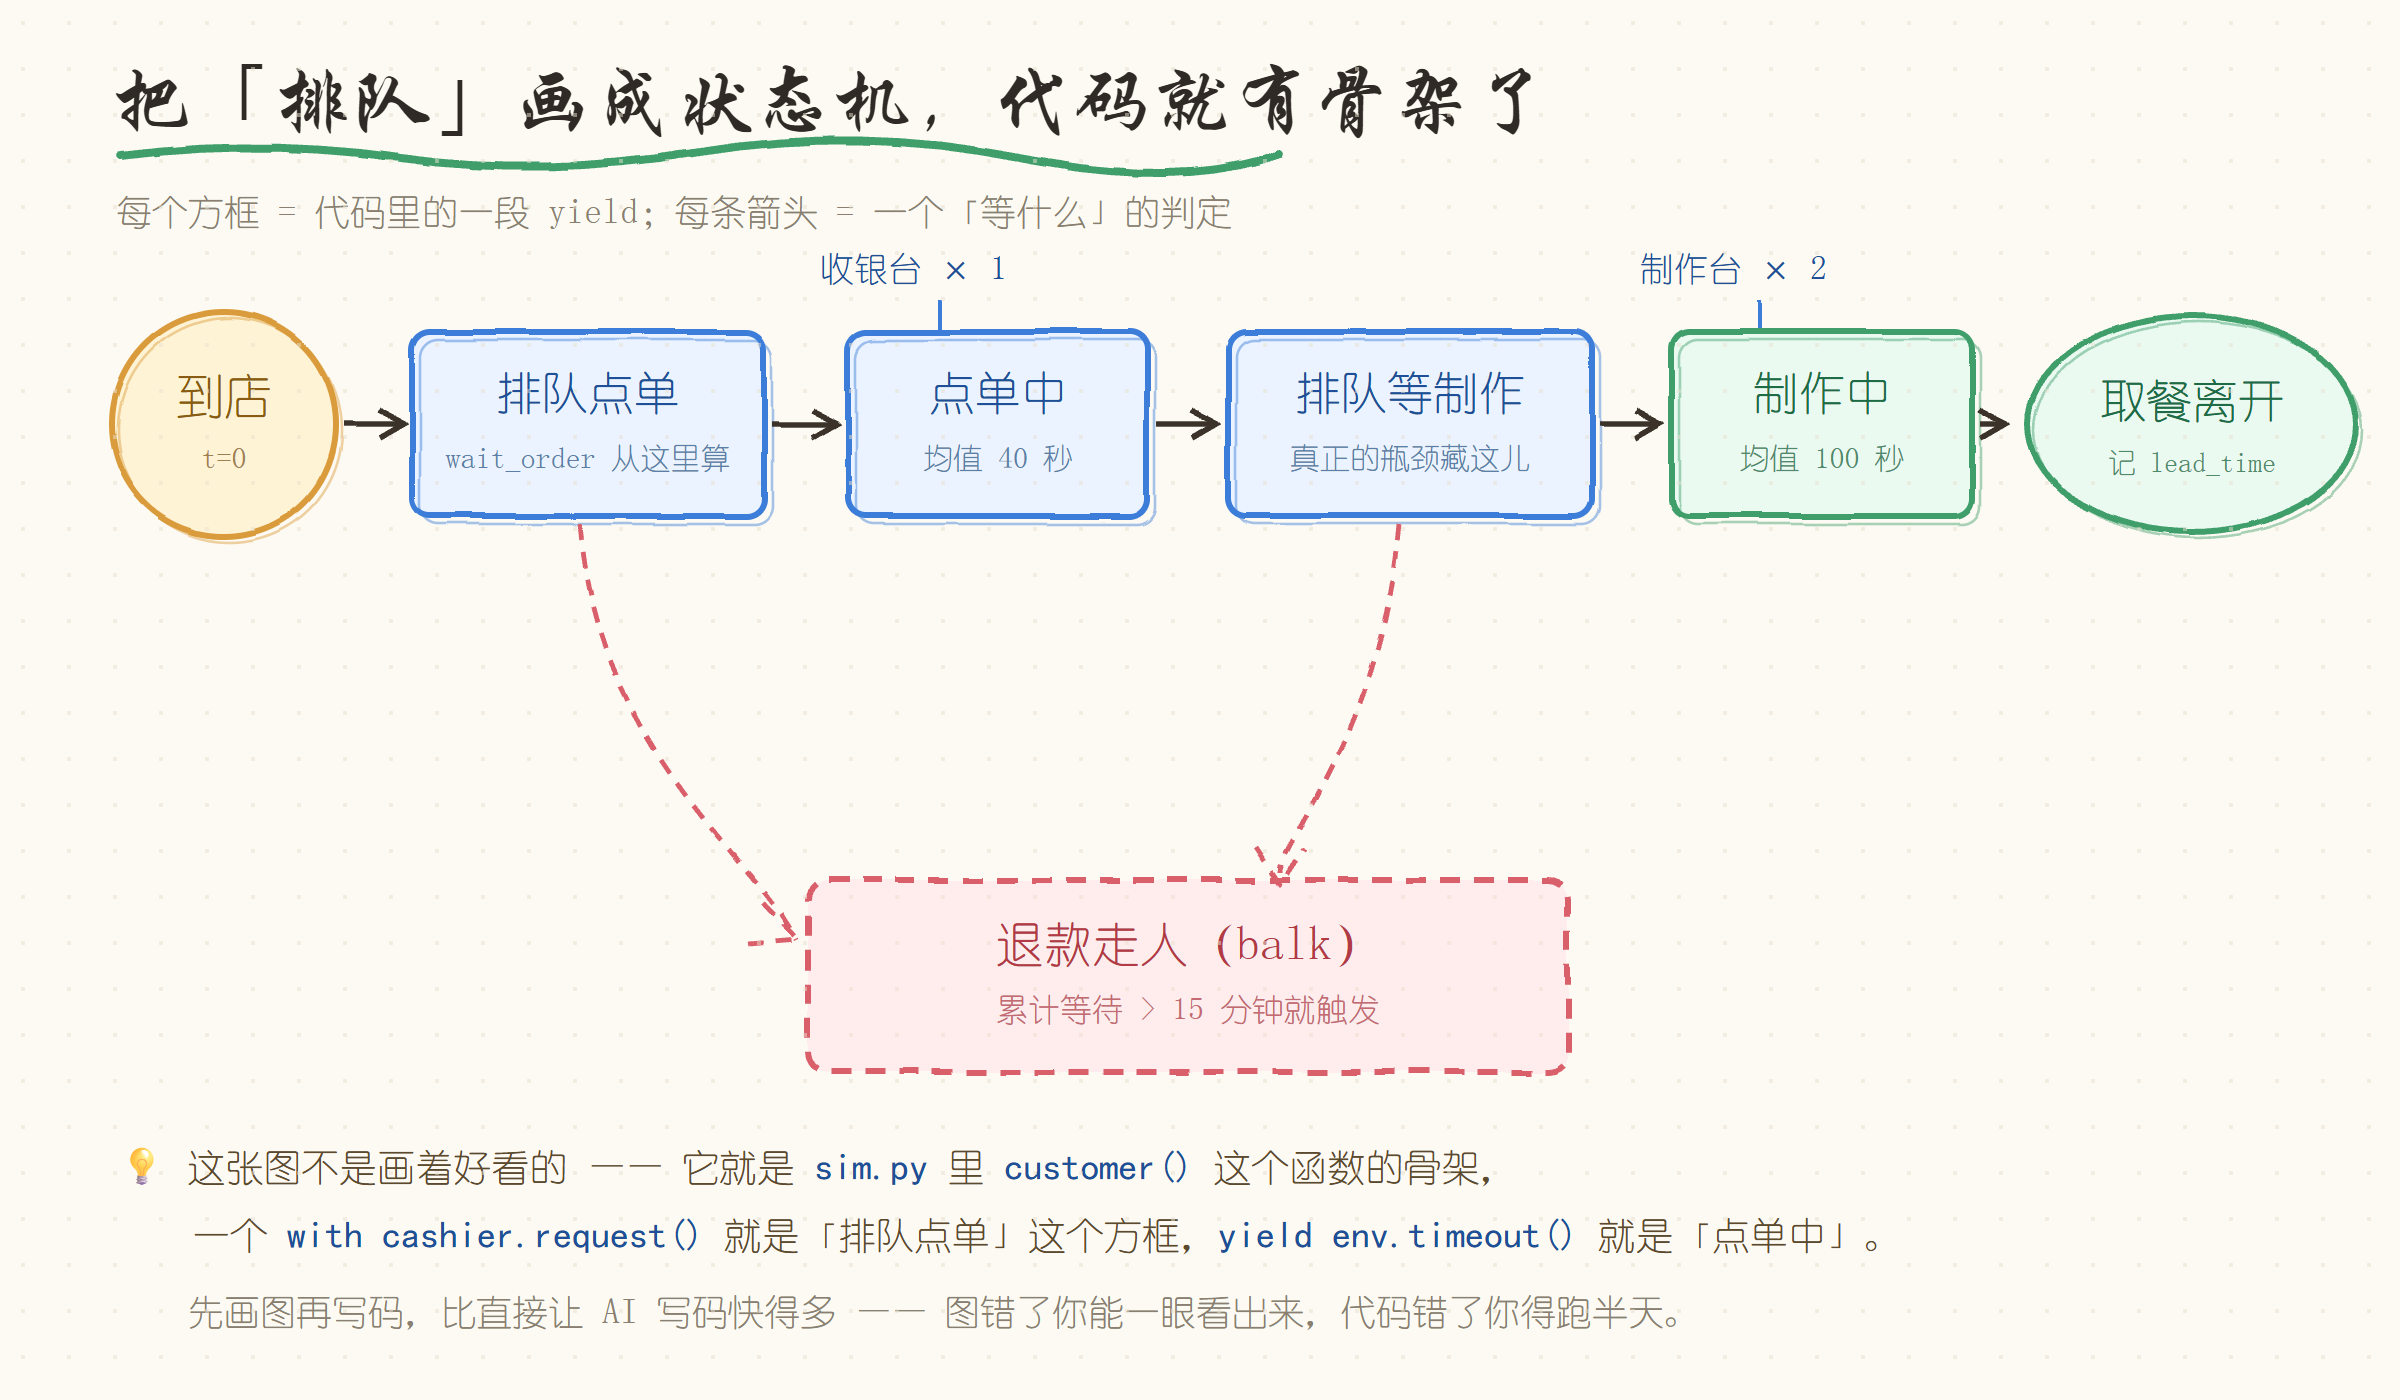
一个顾客从进店到走人,只会处在这么几个状态里:到店 → 排队点单 → 点单中 → 排队等制作 → 制作中 → 取餐离开。另外还有一条隐藏分支:在任何一个排队状态里,等太久就退款走人。
这张图的价值在于,它把「排队」这个模糊的词拆成了「在等什么」。
- 在等收银台空闲 —— 这是
wait_order - 在等制作台空闲 —— 这是
wait_make - 在等师傅把茶摇完 —— 这是服务时间,不算等待
这三个东西混在一起,后面所有结论都会歪。我后面会专门讲这个坑。
画完图再写代码,速度完全不一样。图错了你一眼能看出来,代码错了你得跑半天才发现。
四、第一版:能跑就行
我发给 WorkBuddy 的第一句话是这么写的:
帮我把这个场景写成 SimPy 代码:顾客按泊松过程到店,1 个收银台(点单均值 40 秒),2 个制作台(每杯均值 100 秒),跑 2 小时。先只给我最小可跑版本 —— 不要可视化,不要报告,不要画图,能 print 平均等待时间就行。
这句话之所以有效,是因为它干了三件事:给了具体参数、划了范围、明确了「不要什么」。少任何一样,你拿回来的东西都会膨胀三倍。
第一版代码我只要一个东西:能跑起来,别报错。
import random
import simpy


def customer(env, cid, cashier, maker, log, rng):
    arrive = env.now

    # 状态:排队点单 -> 点单中
    with cashier.request() as req:
        yield req
        wait_order = env.now - arrive
        yield env.timeout(rng.expovariate(1 / 40))   # 点单,均值 40 秒
        order_done = env.now

    # 状态:排队等制作 -> 制作中
    with maker.request() as req:
        yield req
        wait_make = env.now - order_done
        yield env.timeout(rng.expovariate(1 / 100))  # 制作,均值 100 秒

    log.append({
        "id": cid,
        "wait_order": wait_order,
        "wait_make": wait_make,
        "lead": env.now - arrive,
    })


def run(minutes=120, cashiers=1, makers=2, seed=42):
    rng = random.Random(seed)
    env = simpy.Environment()
    cashier = simpy.Resource(env, capacity=cashiers)
    maker = simpy.Resource(env, capacity=makers)
    log = []

    def spawn():
        while env.now < minutes * 60:
            yield env.timeout(rng.expovariate(1 / 45))  # 平均 45 秒来一个人
            env.process(customer(env, len(log), cashier, maker, log, rng))

    env.process(spawn())
    env.run(until=minutes * 60)
    return log


if __name__ == "__main__":
    log = run()
    avg = sum(r["wait_order"] + r["wait_make"] for r in log) / len(log) / 60
print(f"服务 {len(log)} 人,平均等待 {avg:.1f} 分钟")四十来行,没有玄学。simpy.Resource 就是那个「工位」,request() 就是排队,yield 就是「等」。
我让 WorkBuddy 写这一版的时候,只提了一个要求:先给我能跑的最小版本,别一次性上全套。 这句话很关键。你要是上来就说「帮我做一个完整的排队仿真系统,带可视化、带报告、带敏感性分析」,大概率拿到一堆跑不起来的东西,然后你就在 debug 里耗掉一晚上。
五、一个人等多久,才算「等久了」
第一版跑完,日志里有个 lead 字段,平均值十三分钟左右。我第一反应是:这么吓人,难怪差评多。
然后我盯着日志看了五分钟,发现一个问题:我算的是 lead,也就是从进店到走人的总时长,里面包含了点单和制作的时间。
顾客骂的「等了二十分钟」,指的可不是这个。他指的是自己站着干等的时间。
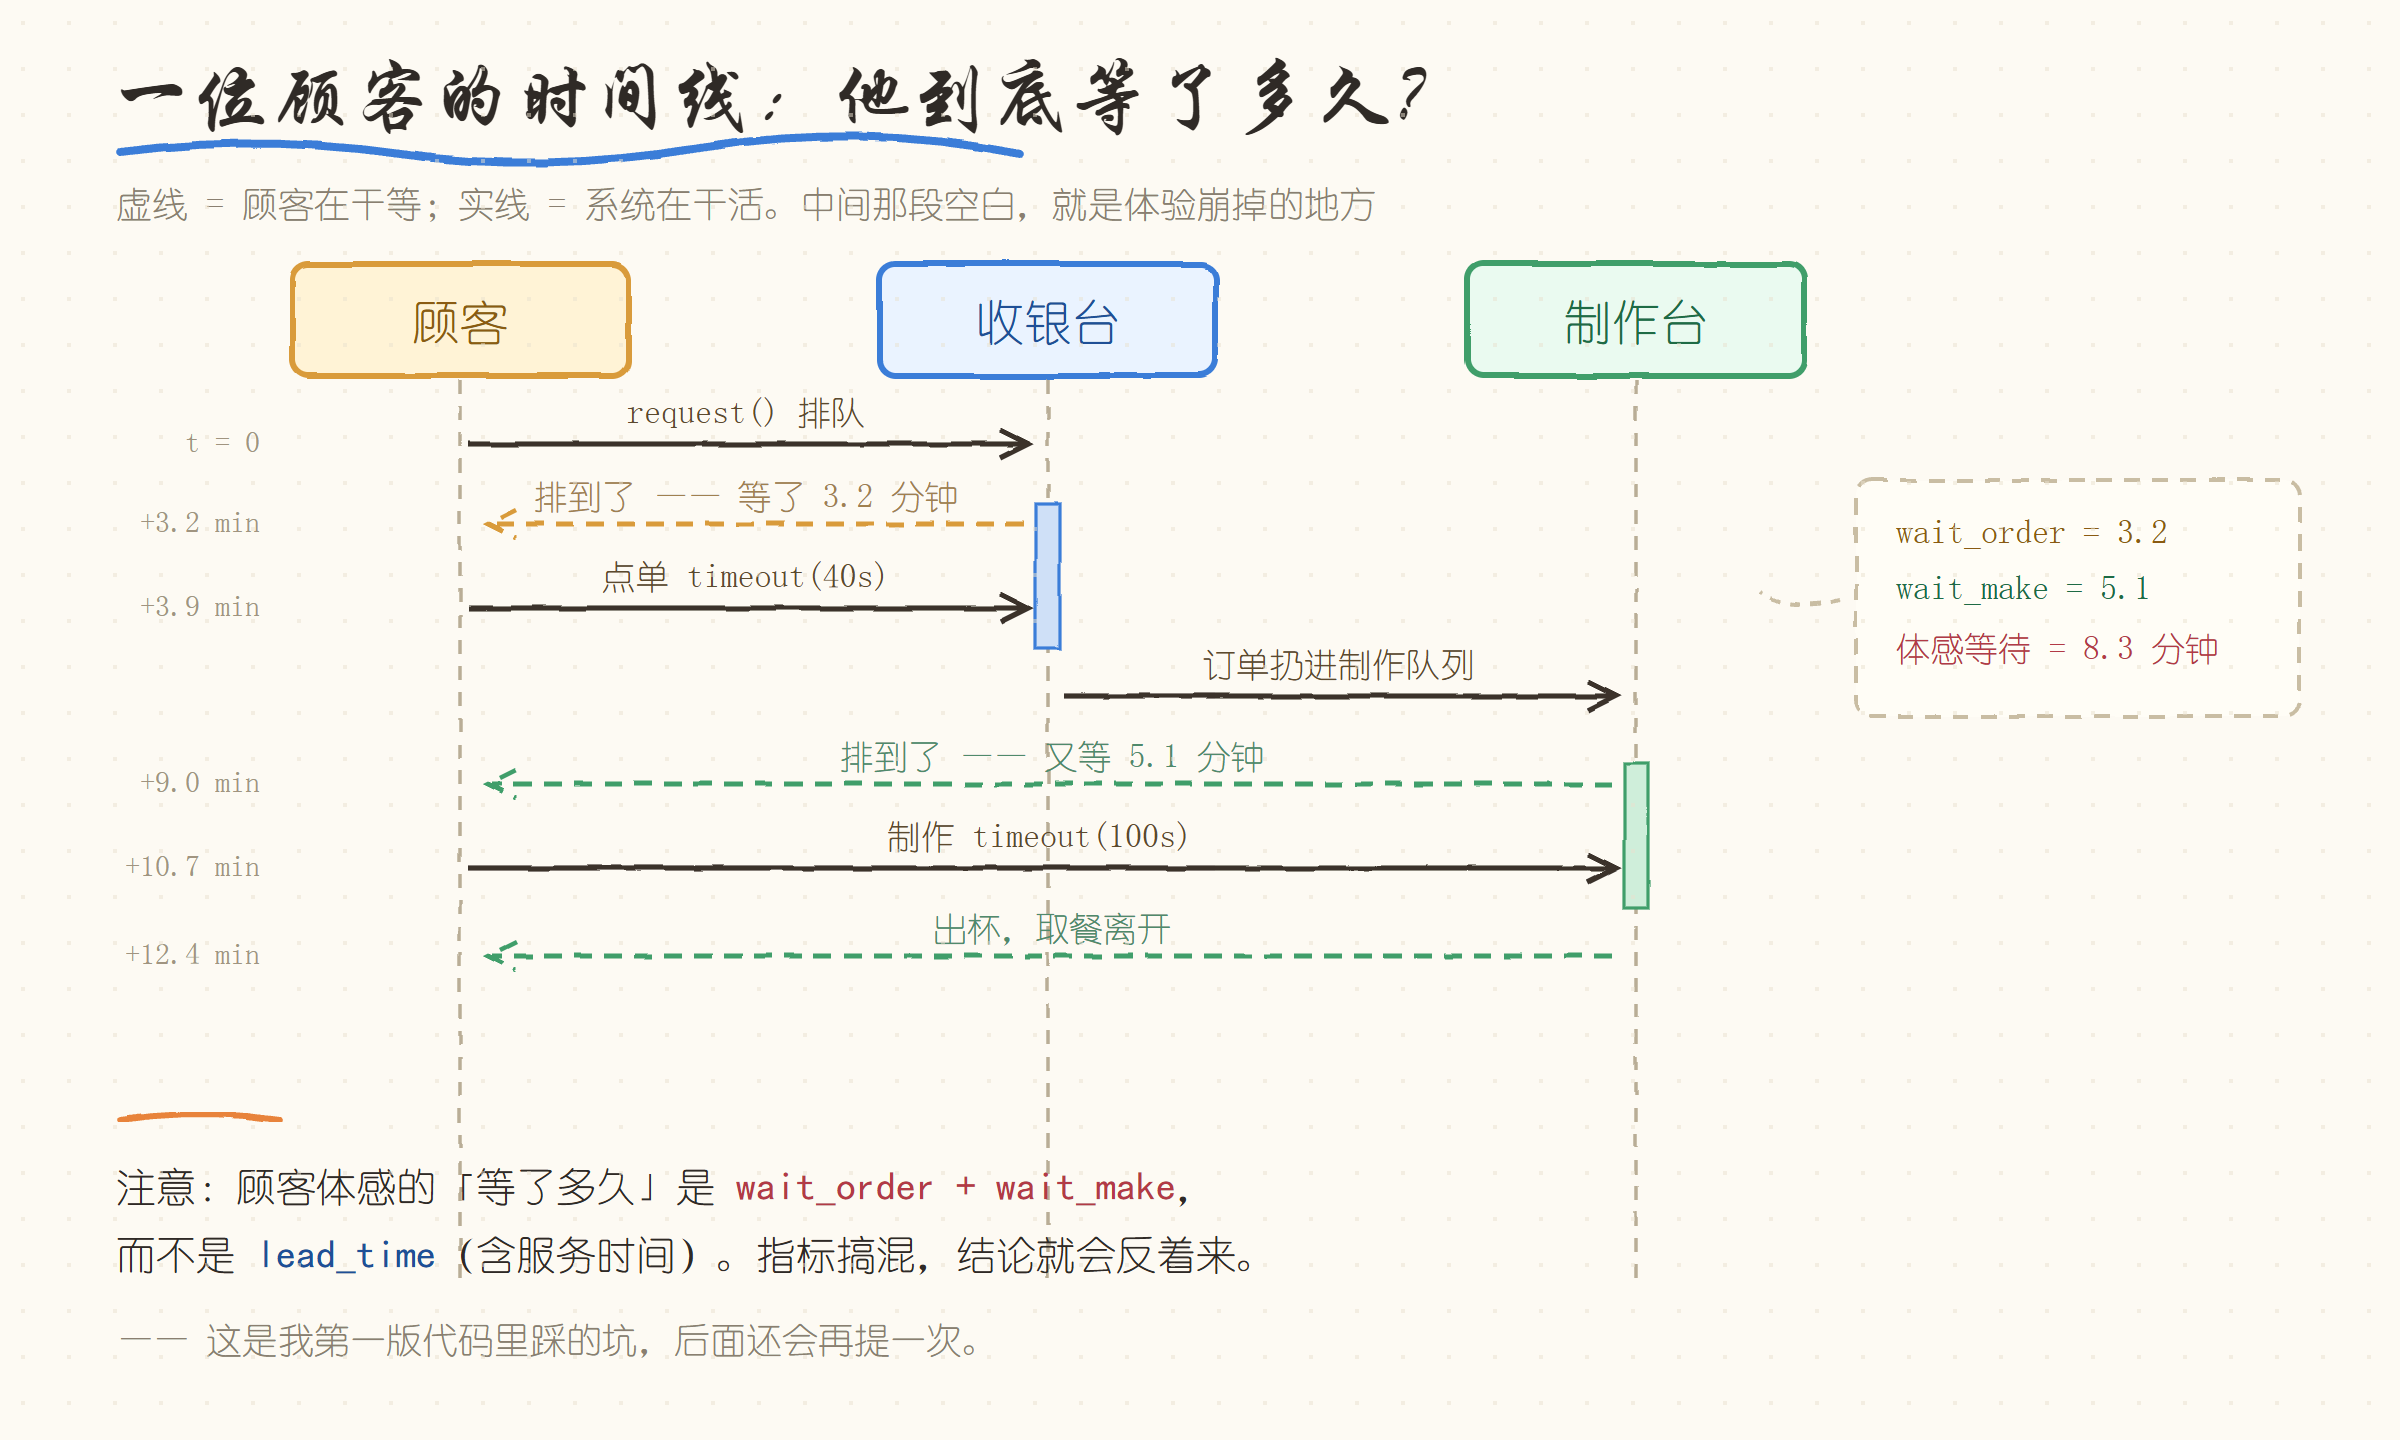
这张图画的是一个顾客的完整时间线。实线是系统在干活,虚线是顾客在干等。
真正该报给老板的指标,是 wait_order + wait_make,也就是那两段虚线加起来。lead 要记,但它回答的是另一个问题(顾客在店里待了多久,占不占座)。
我第一版就把这俩搞混了。要是直接拿十三分钟去汇报,老板大概率当场拍板加两个工位;而顾客真正在骂的那八分钟,反倒没人管。
指标搞错,结论会反着来。这话不是吓唬人。
六、加两个东西:流失和 P90
光有平均值不够。平均值 8 分钟,听起来能忍;但如果有一半人等 15 分钟,这店早就没复购了。
所以我让 WorkBuddy 补了三样东西。原话是:
现在只加三个东西:P90 等待时间、等超过 15 分钟就退款走人的流失逻辑、以及跑 30 次取均值加 95% 置信区间。其他都别动。
「其他都别动」这五个字能省你半小时。不然它会顺手帮你把变量名重构一遍,然后你就得重新读一遍代码。
前两样这一节讲,第三样(重复实验)下一节单独说。
第一是流失。 真实的人有忍耐上限,等太久会退款走人。这不是小事 —— 走掉的人不产生营收,还会留差评。
PATIENCE = 900  # 15 分钟,超过就走人

def customer(env, cid, cashier, maker, log, balked, rng):
    arrive = env.now

    with cashier.request() as req:
        yield req
        if env.now - arrive > PATIENCE:      # 还没轮到就放弃了
            balked.append(cid)
            return
        ...
第二是 P90。 平均值会被少数「幸运儿」拉低,P90 才代表最倒霉那批人的体验。
def p90(xs):
    xs = sorted(xs)
    return xs[int(round(0.9 * (len(xs) - 1)))]
顺便把到达过程也改对了。中午那一小时人明显更多,用一个固定的到达率是不诚实的:
def arrival_times(cfg, rng):
    """用「1 秒一片 + 伯努利抽样」近似非齐次泊松,够用且好读"""
    t, step = 0.0, 1.0 / 60.0
    while t < cfg.sim_minutes * 60:
        in_peak = cfg.peak_start_min * 60 <= t < cfg.peak_end_min * 60
        lam_per_sec = (cfg.lambda_peak if in_peak else cfg.lambda_offpeak) / 60
        if rng.random() < lam_per_sec * step:
            yield t
        t += step
高峰 1.6 人/分钟,平峰 0.8 人/分钟。这个数是我翻了两周的小票记录估出来的,不精确,但比「拍脑袋」强得多。
七、真正的重头戏:一次跑不算数
改完这些,我把同一个配置连着跑了两次。第一次 5.2 分钟,第二次 9.8 分钟。
同一份代码,同一个参数,差了一倍多。
这就是随机仿真的本质:单次运行只是抽了一次签。 你抽到的那个数,什么都说明不了。
正确做法是重复跑,看分布。我让 WorkBuddy 把这块包起来:
import math
import statistics


def replicate(n=30, **kw):
    waits = []
    for i in range(n):
        log = run(seed=1000 + i, **kw)          # 换种子,别复用
        w = [r["wait_order"] + r["wait_make"] for r in log]
        waits.append(statistics.mean(w) / 60)

    m = statistics.mean(waits)
    half = 1.96 * statistics.stdev(waits) / math.sqrt(n)
    return m, m - half, m + half
跑 30 次,取均值,再算个 95% 置信区间。区间宽度控制在 ±0.6 分钟以内,对我来说够用了 —— 我又不是发论文,我只要一个能跟老板对话的精度。
顺带一提,种子必须换。如果你 30 次都用同一个种子,你得到的不是 30 个样本,是同一个样本看了 30 遍。
八、四套方案,结果有点反常识
到这里准备工作才算完。接下来是老板真正关心的问题:钱该花在哪。
我跑了四套配置,每套 30 次:
方案 | 收银台 | 制作台 | 平均总等待 | P90 | 等待>10min 占比 | 流失率 | 制作台利用率 |
|---|---|---|---|---|---|---|---|
S0 现状 | 1 | 2 | 7.4 分钟 | 13.3 | 39.2% | 7.5% | 86.9% |
S1 只加制作台 | 1 | 3 | 3.7 分钟 | 7.7 | 8.6% | 0.2% | 64.4% |
S2 只加收银台 | 2 | 2 | 7.1 分钟 | 13.2 | 37.2% | 8.0% | 87.2% |
S3 两个都加 | 2 | 3 | 1.2 分钟 | 3.3 | 0.9% | 0.0% | 65.0% |
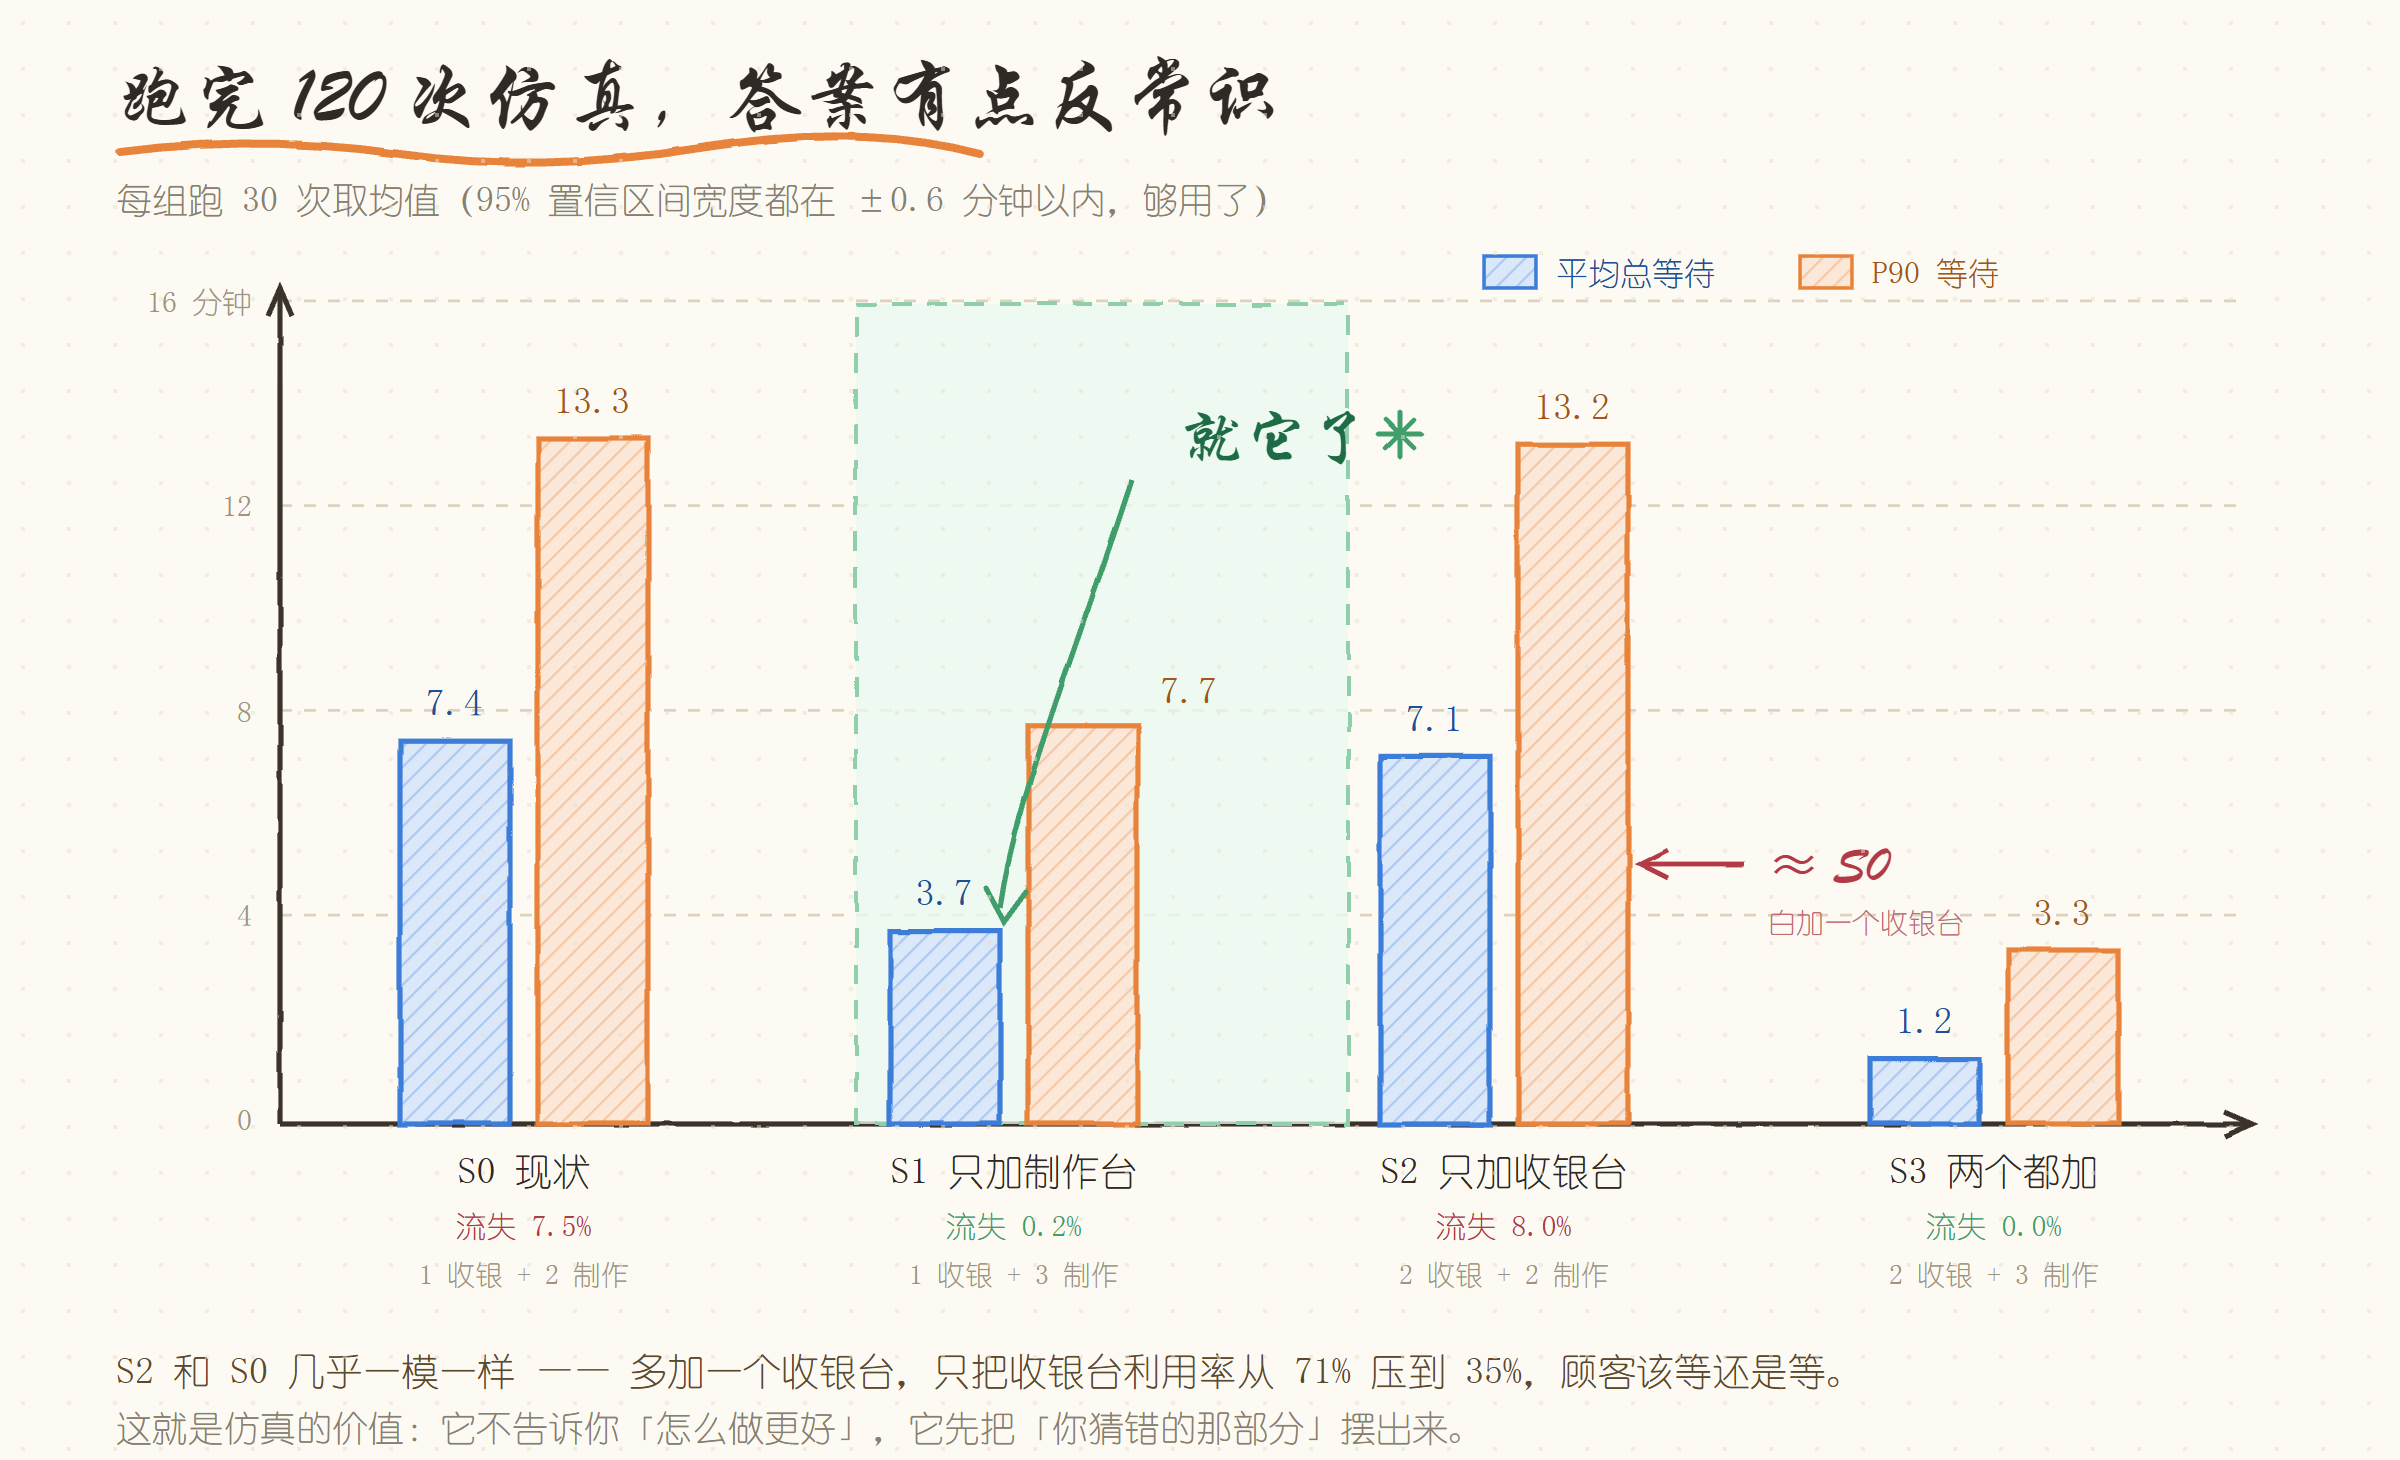
盯着 S2 那一列看三秒。
加了收银台,平均等待从 7.4 降到 7.1。降了 0.3 分钟,也就是 18 秒。流失率甚至还涨了 0.5 个百分点(这属于随机波动,但意思很明确:没有任何改善)。
为什么?因为瓶颈根本不在收银台。
看利用率那一列就懂了:S0 的时候制作台已经跑到 86.9%,收银台只有 70.7%。你再加一个收银台,收银台的利用率直接被摊薄到 34.8% —— 新来的那个人大部分时间在擦桌子。
而只加一个制作台(S1),平均等待从 7.4 掉到 3.7,直接腰斩;流失率从 7.5% 掉到 0.2%,几乎清零。
这就是那个反常识的答案:老板想加的那个工位,不是瓶颈。他以为慢在收银,其实慢在做茶。
顺便说 S3。两个都加当然最好,平均等待 1.2 分钟,几乎不用等。但多花的那个收银台,把 3.7 分钟压到 1.2 分钟,代价是一个月多六千多块人力。值不值,是老板的判断,不是模型的判断。模型只负责把「代价」和「收益」摆在同一张桌上。
我最后给他的建议是:先上 S1,加一个制作台、加一个人,跑一个月看真实差评的变化。如果还压不住,再谈 S3。
九、这五个坑,我替你踩完了
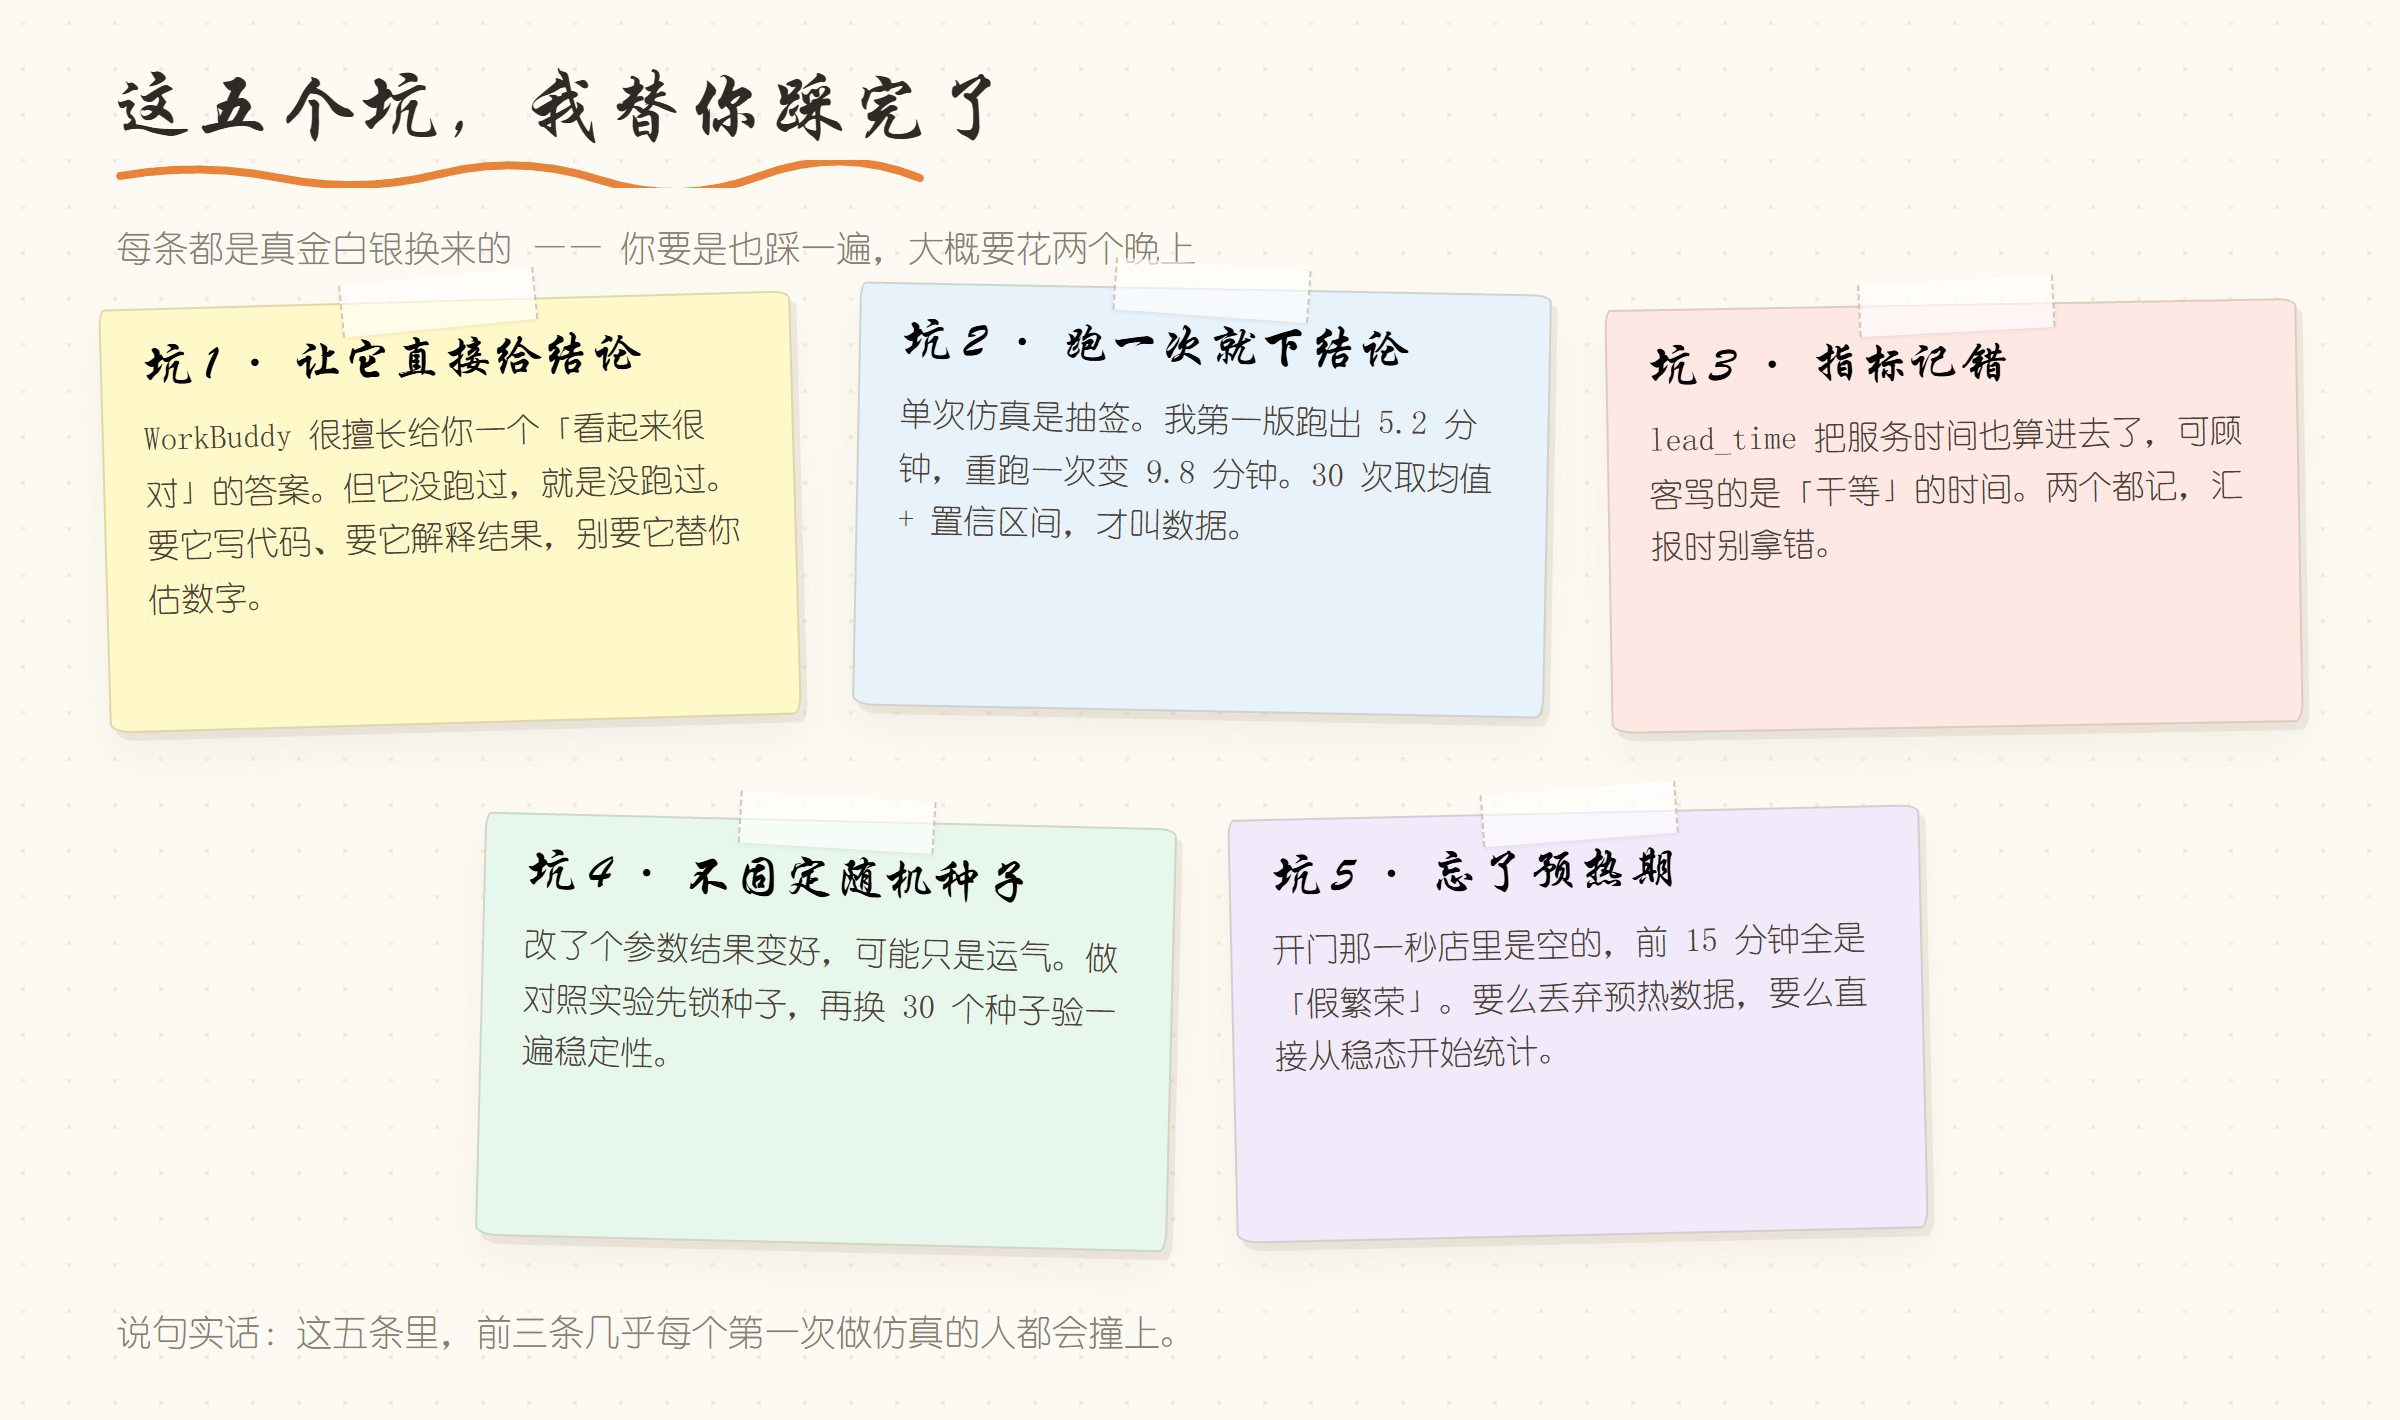
前三条几乎每个第一次做仿真的人都会撞上,我一条都没躲过。
补一句关于预热期的:仿真开始时店里是空的,前十几分钟所有顾客都能立刻被服务,数据会好看得不真实。要么把前 15 分钟的数据丢掉,要么一开始就把队列填到稳态。我第一版没做这件事,导致 S0 的平均等待被低估了大概 0.8 分钟。
十、这套东西还能用在哪
奶茶店只是个壳子。这套「状态机 + 重复实验」的组合,本质上在回答同一个问题:资源不够的时候,先加哪个?
我后来拿同样的骨架改了几个场景,改动量都不大:
- 医院门诊:把收银台换成挂号窗口,制作台换成诊室,加一个「医生看诊时间服从对数正态」就行。指标换成「当天没看完的病人数」。
- 仓库拣货:订单到达 → 排队等拣货员 → 拣货 → 排队等打包 → 打包。瓶颈经常出现在打包台,而不是拣货区。
- 客服中心:这个最典型。你以为要加人,其实很多时候是「一次解决率」太低,同一个客户打三遍电话,把队列灌爆了。
判断标准很简单:只要有「排队 + 有限资源 + 随机性」这三样,就值得跑一跑。 反过来,如果流程是确定的、资源是充足的,那不用仿真,列个表算算就行,别给自己找事。
最后
说句实在话,这件事里最难的部分不是代码,也不是数学。
最难的是忍住不问 AI「大概是多少」。
WorkBuddy 在这件事里的价值,是把我从「不会写 SimPy」变成「半小时后有个能跑的东西」。它写得比我快,改得比我快,解释得也比我清楚。但它不知道我们店中午几点最挤,不知道顾客等 15 分钟会走人,更不知道老板其实只有八千块预算。
那些东西得你自己填进去。填完了,跑出来的数字才是你的。
跑完之后我把结论发给了老板。他看完沉默了一会儿,说:「那就先加个做茶的。」
昨天新制作台到了,还在装。等下个月我打算再跑一次,把真实数据回填进去,看看模型差多少。
差多少,我都认。至少它是个能被检验的数,不是一句「我感觉」。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号