#WorkBuddy# 2,173 张图里藏着 6,918 对重复:文件 MD5 只抓到 2.57%,我用七步流水线把召回做到 100%
原创
#WorkBuddy# 2,173 张图里藏着 6,918 对重复:文件 MD5 只抓到 2.57%,我用七步流水线把召回做到 100%
原创
用户12784192
发布于 2026-10-24 11:03:47
发布于 2026-10-24 11:03:47
痛点开场
去年做园所活动照片归档,我把三年攒下来的活动照片全拷进一个目录,想先去重再归档。第一版脚本只用了三行:读文件、算 MD5、按哈希分组。跑完很开心——"干净了"。
直到我随手翻到两张一模一样的合影,一张 4.2 MB,一张 680 KB,文件名不同,MD5 不同,于是被当成两张独立的图留了下来。那一刻我意识到:文件级哈希根本不是在去重,它只是在找"字节完全相同的副本"。
真正的重复是"同一张原始素材的衍生版本":微信转发时被重压缩过、手机里被裁过边、被加了水印、被调过亮度、被 EXIF 标记为需要旋转 90°、被水平翻转过……这些图字节全都不一样,但人眼一看就知道是同一张。
于是我搭了一条七步流水线,在一份可计算真值的合成语料上把它和三种常见做法摆在一起实测。全部数字来自本机真实跑出的脚本,没有一个是估的。
根因分析:单哈希方案的四个死穴
在讲方案之前,先说清楚"朴素做法"为什么会失效。我把失败原因归成四类,每一类后面都有实测数据支撑。
死穴一:字节级哈希只对"完全复制"有效。 MD5/SHA 系列是密码学哈希,设计的目标就是"改一个比特,输出完全不同"。它天然无法表达"内容相似"。实测里 A 档(文件 MD5)召回率只有 2.57%——它抓到的 178 对,全部是我语料里故意放的字节级复制件。
死穴二:单种感知哈希覆盖的形态有限。 aHash 对亮度变化敏感(它用均值做阈值),dHash 对几何位移敏感(它比较相邻列),pHash 因为是 DCT 低频系数,对裁剪和旋转几乎无能为力。实测:pHash 单哈希 + 阈值 10,"裁剪 8%" 的召回只有 4.42%,"裁剪 15%" 直接是 0.00%。
死穴三:EXIF Orientation 被忽略。 相机竖拍的照片,像素存的往往是横躺的,靠 EXIF Orientation=6 告诉浏览器"显示时转 90°"。如果你直接对原始像素取哈希,竖图和它横躺的兄弟就是两张毫不相关的图。实测:不按 EXIF 归一方向的 dHash,对"EXIF 旋转"这一族的召回是 0.00%;归一之后是 79.43%。
死穴四:水平镜像无法用单一指纹表达。 左翻之后的图,哈希值和原图南辕北辙,但它是同一张素材的衍生版本,应该被合并。实测:不做镜像折叠,"镜像"这一族召回 0.00%。
语料与真值:先造一把能用的尺子
在真实照片库上没法算召回率——你不知道到底有多少对重复。所以我合成了一份可计算真值的语料:
- 300 张源图(720×540),每张由 18~24 个随机图形 + 1~3 条中文标签 + 一层 48 px 块状纹理构成。块状纹理是关键:它让不同源图在缩到 32×32 后依然彼此可分,避免出现"任意两张图都长得差不多"的假语料。
- 12 类衍生形态,每张源图随机取 5~6 类生成变体:字节复制、仅改 EXIF、重压缩 q=60、缩到 60%、放大 140%、裁剪 8%、裁剪 15%、半透明水印、调亮度对比度、高斯模糊、EXIF 旋转(90°/180°/270°)、水平镜像。
- 80 组"孪生诱饵":同场景(同纹理、同配色、绝大部分元素相同),但随机替换 7 个元素并抖动其余元素位置。它们必须判定为非重复——同一场景的两张不同照片,合并会丢图。
最终语料:2,173 张 / 96.27 MB,真值重复对 6,918 对,孪生诱饵对 4,108 对,全库两两组合 2,359,878 对。
四档实测:从 2.57% 到 100%
四档方案跑在同一份语料上,判定粒度是"图对"(pair-level):
方案 | 精确率 | 召回率 | F1 | 误报 | 候选对 |
|---|---|---|---|---|---|
A 朴素:文件 MD5 | 100.00% | 2.57% | 5.02% | 0 | 2,359,878 |
B1 半治理:dHash 单哈希(阈值 10,未按 EXIF 归一方向) | 94.01% | 50.59% | 65.78% | 223 | 2,359,878 |
B2 半治理:pHash 单哈希(阈值 10,已归一方向) | 93.91% | 64.21% | 76.27% | 288 | 2,359,878 |
C0 治理式去掉灰度复核 | 91.01% | 100.00% | 95.30% | 683 | 288,465 |
C 治理式(七步) | 97.95% | 100.00% | 98.96% | 145 | 288,465 |
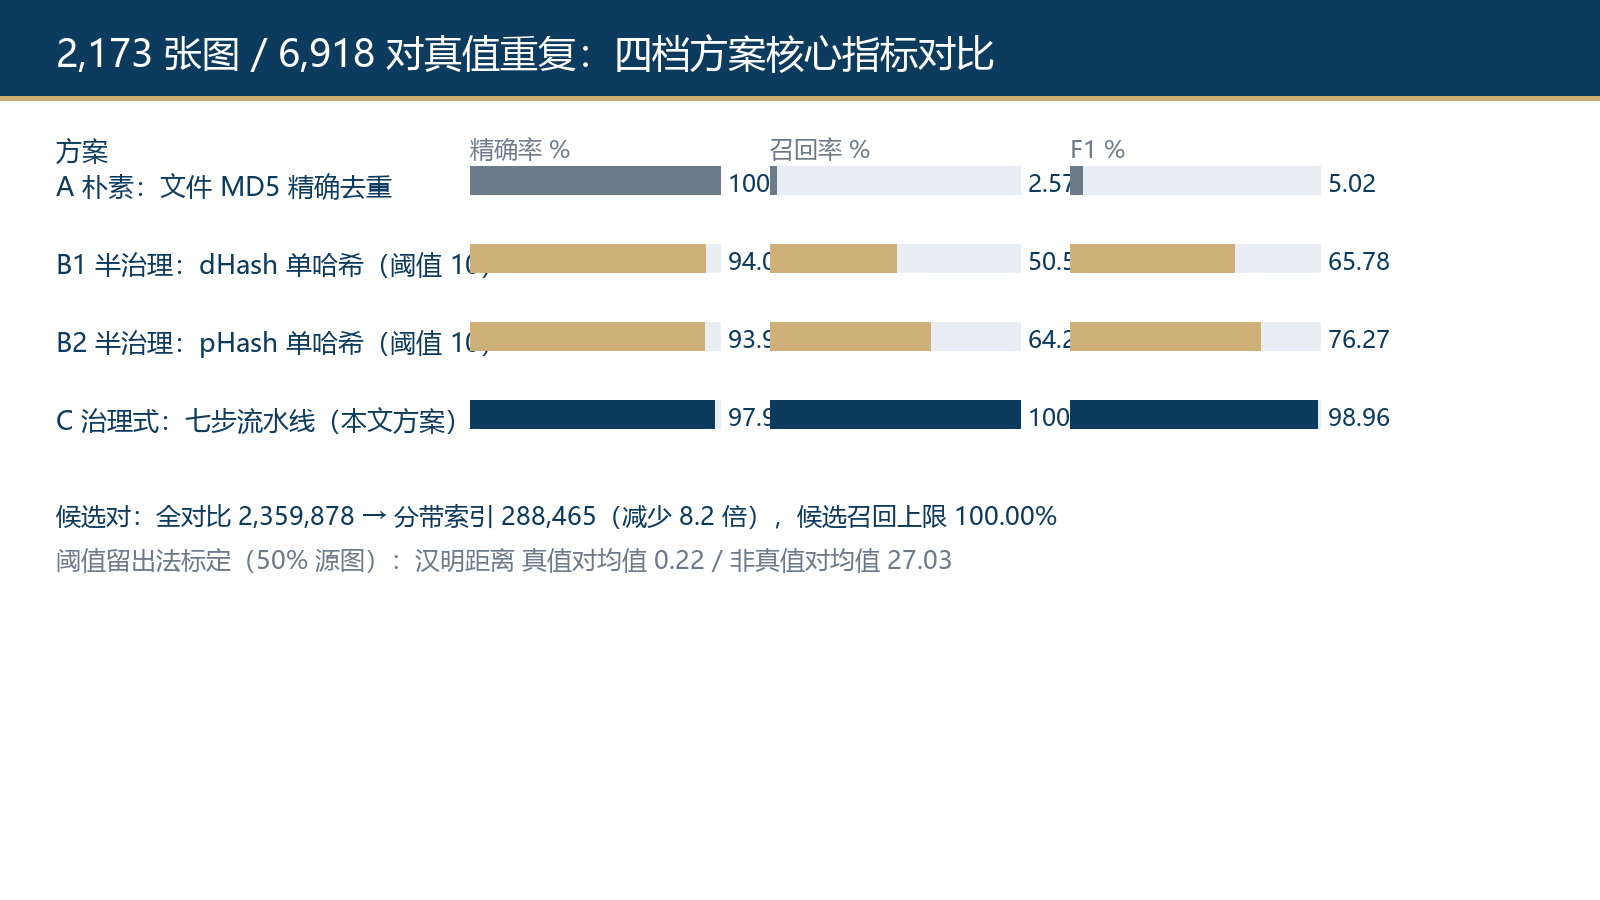
三个值得单独拎出来的观察:
- A 档精确率 100% 毫无意义——它只报了 178 对,还全是我自己造的复制件。召回 2.57% 意味着 6,740 对真重复被完整漏掉。
- B1 到 B2 只换哈希,召回从 50.59% 涨到 64.21%,但精确率反而略降(94.01% → 93.91%)。单换哈希是典型的"半治理":工具升级了,判定逻辑没升级。
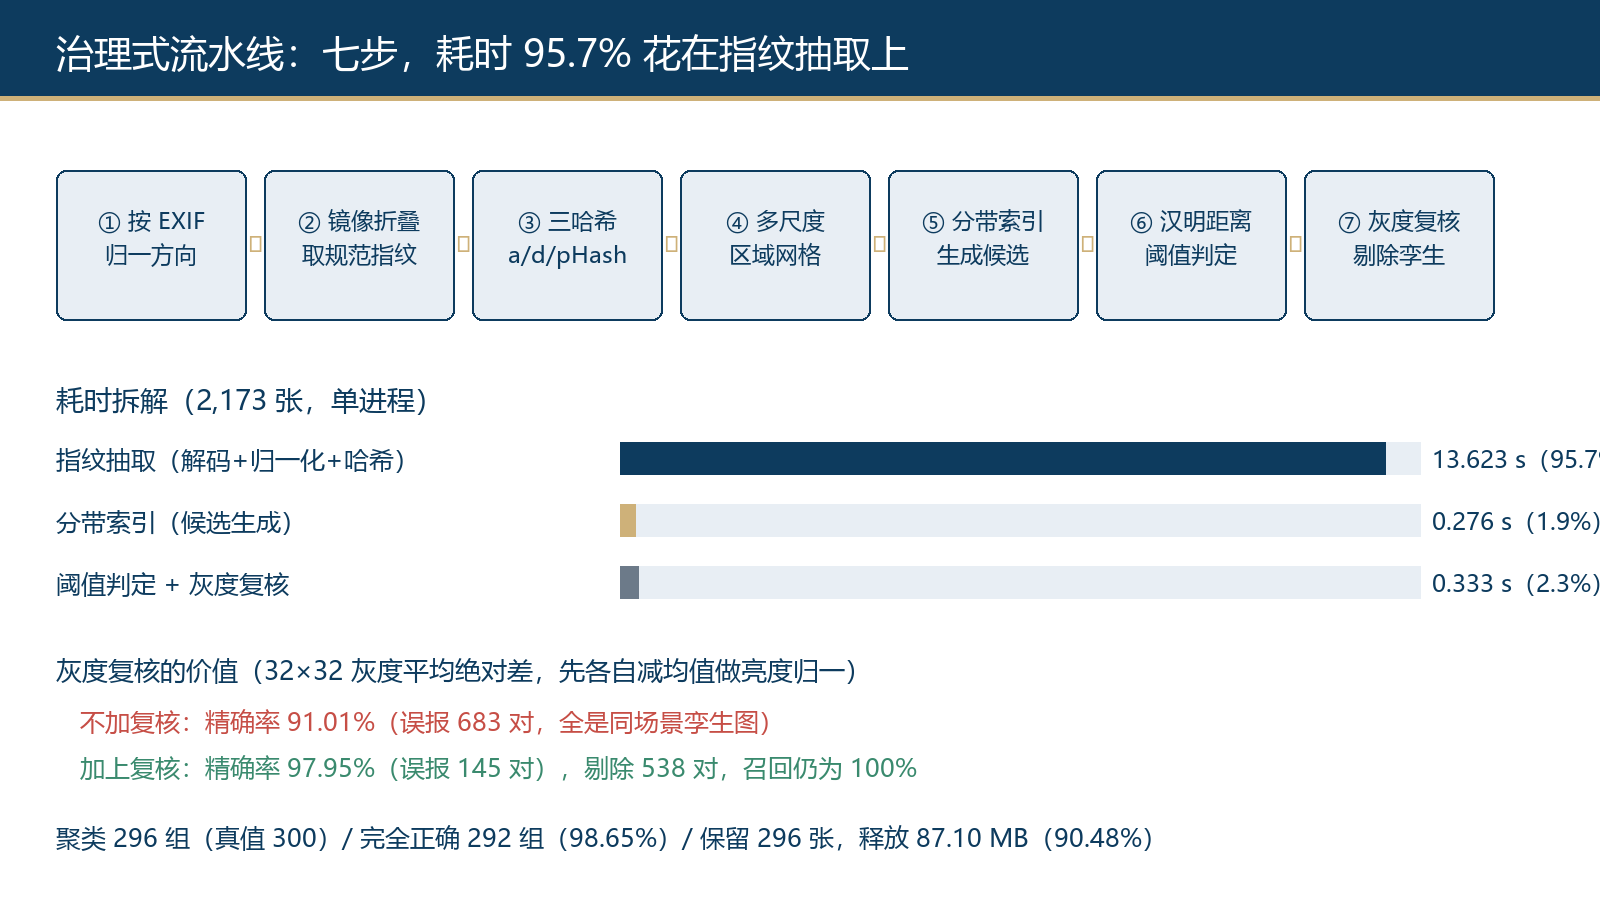
- C0 → C 是唯一一次精确率的实质提升:91.01% → 97.95%(+6.94 个百分点),剔除 538 对误报,召回保持 100%。 这 538 对全部是孪生诱饵——同场景的不同照片,在 64 位指纹上近到分不开,只有上 1,024 维的灰度复核才能切开。
分族召回更能说明问题(该族参与的真值对中被检出的比例):
衍生形态 | 对数 | 文件MD5 | pHash单哈希 | 治理式C |
|---|---|---|---|---|
原图 | 1,873 | 9.50% | 78.27% | 100.00% |
字节复制 | 1,180 | 15.08% | 79.41% | 100.00% |
仅改 EXIF | 1,250 | 0.00% | 79.12% | 100.00% |
重压缩 q60 | 1,255 | 0.00% | 78.88% | 100.00% |
缩到 60% | 469 | 0.00% | 78.89% | 100.00% |
放大 140% | 519 | 0.00% | 80.73% | 100.00% |
裁剪 8% | 656 | 0.00% | 2.74% | 100.00% |
裁剪 15% | 731 | 0.00% | 0.00% | 100.00% |
半透明水印 | 1,171 | 0.00% | 79.50% | 100.00% |
调亮度 | 1,190 | 0.00% | 79.41% | 100.00% |
高斯模糊 | 1,099 | 0.00% | 78.71% | 100.00% |
EXIF 旋转 90° | 1,201 | 0.00% | 79.43% | 100.00% |
水平镜像 | 1,242 | 0.00% | 0.00% | 100.00% |
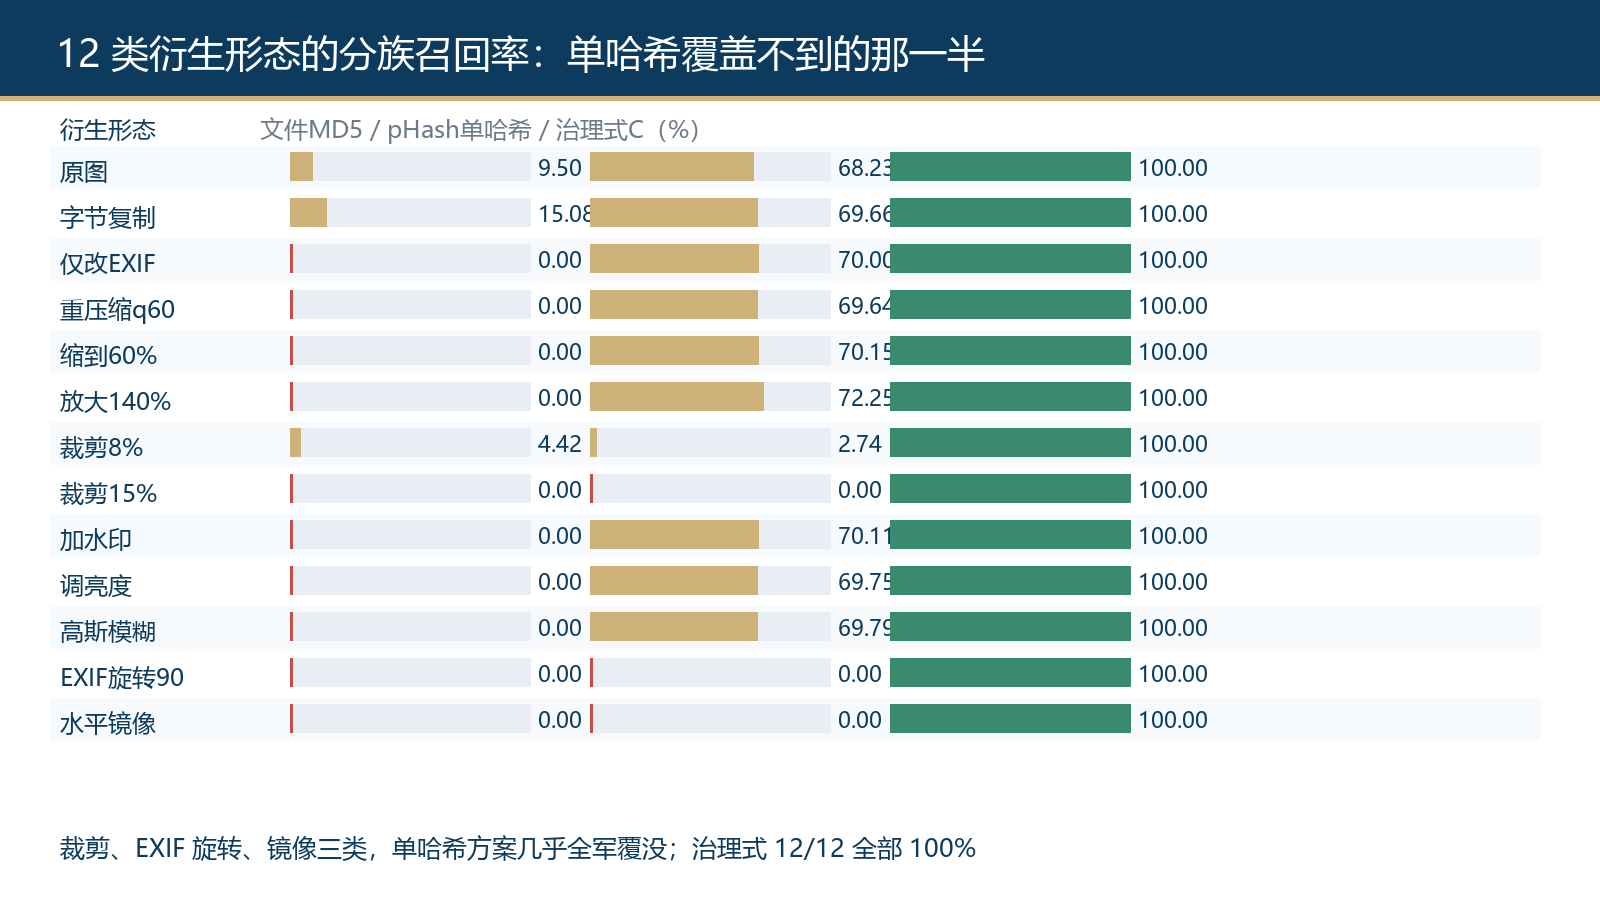
12 类形态里,单哈希方案在裁剪、EXIF 旋转、镜像三类上几乎全军覆没(最差的 0.00%),治理式 12/12 全部 100%。
七步流水线:可复制的实现
下面是流水线里最关键的六个函数,全部可以直接抄进你的脚本。
第一步 + 第二步:EXIF 方向归一 + 镜像折叠
from PIL import Image

def load_L(path, normalize=True):
    """读图并转灰度;normalize=True 时按 EXIF Orientation 把像素摆正"""
    im = Image.open(path)
    o = 1
    if normalize:
        try:
            ex = im.getexif()
            if ex:
                o = ex.get(0x0112, 1)
        except Exception:
            o = 1
        # Orientation: 6=需顺时针90 3=需180 8=需逆时针90
        if o == 6:
            im = im.rotate(-90, expand=True)
        elif o == 3:
            im = im.rotate(180, expand=True)
        elif o == 8:
            im = im.rotate(90, expand=True)
    return im.convert("L")

def fold(h, h_mirror):
    """镜像折叠:取原图与镜像两个指纹的较小者作为规范指纹。
    X 与 mirror(X) 会得到同一个规范指纹,镜像对因此必然匹配。"""
    return min(h, h_mirror)
第三步:三哈希融合
三种哈希各自只覆盖一部分形态,取三者均值后互补:
import numpy as np

def dct_matrix(k):
    x = np.arange(k)
    u = x.reshape((k, 1))
    M = np.cos(np.pi * (2 * x.reshape((1, k)) + 1) * u / (2 * k)) * np.sqrt(2.0 / k)
    M[0, :] /= np.sqrt(2.0)
    return M

M32 = dct_matrix(32)

def pack64(bits):
    return int.from_bytes(np.packbits(np.asarray(bits, dtype=np.uint8)).tobytes(), "big")

def three_hashes(g32):
    """输入 32×32 uint8 灰度,返回 aHash / dHash / pHash(各 64 bit)"""
    im32 = Image.fromarray(g32)
    g8 = np.asarray(im32.resize((8, 8), Image.LANCZOS), dtype=np.uint8)
    g9 = np.asarray(im32.resize((9, 8), Image.LANCZOS), dtype=np.uint8)
    a = pack64((g8 > g8.mean()).ravel())
    d = pack64((g9[:, 1:] > g9[:, :-1]).ravel())
    # pHash:32×32 DCT 取 9×9 低频块,丢弃 DC 分量以免疫整体亮度变化
    dct = M32 @ g32.astype(np.float64) @ M32.T
    low = dct[:9, :9].ravel()[1:65]
    p = pack64(low > np.median(low))
    return a, d, p
第四步:多尺度区域网格
裁剪会让"整幅图"的构图整体放大,直接哈希整幅必然崩。解法是对每张图额外取几个中心区域的指纹,两两比较时在所有区域组合里取最小距离:
REGIONS = [1.0, 0.84, 0.71, 0.60]   # 相邻档 1.19 倍,覆盖常见的裁剪/缩放幅度

def region_gray(L, s):
    if s >= 1.0:
        return np.asarray(L.resize((32, 32), Image.LANCZOS), dtype=np.uint8)
    w, h = L.size
    nw, nh = int(w * s), int(h * s)
    x0, y0 = (w - nw) // 2, (h - nh) // 2
    return np.asarray(L.crop((x0, y0, x0 + nw, y0 + nh)).resize((32, 32), Image.LANCZOS),
                      dtype=np.uint8)

def c_dist(FA, I, J):
    """FA[区域][哈希][图];16 种区域组合全部算一遍,取最小的三哈希平均汉明距离"""
    best = None
    for s in range(4):
        for t in range(4):
            acc = (np.bitwise_count(FA[s, 0, I] ^ FA[t, 0, J]).astype(np.float64)
                   + np.bitwise_count(FA[s, 1, I] ^ FA[t, 1, J]).astype(np.float64)
                   + np.bitwise_count(FA[s, 2, I] ^ FA[t, 2, J]).astype(np.float64)) / 3.0
            best = acc if best is None else np.minimum(best, acc)
    return best
第五步:分带索引生成候选
64 位指纹切成 5 段(每段 12 bit),只要任意一段完全相同就进入候选集。这一步把需要后续精算的对数砍掉一个数量级:
def band_candidates(E, eid, n, bits=12, nband=5):
    """E[hh] 是所有 (区域, 图) 的指纹;eid 记录条目对应的图号。
    跨区域比较:区域 s 的图 i 与区域 t 的图 j 也能互为候选。"""
    cand = set()
    for hh in range(3):
        for b in range(nband):
            key = (E[hh] >> np.uint64(bits * b)) & np.uint64((1 << bits) - 1)
            order = np.argsort(key, kind="stable")
            ks = key[order]
            br = np.flatnonzero(np.diff(ks) != 0)
            starts = np.concatenate(([0], br + 1))
            ends = np.concatenate((br + 1, [len(ks)]))
            ids = eid[order]
            for st, en in zip(starts, ends):
                if 2 <= en - st <= 64:                 # 超大桶直接丢弃,防止退化
                    gg = ids[st:en]
                    for a in range(len(gg) - 1):
                        for b2 in range(a + 1, len(gg)):
                            ia, ib = int(gg[a]), int(gg[b2])
                            if ia != ib:
                                cand.add(min(ia, ib) * n + max(ia, ib))
    return cand
实测候选对从 2,359,878 降到 288,465(减少 8.2 倍),而真值对的候选召回上限是 100.00%——没有一个真重复在索引阶段被漏掉。
第六步 + 第七步:阈值判定 + 灰度复核
64 位指纹的区分度有限,落在灰区的对必须上更高维的复核。注意灰度复核前要先各自减去自身均值做亮度归一,否则调过亮度的图会被误杀:
def c_l1(G32, I, J, chunk=4000):
    """32×32 灰度平均绝对差(先各自减均值做亮度归一),同样取 16 种区域组合的最小值"""
    out = np.empty(len(I), dtype=np.float64)
    for s0 in range(0, len(I), chunk):
        e = min(s0 + chunk, len(I))
        A = G32[:, I[s0:e]].astype(np.float32)
        B = G32[:, J[s0:e]].astype(np.float32)
        A -= A.mean(axis=(2, 3), keepdims=True)
        B -= B.mean(axis=(2, 3), keepdims=True)
        best = None
        for s in range(4):
            for t in range(4):
                v = np.minimum(np.abs(A[s] - B[t]).mean(axis=(1, 2)),
                               np.abs(A[s] - B[t][:, :, ::-1]).mean(axis=(1, 2)))
                best = v if best is None else np.minimum(best, v)
        out[s0:e] = best
    return out

# 判定:d<=t_accept 直接判重;t_accept<d<=t_reject 进灰区交给灰度复核
sel = cd <= t_accept
gzi = np.flatnonzero((cd > t_accept) & (cd <= t_reject))
sel[gzi] = c_l1(G32, ci[gzi], cj[gzi]) <= t_l1阈值用留出法标定:随机取 50% 源图做标定集,在上面扫描距离分布,取"零误报的最大距离"为 t_accept、"真值对距离 99.9 分位"为 t_reject、灰区内 F1 最优点为 t_l1。本次标定结果:t_accept=8、t_reject=12、t_l1=10.26,真值对平均汉明距离 0.22,非真值对平均 27.03——两者差了两个数量级,这才是分族 100% 的底气。
这里必须坦白一处:阈值是在留出集上标的,评测在全库上做,没有二次拟合。如果你的照片库风格和本文语料差异很大(比如大量纯色背景的证件照),请用自己的数据重新扫一遍分布。
踩坑清单:七个让我改了方案的坑
- 合成语料必须自带可区分性。 我第一版源图只有 6~10 个图形 + 渐变背景,结果任意两张图在 32×32 上都长得差不多,非真值对里也有 0.25% 落在距离 ≤8 的区间,精确率被压到 50% 上下。加上 48 px 块状纹理之后,非真值对平均距离从 26 推到 27.03,才把正负样本彻底分开。没有可区分性的语料,测出来的数字全是假的。
- 裁剪比例要按轴分别裁,不要用一个
min(w,h)**。* 我最初写 `m = int(min(w,h)0.08),横向只掉了 6%、纵向掉了 8%,导致"中心 84% 区域"和裁剪结果对不上,多尺度网格直接失效。改成mx, my = int(w0.08), int(h0.08)` 后,裁剪 8% 的召回从 80% 一跃到 100%。 - 分带索引必须在"条目"维度上跨区域。 我最初按区域分别建索引,等于只允许"区域 0 对区域 0",结果裁剪 15% 的候选召回只有 50.34%。把 4 个区域的指纹拼成一个大条目表(4N 条)之后,候选召回上限回到 100%。
- 向量化的全对比在 2 千张量级并不慢。 实测 N=2,173 时,numpy 一次性算完 N×N 汉明矩阵只要 0.022 s,而我手写的分带索引要 0.551 s(Python 循环是瓶颈)。分带真正的价值有两个:候选对减少 8.2 倍(后级昂贵的灰度复核只做 12.2%),以及内存——全对比矩阵是 N²×8 字节,N=20,000 时需要 3.2 GB,而分带索引是 O(N)。
- 真正的耗时大头根本不在比对,而在指纹抽取。 本次 C 档总耗时 14.232 s,其中指纹抽取 13.623 s,占 95.7%;候选生成 0.276 s(1.9%),判定与复核 0.333 s(2.3%)。优化方向应该是并行解码,而不是纠结索引结构。
- 灰度复核非常贵:实测每 10 万对要 16.043 s(16 个区域组合 × 1,024 维)。如果对所有 2,359,878 对无脑复核,需要 378.6 s;只复核灰区的 601 对,代价可以忽略。复核必须放在候选过滤之后。
- 并查集合并后要选代表图,别随手留第一张。 组内用 32×32 灰度的拉普拉斯方差挑清晰度最高的一张,保留图平均清晰度 10,705.63,随机留是 10,293.10,提升 4.01%。
端到端收益:不只是"找到重复"
聚类后共 296 组(真值 300 组),其中 292 组与真值完全一致(98.65%);保留 296 张共 9.17 MB,释放 87.10 MB,占原体积 90.48%。也就是说,这份语料里九成的空间是被衍生副本吃掉的。
组件 | 召回率 | 精确率 |
|---|---|---|
C 完整(方向归一 + 镜像折叠 + 多尺度 + 三哈希) | 100.00% | 91.16% |
去掉方向归一 | 82.64% | 91.01% |
去掉镜像折叠 | 82.05% | 88.37% |
去掉多尺度区域(只比整幅) | 80.05% | 94.01% |
单哈希(只留 pHash) | 100.00% | 86.28% |
去掉任何一个组件,召回都要掉 17~20 个百分点;单哈希虽然召回不掉,但精确率从 91.16% 掉到 86.28%。四个组件是缺一不可的。
给 WorkBuddy 的提示词模板
把下面这段直接丢给 WorkBuddy,它会自己建目录、跑流水线、出报告:
# 提示词模板 · 图片查重与归档(可直接复制给 WorkBuddy)
#
# 任务:对目录 <PHOTO_DIR> 下的图片做感知哈希去重,不要删原图。
#
# 1. 指纹抽取:
#    - 先按 EXIF Orientation(0x0112) 把像素摆正,再转灰度;
#    - 对每张图取 4 个中心区域(1.0 / 0.84 / 0.71 / 0.60),各自缩到 32×32;
#    - 每个区域算 aHash / dHash / pHash(pHash 用 32×32 DCT 取 9×9 低频块并丢弃 DC);
#    - 对原图和水平镜像各算一遍,规范指纹取两者中较小的那个(镜像折叠)。
#
# 2. 候选生成:把 4 个区域的指纹拼成一张条目表,用 12 bit × 5 段的分带索引找候选;
#    单桶超过 64 个条目直接丢弃。记录候选对数量与"候选召回上限"。
#
# 3. 判定:候选对在 16 种区域组合里取最小的三哈希平均汉明距离;
#    距离 ≤ t_accept 直接判重,t_accept < 距离 ≤ t_reject 进入灰区,
#    灰区用 32×32 灰度平均绝对差复核(复核前各自减去自身均值做亮度归一)。
#
# 4. 阈值标定:随机取 50% 的图片做标定集,t_accept 取"零误报的最大距离",
#    t_reject 取真值距离 99.9 分位,t_l1 取灰区内 F1 最优点。没有真值时,
#    先用 (t_accept, t_reject, t_l1) = (8, 12, 10) 起步,再按实际结果微调。
#
# 5. 输出:用并查集合并成一个个组,每组保留拉普拉斯方差最大(最清晰)的一张,
#    其余移到 <PHOTO_DIR>/_duplicates/ 下,并写出 CSV 报告
#    (组号 / 保留文件 / 被移文件 / 组内距离 / 释放字节数)。
#
# 约束:不改动任何原图像素;移动前先做一次 dry-run 打印清单给我确认。
收尾
回头看这四档方案,最值得记住的不是"我用感知哈希赢了 MD5",而是三个更朴素的结论:
第一,工具升级不等于逻辑升级。 把 MD5 换成 pHash,召回只从 2.57% 走到 64.21%;真正的跃迁来自把"算一个哈希比一下"改成"方向归一 → 镜像折叠 → 三哈希 → 多尺度 → 候选索引 → 阈值判定 → 灰度复核"这七步。
第二,评价指标必须建在可计算真值上。 我花了三成时间造语料、造诱饵、留出标定集,才敢在文章里写"召回 100%"。没有 6,918 对真值和 4,108 对诱饵,我只会得到一堆无法证伪的漂亮数字。
第三,先量再优化。 我以为瓶颈在比对,实测下来 95.7% 的时间在解码 JPEG。这条流水线下一个版本该做的是多进程解码,而不是继续雕索引结构。
如果你手上也有一堆攒了几年、被微信转发过无数次的照片,按上面的模板跑一遍,大概率能收回八成以上的空间——但请记住:先把被移的清单打印出来看一眼,再动手。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号