Netskope 的专利:用于图像数据保护的“训练您自己的分类器”(TYOC)
原创
Netskope 的专利:用于图像数据保护的“训练您自己的分类器”(TYOC)
原创
特别关注外国供应商
发布于 2026-10-23 15:22:03
发布于 2026-10-23 15:22:03
介绍
基于机器学习的数据防泄漏 (DLP) 文件分类器能够快速有效地实时识别敏感数据,使组织能够实现精细化的实时 DLP 策略控制。Netskope 高级 DLP 提供一系列预定义的文件分类器,例如护照、驾驶执照、支票、支付卡、屏幕截图、源代码、税务表格和商业协议。尽管这些预定义的分类器本身就非常出色,但考虑到不同行业和组织中敏感数据的巨大多样性,它们必然存在一定的通用性。为了更好地处理公司或行业特定的文档,例如身份证明文件、人事档案或关键基础设施镜像,Netskope 开发了一种全新的专利方法,允许客户在确保数据隐私的前提下训练自己的分类器。这项创新使组织能够专注于保护其最关键的信息。
这种名为“训练您自己的分类器 (TYOC)”的训练过程旨在提高效率,既不需要大量标注数据,也不需要耗时的监督分类模型训练。这一功能得益于前沿的对比学习技术。客户可以将少量示例图像(约 20-30 张)上传到 Netskope 安全云平台。这些示例随后将用于提取重要属性,并使用 Netskope 的机器学习引擎训练定制的分类器。
自定义分类器训练完成后,将部署到客户的租户环境中,用于检测客户在使用 Netskope DLP 的任何位置(包括电子邮件和端点 DLP)中的敏感信息。重要的是,原始样本不会被保留,训练好的分类器也不会与其他客户共享,从而确保客户敏感数据在整个过程中得到保护。
图像相似性和对比学习
TYOC 利用对比学习技术解决图像相似性问题。
图像相似性旨在解决识别与参考图像相似的图像的难题,即使在颜色、方向、裁剪和其他特征方面存在细微差异。利用先进的对比学习技术可以有效地实现这一过程。
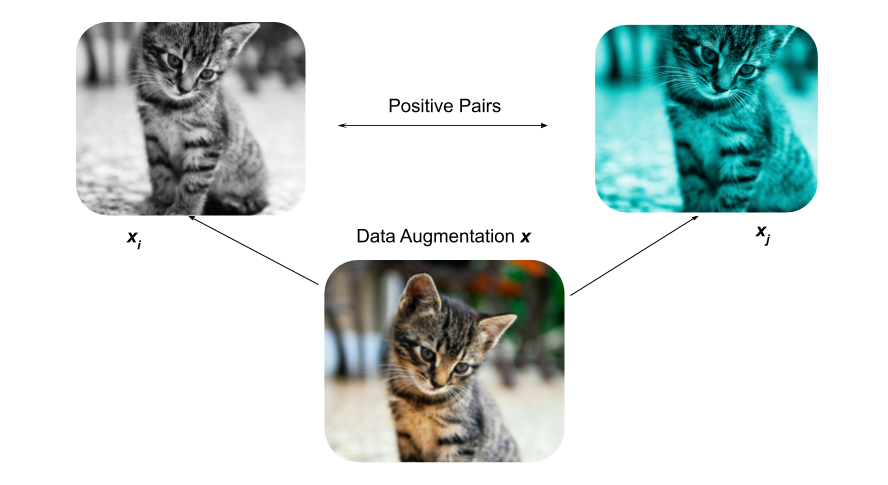
对比学习旨在通过对比相似(正例)和不相似(负例)的实例对来提取有意义的表征。其基本概念是:相似的实例在学习到的嵌入空间中应该彼此靠近,而不相似的实例则应该彼此远离。对比学习通过无监督学习来训练图像模型,具体做法是增强每张图像,以保留其语义内容。这种增强操作包括随机旋转、颜色失真和裁剪等,确保裁剪区域仍然是原始图像的重要组成部分。这些增强后的样本用于训练基于卷积神经网络(CNN)的图像编码器模型。该编码器以图像作为输入,并生成特征向量,也称为表征或嵌入。
Netskope TYOC 将 Netskope 预训练的图像编码器与客户提供的少量训练图像相结合。这种组合使 Netskope 安全云能够对客户相关的文件执行图像相似度排序,其性能与内置(预定义)文件分类器的性能相当。
对比学习训练
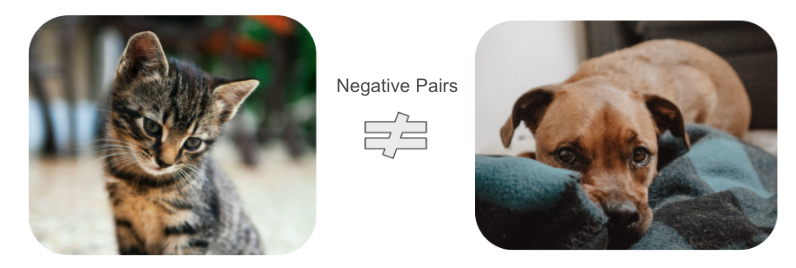
编码器模型通过建立匹配的图像对(称为正例对)之间的相似性来学习识别图像之间的相似性。匹配的图像对具有最高的相似度,而未匹配的图像对(称为负例对)则具有最低的相似度。以下我们将通过正例对和负例对的示例来说明这一概念。
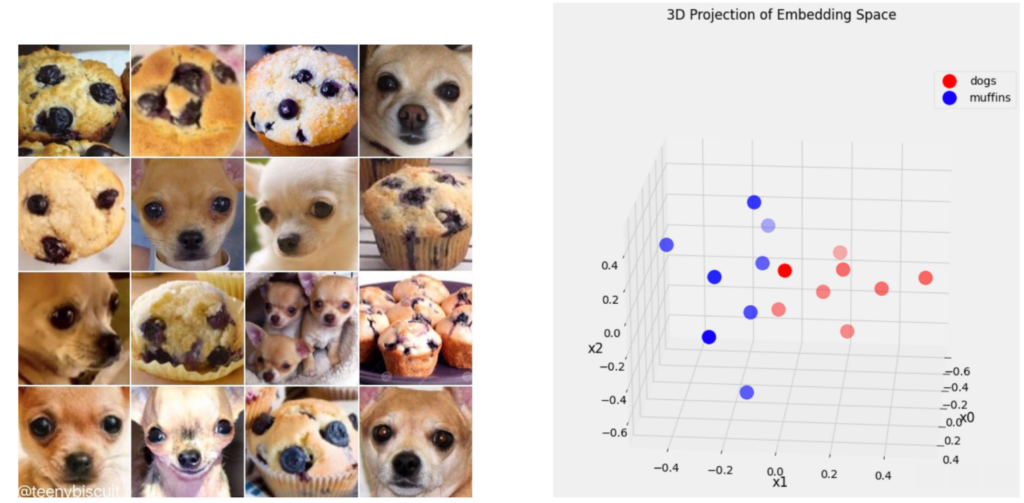
该图像编码器采用对比学习方法训练,可将任意图像映射到用于语义哈希的高维嵌入向量,从而有效地捕捉图像的语义信息。下图展示了该预训练图像编码器在“狗狗与松饼”数据集上的应用。该数据集包含八张狗狗图像和八张松饼图像,所有图像外观都非常相似。右侧展示了每张图像生成的高维嵌入向量的三维投影。该可视化结果清晰地展示了嵌入空间中两类图像的明显分离,突显了编码器在捕捉和区分图像语义本质方面的有效性。
使用训练你自己的分类器
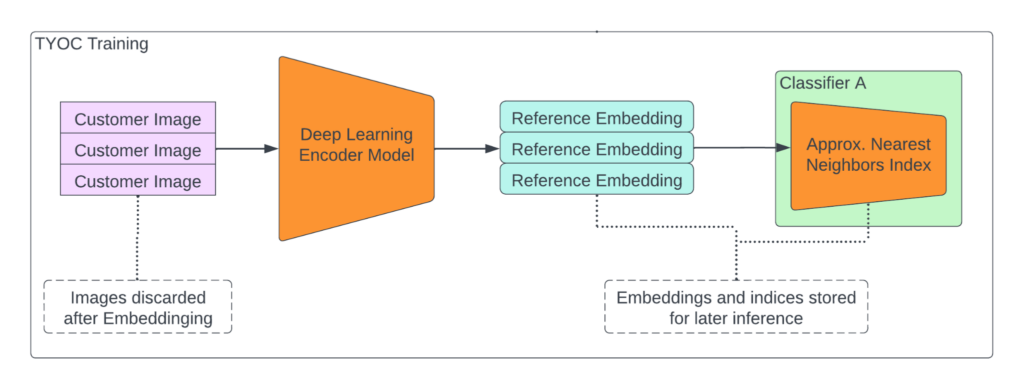
利用预训练的图像编码器模型,我们的系统允许客户上传训练图像或参考图像,用于训练定制分类器。为获得最佳性能,建议每个类别至少提供 20-30 张参考图像。图像编码器处理这些参考图像,将其转换为高维嵌入。为确保隐私,编码后会删除原始图像。这些参考嵌入随后用于构建近似最近邻 (ANN) 索引,该索引作为定制分类器。
在推理阶段,新图像使用相同的图像编码器模型进行编码,生成嵌入向量。然后,人工神经网络(ANN)模型识别最接近的参考嵌入向量的类别标签。如果到该最接近嵌入向量的距离低于预定义的阈值,则将图像分配到参考嵌入向量中对应的预测标签。否则,将图像归类到预测标签“其他”。
案例研究
门禁卡
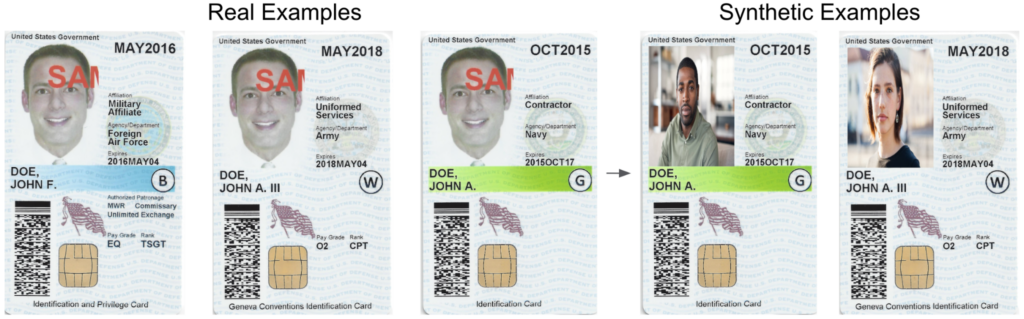
在本评估中,我们采用了 TYOC 方法对门禁卡进行分类,具体细节如下。最初,我们的数据集仅包含三个真实(样本)卡片,如左图所示。为了扩充训练数据,我们生成了 30 张合成图像。这种扩充方法是将样本卡片上的肖像替换为各种随机肖像,如右图所示。随后,我们分配了其中 20 张图像用于训练分类器,而剩余的 10 张图像以及 1000 个随机选择的负样本则用于测试。在测试阶段,自定义分类器表现出色,召回率(或检测率)达到 100%,精确率达到 99.3%。
手写签名
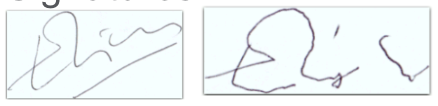
本实验使用了一个公开的手写签名数据集。该数据集包含64位人士的签名,每位人士约有25张签名图像。其中,每位人士约有10张伪造签名图像。所有图像均使用预训练的图像编码器转换为嵌入向量,无需进一步训练。对于每位人士,选取6个嵌入向量作为参考图像导入Annoy软件,其余约20个嵌入向量作为测试样本。在评估测试签名图像时,如果将伪造签名视为有效匹配,则签名与对应姓名的匹配准确率可达87%。如果排除伪造签名,准确率略微下降至84%。
隐私问题
我们预训练的图像编码器将图像转换为高维语义嵌入——图像本质含义及其视觉相似对应物的紧凑向量表示。由于这些嵌入包含语义数据,理论上存在图像可能被部分或完全从其嵌入中重建的风险,这可能会危及我们系统中的用户隐私。
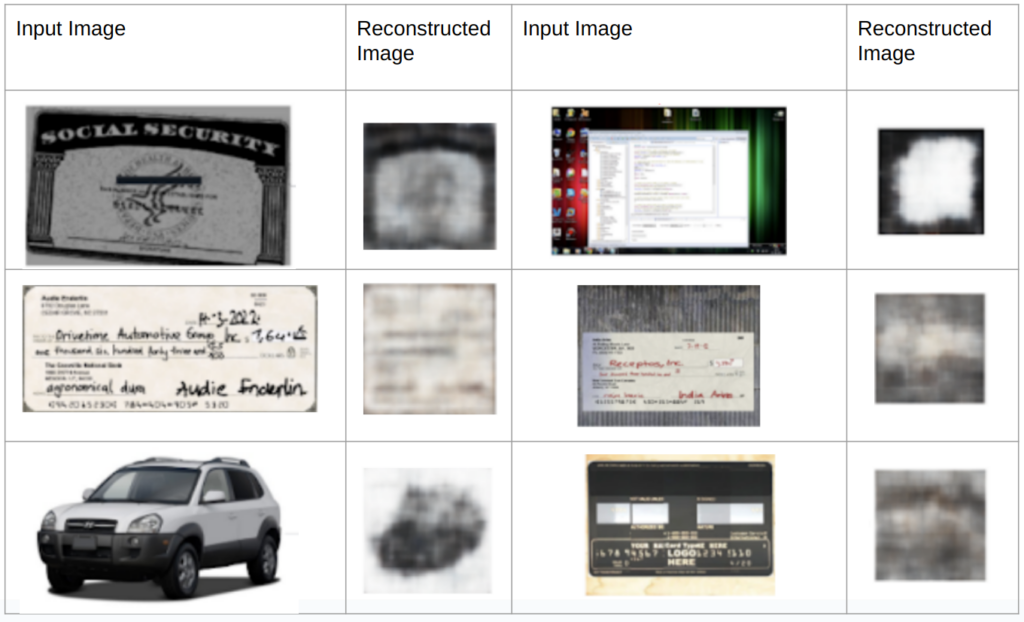
为了缓解这些担忧,我们进行了全面的实验,发现虽然理论上在极不可能的情况下可以从高维嵌入中重建图像,但重建结果的保真度会非常低。这一限制显著减少了可恢复的信息量,从而为防止潜在的隐私泄露提供了强有力的保障。
作为最坏情况,我们尝试使用能够访问 TYOC 编码器的生成式 AI 模型,从高维 TYOC 嵌入中重建图像。以下是一些结果。尽管模型架构、权重文件和实际图像嵌入完全可访问的可能性极低,但我们的重建结果仍然质量很差,无法重现任何细节。
概括
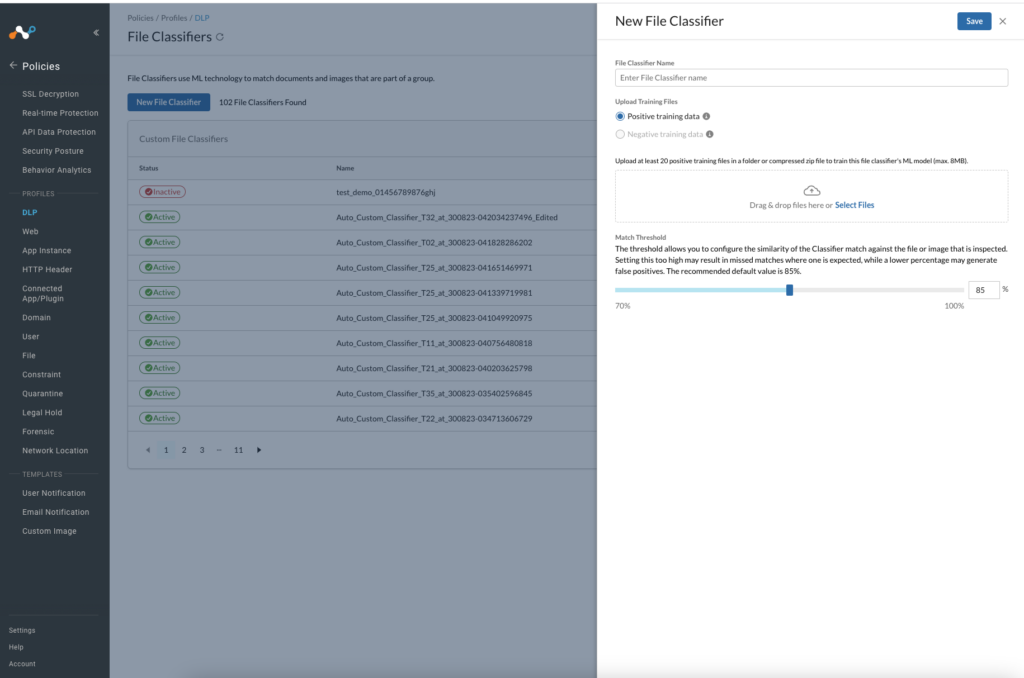
“训练您自己的分类器”功能现已作为 Netskope 高级 DLP 解决方案的一部分(如下截图所示)。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号