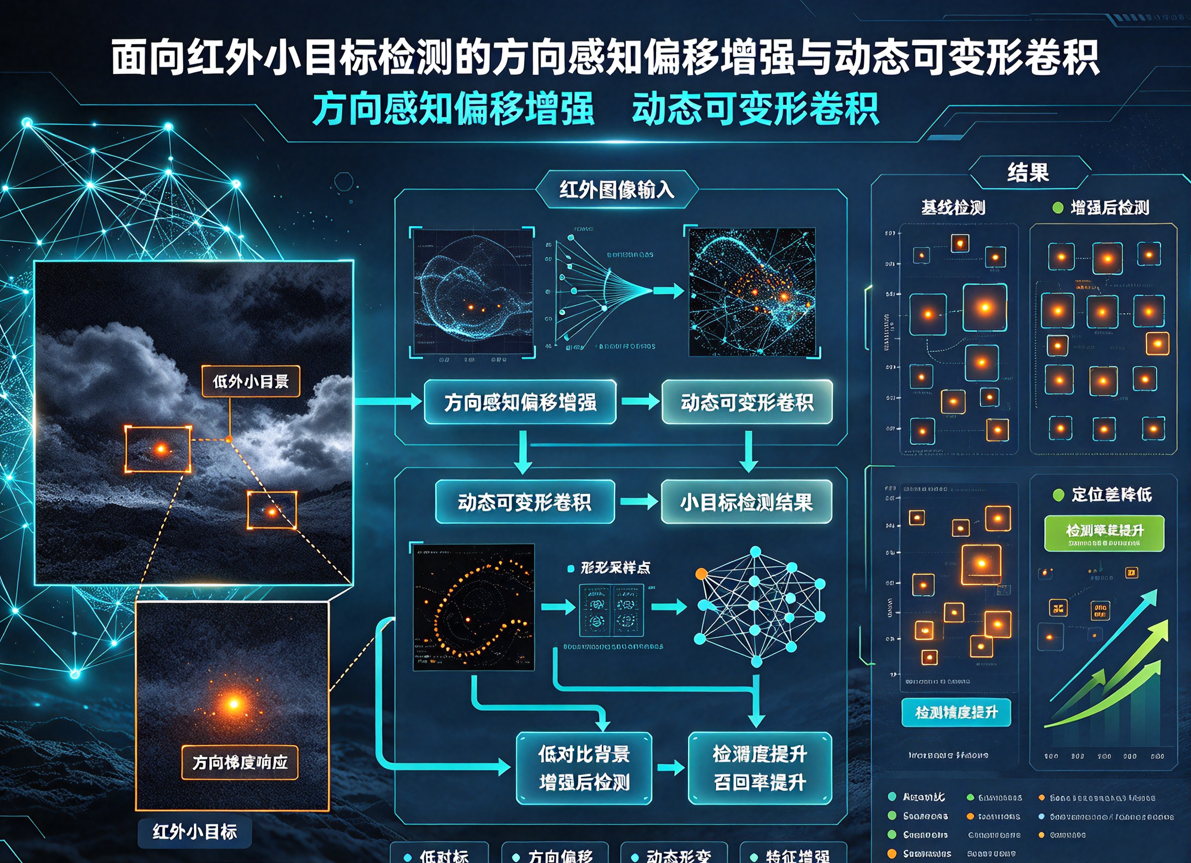
面向红外小目标检测的方向感知偏移增强与动态可变形卷积
原创
面向红外小目标检测的方向感知偏移增强与动态可变形卷积
原创
AI小怪兽
发布于 2026-10-23 09:01:32
发布于 2026-10-23 09:01:32
论文解读 | EDDNet:方向感知偏移增强 + 动态可变形卷积,让红外小目标检测摆脱背景噪声淹没
论文:Direction-Aware Offset Enhancement and Dynamic Deformable Convolution for Infrared Small-Target Detection 题目译名:《面向红外小目标检测的方向感知偏移增强与动态可变形卷积》 作者:Baofeng Ji, Dewei Wang, Jianpeng Bai, Guoqiang Zheng, Tongshuai Xin, Huitao Fan(河南科技大学 / 龙门实验室 / 郑州煤矿机械集团等) 期刊:IEEE Transactions on Geoscience and Remote Sensing, Vol. 64, 2026, Article 5620310 DOI:10.1109/TGRS.2026.3688853 | 代码:https://github.com/wdw0537/EDDNet
一、摘要
红外小目标检测(IRSTD)在军用与民用领域都扮演着关键角色。然而红外小目标本身尺寸极小,往往小于卷积核的尺寸,传统卷积操作不可避免地引入背景噪声,导致检测性能不佳。本文提出增强动态可变形网络 EDDNet:在特征提取过程中减少背景噪声引入的同时,充分提取小目标特征。具体包括三个设计:
- 设计动态可变形卷积,在精准提取红外小目标特征的同时,最小化背景噪声干扰;
- 提出方向感知偏移增强(DAOE)模块,增强卷积核采样点向小目标偏移的能力;
- 在编码器—解码器过渡处引入语义精炼(SR)模块,增强深度语义特征,确保网络在聚焦小目标的同时保持语义感知。
在 NUAA-SIRST、NUDT-SIRST、IRSTD-1K 三个公开数据集上的大量实验表明,该方法优于现有 SOTA 方法,能在复杂背景下提取更有效的目标信息。
EDDNet/model/EDDNet/UNet_dynamicDCNv2Block_MCCA_LEFF.py
核心代码:
import torch
import torch.nn as nn
import torch.nn.functional as F
from torchvision.ops import deform_conv2d


class ChannelAttention(nn.Module):
    def __init__(self, in_planes, ratio=16):
        super(ChannelAttention, self).__init__()
        self.avg_pool = nn.AdaptiveAvgPool2d(1)
        self.max_pool = nn.AdaptiveMaxPool2d(1)
        self.fc1 = nn.Conv2d(in_planes, max(in_planes // 16, 1), kernel_size=1, bias=False)
        self.relu1 = nn.ReLU()
        self.fc2 = nn.Conv2d(max(in_planes // 16, 1), in_planes, kernel_size=1, bias=False)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = self.fc2(self.relu1(self.fc1(self.avg_pool(x))))
        max_out = self.fc2(self.relu1(self.fc1(self.max_pool(x))))
        out = avg_out + max_out
        return self.sigmoid(out)


class SpatialAttention(nn.Module):
    def __init__(self, kernel_size=7):
        super(SpatialAttention, self).__init__()
        assert kernel_size in (3, 7), 'kernel size must be 3 or 7'
        padding = 3 if kernel_size == 7 else 1
        self.conv1 = nn.Conv2d(2, 1, kernel_size=kernel_size, padding=padding, bias=False)
        self.sigmoid = nn.Sigmoid()

    def forward(self, x):
        avg_out = torch.mean(x, dim=1, keepdim=True)
        max_out, _ = torch.max(x, dim=1, keepdim=True)
        x = torch.cat([avg_out, max_out], dim=1)
        x = self.conv1(x)
        return self.sigmoid(x)


class DeformableConv2d(nn.Module):
    # 带mask调制,即每个核的点都被0-1调制
    def __init__(self, in_dim, out_dim, kernel_size, stride=1, dilation=1, groups=1, bias=True, *,
                 offset_groups=1, with_mask=False
                 ):
        super().__init__()
        assert in_dim % groups == 0, "输入通道数必须能被groups整除"
        assert out_dim % groups == 0, "输出通道数必须能被groups整除"
        self.stride = stride
        self.padding = ((stride - 1) + dilation * (kernel_size - 1)) // 2
        self.dilation = dilation
        self.weight = nn.Parameter(torch.empty(out_dim, in_dim // groups, kernel_size, kernel_size))
        if bias:
            self.bias = nn.Parameter(torch.empty(out_dim))
        else:
            self.bias = None
        nn.init.kaiming_normal_(self.weight, mode='fan_out', nonlinearity='relu')
        if bias:
            self.bias = nn.Parameter(torch.zeros(out_dim))
        else:
            self.bias = None

        self.with_mask = with_mask
        self.param_generator = nn.Conv2d(in_dim, (3 if with_mask else 2) * offset_groups * kernel_size ** 2, 3, 1, 1)
        nn.init.constant_(self.param_generator.weight, 0.0)  # 关键初始化
        nn.init.constant_(self.param_generator.bias, 0.0)  # 初始无偏移

    def forward(self, x):
        if self.with_mask:
            oh, ow, mask = self.param_generator(x).chunk(3, dim=1)
            offset = torch.cat([oh, ow], dim=1)
            mask = mask.sigmoid()
        else:
            offset = self.param_generator(x)
            mask = None

        x = deform_conv2d(
            x,
            offset=offset,
            weight=self.weight,
            bias=self.bias,
            stride=self.stride,
            padding=self.padding,
            dilation=self.dilation,
            mask=mask,
        )
        return x


class MCCA(nn.Module):
    def __init__(self, in_channels, reduction_ratio=16):
        super().__init__()
        self.reduction = reduction_ratio
        mid_channels = max(8, in_channels // reduction_ratio)  # 保证最小通道数

        # 水平分支(Width方向)
        self.width_pool = nn.AdaptiveAvgPool2d((1, None))  # [N,C,H,W] -> [N,C,1,W]
        self.width_conv = nn.Sequential(
            nn.Conv2d(in_channels, mid_channels, 1),
            nn.BatchNorm2d(mid_channels),
            nn.ReLU(),
            nn.Conv2d(mid_channels, in_channels, 1),
            nn.Sigmoid()
        )

        # 垂直分支(Height方向)
        self.height_pool = nn.AdaptiveAvgPool2d((None, 1))  # [N,C,H,W] -> [N,C,H,1]
        self.height_conv = nn.Sequential(
            nn.Conv2d(in_channels, mid_channels, 1),
            nn.BatchNorm2d(mid_channels),
            nn.ReLU(),
            nn.Conv2d(mid_channels, in_channels, 1),
            nn.Sigmoid()
        )

        # 全局分支(Global Average Pooling)
        self.global_pool = nn.AdaptiveAvgPool2d(1)
        self.global_conv = nn.Sequential(
            nn.Conv2d(in_channels, mid_channels, 1),
            nn.BatchNorm2d(mid_channels),
            nn.ReLU(),
            nn.Conv2d(mid_channels, in_channels, 1),
            nn.Sigmoid()
        )

    def forward(self, x):
        # 水平注意力
        w_pool = self.width_pool(x)  # [N,C,1,W]
        w_attn = self.width_conv(w_pool)  # [N,C,1,W]

        # 垂直注意力
        h_pool = self.height_pool(x)  # [N,C,H,1]
        h_attn = self.height_conv(h_pool)  # [N,C,H,1]

        # 全局注意力
        g_pool = self.global_pool(x)  # [N,C,1,1]
        g_attn = self.global_conv(g_pool)  # [N,C,1,1]

        # 合成三维注意力
        combined_attn = w_attn * h_attn * g_attn

        # 应用注意力权重
        return x * combined_attn


class MCDC(nn.Module):
    def __init__(self, in_channels, out_channels, kernel_size=3):
        super().__init__()
        self.kernel_size = kernel_size

        # Main convolution parameters
        self.weight = nn.Parameter(torch.Tensor(out_channels, in_channels, kernel_size, kernel_size))

        # Offset and modulation generators
        self.offset_conv = nn.Conv2d(in_channels, 2 * kernel_size ** 2, kernel_size=3, padding=1)
        self.modulation_conv = nn.Conv2d(in_channels, kernel_size ** 2, kernel_size=3, padding=1)

        # MCCA module
        self.mcca = MCCA(in_channels)

        self.init_weights()

    def init_weights(self):
        nn.init.kaiming_uniform_(self.weight)
        nn.init.zeros_(self.offset_conv.weight)
        nn.init.zeros_(self.modulation_conv.weight)

    def forward(self, x):
        # Generate MCCA features
        x_attn = self.mcca(x)

        # Generate offsets and modulation
        offsets = self.offset_conv(x_attn)  # [N, 2*k*k, H, W]
        modulation = torch.sigmoid(self.modulation_conv(x_attn))  # [N, k*k, H, W]

        # Apply deformable convolution
        return deform_conv2d(
            input=x,
            offset=offsets,
            weight=self.weight,
            mask=modulation,
            padding=(self.kernel_size // 2, self.kernel_size // 2)
        )


class ChannelShuffle(nn.Module):
    def __init__(self, groups):
        super().__init__()
        self.groups = groups

    def forward(self, x):
        # 通道混洗实现
        batch_size, channels, height, width = x.size()
        channels_per_group = channels // self.groups
        x = x.view(batch_size, self.groups, channels_per_group, height, width)
        x = torch.transpose(x, 1, 2).contiguous()
        return x.view(batch_size, -1, height, width)


class LEFF(nn.Module):
    def __init__(self, in_channels):
        super().__init__()
        expanded_channels = in_channels * 4

        # 1x1卷积扩展通道
        self.conv1x1_expand = nn.Conv2d(in_channels, expanded_channels, kernel_size=1)

        # 深度卷积序列
        self.dw_conv3 = nn.Conv2d(expanded_channels, expanded_channels, kernel_size=3,
                                  padding=1, groups=expanded_channels)
        self.dw_conv5 = nn.Conv2d(expanded_channels, expanded_channels, kernel_size=5,
                                  padding=2, groups=expanded_channels)
        self.dw_conv3_2 = nn.Conv2d(expanded_channels, expanded_channels, kernel_size=3,
                                    padding=1, groups=expanded_channels)

        # 通道混洗
        self.shuffle1 = ChannelShuffle(groups=expanded_channels // 2)
        self.shuffle2 = ChannelShuffle(groups=expanded_channels // 2)

        # 最后的1x1卷积恢复通道
        self.conv1x1_reduce = nn.Conv2d(expanded_channels, in_channels, kernel_size=1)

    def forward(self, x):
        # Step 1: 1x1卷积扩展通道
        x_1 = self.conv1x1_expand(x)  # [b, 4c, h, w]
        # Step 2: 3x3深度卷积
        x_2 = self.dw_conv3(x_1)  # [b, 4c, h, w]
        # Step 3: 通道混洗
        x2_s = self.shuffle1(x_2)  # [b, 4c, h, w]
        # Step 4: 5x5深度卷积
        x_3 = self.dw_conv5(x2_s)  # [b, 4c, h, w]
        # Step 5: 残差连接
        x_4 = x_3 + x_2  # [b, 4c, h, w]
        # Step 6: 通道混洗
        x4_s = self.shuffle2(x_4)  # [b, 4c, h, w]
        # Step 7: 3x5深度卷积
        x_5 = self.dw_conv3_2(x4_s)  # [b, 4c, h, w]
        # Step 8: 残差连接
        x_6 = x_5 + x_2  # [b, 4c, h, w]
        # Step 9: 恢复通道
        output = self.conv1x1_reduce(x_6)  # [b, c, h, w]

        return output


class DynamicConv(nn.Module):
    def __init__(self, in_ch, out_ch, dc_groups=3, offset_groups=3, kernel_list=[1, 3, 5], with_mask=True):
        super().__init__()
        self.num_convs = len(kernel_list)
        self.dc_groups = dc_groups
        self.offset_groups = offset_groups
        # 路由网络保持不变
        self.router = nn.Sequential(
            nn.AdaptiveAvgPool2d(1),
            nn.Conv2d(in_ch, self.num_convs, 1),
            nn.Softmax(dim=1)
        )
        self.with_mask = with_mask
        # 使用可变形卷积块替代普通卷积
        self.convs = nn.ModuleList([
            # nn.Conv2d(in_ch, out_ch, k, padding=k // 2)
            # MCDC(in_ch, out_ch, k)
            MCDC(in_ch, out_ch)
            # DeformableConv2d(in_dim=in_ch, out_dim=out_ch, kernel_size=k, groups=self.dc_groups,
            #                  offset_groups=self.offset_groups, with_mask=self.with_mask)
            for k in kernel_list
        ])

    def forward(self, x):
        B, _, H, W = x.shape
        weights = self.router(x).squeeze(-1).squeeze(-1)

        output = 0
        for i, conv in enumerate(self.convs):
            weight = weights[:, i].view(B, 1, 1, 1)  # 权重调整维度
            output += weight * conv(x)  # 加权求和

        return output


class Res_CBAM_block(nn.Module):
    def __init__(self, in_channels, out_channels, stride=1, dc_groups=4, offset_groups=4, kernel_list=[1, 3, 5],
                 with_mask=True):
        super(Res_CBAM_block, self).__init__()
        self.kernel_list = kernel_list
        self.with_mask = with_mask
        self.dc_groups = dc_groups
        self.offset_groups = offset_groups
        # self.conv1 =MCDC(in_channels, out_channels)
        # self.conv1 = DeformableConv2d(in_dim=in_channels, out_dim=out_channels, kernel_size=kernel_size, groups=self.dc_groups,
        #                      offset_groups=self.offset_groups, with_mask=self.with_mask)
        self.conv1 = DynamicConv(in_channels, out_channels, dc_groups=self.dc_groups, offset_groups=self.offset_groups,
                                 kernel_list=self.kernel_list, with_mask=with_mask)
        # self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, padding=1)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)
        # self.conv2 = MCDC(out_channels, out_channels)
        # self.conv2 = DeformableConv2d(in_dim=out_channels, out_dim=out_channels, kernel_size=kernel_size,
        #                               groups=self.dc_groups,
        #                               offset_groups=self.offset_groups, with_mask=self.with_mask)
        self.conv2 = DynamicConv(out_channels, out_channels, dc_groups=self.dc_groups, offset_groups=self.offset_groups,
                                 kernel_list=self.kernel_list, with_mask=with_mask)
        # self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1)
        self.bn2 = nn.BatchNorm2d(out_channels)
        if stride != 1 or out_channels != in_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride),
                nn.BatchNorm2d(out_channels))
        else:
            self.shortcut = None

        self.ca = ChannelAttention(out_channels)
        self.sa = SpatialAttention()

    def forward(self, x):
        residual = x
        if self.shortcut is not None:
            residual = self.shortcut(x)
        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)
        out = self.conv2(out)
        out = self.bn2(out)
        out = self.ca(out) * out
        out = self.sa(out) * out
        out += residual
        out = self.relu(out)
        return out


class Res_CBAM_block_org(nn.Module):
    def __init__(self, in_channels, out_channels, stride=1):
        super().__init__()
        self.conv1 = nn.Conv2d(in_channels, out_channels, kernel_size=3, stride=stride, padding=1)
        self.bn1 = nn.BatchNorm2d(out_channels)
        self.relu = nn.ReLU(inplace=True)
        self.conv2 = nn.Conv2d(out_channels, out_channels, kernel_size=3, padding=1)
        self.bn2 = nn.BatchNorm2d(out_channels)
        if stride != 1 or out_channels != in_channels:
            self.shortcut = nn.Sequential(
                nn.Conv2d(in_channels, out_channels, kernel_size=1, stride=stride),
                nn.BatchNorm2d(out_channels))
        else:
            self.shortcut = None

        self.ca = ChannelAttention(out_channels)
        self.sa = SpatialAttention()

    def forward(self, x):
        residual = x
        if self.shortcut is not None:
            residual = self.shortcut(x)
        out = self.conv1(x)
        out = self.bn1(out)
        out = self.relu(out)
        out = self.conv2(out)
        out = self.bn2(out)
        out = self.ca(out) * out
        out = self.sa(out) * out
        out += residual
        out = self.relu(out)
        return out


class UNet_dynamicDCNv2Block_MCCA_LEFF(nn.Module):
    def __init__(self, num_classes, input_channels, block, num_blocks, nb_filter, deep_supervision=True):
        super().__init__()
        self.relu = nn.ReLU(inplace=True)
        self.deep_supervision = deep_supervision
        self.pool = nn.MaxPool2d(2, 2)
        self.up = nn.Upsample(scale_factor=2, mode='bilinear', align_corners=True)
        self.down = nn.Upsample(scale_factor=0.5, mode='bilinear', align_corners=True)

        self.up_4 = nn.Upsample(scale_factor=4, mode='bilinear', align_corners=True)
        self.up_8 = nn.Upsample(scale_factor=8, mode='bilinear', align_corners=True)
        self.up_16 = nn.Upsample(scale_factor=16, mode='bilinear', align_corners=True)

        self.conv0_0 = self._make_layer_org(Res_CBAM_block_org, input_channels, nb_filter[0])
        self.conv1_0 = self._make_layer(block, nb_filter[0], nb_filter[1], num_blocks[0])
        self.conv2_0 = self._make_layer(block, nb_filter[1], nb_filter[2], num_blocks[1])
        self.conv3_0 = self._make_layer(block, nb_filter[2], nb_filter[3], num_blocks[2])
        self.conv4_0 = self._make_layer(block, nb_filter[3], nb_filter[4], num_blocks[3])

        self.leff = LEFF(nb_filter[4])

        self.conv3_1 = self._make_layer(block, nb_filter[3] + nb_filter[4], nb_filter[3], num_blocks[2])
        self.conv2_2 = self._make_layer(block, nb_filter[2] + nb_filter[3], nb_filter[2], num_blocks[1])
        self.conv1_3 = self._make_layer(block, nb_filter[1] + nb_filter[2], nb_filter[1], num_blocks[0])
        self.conv0_4 = self._make_layer(block, nb_filter[0] + nb_filter[1], nb_filter[0])

        self.conv0_4_final = self._make_layer(block, nb_filter[0] * 5, nb_filter[0])

        self.conv0_4_1x1 = nn.Conv2d(nb_filter[4], nb_filter[0], kernel_size=1, stride=1)
        self.conv0_3_1x1 = nn.Conv2d(nb_filter[3], nb_filter[0], kernel_size=1, stride=1)
        self.conv0_2_1x1 = nn.Conv2d(nb_filter[2], nb_filter[0], kernel_size=1, stride=1)
        self.conv0_1_1x1 = nn.Conv2d(nb_filter[1], nb_filter[0], kernel_size=1, stride=1)
        if self.deep_supervision:
            self.final1 = nn.Conv2d(nb_filter[3], num_classes, kernel_size=1)
            self.final2 = nn.Conv2d(nb_filter[2], num_classes, kernel_size=1)
            self.final3 = nn.Conv2d(nb_filter[1], num_classes, kernel_size=1)
            self.final4 = nn.Conv2d(nb_filter[0], num_classes, kernel_size=1)
        else:
            self.final = nn.Conv2d(nb_filter[0], num_classes, kernel_size=1)

    def _make_layer(self, block, input_channels, output_channels, num_blocks=1, dc_groups=4, offset_groups=4):
        layers = []
        layers.append(block(input_channels, output_channels, dc_groups=dc_groups, offset_groups=offset_groups))
        for i in range(num_blocks - 1):
            layers.append(block(output_channels, output_channels, dc_groups=dc_groups, offset_groups=offset_groups))
        return nn.Sequential(*layers)

    def _make_layer_org(self, block, input_channels, output_channels, num_blocks=1):
        layers = []
        layers.append(block(input_channels, output_channels))
        for i in range(num_blocks - 1):
            layers.append(block(output_channels, output_channels))
        return nn.Sequential(*layers)

    def forward(self, input):
        # 还差把input_x与最后的结果相加,然后输出结果
        x0_0 = self.conv0_0(input)
        x1_0 = self.conv1_0(self.pool(x0_0))
        x2_0 = self.conv2_0(self.pool(x1_0))
        x3_0 = self.conv3_0(self.pool(x2_0))
        x4_0 = self.conv4_0(self.pool(x3_0))

        x4_0 = self.leff(x4_0)

        x3_1 = self.conv3_1(torch.cat([x3_0, self.up(x4_0)], 1))
        x2_2 = self.conv2_2(torch.cat([x2_0, self.up(x3_1)], 1))
        x1_3 = self.conv1_3(torch.cat([x1_0, self.up(x2_2)], 1))
        x0_4 = self.conv0_4(torch.cat([x0_0, self.up(x1_3)], 1))

        Final_x0_4 = self.conv0_4_final(
            torch.cat([self.up_16(self.conv0_4_1x1(x4_0)), self.up_8(self.conv0_3_1x1(x3_1)),
                       self.up_4(self.conv0_2_1x1(x2_2)), self.up(self.conv0_1_1x1(x1_3)), x0_4], 1))

        if self.deep_supervision:
            output1 = self.up_8(self.final1(x3_1))
            output2 = self.up_4(self.final2(x2_2))
            output3 = self.up(self.final3(x1_3))
            output4 = self.final4(Final_x0_4)
            return [output1, output2, output3, output4]
        else:
            output = self.final(Final_x0_4)
            return output


if __name__ == "__main__":
    inp = torch.ones((2, 1, 256, 256)).cuda()
    deep_supervision = "True"
    if deep_supervision == "True":
        model = UNet_dynamicDCNv2Block_MCCA_LEFF(1, 1, Res_CBAM_block, [2, 2, 2, 2], [16, 32, 64, 128, 256],
                                                 True).cuda()
        [output1, output2, output3, output4] = model(inp)
        print("output1", output1.shape)
        print("output2", output2.shape)
        print("output3", output3.shape)
        print("output4", output4.shape)
        '''
        output1 torch.Size([2, 1, 256, 256])
        output2 torch.Size([2, 1, 256, 256])
        output3 torch.Size([2, 1, 256, 256])
        output4 torch.Size([2, 1, 256, 256])
        '''
    else:
        model = UNet_dynamicDCNv2Block_MCCA_LEFF(1, 1, Res_CBAM_block, [2, 2, 2, 2], [16, 32, 64, 128, 256],
                                                 False).cuda()
        out = model(inp)
        print("out", out.shape)
二、研究背景和意义
2.1 红外小目标:一个"先天不足"的检测难题
红外热成像(ITI)通过红外探测器捕捉目标热辐射成像。由于红外波长超过可见光,能有效穿透雾、烟等大气障碍,在恶劣天气下具备可见光难以比拟的探测优势;凭借热辐射特征,目标识别得以突破视觉限制。依托全天候工作能力,IRSTD 在军用(作战交战与防御系统)与民用(智能交通管理、农业监测、水下侦察)领域均有重要价值。
但红外小目标天生带有三大"缺陷":
特性 | 含义 |
|---|---|
低显著性 | 背景噪声与杂波频繁掩盖目标,真伪难辨 |
像素占比极小 | 远距离成像导致目标通常仅 1–10 像素(SPIE 正式定义为不超过 9×9 像素) |
形状多变 | 目标形态随类型与环境波动,缺乏稳定形状先验 |
与汽车、人脸等具有丰富几何结构和纹理的普通目标不同,红外小目标往往呈现为点状斑块,几乎没有可利用的形状信息。
2.2 现有方法的瓶颈:固定卷积核的"原罪"
传统图像处理方法各有所长但各有硬伤:
- 滤波类(Top-hat、max-median/max-mean):只能抑制简单背景杂波,复杂场景性能急剧退化,虚警率高;
- 人眼视觉建模类:对高亮小目标敏感,但目标与背景相似时难以区分;
- 低秩矩阵类:能适应暗弱小目标,但复杂背景中形状多变的目标仍导致高虚警;
- 共同短板:严重依赖手工特征,难例表现不佳。
深度学习时代,CNN 成为主流,U 形架构(U-Net)显著提升了复杂背景下的鲁棒性,特征融合模块被用于弥合"低层细节 vs 高层语义"的断层,CNN-Transformer 混合模型则试图补足 CNN 全局上下文不足的短板。然而这些方法存在一个共同的"原罪":全部依赖固定网格卷积核。当目标尺寸小于卷积核(subkernel scale)时,3×3 感受野内绝大多数采样点落在背景上,卷积响应被背景主导,弱目标信号被噪声淹没——性能瓶颈不在后处理,而在特征提取的第一步。
2.3 研究意义
EDDNet 的价值不止于刷榜:它把引入可变形卷积的动机从"处理几何变换"重新定义为"在乘法操作前先做一次空间注意力,从物理上过滤背景杂波",实现了从"事后滤波"到"源头抑制"的范式转变。这对算力受限的机载/边端红外探测系统尤其有意义——不依赖 Transformer 即可获得对点状目标的定位先验。
三、创新点
- EDDNet 整体架构:克服传统固定卷积核在特征提取中引入背景噪声的问题,并通过输入依赖的动态卷积核尺寸适配不同大小的小目标;
- DAOE 模块:通过单向池化定位小目标边界,约束可变形卷积采样点的偏移自由度,使其向小目标收敛;
- SR 模块:在编码到解码的过渡阶段,将深层语义信息重新聚焦到小目标上。
四、创新点解读
4.1 问题本质:卷积核比目标还大
承接背景部分:当目标小于 3×3 卷积核时,固定网格的 9 个采样点中大部分落在背景上,微弱目标信号被背景噪声淹没,卷积响应被背景主导。
作者特别指出:引入可变形卷积的动机不是处理旋转、缩放等几何变换,而是自适应地把采样点聚集到稀疏的目标区域——相当于在乘法累加之前先做一次"空间注意力",从物理上过滤背景杂波,实现"从源头抑制"而非"事后滤波"。
4.2 增强动态可变形卷积(EDDConv)
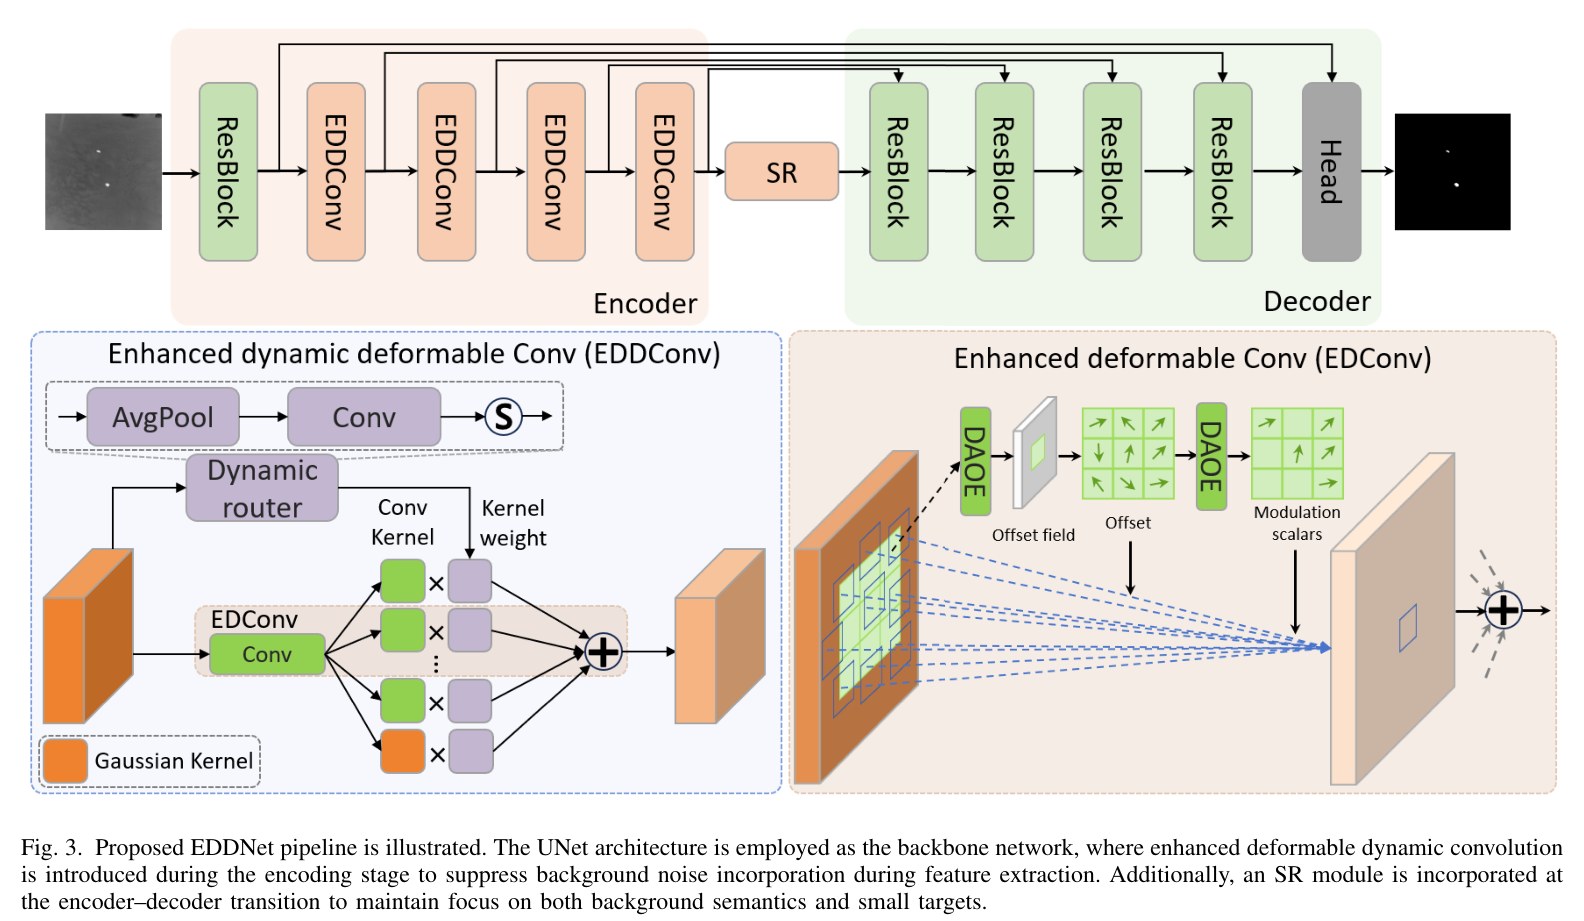
EDDNet整体架构
输入先经 ResBlock 将通道扩展到 C=16,随后编码器由 5 级 EDDConv 下采样构成。每一级 EDDConv 包含两条分支:
- 动态路由:
MaxPool → Conv2d → Sigmoid生成路径权重 W_d,按输入特征动态调节各核尺寸的贡献; - 多尺度采样:核尺寸配置为 {1, 3, 5}(小目标平均约 50 像素,故刻意避开更大核,防止引入背景噪声与额外延迟),另加一路可学习高斯核(对点状目标有增强作用);
- 输出为
cat(Fx1, Fx3, Fx5, Fg) × W_d,即"多尺度特征拼接后按输入动态加权"。
4.3 DAOE 模块:给 offset 装上"导航仪"
标准可变形卷积在亚像素目标上容易"offset 失灵"(学到的偏移紊乱)。DAOE 的核心思路是约束 offset 的自由度:
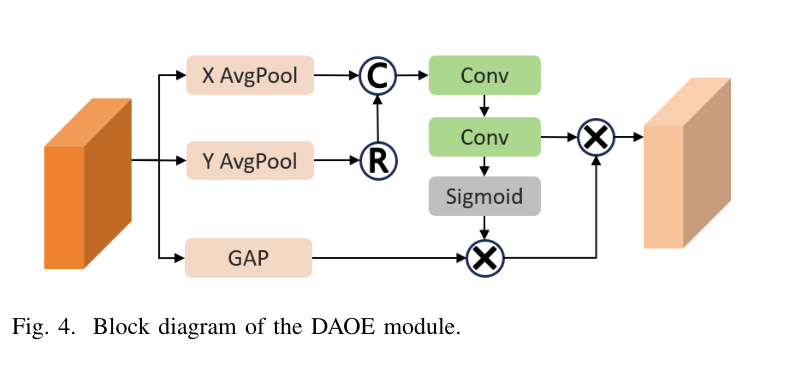
DAOE模块
沿 x 方向、y 方向分别做 MaxPool,再做全局 MaxPool。关键在于:全局池化会丢失空间坐标,而 MaxPool_x 与 MaxPool_y 分别保留水平/垂直轴上的峰值响应位置,二者拼接相当于一个显式的空间坐标系,提供几何先验,引导可学习偏移 Δb_n 收敛到 x/y 峰值的交点——即目标中心,从而让卷积核物理"收缩"以贴合极小目标。此外,每个采样点引入调制因子 M(b_n),对错误 offset 的影响逐点增强或抑制:
y(b₀) = Σ M(b_n) · w(b_n) · x(b₀ + b_n + Δb_n)
4.4 SR 模块:编码—解码之间的语义接力
SR模块
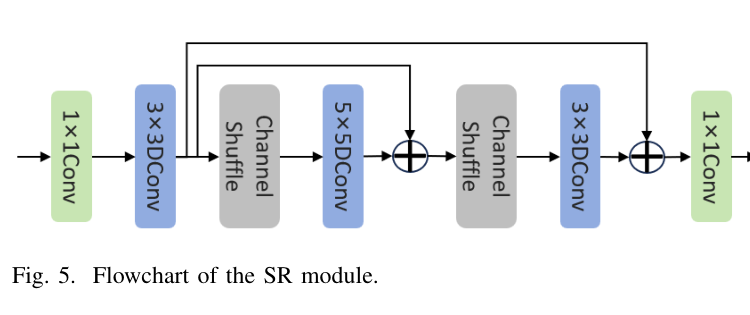
编码阶段已滤除大部分背景噪声后,SR 模块部署在特征图分辨率最低的瓶颈处:由不同扩张率的深度可分离卷积(3×3、5×5)+ 通道混洗(Channel Shuffle) 级联而成,首尾以 1×1 卷积调整通道并带残差连接。扩张感受野有助于抑制目标周边残余噪声而不引入新背景;通道混洗促进编码器到解码器的特征过渡,增强泛化能力。
五、实验结果
5.1 实验设置
数据集 | 数量 | 划分 | 输入尺寸 |
|---|---|---|---|
NUAA-SIRST | 427 | 50:50 | 256×256 |
NUDT-SIRST | 1327 | 50:50 | 256×256 |
IRSTD-1K | 1000 | 80:20 | 512×512 |
WideIRSTD-Full | — | 82% 训练 | — |
评价指标为 IoU、nIoU(归一化 IoU,小目标分割专用)、Pd(检测率)与 Fa(虚警率,×10⁻⁶)。训练平台为 RTX 3090,PyTorch 实现,Xavier 初始化,Adagrad 优化器 + SoftIoU 损失,学习率 0.05,从零训练。对比方法涵盖 10 个 SOTA:ACM、ALCNet、DNA-Net、ISNet、UIU-Net、PBT、MRF-Net、RRCANet、FMNet、SCTransNet。
5.2 主实验(Table I 精选,单位 %)
方法 | NUAA IoU | NUAA nIoU | NUDT IoU | NUDT nIoU | IRSTD-1K IoU | IRSTD-1K Pd | WideIRSTD IoU | WideIRSTD nIoU |
|---|---|---|---|---|---|---|---|---|
DNA-Net | 74.815 | 72.571 | 94.192 | 91.366 | 65.735 | 89.562 | 45.991 | 32.834 |
PBT | 76.737 | 74.435 | 91.419 | 88.676 | 68.439 | 94.205 | 41.046 | 29.701 |
MRF-Net | 77.928 | 75.590 | 94.221 | 91.394 | 67.014 | 94.657 | 44.516 | 31.850 |
EDDNet | 79.289 | 76.910 | 94.762 | 91.919 | 68.564 | 94.913 | 46.533 | 33.426 |
- NUAA-SIRST:IoU / nIoU 超次优 MRF-Net 1.37 / 1.32 个点;Pd 96.591% 仅比最高的 FMNet(96.958%)低 0.36 个点;Fa 15.897×10⁻⁶。
- NUDT-SIRST:IoU / nIoU 超 MRF-Net 0.54 / 0.52 个点;Pd 99.361%,仅低于 DNA-Net 0.1 个点;Fa 3.913×10⁻⁶。
- IRSTD-1K:IoU 68.564% 超 PBT 0.125 个点;nIoU 66.507% 略低于 PBT 的 67.841%,但 Pd(94.913%)与 Fa(16.154×10⁻⁶)双优。
- WideIRSTD-Full(大规模最难场景):IoU / nIoU 全场最高,但 Pd(57.360%)低于 SCTransNet(59.435%),Fa(59.883×10⁻⁶)明显差于 UIU-Net(20.088×10⁻⁶)——虚警控制仍是短板。
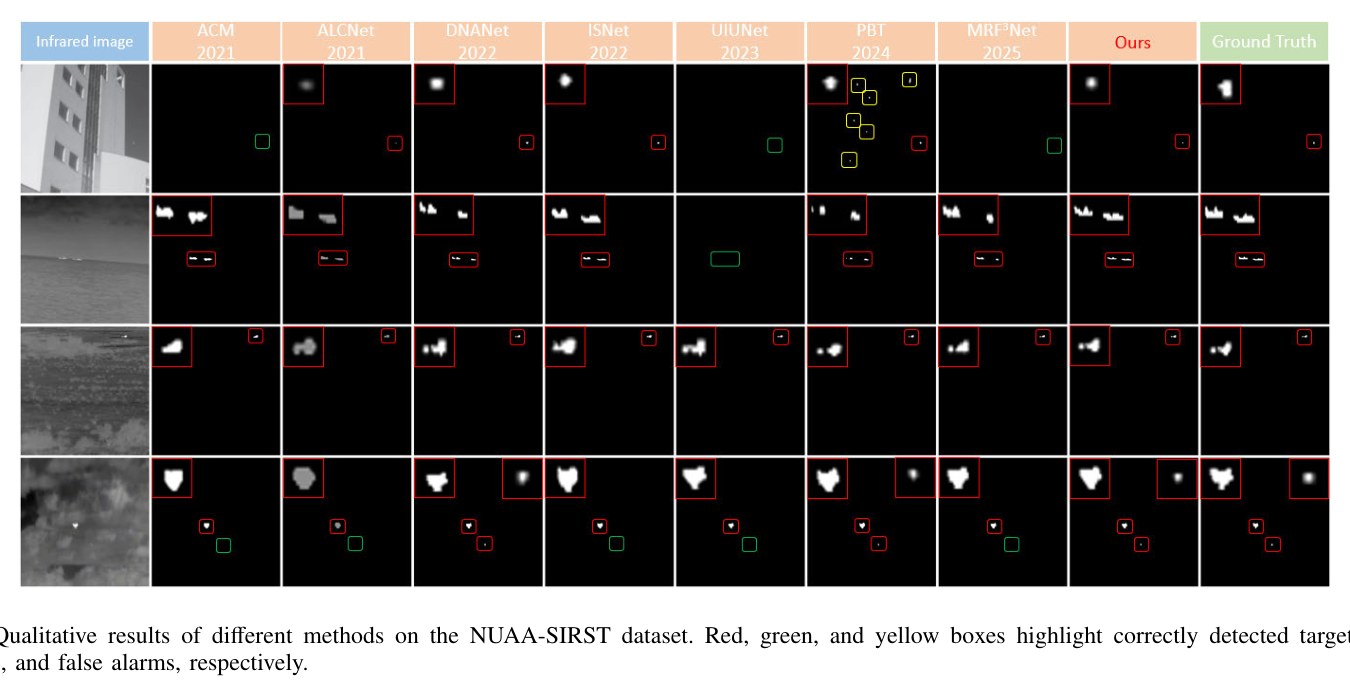
定性结果(Fig. 6)显示,EDDNet 的定位更准、轮廓更完整、漏检(绿框)与虚警(黄框)更少:
定性对比
5.3 消融实验(Table II,NUAA-SIRST)
变体 | 参数量 | FLOPs | IoU | nIoU | Pd | Fa |
|---|---|---|---|---|---|---|
baseline (ResNet18) | 4.086M | 7.041G | 75.910 | 73.961 | 95.198 | 22.707 |
+ 动态路由 | 15.444M | 25.381G | 77.385 | 75.063 | 95.991 | 17.835 |
+ 可变形卷积(无约束) | 2.491M | 14.884G | 76.984 | 74.674 | 95.674 | 18.894 |
+ DAOE | 3.221M | 15.082G | 78.917 | 76.549 | 96.417 | 17.045 |
+ SR(完整版) | 3.794M | 15.228G | 79.289 | 76.910 | 96.591 | 15.897 |
三个关键读数:
- 动态路由按输入自适应调配多尺度核权重,IoU +1.47;
- 裸的可变形卷积反而掉点(76.984%,低于动态路由变体 77.385%)——无约束的 offset 在亚像素目标上会紊乱,恰好反衬 DAOE 的必要性;
- DAOE 是全文最大的单模块增益:IoU 从 76.98% 拉至 78.91%(+1.93);SR 再补 0.37 个点,并把 Fa 压到最低 15.897×10⁻⁶。
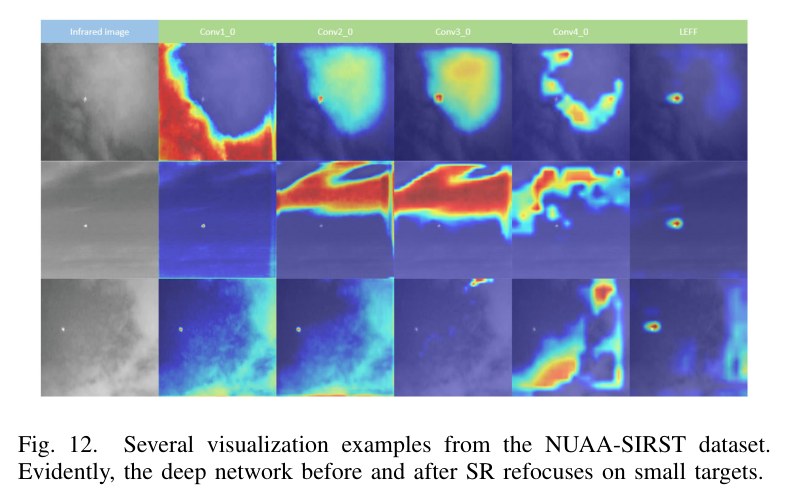
特征热力图(Fig. 12)进一步显示:加入 SR 前后,深层网络对小目标邻域的关注显著增强,背景响应被持续抑制:
特征热力图
六、展望
论文自述的局限与未来方向:
- 速度代价:动态 offset 计算不可避免增加计算复杂度,相比静态卷积推理速度略有下降(完整版 15.228G FLOPs,约为 baseline 的 2.2 倍);
- 极端杂波虚警:在与目标特征相似的高强度杂波场景中,仍可能出现少量虚警;
- 后续将聚焦模型轻量化与语义约束的进一步探索。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号