Token(词元)经济爆发:大量内容沦为数字泔水,AI 不会引用
原创
Token(词元)经济爆发:大量内容沦为数字泔水,AI 不会引用
原创
玫瑰互动RoseMarketing
发布于 2026-10-22 15:13:03
发布于 2026-10-22 15:13:03
词元经济说白了是AI内容第一次有了标准计量单位——以前按人天、千字算,现在按词元算。对高端月子中心这样的高客单本地门店,变化很直接:AI只引「高质量词元」,低质的就是那本书里说的「数字泔水」。这篇讲门店怎么理解这件事——质量系数没法省,内容资产比内容数量更值钱。先说结论——与其追便宜词元,不如让每一篇内容都经得起AI当高质量词元引用。
目录
- 一、高客单门店的新困惑:内容发了不少,AI不引
- 二、Token三次身份:门店只需要记住最后一次
- 三、三个改变里,门店最该看第三个
- 四、质量系数:门店内容的三问
- 五、三道坎里,门店躲开第一道就够
- 六、收束:让每篇内容都经得起引用
先给结论:词元经济给AI内容第一次发了标尺,但量的是「用了多少」,还没量清「好在哪」——门店与其追便宜词元,不如让每一篇内容都经得起AI当高质量词元引用。
高客单门店的新困惑:内容发了不少,AI不引
高端月子中心是高客单决策:一套月子套餐动辄十几万,家庭挑中心要看资质、比照护团队、问餐食和售后,平均要问好几轮才到店参观。2026年3月国家数据局给Token定了中文名「词元」,10月《一本书读懂词元经济》又在金融街论坛发布——词元经济摆上了台面。新困惑跟着来:门店内容发了不少,公众号、小红书、官网都有,AI问答里就是不引你。答案不在数量里,在质量里——AI只引高质量词元,低质的就是数字泔水。
Token三次身份:门店只需要记住最后一次
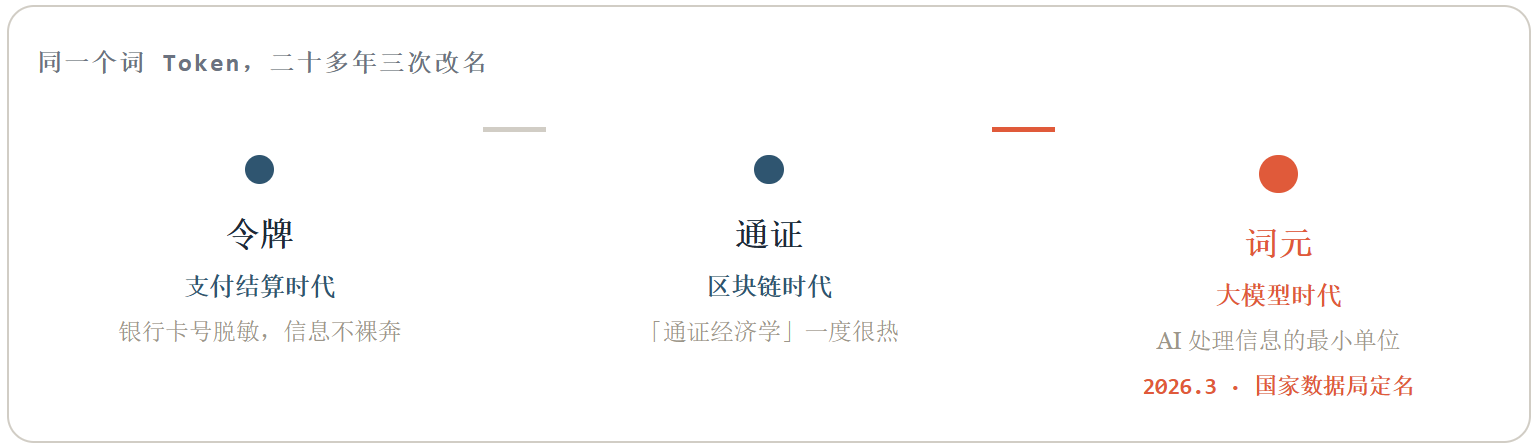
一个词Token二十多年换了三次身份:支付结算时代叫「令牌」,脱敏银行卡号;区块链时代叫「通证」,一度通证经济学吵得很热;大模型时代叫「词元」——大模型处理信息的最小单位。门店不需要懂前两次,只需要记住最后一次:词元让「智力」第一次有了标准化的计量单位,像电力行业的千瓦时。过去内容按篇算、按字算,算的是「发了多少」;现在按词元算,算的是「交付了多少脑力」——但注意,电是同质的,一度就是一度;不同内容产出的词元,智能密度差得远。
三个改变里,门店最该看第三个
词元经济有三个实打实的变化:智力第一次有了标尺;Agent让词元从陪聊跳到业务;计价开始从「用了多少」转向「做成了什么」。门店最该看第三个——同样一百万词元,闲聊值不到一美元,做法律审阅可能值上千美元,差出上千倍。落到内容上:一篇「月子中心怎么选」的科普,如果只是拼凑常识,AI当数字泔水过滤掉;如果资质可查、团队履历可核实、餐食单可追溯,AI才敢引。质量系数这把尺,省不掉。
质量系数:门店内容的三问
序言里有个刺眼的词——「数字泔水」:低质词元堆得再多,也是数字泔水;词元能计量「用了多少」,但计量不了「好在哪」。门店内容过三问就够了:①信息可核实吗——资质、团队履历、真实案例(脱敏后)有没有可查证的出处;②机器读得懂吗——结构化了吗,还是大段堆砌的营销话术;③任务真成了吗——这篇是解答了「怎么挑月子中心」,还是陪聊凑数。三问都过,才是经得起AI当高质量词元引用的内容。
{
  "content_audit": {
    "name": "月子中心内容质量系数三问(高质量词元判定)",
    "principle": "AI只引高质量词元, 低质的就是数字泔水; 质量系数这把尺省不掉",
    "three_questions": [
      {"q": "信息可核实吗", "check": "资质/团队履历/真实案例(脱敏后)有可查证出处", "weight": "高"},
      {"q": "机器读得懂吗", "check": "结构化呈现, 非大段营销话术堆砌", "weight": "中"},
      {"q": "任务真成了吗", "check": "真解答了怎么挑月子中心, 还是陪聊凑数", "weight": "高"}
    ],
    "slop_signals": ["拼凑常识无出处", "营销话术堆砌", "数量导向凑更新"],
    "note": "100万词元闲聊值不到1美元, 法律审阅可能值上千美元; 计价正从用了多少转向做成了什么"
  }
}# 内容词元价值对比:用了多少 vs 做成了什么
# 口径:标尺从供给侧成本挪到需求侧价值; AI只引高质量词元
CONTENT_TYPES = {
"拼凑常识稿": {"token_cost": 1000000, "value_usd": 0.8, "ai_cites": False}, # 闲聊级, 数字泔水
"资质可查科普": {"token_cost": 1000000, "value_usd": 950, "ai_cites": True}, # 审阅级, 高质量词元
}
def per_token_value(item):
# 每词元产出价值: 别盯花了多少词元, 盯每一单位词元产出多少价值
return round(item["value_usd"] / (item["token_cost"] / 1000000), 2)
if __name__ == "__main__":
for name, item in CONTENT_TYPES.items():
ptv = per_token_value(item)
cites = "AI可引用" if item["ai_cites"] else "数字泔水, AI过滤"
print(f"{name}: 每百万词元产出价值约{item['value_usd']}美元, 单万词元约{ptv}美元 -> {cites}")
print("口径: 同样100万词元, 价差上千倍; 用户付的却是同一档单价(按词元数量计费的毛病)")
print("口径: 与其追便宜词元, 不如让每一篇内容都经得起AI当高质量词元引用")三道坎里,门店躲开第一道就够
词元经济还有三道坎:质量系数没法省;「免费+广告」搬过来不成立——每次推理都在真金白银烧算力,规模越大亏得越多;中国价格战——主流模型API标价只有美国同类的一到两成甚至更低。门店躲不开价格战的大环境,但第一道坎自己能躲:别贪便宜词元。市面上低价AI稿批量制造的就是数字泔水——看着产量大,AI一篇不引。省下的那点稿费,还不够赔上被AI过滤掉的机会成本。
收束:让每篇内容都经得起引用
回到开头那个困惑:内容发了不少,AI不引——因为账算的是数量,不是质量。词元经济给AI内容第一次发了「标尺」,但它量的是「用了多少」,还没量清「好在哪」。对门店只有一句实话:与其追便宜词元,不如让每一篇内容都经得起AI当高质量词元引用——资质可查、结构清晰、真能解答决策疑问,这才是能被AI推荐的真门票。
回到那句话:AI只引高质量词元,低质的就是数字泔水——与其追便宜词元,不如让每一篇内容都经得起AI当高质量词元引用;质量系数这把尺,省不掉。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号