把排污口看到的异常,翻译成能进卷的话:一个基层执法人员的 1024 造物
原创
把排污口看到的异常,翻译成能进卷的话:一个基层执法人员的 1024 造物
原创
用户12785816
修改于 2026-10-22 16:17:03
修改于 2026-10-22 16:17:03
现场检查最耗时的从来不是"查",而是"翻译"——把眼睛看到的异常,翻译成法条、幅度和能被法制审核退不回来的记录。这篇讲讲我为什么在 1024 这天做了个小工具,以及它是怎么被做出来的。
一、真正的瓶颈不在"查不到法条"
做基层生态环境执法,谁都能背出几条常用罚则。真正卡住人的,是下面这种时刻:
你站在一家企业的污水处理站旁边。调节池边上有一根软管,一头插在池子里,另一头搭在围墙外的雨水沟上,管壁还是湿的,沟里有水痕。企业负责人说这是"临时抽水浇树"。
这个时候,脑子里同时要跑三个问题:
- 这算什么?是"私设暗管",还是"不正常运行污染防治设施",还是"通过逃避监管的方式排放污染物"?
- 该引哪一条?引错条,后面全废。
- 笔录里罚款幅度写多少?写低了被退,写高了被复议。
这三个问题,翻法条是翻不出来的。法条只告诉你"什么行为对应什么责任",它不会告诉你"软管搭在雨水沟上通常按哪一类定性"。这中间的落差,平时靠老同志带、靠翻旧案卷、靠打电话问。
二、三个卡点,正好对上三件事
我把平时最常卡的地方捋了一遍,归纳成三类,工具也就顺着这三类做:
卡点 | 现场长什么样 | 工具对应能力 |
|---|---|---|
定性难 | 软管接雨水沟、曝气池停运半个月、在线数据稳定 40 而手工测得 380 | 用自然语言描述现场,匹配出候选条款并排序 |
幅度难 | 知道该罚,但不知道落点在哪,重了轻了都麻烦 | 按法定从重/从轻情节做加权测算,给出计算过程 |
记录难 | 现场记得潦草,回办公室补不出来,法制审核退回重做 | 按场景逐项核对取证要点,并生成检查记录文本 |
这三件事其实是同一条链上的三个环节:定性 → 幅度 → 记录。现场做不完这条链,就得带着问题回办公室,第二天再来一趟。
三、技术选型:为什么是单文件纯前端
这个工具的第一约束不是"功能多",而是"能在现场用"。现场意味着:手机、可能没信号、不想装 App、不能登录、不能等加载。
所以定了三条:
- 单文件、无依赖、无构建。一个 index.html 打开就能用,扔到任何静态托管上都能跑。
- 全部计算在前端完成。没有后端,没有接口,断网也能用。
- 数据结构跟着法条走。条款不是写死在页面里的文字,而是一份结构化数据,页面只是它的一个视图。
条款匹配没有上模型。原因很实在:现场描述通常很短(十几个字),模型在这种输入上容易"过度发挥",而执法场景最怕的就是编条款。最后用的是最笨也最可控的办法:
- 把 52 条高频罚则拆成"行为要件关键词 + 实务语义词";
- 用 bigram 做基础相似度,保证中文短句也能命中;
- 再叠一层实务语境词表(比如"软管""雨水沟""暗管""稀释"这类只有干这行才会一起出现的词),给它们加权;
- 按总分排序,同时标注"是否必须移送公安"这类硬性标志。
笨办法的好处是:命中了哪几条、为什么命中,都能解释。执法场景里,"可解释"比"准"更重要——因为最终签字的是人,不是工具。
四、四个面板
打开就是速判。把现场情况用自己的话打进去,下面按相关度列出候选条款,点开能看要件和取证要点。
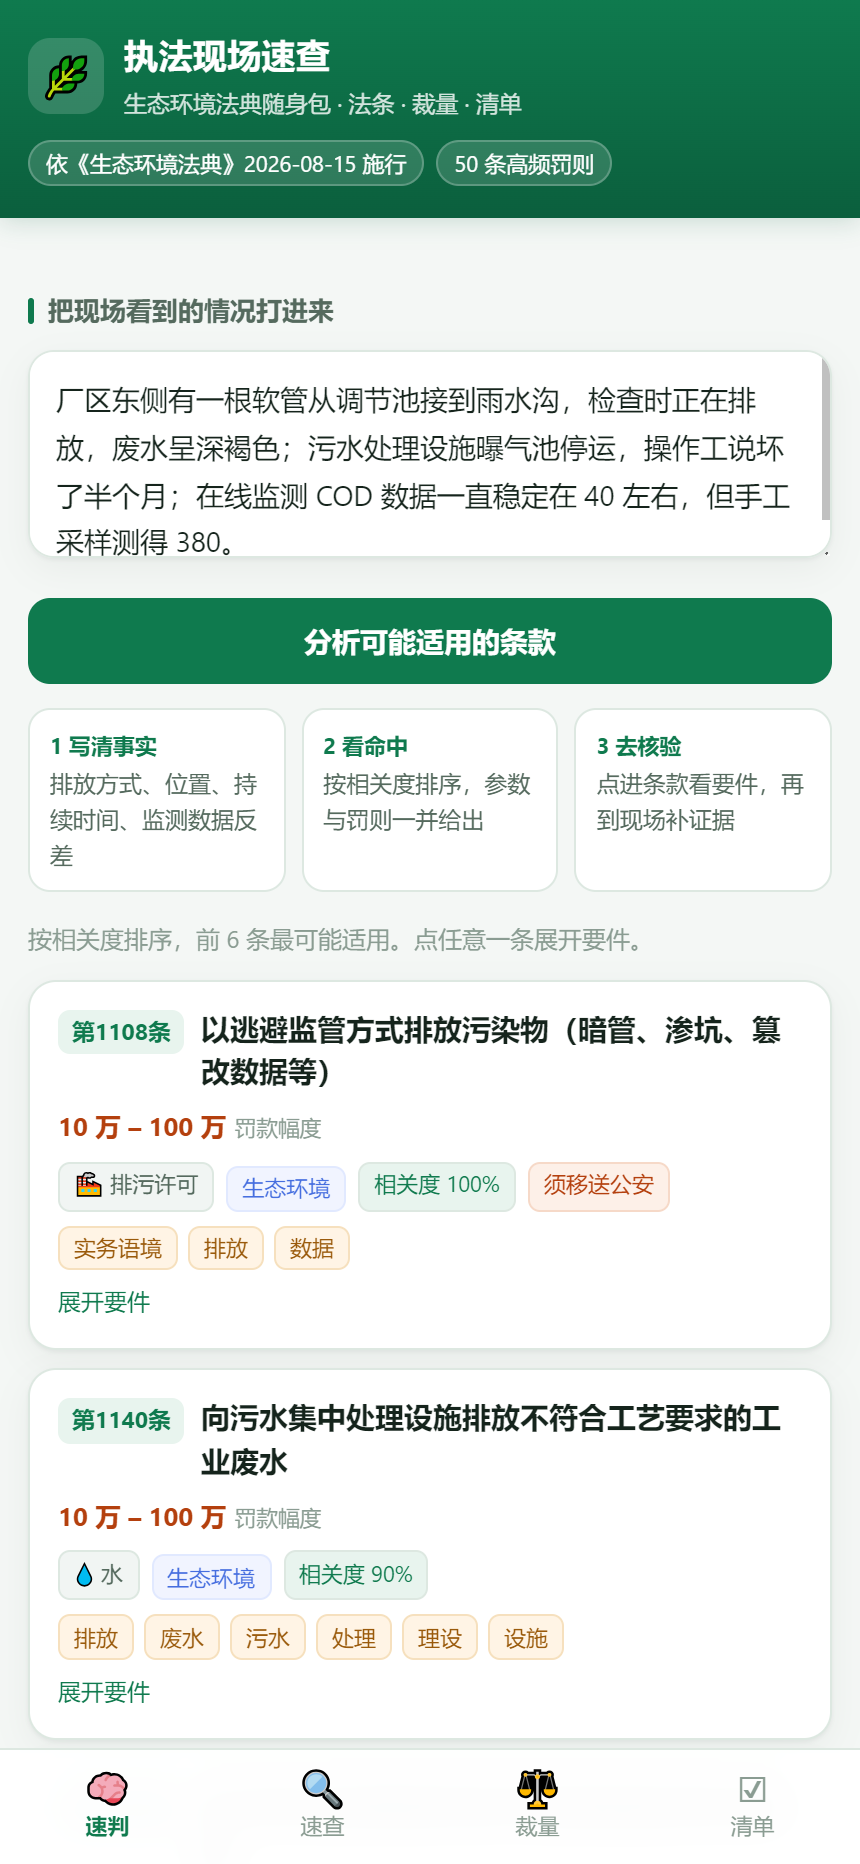
案情速判:自然语言描述现场,输出候选条款
第二个面板是速查,收录 52 条高频罚则,按违法行为分类,每条都带条号、罚款区间、处罚主体、是否移送公安。
第三个面板是裁量。选定条款后,勾选法定从重/从轻情节,右边实时算出建议落点,并把计算过程逐项列出来——这一步是给法制审核看的,算式摊开,比一个数字有说服力。
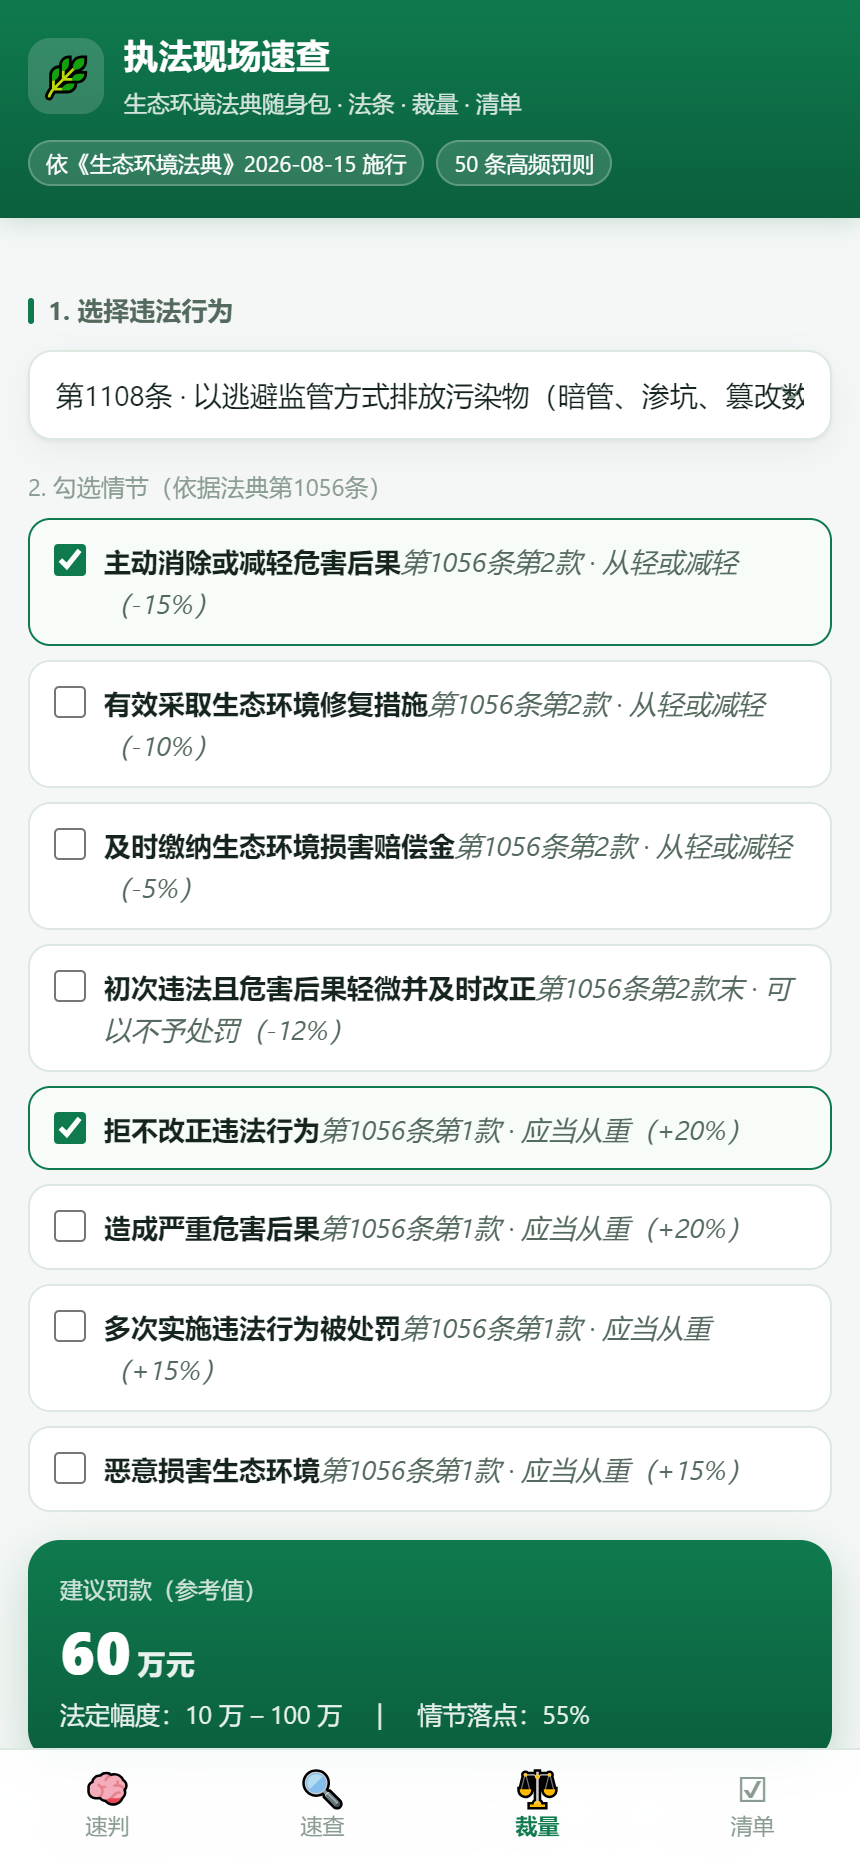
裁量测算:勾选情节,输出建议幅度与计算过程
裁量用的是加权模型:以法定幅度为基准区间,每个情节给一个权重系数,累加后映射回区间内。举个简化例子:
情节 | 方向 | 权重 |
|---|---|---|
主动改正、消除影响 | 从轻 | -0.15 |
首次违法且危害后果轻微 | 从轻 | -0.10 |
两年内因同类违法被处罚过 | 从重 | +0.20 |
在检查中伪造、篡改监测数据 | 从重 | +0.30 |
第四个面板是清单,按场景分六类:排污许可、自动监测、危险废物、废水、废气、扬尘工地。逐项打勾,缺项会标红,最后能一键生成一段检查记录文本,直接粘进笔录。
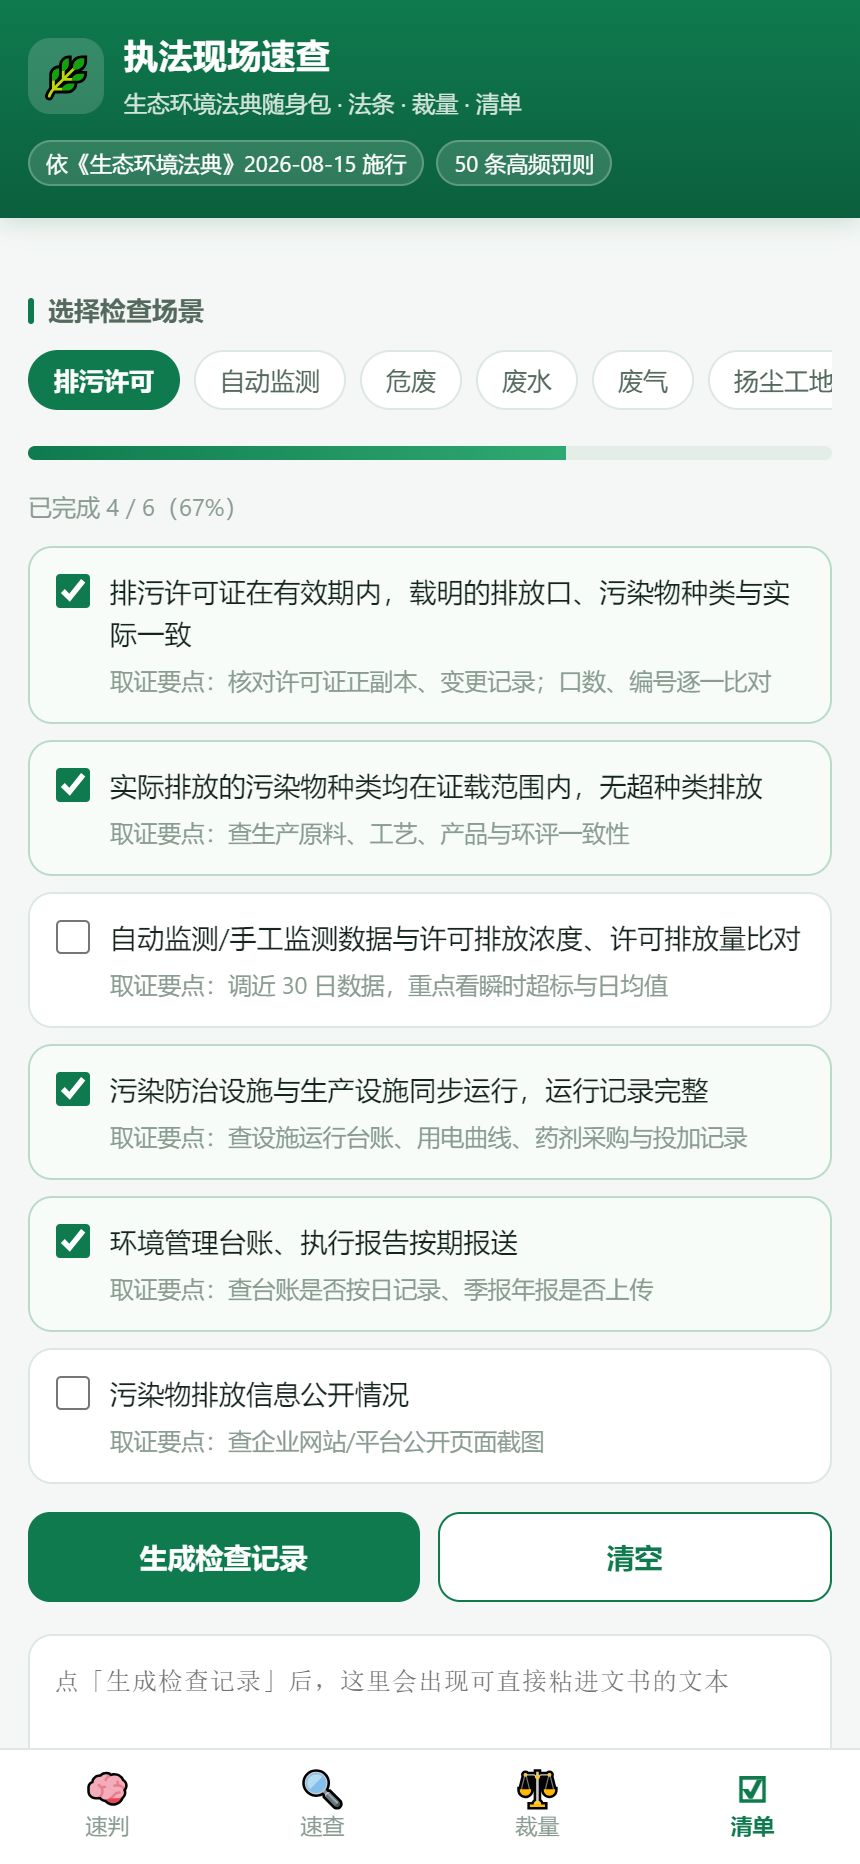
现场检查清单:按场景逐项核对,可导出记录文本
五、一个完整走查:那根软管从头到尾
把开头那个场景完整走一遍,能看清这条链是怎么闭合的。
第一步,描述现场。 在速判里输入:
调节池有一根软管接到围墙外雨水沟,管壁湿润,沟内有水痕,企业称临时抽水浇树。
工具返回三条候选,按相关度排序,第一条是"通过暗管、渗井、渗坑、灌注等逃避监管的方式排放水污染物",并标出"应移送公安机关"。第二条是不正常运行污染防治设施,第三条是排污口设置不规范。
这时候正确的做法不是直接采信第一条,而是点开看要件:暗管的核心要件是"隐蔽性"和"绕过法定排放口"。软管是否固定、是否埋设、是否有意规避监管,需要现场进一步取证。工具的排序只是提示方向,不是结论。
第二步,补取证。 切到清单面板,选"废水"场景,逐项核对。会提示你补:软管两端位置的照片、水流方向、企业排水许可的排放口位置、当日生产负荷、以及企业负责人的陈述笔录。缺哪项标红。
第三步,测幅度。 回到裁量面板,选定条款,勾选情节:现场配合检查(从轻)、无法提供排污许可(从重)。右侧给出建议落点,并把算式摊开:法定区间、基准值、各情节系数、最终落点。这段算式可以直接抄进调查报告的说理部分。
第四步,出记录。 清单底部一键生成检查记录文本,包含检查时间、检查部位、发现问题、取证情况、企业陈述。粘进笔录再按实际情况改,比从空白页开始写快得多,也不会漏要素。
四步下来,现场该做的判断和该留的证据都在手上,回办公室只需要整理,不需要"再跑一趟补材料"。
六、数据结构长什么样
条款不是写在页面里的文字,而是一份结构化数据。每条罚则大概长这样:
{
  "id": "w-001",
  "law": "生态环境法典",
  "article": "第xxx条",
  "behavior": "通过暗管、渗井、渗坑、灌注等逃避监管的方式排放水污染物",
  "keywords": ["暗管", "渗井", "渗坑", "灌注", "逃避监管"],
  "context": ["软管", "雨水沟", "围墙外", "隐蔽", "绕过排放口"],
  "penalty": { "min": 100000, "max": 1000000, "unit": "元" },
  "subject": "生态环境主管部门",
  "transferToPolice": true,
  "elements": ["隐蔽性", "绕过法定排放口", "主观故意"],
  "evidence": ["现场照片", "水流方向", "排放口许可位置", "生产负荷", "陈述笔录"]
}
拆开看,几个字段是刻意分开的:
- keywords 是法条原文里的行为动词,保证不漏;
- context 是实务里会一起出现的场景词,保证排序靠前;
- elements 是构成要件,用来回答"够不够得上";
- evidence 是取证清单,直接和记录面板联动;
- transferToPolice 是硬标志,命中就必须提示移送,不能藏在小字里。
分开的好处是:同一份数据,速判拿 keywords + context 做匹配,速查拿 behavior + penalty 做展示,裁量拿 penalty 做区间,清单拿 evidence 做核对。一份数据,四个视图,改一处四处同步,不会出现"速查里说 100 万、裁量里按 50 万算"这种低级错误。
七、数据从哪来,怎么保证没编
这是整个工具里我花时间最多的地方,也是最容易被质疑的地方。做法是:
- 依据是《中华人民共和国生态环境法典》(2026 年 8 月 15 日施行)与《生态环境监测条例》(国务院令第 820 号)。
- 52 条罚则全部逐条核对:条号、罚款区间、处罚主体、是否移送公安,四项齐全才录入。
- 涉监测数据造假的,按法典第 1055 条"择一重"的规则处理,同时给出条例第 39 条(50 万–200 万)那一档,让使用者自己看清两条路径的差别。
- 没有"大概""通常"这类模糊表述。写不清的,宁可不收录。
一个细节:工具里每个页面都写着同一句话——它只做条款匹配和幅度测算,不替代事实认定、法制审核和集体审议。这句话不是免责声明,是使用边界。工具给的是候选和算式,定性权、裁量权始终在执法人员手里。
八、还有一个模块:案子立不立得住
前两个模块解决的是「查到什么」和「企业怎么自查」。中间还缺一段,也是最要命的一段。
基层办案被复议撤销,很少是因为条款选错。多数是因为证据不够:现场笔录没有当事人签字、采样没录像、危废属性没做认定、监测点位不在证载排放口。这些东西查的时候不觉得是问题,等到被申请复议、被起诉,才发现整个案子悬着。
于是又加了一个模块:立案证据链体检。
它不是清单,是分级
同样是证据,在不同案子里的分量不一样。所以每一项都标了权重:
- 核心:缺了这一项,案子直接断链。比如暗管案件里的「管道开挖照片与走向勘验」「现场采样监测报告」
- 关键:缺了会削弱证明力,但可以补强
- 补强:有更好,没有不影响
顶部有一个环形分,但不是简单算百分比——核心项缺一项,哪怕总分到了 88%,也直接判「证据链断裂」。因为分数好看不能替代构成要件。
为什么把程序证据单列
实体证据查得再齐,程序上漏一步也可能白干。所以四组证据里,「程序证据」是通用的,每个案子都要:出示执法证件记录、责令改正决定书及送达回证、行政处罚告知书及送达回证、陈述申辩笔录。
这几项在实务里最容易漏,也最容易被拿来主张程序违法。
每一条都写了「最容易栽在哪」
选完条款,下面会有一段红字提示。比如:
- 无证排污:用「未办环评」代替「无证排污」定性,两者构成要件不同,按错条款会被撤销
- 暗管:只证明「有根管子」,没证明「正在排」和「排到外环境」,逃匿监管不成立
- 危废交无资质:没做危废属性认定就直接按危废处罚,是这类案件最常见的败诉点
- 噪声:测点不在场界外 1 米,监测报告不能作为依据
- 稀释排放:只证明浓度达标,没证明「加了清水」,不能认定
这些不是法条,是实务里真的会栽的地方。
三个模块接起来了
在速查里看到某一条,卡片下面多了「查证据要求」,点进去直接落到那一条的证据标准。三个模块共用一套条文编号,跳转不丢上下文;没单独收录的条款也不让用户空手走,会给一版通用证据骨架。
顺手记个技术坑:发布平台的链接必须带 sharecode 才能访问,跨页跳转不带就 403。最后给所有内部链接加了一段自动补参数的脚本,静态链接和动态生成的链接都覆盖到了。
九、第二个模块:把同一套口径反过来发给企业
速查做完之后我又想了一层:它解决的是执法端的问题,但执法量本身不会因为这个变小。真正减少执法量的,是企业先把自己那边捋清楚。
于是同一个应用里加了第二个模块——企业环保合规体检。30 道自查题,六个板块:许可与台账、废水、废气、危险废物、监测、应急与制度。选行业(电镀、印染、制革、食品、建材、化工、养殖、其他)之后,各板块按行业权重加权,最后出一个总分加一份按严重程度排序的整改清单。
两个模块用的是同一套条文、同一套判定口径,只是问法反过来:
- 执法端问的是「现场看到这个现象,可能对应哪些条款、幅度多少」
- 企业端问的是「我目前这个状态,算不算踩线」
这个反向映射听着简单,做的时候有个坑必须处理。
分数会骗人。 30 道题加权算总分,如果一家企业 29 项都做得不错,只有「废水通过暗管排放」这一项选了不符合,总分照样能算到 90 分以上,落在绿色区间。可是按法典,暗管排污是逃避监管,够得上较重违法,跟总分没有关系。
所以体检报告里加了一层红线判定:无证排污、暗管旁路、治污设施不正常运行、危险废物交给无资质单位、监测数据弄虚作假,这五项只要有一项答「不符合」,无论总分多少,直接判「高风险·触红线」,并且红线项排在整改清单最前面。
这个设计不是技术活,是执法常识——有些问题不能拿来和别的问题做加权平均。做工具的时候如果只想着把分数算得漂亮,出来的东西在真实场景里就是有害的。
截图里那家 91 分的电镀厂就是这种情况:分数好看,但暗管和危废联单两项已经把它钉在高风险上了。
体检报告可以一键复制成文本,企业拿去当整改依据;执法端那边则是现场笔录的素材。方向相反,共用一套底层数据。
十、它不做什么
明确列一下,免得被误解成"AI 办案":
- 不做事实认定。现场到底有没有那根软管,只有到现场的人知道。
- 不替代法制审核。它出的幅度是建议落点,不是决定。
- 不连接任何业务系统。不上传、不同步、不留痕。
- 不覆盖全部罚则。52 条是高频条目,不是全量。遇到没收录的,它会明确说"未匹配到",而不是硬凑一条。
十一、做完之后的一点感受
我原本以为这个工具的价值在"快"。做完发现不是。
真正的价值在把隐性经验显性化。老同志看一眼软管就知道往哪个方向定性,这个判断过程是隐性的,存在他脑子里。工具做的事,是把"软管接雨水沟"和"逃避监管"之间的那条推理路径写出来,让刚入职的人也能沿着走一遍,并且走完之后能说出理由。
至于快,那是副产品。
另外一句实话:这类工具的天花板很低。它能减少来回翻页的时间,但解决不了现场取证不扎实、笔录要素不全这些根本问题。工具能帮的,是让一个认真的人少犯低级错误。
十二、关于 1024 造物挑战
这个工具是我参加 WorkBuddy「1024 造物挑战」程序员节应用创作大赛的作品,投稿已提交,等审核上墙。
- 作品名:执法现场速查
- 类型:网页应用(纯前端,手机可直接打开,数据不上传)
- 体验地址:https://eco-enforcement-quickcheck.app.workbuddy.host/?sharecode=OA46WTENEQ
- 两个模块:执法端速查(案情速判 / 罚则速查 / 裁量测算 / 检查清单)+ 企业端合规体检(30 项自查 / 风险分级 / 整改清单)
如果你也在做一线执法或者企业环保管理,欢迎点进去试试,把不顺手的地方告诉我——尤其是"我明明描述对了,它却没匹配到"这种情况,最有价值。
#WorkBuddy #1024程序员节
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号