控制告警的激活、恢复与通知:Elastic Observability 中的 Kibana Universal Alerting
原创
控制告警的激活、恢复与通知:Elastic Observability 中的 Kibana Universal Alerting
原创
点火三周
发布于 2026-10-21 20:44:11
发布于 2026-10-21 20:44:11
Kibana Universal Alerting 是一个用于构建和维护告警与通知的全新选项。无论你是从引导式构建器开始,还是直接深入研究 ES|QL,你都可以精确选择要查询的内容、每条告警要存储的数据,以及在所有规则中由谁接收通知。每条告警都以时间序列数据的形式存储,使你可以在一个位置统一搜索、分析和分诊这些告警。下面将介绍六个调节杠杆(lever),帮助你微调每一步。
Kibana Universal Alerting 将于 2026 年 10 月 20 日在 Elastic Cloud Serverless 中正式推出(GA)并默认启用,同时随 Elastic Stack 9.6 一并适用于 Elastic Cloud Hosted 和自管部署。Kibana 中已有告警?新系统将与现有的 Classic Alerting 系统并行运行,因此你可以按照自己的节奏采用喜欢的功能。
Kibana Classic Alerting 仍然能很好地处理常见场景。选择规则类型,填写参数,然后像往常一样附加动作(action)。Classic Alerting 一如既往地简单可靠。Universal Alerting 更进一步,它使你可以将任何 ES|QL 查询表达为告警规则,通过告警延迟和恢复延迟来控制抖动(flapping),使用自定义恢复查询,按需塑造告警数据结构,并调度能够响应和跨规则分组告警的动作。
何时适合使用 Universal Alerting
当满足以下一个或多个条件时,它是一个很好的选择:
- 你的告警场景超出了 Classic Alerting 的能力范围,例如自定义严重级别、工作流驱动的动作、告警数据控制、对恢复过程的完全控制等。
- 你希望享受使用简化查询构建器构建规则的灵活性,并之后“降级”去编辑和扩展现成的 ES|QL。
- 你的告警来自多个系统,而你希望在一个视图中对它们进行分诊和分析。
- 精细的通知控制很重要,例如通知谁、通知频率、跨规则分组和处理等。
- 你的团队希望获得 Discover、ES|QL 和 Workflows 所提供的全部灵活性。Universal Alerting 与这些基础的 Elastic 功能完美集成,并且依赖于它们。
如果某个 Classic 规则类型已经覆盖了你的场景,那么请继续使用它。我们将在本文后面并排比较这两个系统。
Universal Alerting 的工作原理:从 ES|QL 查询规则到告警数据
Universal Alerting 规则按计划运行一个 ES|QL 查询。每个结果都会作为规则事件(rule event)写入一个专用的数据流 .rule-events。四个核心概念定义了该系统:
- 规则就是 ES|QL 查询,因此无需从预设规则类型中选择。查询返回的每一行(由其分组标识)都会成为一个规则事件,并且查询返回的列也会与该事件一起存储。查询定义了告警的形态。
- 告警即数据。规则事件存放在具有文档化 schema 的常规数据流中,无论它们来自 Kibana 告警规则还是外部工具。它们可以在 Discover 中搜索、在仪表盘上绘图,并作为其他规则的输入。
- 一条告警追踪一个持续存在的问题在整个生命周期(pending、active、recovering、inactive)中的进展,并将其所有底层规则事件分组为该告警的历史记录。规则不会在每次运行时都触发新告警,也不会更新现有的告警文档。规则事件可以被捕获而不触发告警,这些事件仅作为数据被收集。
- 动作策略(action policy)独立于规则之外。它们基于告警数据匹配、分组和节流,并将告警发送到工作流(workflow)。更改通知对象并不意味着要逐一编辑每条规则的动作。
上述每个概念都是独立的组件,每个组件本身都提供了灵活性和控制能力。
SRE 工作流:编写并塑造一条规则
假设你在多个可用区(availability zone)中运行生产主机。目标是在主机持续过热时发出告警,并附上值班工程师所需的严重级别和可用区信息。短暂的峰值不应算作问题。主机示例使用 Elastic Agent System 集成(system.* 字段)的指标,后面的 Pod 示例使用 Kubernetes 集成(kubernetes.* 字段)。可根据需要替换为你自己的字段。
编写:一条 ES|QL 规则,以你习惯的查询方式来写
此规则计算每台主机的平均 CPU,分配严重级别,并仅返回值得关注的主机:
/*  每个主机的平均 CPU,带有严重级别和最小样本守卫。*/
FROM metrics-*
| WHERE system.cpu.total.norm.pct IS NOT NULL
| STATS
    avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
    samples = COUNT(*)
  BY host.name, cloud.availability_zone
    /* 名为 severity 的列会设置告警的内置严重级别字段
       (info、low、medium、high 或 critical)。低于所有阈值的主机
       不会获得 severity,下面的 WHERE 会将其丢弃。其他返回列,
       如 avg_cpu_pct 和 zone,会存储在告警上,并可供
       后续的动作策略和仪表盘使用。 */
| EVAL severity = CASE(avg_cpu_pct > 95, "critical", avg_cpu_pct > 90, "high", avg_cpu_pct > 85, "medium")
| WHERE samples >= 10 AND severity IS NOT NULL
    /* 最小样本守卫可以跳过刚刚启动且仅上报了
       少数数据点的主机。 */
| KEEP host.name, cloud.availability_zone, avg_cpu_pct, severity, samples
塑造:决定告警在时间上的行为
查询决定了什么会匹配。规则定义决定了匹配出现和消失时会发生什么。下面是同一条规则的 YAML 形式,拆分为基础查询、触发条件(breach condition)和恢复条件(recovery condition):
kind: alert
metadata:
  name: host-cpu-saturation
  routing_tags: [infra]                 # 将此规则链接到动作策略(杠杆 5)
schedule:
  every: 1m
  lookback: 5m
query:
  base: |
    FROM metrics-*
    | WHERE system.cpu.total.norm.pct IS NOT NULL
    | STATS
        avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
        samples = COUNT(*)
      BY host.name, cloud.availability_zone
    | EVAL severity = CASE(avg_cpu_pct > 95, "critical", avg_cpu_pct > 90, "high", avg_cpu_pct > 85, "medium")
  breach:
    segment: WHERE samples >= 10 AND severity IS NOT NULL
recovery:
  strategy: condition
  segment: WHERE avg_cpu_pct < 70       # 远低于触发阈值时才恢复
no_data:
  strategy: keep_last                   # 正在重启的主机保持其最后已知状态
state_transition:
  pending:
    count: 2                            # 告警延迟:在第三次连续触发时才进入 active
  recovering:
    count: 2                            # 恢复延迟:在第三次连续恢复时才进入 inactive
grouping:
  fields: [host.name, cloud.availability_zone]   # 每个主机一条告警
恢复、状态转换、分组和无数据处理都是可调节的,下面的杠杆 1 到 4 会介绍它们。杠杆 5 和 6 在告警激活后生效:通知谁,以及响应者如何分诊。
六个杠杆,用于微调你的告警
Universal Alerting 在管道的每个阶段都有一个控制项,按从早到晚的顺序列出。仅在场景需要时使用它们。
1. 查询:精确决定什么算数
ES|QL 拥有精确定义条件所需的一切。WHERE 设置范围,最小样本守卫忽略刚启动的主机,CASE 分配严重级别,SORT 和 LIMIT 将告警限制在最严重的违规者上。
/*  只对最热的三个 Pod 发出告警,而不是对所有超过阈值线的 Pod 发出告警。*/
FROM metrics-*
| WHERE kubernetes.pod.cpu.usage.node.pct IS NOT NULL
| STATS avg_cpu_pct = ROUND(AVG(kubernetes.pod.cpu.usage.node.pct) * 100, 1) BY kubernetes.pod.name
| SORT avg_cpu_pct DESC
| KEEP kubernetes.pod.name, avg_cpu_pct
| LIMIT 3    /* LIMIT 限制了单次运行可以产生的告警数量。
       当你关心的问题是“最差的几个”时使用它。 */
LIMIT 有一个需要提前规划的副作用。一个掉出前三名的 Pod 会从结果中消失。使用 no_breach 恢复策略时,这会被视为已恢复,如果该 Pod 重新进入前三名,告警可能再次激活。如果这对你的规则很重要,请将 LIMIT 与恢复延迟(杠杆 3)结合使用。
2. 分组:选择一条告警的单元
STATS ... BY 定义了一条告警是什么。按 host.name 分组,每个主机一条告警;或按 service.name 分组,每个服务一条告警。选择一个某人可以操作的单元:分组太宽会隐藏问题,太窄则会使问题倍增。如果某些文档缺少某个分组字段,这些行会落入一个空的 null 组,并共享同一条告警,而其他分组则各自拥有告警。如果这很重要,请在查询中显式处理缺失值。
除非你设置了 LIMIT,告警规则最多返回 1,000 行。如果单次运行可能产生超过该数量的分组,请添加显式的 LIMIT。
3. 告警延迟和恢复延迟:定义告警如何开始和结束
超过阈值 30 秒并不总是事件。一次恢复迹象也不总是真正的恢复。这种抖动是告警噪音的最大来源之一,而两个延迟配置可以在不修改查询的情况下处理它。
告警延迟(state_transition.pending)是告警在进入 active 状态之前停留在 pending 状态的评估次数。使用 count: 2 时,告警在第三次连续触发时才进入 active,因此短暂峰值会一直处于 pending,永远不会成为告警。
恢复延迟(state_transition.recovering)在告警进入 inactive 前对 recovering 状态执行相同的操作。在阈值附近波动的信号会保持为一条告警。每个阶段都接受一个 count、一个 timeframe 或两者,再加上一个 operator(and 或 or),用于指示必须同时满足两者还是仅满足其一。
恢复是一个独立的设置,每条告警规则都必须设置一个(默认是 no_breach):
no_breach:当某分组不再出现在触发结果中时,恢复该告警。condition:当同一条基础查询上的一个不同恢复条件(与告警条件相对)被满足时,恢复该告警,如上面的规则所示。query:当一条独立的 ES|QL 查询返回该告警的分组时,恢复该告警。恢复按分组进行,因此每条告警仅在其分组被查询返回时才会恢复。manual:永远不会自动恢复。告警将一直保持 active,直到有人手动解决它。
一个常见模式是远低于触发阈值时恢复;例如,CPU 在 90% 时触发,在 67% 以下恢复。这样,告警不会在指标刚刚跌破阈值线时立即关闭。而且由于 query 恢复可以运行自己的 ES|QL 查询,它可以检查与触发条件不同的值。下面的示例要求 CPU 和负载平均值都恢复正常后,告警才会关闭:
# 一个比触发查询检查更多指标的恢复查询。
recovery:
  strategy: query
  query: |
    FROM metrics-*
    | STATS
        avg_cpu_pct = ROUND(AVG(system.cpu.total.norm.pct) * 100, 0),
        load_avg_5m = AVG(system.load.5)
      BY host.name, cloud.availability_zone
    | WHERE avg_cpu_pct < 67 AND load_avg_5m < 4
    | KEEP host.name, cloud.availability_zone
4. 无数据处理:决定静默意味着什么
当一个具有活跃告警的分组不再出现在触发结果中时,有两种截然不同的解释:要么问题已经解决,要么数据源停止上报。仅凭告警条件无法区分这两者。无数据处理(no-data handling)让你能够针对每条规则决定该时刻发生什么,这样损坏的指标代理不会悄然恢复一条真实告警。
使用 no_data.strategy 或规则构建器中的无数据设置来配置它:
选项 | no_data.strategy | 效果 |
|---|---|---|
保持最后状态 | keep_last | 保持最后已知状态。活跃告警保持活跃,恢复中的告警保持恢复中。一条 status:no_data 规则事件会被写入数据流。 |
恢复 | resolve | 在首次发现无数据时关闭告警,直接将其移至 inactive,而无需等待恢复延迟。一条 status:no_data 规则事件会被写入数据流。 |
不执行任何操作 | ignore | 跳过无数据检查。使用 no_breach 恢复时,数据缺口看起来像一次恢复。使用 condition 或 query 恢复时,不写入任何事件,告警保持活跃。 |
正确的选择取决于静默对该规则意味着什么。对于基础设施 CPU,使用“保持最后状态”:如果代理停止发送数据,活跃的 CPU 触发状态将保持活跃,直到数据恢复。对于作业积压过大时触发告警的规则,“恢复”则更合理。一旦队列清空,查询将没有返回内容,告警就会关闭。
5. 动作策略:路由、分组和节流
规则本身不携带动作。相反,动作策略会选择告警,将其捆绑为有效负载,控制它们重复的频率,并将它们派发到工作流。一个动作策略可以覆盖来自许多规则的告警,因此,如果要修改一百条规则的分页通知对象,只需编辑一次。
策略范围(policy scope)选择动作策略处理的告警,由两个可以组合的部分组成。路由标签(routing tags)将动作策略限制为来自至少带有这些标签之一的规则的告警。在“高级匹配”(Advanced matching)下,一个 KQL 表达式可以基于告警字段(如 severity、group_hash 或 data.*)进行过滤。当两者都设置时,告警必须同时通过两者。
路由标签将动作策略连接到规则。在规则表单的 Actions 步骤的 Routing tags 字段中添加它们,并在动作策略表单中选择相同的标签。此后,该动作策略将应用于带有这些标签之一的每条规则,包括之后创建的规则。规则表单的 Applied policies 面板会列出与该规则匹配的每个动作策略,因此很容易验证连接。要针对单条规则,请为其指定一个其他规则不使用的路由标签。然后,附加或分离规则只需编辑其路由标签,而动作策略本身不需要更改。
路由标签不同于规则常规标签。常规标签用于在规则列表中分组和过滤规则。它们对通知没有影响,因此给规则添加常规标签绝不会将动作策略附加到它。
还有两个设置塑造通知。按以下维度通知(Notify per)控制捆绑方式:每条告警一个通知,跨规则共享某个字段值(例如可用区)的每组告警一个通知,或者动作策略匹配的所有内容的单一摘要。频率(Frequency)限制重复次数,例如最多每 30 分钟一次。
以下是 CPU 规则的两个动作策略,以 UI 中选定的设置形式表示。两者都通过其 infra 路由标签与规则关联:
# 仅对 critical 主机呼叫值班工程师,每个可用区一个呼叫。
Name:           infra-oncall-pager
Policy scope:   Routing tags: infra
                Advanced matching (KQL): severity : "critical"
Notify per:     Group, by data.cloud.availability_zone
Frequency:      At most once every 30 minutes
Destination:    pagerduty-infra workflow

# 将较低严重级别发送到基础设施频道,按区域批量处理,最多每小时一次。
Name:           infra-team-digest
Policy scope:   Routing tags: infra
                Advanced matching (KQL): severity : "high" or severity : "medium"
Notify per:     Group, by data.cloud.availability_zone
Frequency:      At most once every 1 hour
Destination:    slack-infra-team workflow
一条告警可以匹配多个动作策略,每个策略应用自己的分组和频率。如果整个可用区过热,寻呼机收到的是一个分组呼叫而不是每个主机一个呼叫,团队频道则收到关于 high 和 medium 主机的每小时摘要。
动作策略也跨规则工作。为你的 CPU、内存和磁盘规则赋予相同的路由标签,在动作策略中选择该标签,并将 Notify per 设置为按 data.cloud.availability_zone 分组。这样,一个三条规则同时触发的可用区只会发送一个分页,而不是三个。将 Notify per 切换为 Digest,动作策略将为其匹配的所有内容发送单个通知。要对模式本身发出告警,请参阅基于告警的规则。
每个目的地示例都是一个工作流,它调用你的连接器(例如 Slack 或 PagerDuty)。要了解如何构建和启用工作流,请参阅 Workflows 文档。
6. 分诊控制与维护窗口:有意地静默
一旦告警激活,响应者可以确认(acknowledge)、休眠(snooze)该系列一段时间或解决(resolve)它。被抑制的告警不会进入通知渠道,但仍保留在数据中。任何内容都不会被删除,一切都可审计。例如,在计划内的发布期间,休眠该系列会使其在休眠到期前不进入通知渠道。维护窗口(maintenance windows)对计划内维护执行相同的操作,并同样适用于 Universal Alerting 和 Classic 规则。
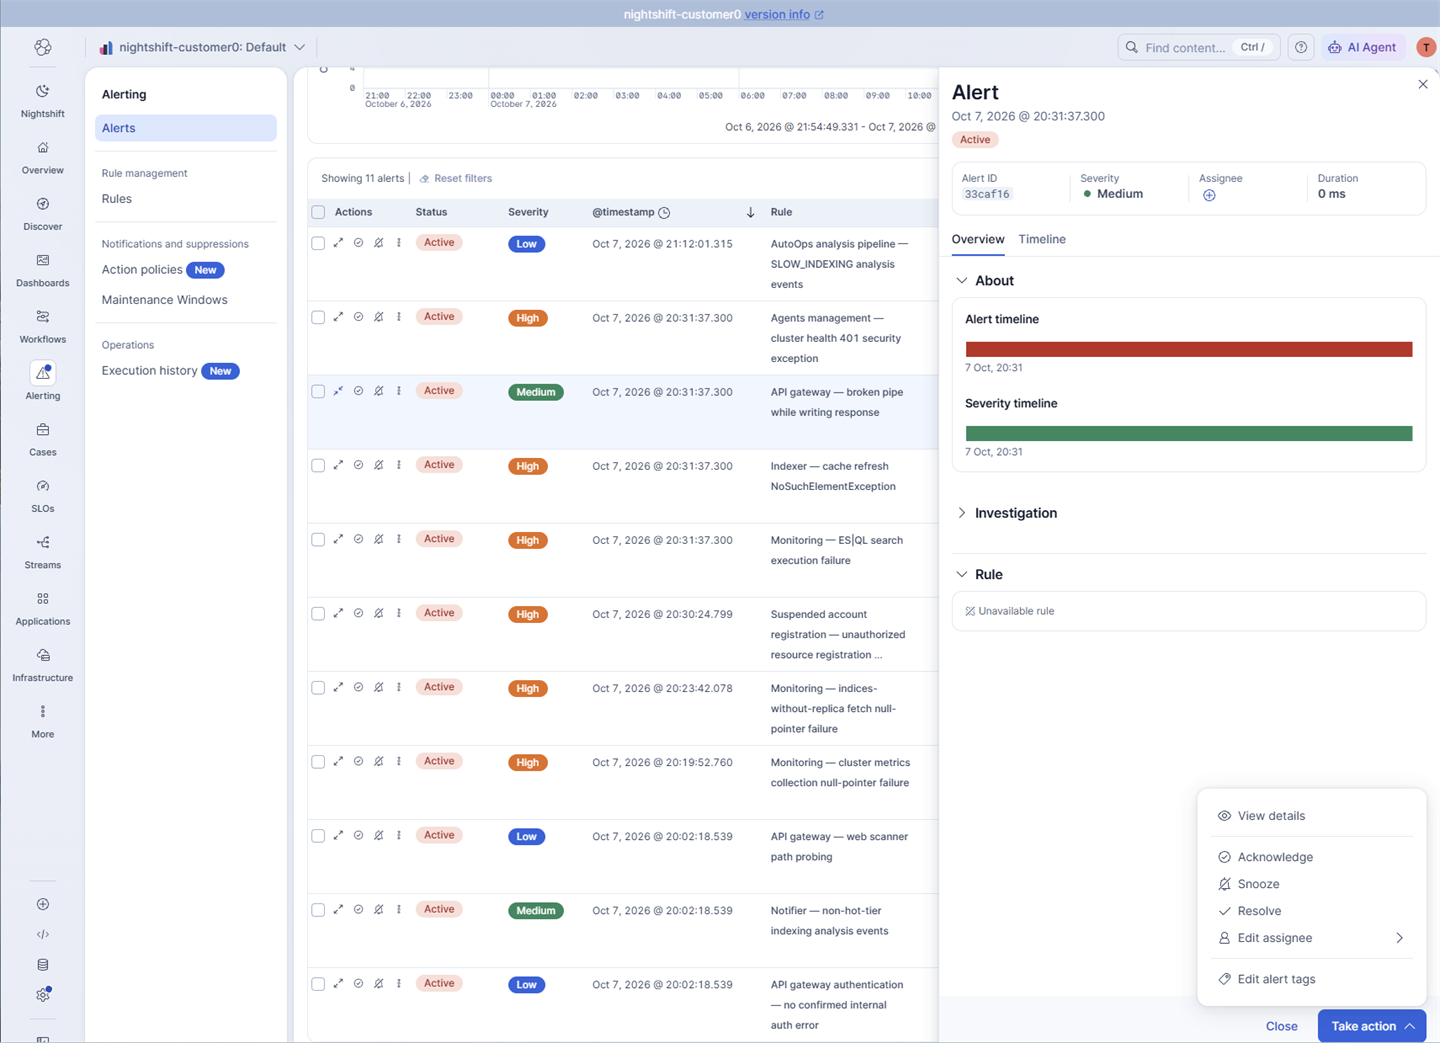
Alerts 页面,包含告警详情浮出层和 Take action 菜单,显示 acknowledge、snooze 和 resolve
一个地方容纳所有告警:Classic、Universal,甚至外部告警
很少有团队只有一个告警来源。有些来自 Classic Alerting 规则,有些来自 Universal Alerting 规则,还有一些来自其他监控工具。我们新的告警视图旨在让响应者能够从单一队列工作。
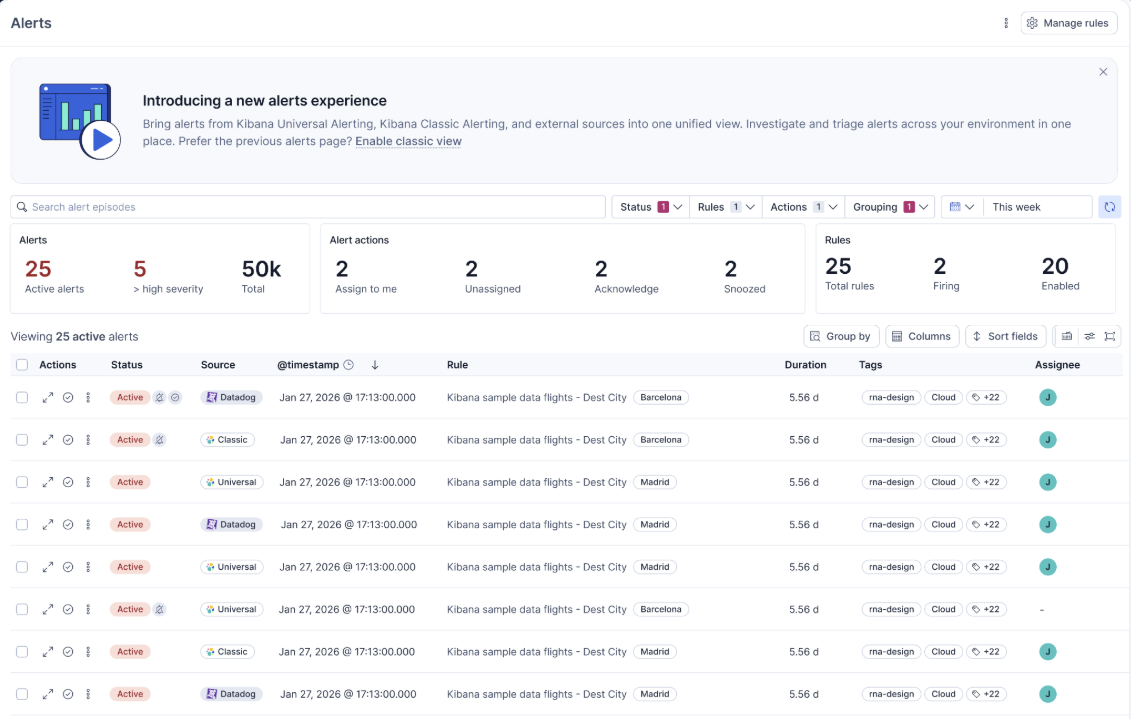
Alerts 页面,包含 Classic、Universal 和外部告警
来自其他工具的外部告警,作为数据
来自外部监控工具的告警与 Elastic 生成的告警落在同一数据流中,并以相同的方式被搜索、路由和分诊。工作流使用 alerting.create_alert 步骤写入每条外部告警,source 字段记录其来源。对于值班工程师来说,这是一个需要检查的地方,而不是每个工具一个标签页。外部告警摄入是一个实验性功能,因此随着我们了解其使用方式,它可能会发生变化和改进。
Universal 与 Classic 功能对比
两个系统有共同的目标,但做了不同的取舍。Classic Alerting 倾向于为已知场景提供引导式设置,而 Universal Alerting 则倾向于灵活性和控制力。
功能 | Classic | Universal | |
|---|---|---|---|
带引导参数的内置规则类型 | ✓ | 部分,后续更多 | |
以 ES | QL 查询形式编写的规则 | ✓ | ✓ |
基本阈值规则 | ✓ | ✓ | |
异常检测和 APM 异常规则 | ✓ | 即将推出 | |
机器学习作业健康与转换健康规则 | ✓ | 即将推出 | |
SLO 燃尽率规则 | ✓ | 即将推出 | |
Synthetics 监控状态规则 | ✓ | 即将推出 | |
由规则查询定义的告警字段 | ✓ | ||
每次运行的告警事件历史数据 | ✓ | ||
告警延迟(连续触发后才激活) | ✓ | ✓ | |
恢复延迟(连续恢复后才自动恢复) | ✓ | ||
自定义恢复条件或恢复查询 | ✓ | ||
动作附加到每条规则,直接发送到连接器 | ✓ | ||
跨多条规则共享的可重用动作策略,支持分组和节流 | ✓ | ||
从外部工具导入告警(实验性) | ✓ | ||
合并的 Alerts 页面中的分诊与分析 | ✓ | ✓ | |
维护窗口 | ✓ | ✓ |
Universal 和 Classic 告警会一起出现在合并的 Alerts 页面上,因此响应者可以在一个视图中分诊所有内容。Classic Alerting 会像现在一样继续运行。维护窗口、连接器和工作流在两个系统之间共享。
新的告警能力正在 Universal Alerting 中积极构建。对于其设计所针对的标准场景,Classic 规则仍然是一个很好的选择,你可以按照自己的节奏一条一条地采用 Universal Alerting。
Universal Alerting 目前不具备的功能
Universal Alerting 在功能数量上尚未完全比肩 Classic Alerting。我们宁愿你现在就知道这些差距,也不希望你在处理事件中途才发现。以下是在迁移规则之前需要了解的内容。
- 并非每种 Classic 规则类型都有对应的 Universal 版本。Universal 规则是 ES|QL 查询,由手工编写或由规则构建器生成。阈值类规则(如自定义阈值、指标阈值、日志阈值和索引阈值规则)可以很好地映射到阈值规则构建器,许多其他条件可以直接用 ES|QL 编写。依赖堆栈中其他位置计算结果的规则类型(如异常检测)目前还没有 Universal 对应项,因此这些规则暂时保留在 Classic 上。上面的对比表列出了它们,我们路线图中的规则库将为常见模式添加即用起点。
- SLO 和 Synthetics 规则需要额外工作。它们的条件可以用 ES|QL 针对 SLO 和 Synthetics 数据编写,但 Classic 规则的多窗口燃尽率逻辑和按监控项的设置必须手工重建。除非你需要额外的控制,否则请将这些规则保留在 Classic 上。
- Classic 规则不会自动迁移到 Universal 系统。它们会原样继续运行,将一条规则迁移到 Universal Alerting 意味着将其条件重建为 ES|QL 规则。
- Universal Alerting 动作依赖工作流。Classic 规则将其动作直接发送到连接器。Universal 规则本身没有动作:动作策略将告警交给工作流,工作流是唯一的目的地类型,然后工作流再调用 Slack、PagerDuty 或任何其他连接器。在 Universal 规则能够通知任何人之前,必须至少存在一个已启用的工作流。
- 在 Elastic Cloud Hosted 和自管部署中,工作流需要 Enterprise 许可证。没有此许可证,Universal 规则仍然可以运行,告警仍然会被写入,但动作策略无法投递到任何目的地,因此不会发送任何通知。现有动作策略仍然可以查看、禁用、休眠和删除。
- Universal 告警不提供抖动状态配置。告警延迟、恢复延迟和自定义恢复(杠杆 3)是防止嘈杂告警过于频繁触发的方式。
- 两种告警类型的字段名可能不同。对
group_hash等 Universal 告警字段的查询不会匹配任何 Classic 告警。我们统一的告警表在很大程度上隐藏了这种差异,但在你自己的组合查询中请使用共享过滤器(status、severity、rule、tags),或分别查询每个系统。
两个投递细节适用于每个动作策略。通知至少投递一次,因此在极少数情况下(例如在派发和记录之间发生重启),同一个通知可能会到达两次。请确保工作流具有幂等性。通知也以短轮询间隔而不是即时方式派发,因此不要依赖亚秒级的分页延迟。
使用 ES|QL 理解你的告警
一条告警及其历史记录是数据流中的文档,因此定义规则的语言也可以回答关于你的告警的问题。从一条告警出发,你可以跳转到 Discover,并 pivot 到该主机的指标和日志,而无需使用单独的工具。下面两个示例都查询 .rule-events 数据流。
/*  过去 7 天中激活最多告警的十条规则。
  rule.id 是规则的保存对象 ID,而非名称。*/
FROM .rule-events
| STATS alerts = COUNT_DISTINCT(alert.id) BY rule.id
| SORT alerts DESC
| LIMIT 10    /* 列表顶部的规则是调优的候选者。调整阈值、
提高告警延迟或更改分组,然后重新运行。 *//* 单条规则每天的告警量,用于确认更改达到了预期效果。
rule.id 是规则的保存对象 ID,而非名称。*/
FROM .rule-events
| WHERE rule.id == "<your-rule-id>" AND type == "alert"
| STATS alerts = COUNT_DISTINCT(alert.id) BY day = BUCKET(@timestamp, 1 day)
| SORT day ASC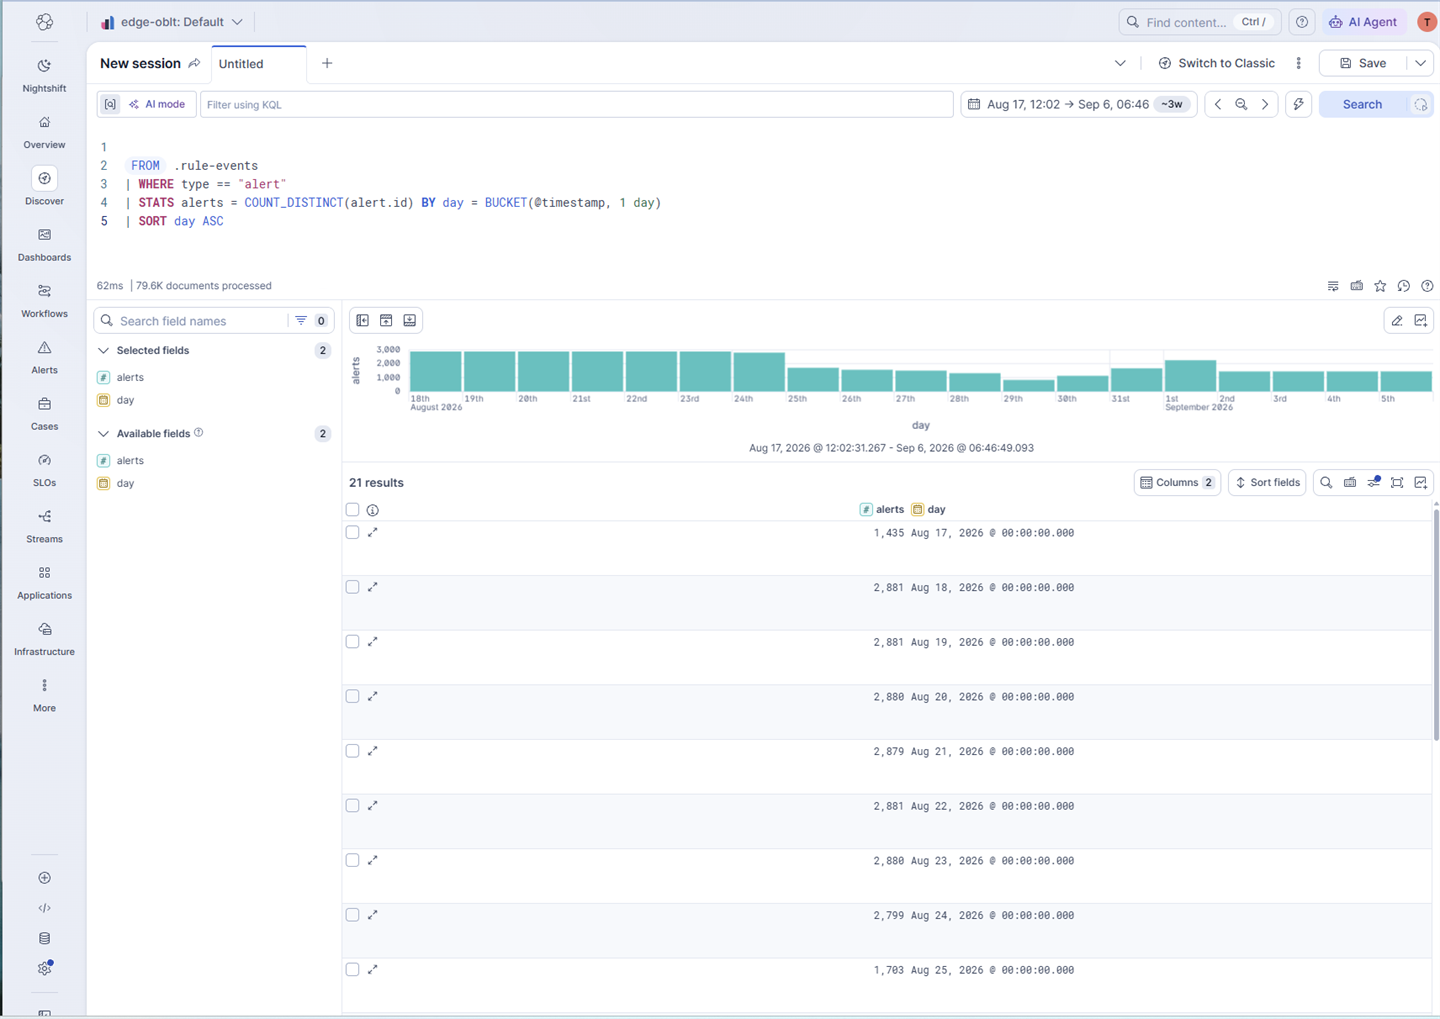
Discover 在 .rule-events 上运行 ES|QL 查询,统计每天的去重告警数量
基于告警的规则
由于告警是数据,规则也可以在其之上运行。基于告警数据的规则是一条普通的 ES|QL 规则,它读取 .rule-events 而不是日志和指标。这使它能够捕捉到单条告警无法显示的模式,例如同一可用区内三个或更多规则同时触发。来自 Universal 规则和外部工具的告警在这里以同样的方式工作,因为它们都落在同一数据流中并且具有相同的字段。此类规则产生的告警与其他任何告警一样,获得相同的生命周期、动作策略和分诊控制。
信号规则(signal rules)就是构建此功能的基础。一条 kind: signal 的规则(在 UI 中标记为 Events)将触发和恢复事件记录为数据,而不会触发告警或通知任何人。将信号规则用于主要在组合时才重要的条件,例如同一主机上的高 CPU、低可用磁盘和升高的 I/O 等待时间。然后编写一条告警规则,当多个此类信号排列对齐时触发。
我们下一步的工作
按空间试用即将推出的功能
新的和即将推出的 Kibana Universal Alerting 功能将放在实验性功能标志之后,以便团队可以在它们面向所有人启用之前试用。该标志是 Universal Alerting: Experimental Features 设置(alerting:v2:experimentalFeatures)。它默认关闭,并按 Kibana 空间设置,因此你可以在测试或预发空间启用它,而生产空间保持原样。更改它需要重新加载页面。
该标志会门控所有即将推出的 Universal Alerting 功能。GA 时发布的所有功能无需该标志即可使用。
即将推出
虽然我们不承诺任何具体日期,但以下是我们在 GA 之后关注的方向:
- 序列规则构建器 GA:一种引导式方式,用于构建检测特定顺序事件发生的规则,而无需手工编写整个查询(已可通过“实验性功能”使用)。
- 更多规则构建器:提供更多引导式方式来构建规则查询(SLO、Synthetics、异常检测等)。
- 规则库:包含即用型规则,可供起步和调整,使新规则不必从空白查询开始。
- 告警删除,用于不再需要的告警。
- 外部告警导入正式可用,并提供更简单的设置和管理。
- 与外部系统进行双向告警同步,使一个系统中采取的操作反映在另一个系统中。
- 更多“无数据”功能。
如果其中某项对你来说比其他更重要,请告诉我们。这有助于我们决定首先构建什么。
入门
Universal Alerting 已在 Elastic Cloud Serverless 上正式可用,并随 Elastic Stack 9.6 在 Elastic Cloud Hosted 和自管部署上提供。在 Elastic Cloud Hosted 和自管部署上,基于工作流的动作策略需要 Enterprise 许可证,该许可证每月包含 10,000 次工作流执行(请参阅订阅)。在 Serverless 上,Elastic 管理告警系统。
为你的团队授予访问权限
访问由 Kibana 功能权限控制,在 Stack Management > Roles 中按角色设置。Universal Alerting 增加了四项,在角色编辑器中的 Universal Alerting 下列出,每项都有自己的 All 或 Read 级别:
权限 | Read | All |
|---|---|---|
Rules | 查看规则 | 创建、编辑和删除规则 |
Alerts | 查看告警 | 分诊告警 |
Action Policies | 查看动作策略 | 创建和编辑动作策略 |
Execution history | 查看执行历史 | 与 Read 相同 |
大多数响应者需要 Alerts: All 和 Rules: Read。规则作者需要 Rules: All,如果他们还管理通知,还需要 Action Policies: All。通知通过工作流运行,因此任何构建或编辑工作流的人也需要 Analytics > Workflows 的 All 权限。有关 Workflows 权限的完整列表,请参阅设置 Workflows。
权限控制用户可以管理什么,而不是规则可以读取什么数据。每条规则都使用最后保存它的用户的 API key 运行,该 key 决定了规则可以查询哪些数据。请以能够读取规则所查询索引的用户身份保存规则。有关规则、动作策略和工作流如何授权的信息,请参阅授权文档。
创建你的第一条规则
打开 Universal rules 标签页,创建你的第一条规则,并告诉我们你的发现。如果你遇到我们未在此处介绍的情况,我们很乐意听取你的意见。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号