中间件机制:PII 过滤、摘要压缩与人工介入
原创
中间件机制:PII 过滤、摘要压缩与人工介入
原创
老周聊架构
发布于 2026-10-21 18:50:31
发布于 2026-10-21 18:50:31
很多团队把 PII 脱敏、历史压缩、人工确认这些逻辑全塞进一个超长 system prompt,或者散落在业务函数里。结果代码改不动、测不了,顺序一乱就出 bug。这篇聊中间件(middleware)——一类在请求进入模型前、响应离开模型后做横切处理的机制。它不是 prompt 里的杂烩,而是有顺序、可组合的管道。我们讲透三个典型中间件:PII 过滤、对话摘要压缩、人工介入(HITL)。
第一节:中间件到底是什么
一句话:中间件是在请求进模型前、响应出模型后做横切处理的管道节点。它和 Web 框架里的 middleware、Spring 的拦截器是同构的东西——横切关注点(cross-cutting concern)不该写进业务主干,应该抽出来挂在请求-响应的路径上。
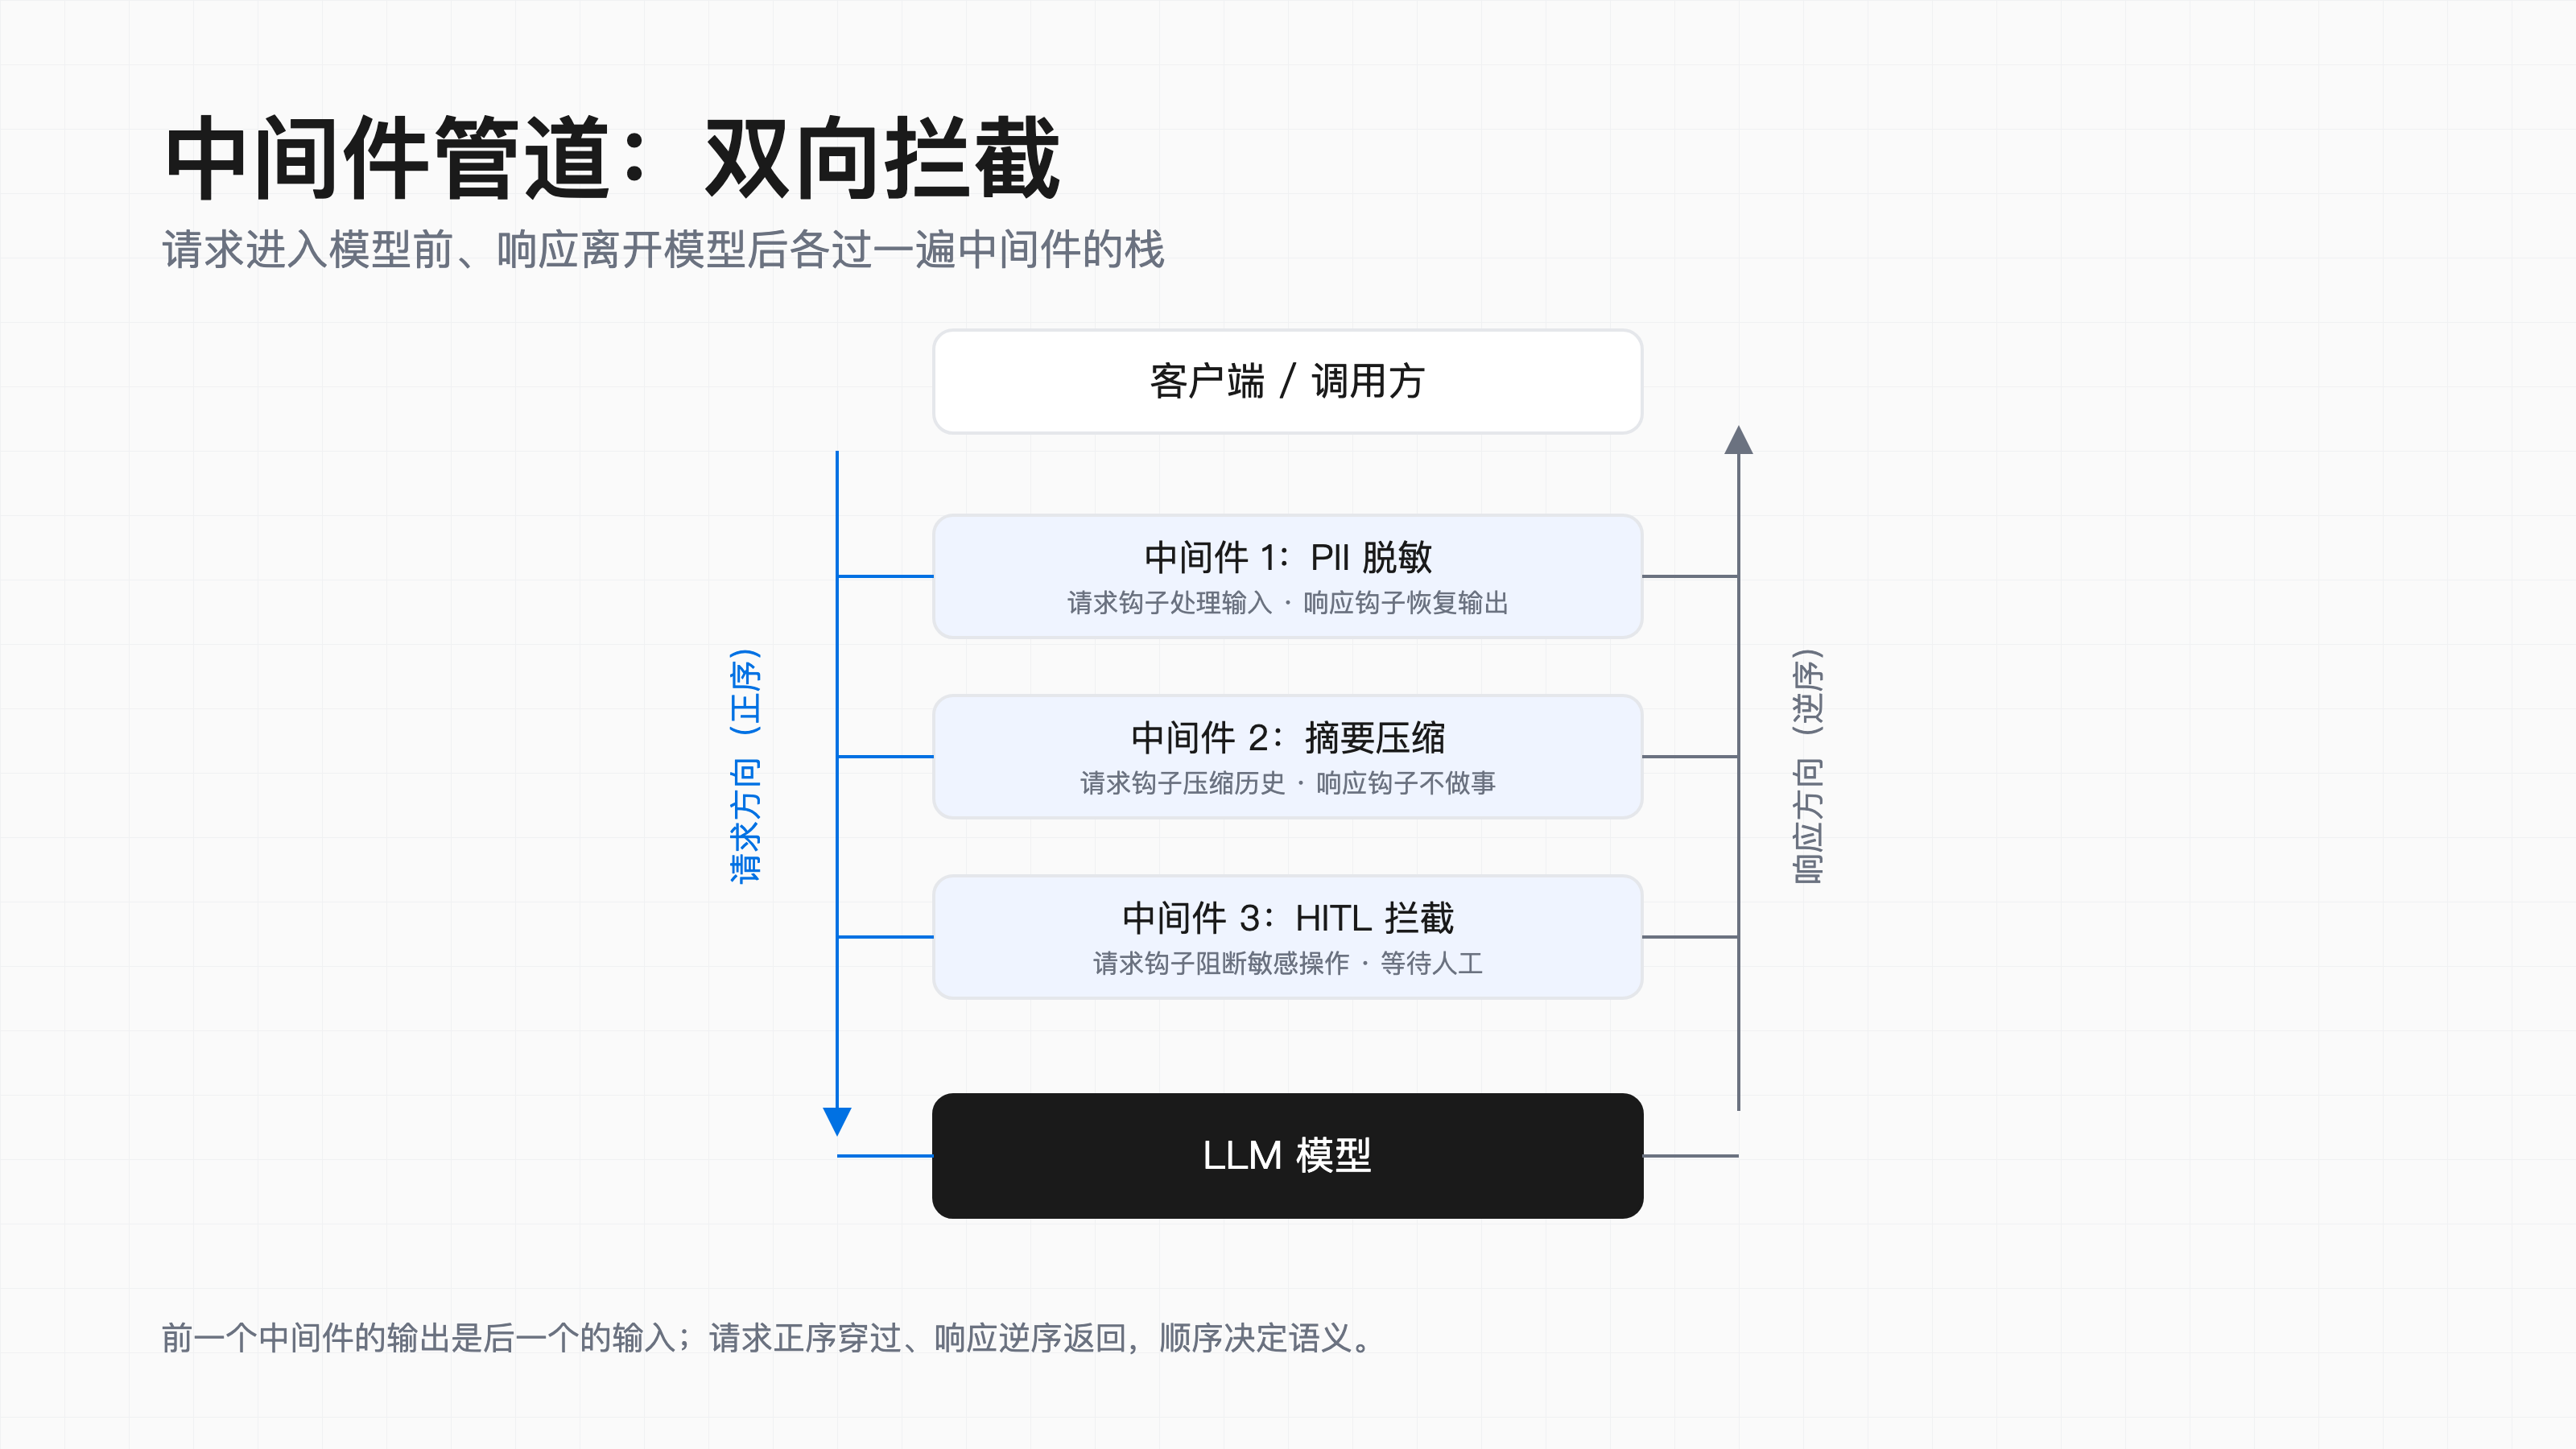
一个普通函数调用是 输入 → 函数 → 输出,中间件把它变成 输入 → 中间件A → 中间件B → 模型 → 中间件B' → 中间件A' → 输出。注意请求方向和响应方向是两趟独立的钩子:process_request 在模型前,process_response 在模型后。
- 请求钩子(request hook) 在消息送去模型之前改写、校验、脱敏输入
- 响应钩子(response hook) 在模型吐字之后恢复、审计、拦截输出
- 可组合 多个中间件按顺序叠成一条栈,前一个的输出是后一个的输入
这跟"把规则写进 prompt"本质不同。prompt 里写"请勿泄露隐私",模型听不听是两码事;中间件在管道里强制把明文换成占位符,模型这辈子都看不到原始 PII。管道是确定性的工程控制,prompt 只是软约束。
下面这段是中间件的最小契约和一个按正序进、逆序出的管道实现,后面三个中间件都挂在它上面。
from typing import Callable, Protocol

# 一次请求-响应的上下文,中间件可读写它
class MiddlewareContext:
    def __init__(self, messages, metadata=None):
        self.messages = messages        # 送给模型的消息列表
        self.metadata = metadata or {}  # 中间件之间的私人数据
        self.response = None            # 模型返回后填充

# 中间件契约:请求钩子 + 响应钩子
class Middleware(Protocol):
    def process_request(self, ctx: MiddlewareContext) -> MiddlewareContext: ...
    def process_response(self, ctx: MiddlewareContext) -> MiddlewareContext: ...

# 管道:请求正序穿过,响应逆序返回
class MiddlewarePipeline:
    def __init__(self, middlewares: list, model_fn: Callable):
        self.middlewares = middlewares
        self.model_fn = model_fn

    def run(self, ctx: MiddlewareContext) -> MiddlewareContext:
        for mw in self.middlewares:            # 请求方向:正序
            ctx = mw.process_request(ctx)
        ctx.response = self.model_fn(ctx.messages, ctx.metadata)  # 调模型
        for mw in reversed(self.middlewares):  # 响应方向:逆序
            ctx = mw.process_response(ctx)
return ctx逆序返回这一点很重要:PII 脱敏在请求方向第一个把明文换掉,响应方向它就最后一个把占位符换回来——这样中间所有环节(包括模型)看到的都是脱敏后的内容。顺序即语义。
第二节:PII 过滤——进脱敏,出恢复
PII(个人身份信息)过滤要解决一个具体问题:用户输入里常有手机号、身份证、邮箱,你不能把它们送进第三方模型,但又得把答案里的真实值返回给用户。解法是两端脱敏-恢复:请求方向把敏感字段替换成占位符 <PII_0>,把映射存在上下文里随请求带走;响应方向再把占位符还原。
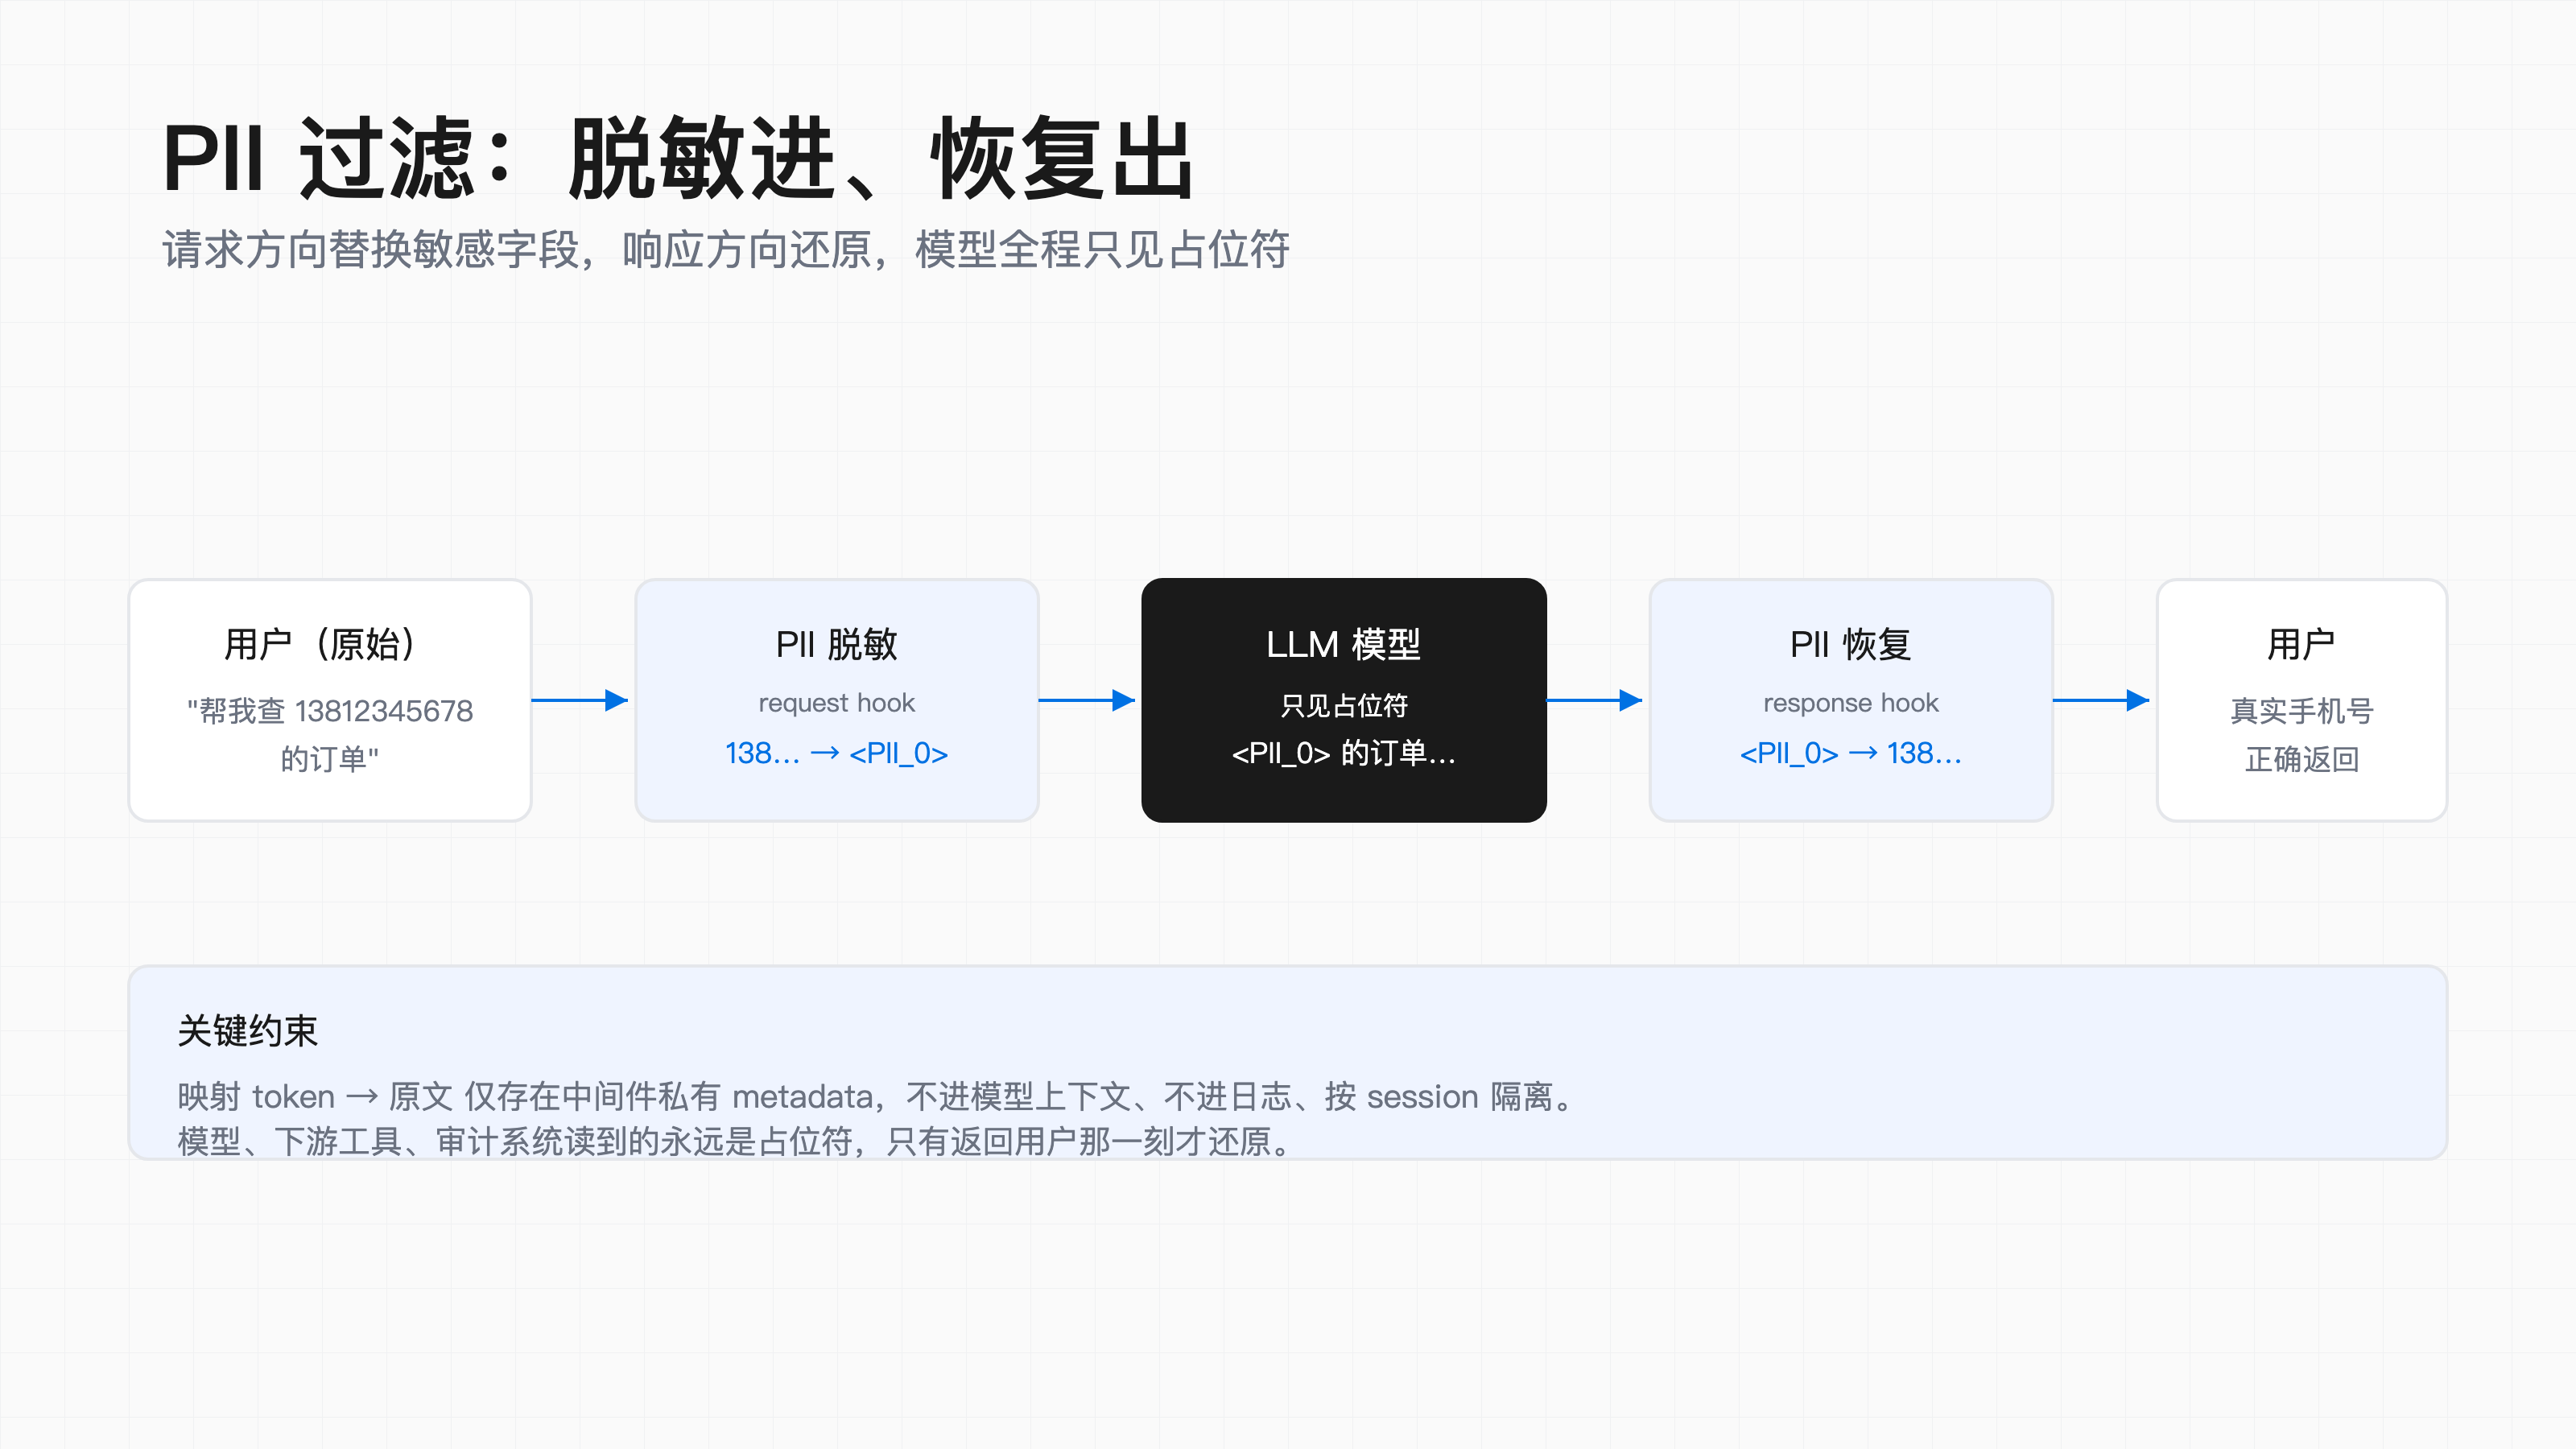
这样模型自始至终看不到明文,合规面和泄露面都大幅缩小。占位符到原文的映射绝不能写进日志,也绝不能进模型的上下文——它只活在中件间的私有 metadata 里。
import re

class PIIMaskMiddleware:
    def __init__(self):
        self.store = {}   # token -> 原文,真实系统里按 session 隔离

    def process_request(self, ctx):
        masked, mapping = self._mask(ctx.messages)
        ctx.messages = masked
        ctx.metadata["pii_map"] = mapping   # 随请求一起带走
        return ctx

    def process_response(self, ctx):
        mapping = ctx.metadata.pop("pii_map", {})
        ctx.response = self._unmask(ctx.response, mapping)
        return ctx

    def _mask(self, messages):
        mapping, counter = {}, 0
        def replace(m):
            nonlocal counter
            token = f"<PII_{counter}>"
            mapping[token] = m.group(0)
            counter += 1
            return token
        for msg in messages:
            msg["content"] = re.sub(r"1[3-9]\d{9}", replace, msg["content"])  # 手机号
        return messages, mapping

    def _unmask(self, text, mapping):
        for token, original in mapping.items():
            text = text.replace(token, original)
        return text
几个工程要点:
- 占位符要可逆且唯一 用计数器生成
<PII_n>比固定字符串安全,避免不同用户的 PII 串台 - 恢复只在响应出口做 模型、下游工具、日志拿到的都是占位符
- 别只靠正则 真实生产用 Presidio、Microsoft 识别器或自训 NER,地址、姓名、银行卡正则覆盖不全
第三节:对话摘要压缩——历史太长时的取舍
多轮对话一久,历史消息会无限涨,token 直接爆表,还挤占模型的有效注意力。摘要压缩中间件干的事是:当历史超过阈值,把最旧的若干条交给一个压缩模型生成摘要,用一条摘要消息替换它们。
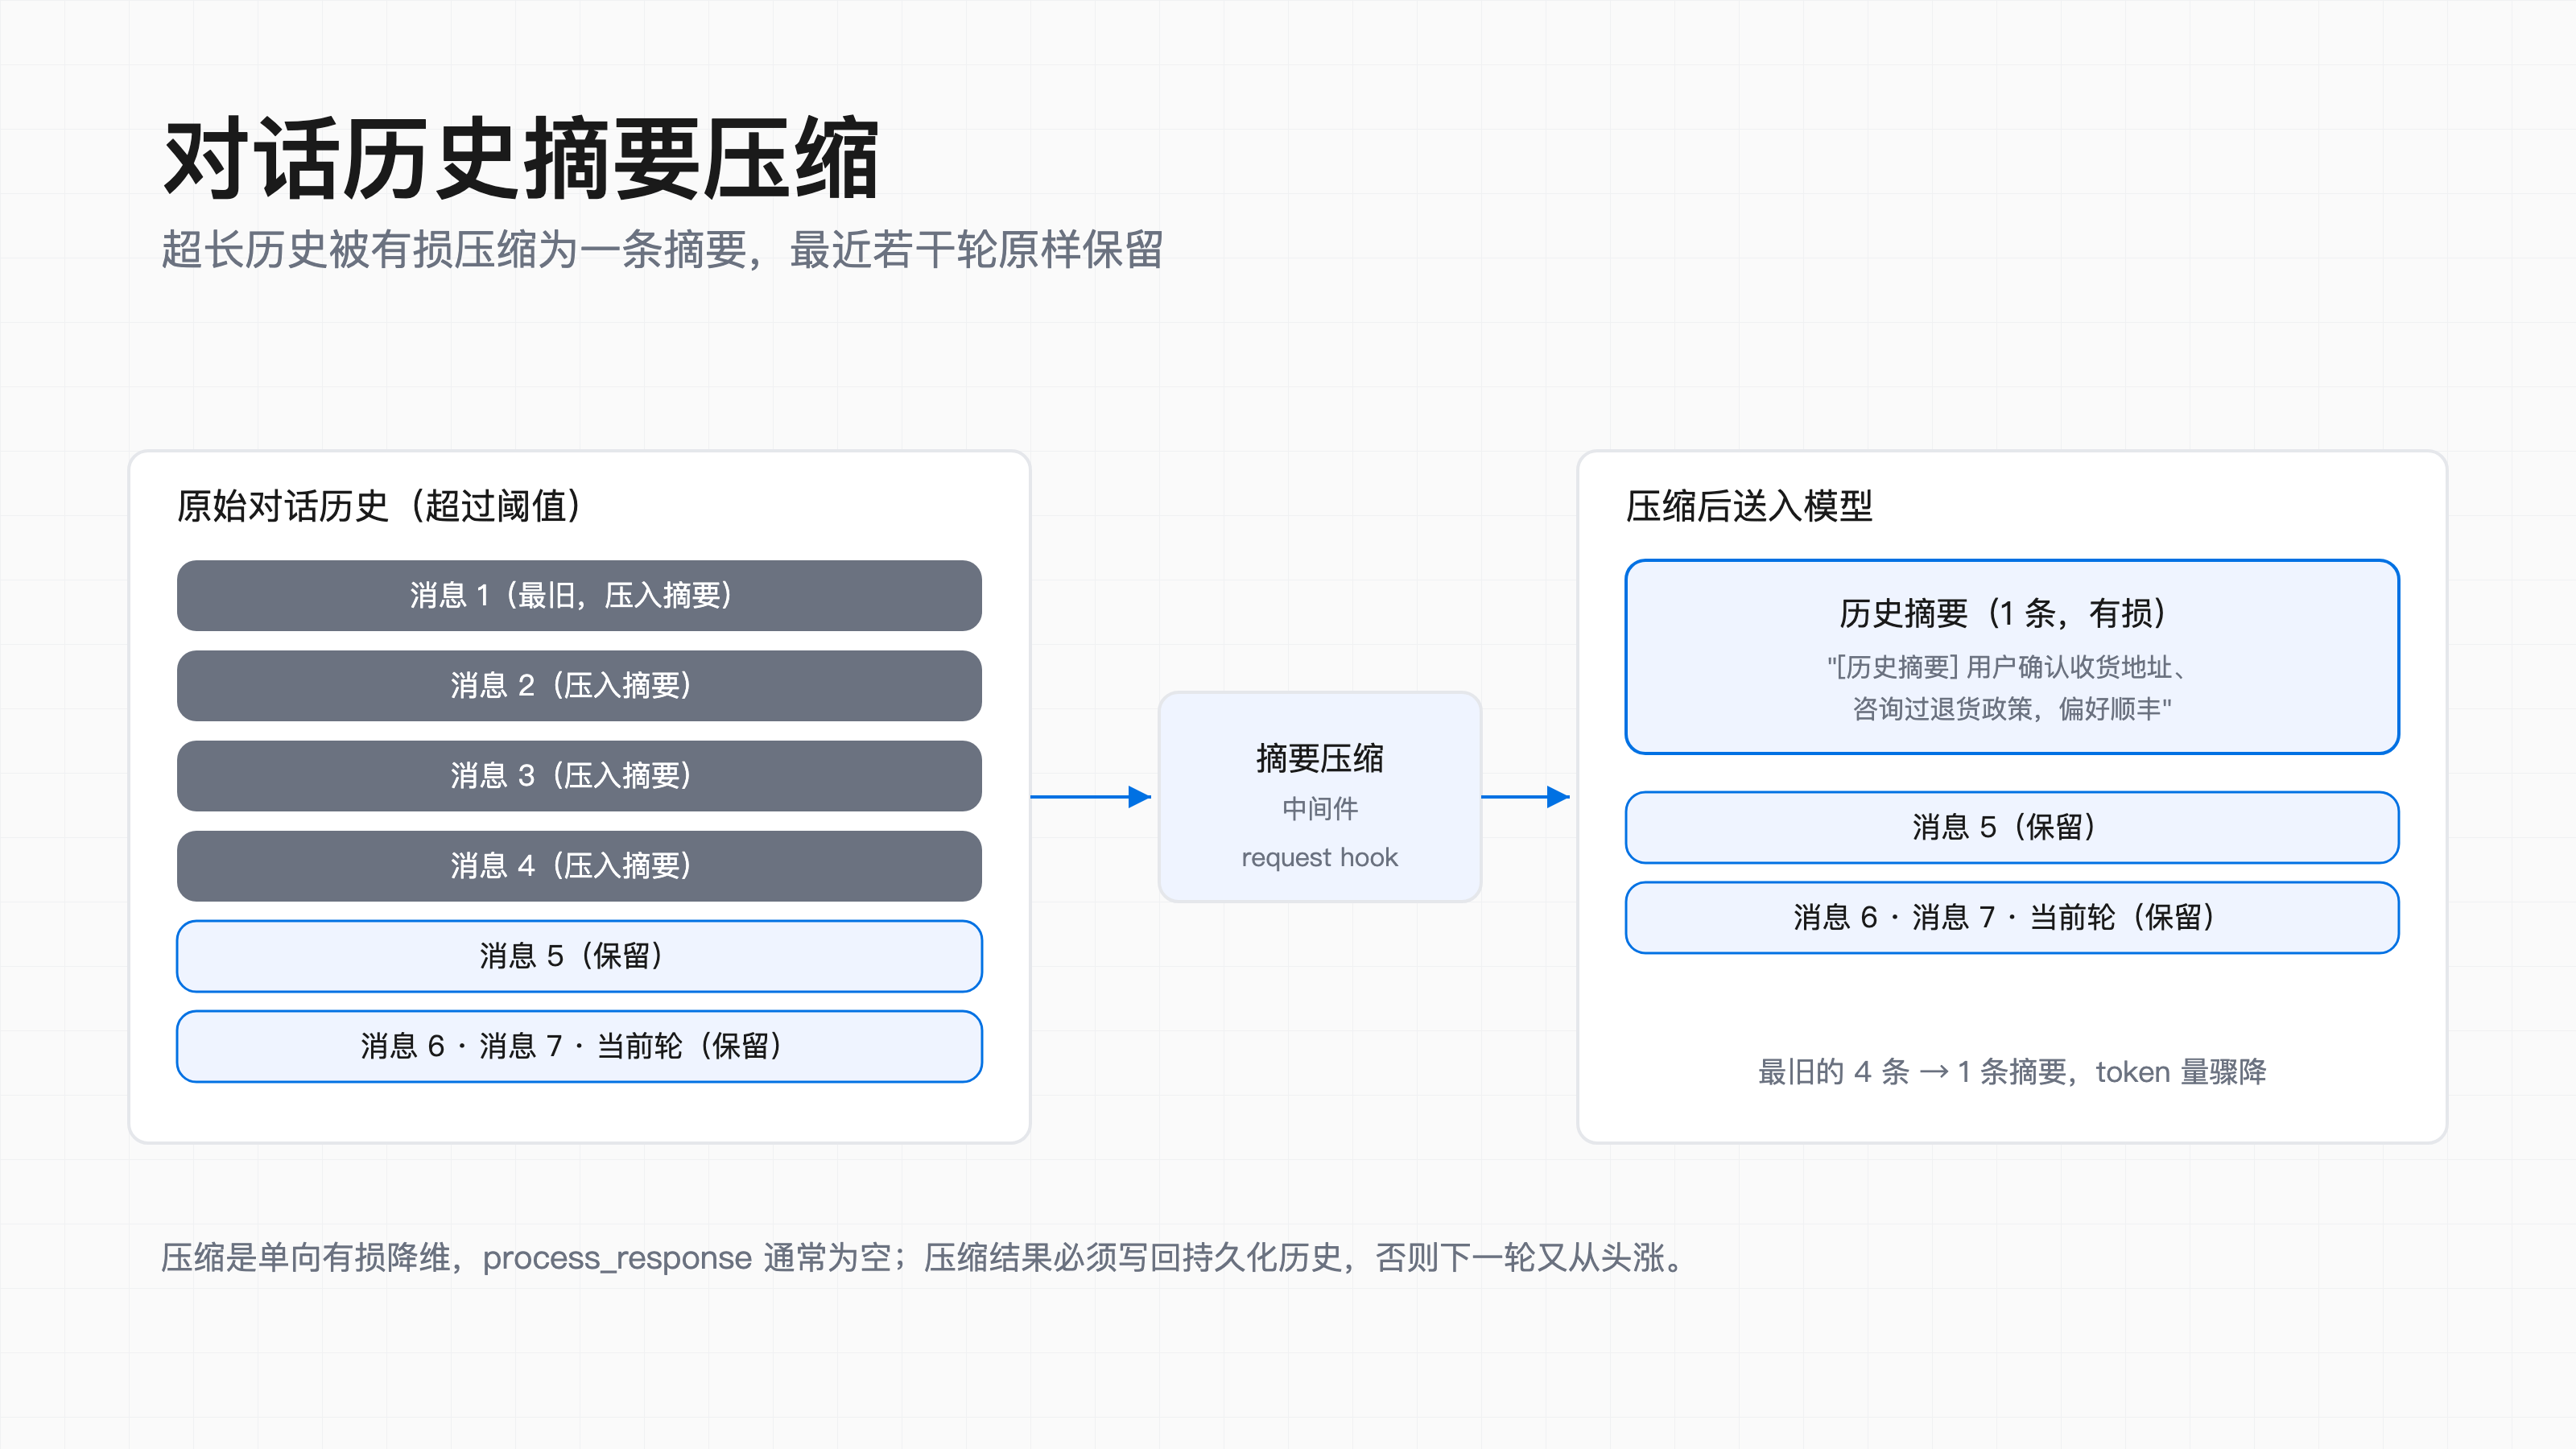
这是有损降维,不是无损存储。设计时必须回答三个问题:压哪些(通常最旧的)、留哪些(最近的 Few-shot 和当前轮)、压完往哪放(压缩结果要写回持久化历史,否则下一轮又从头涨)。
class SummaryCompressionMiddleware:
    def __init__(self, max_messages: int, summarizer_fn):
        self.max_messages = max_messages   # 保留的最近消息条数
        self.summarizer = summarizer_fn    # 调用压缩模型的函数

    def process_request(self, ctx):
        msgs = ctx.messages
        if len(msgs) <= self.max_messages:
            return ctx
        # 最旧的 (总数 - 上限) 条送去压缩
        cut = len(msgs) - self.max_messages
        to_compress, keep = msgs[:cut], msgs[cut:]
        summary = self.summarizer(to_compress)
        ctx.messages = [{"role": "system", "content": f"[历史摘要] {summary}"}] + keep
        return ctx

    def process_response(self, ctx):
return ctx # 压缩不可逆,响应方向不做事- 压缩是单向的 所以
process_response通常是空实现,这点要和 PII 区分开,别搞混 - 阈值按 token 算 按消息条数拍脑袋不稳,一条消息长度差异巨大
- 压缩子调用也要过脱敏 否则历史里的隐私会在 summarizer 那一步裸奔,这是顺序问题,下一节细说
它和"记忆(memory)"不是一回事:memory 是把历史存下来,压缩是把历史变小。两者常配合,但职责不同。
第四节:人工介入——在关键步骤踩刹车
有些动作不能让模型自己拍板:发邮件、转账、删库、对外发消息。这时候需要 HITL(Human-In-The-Loop,人工介入):在管道或状态机里暂停,把决策权交给人,人确认后再继续。
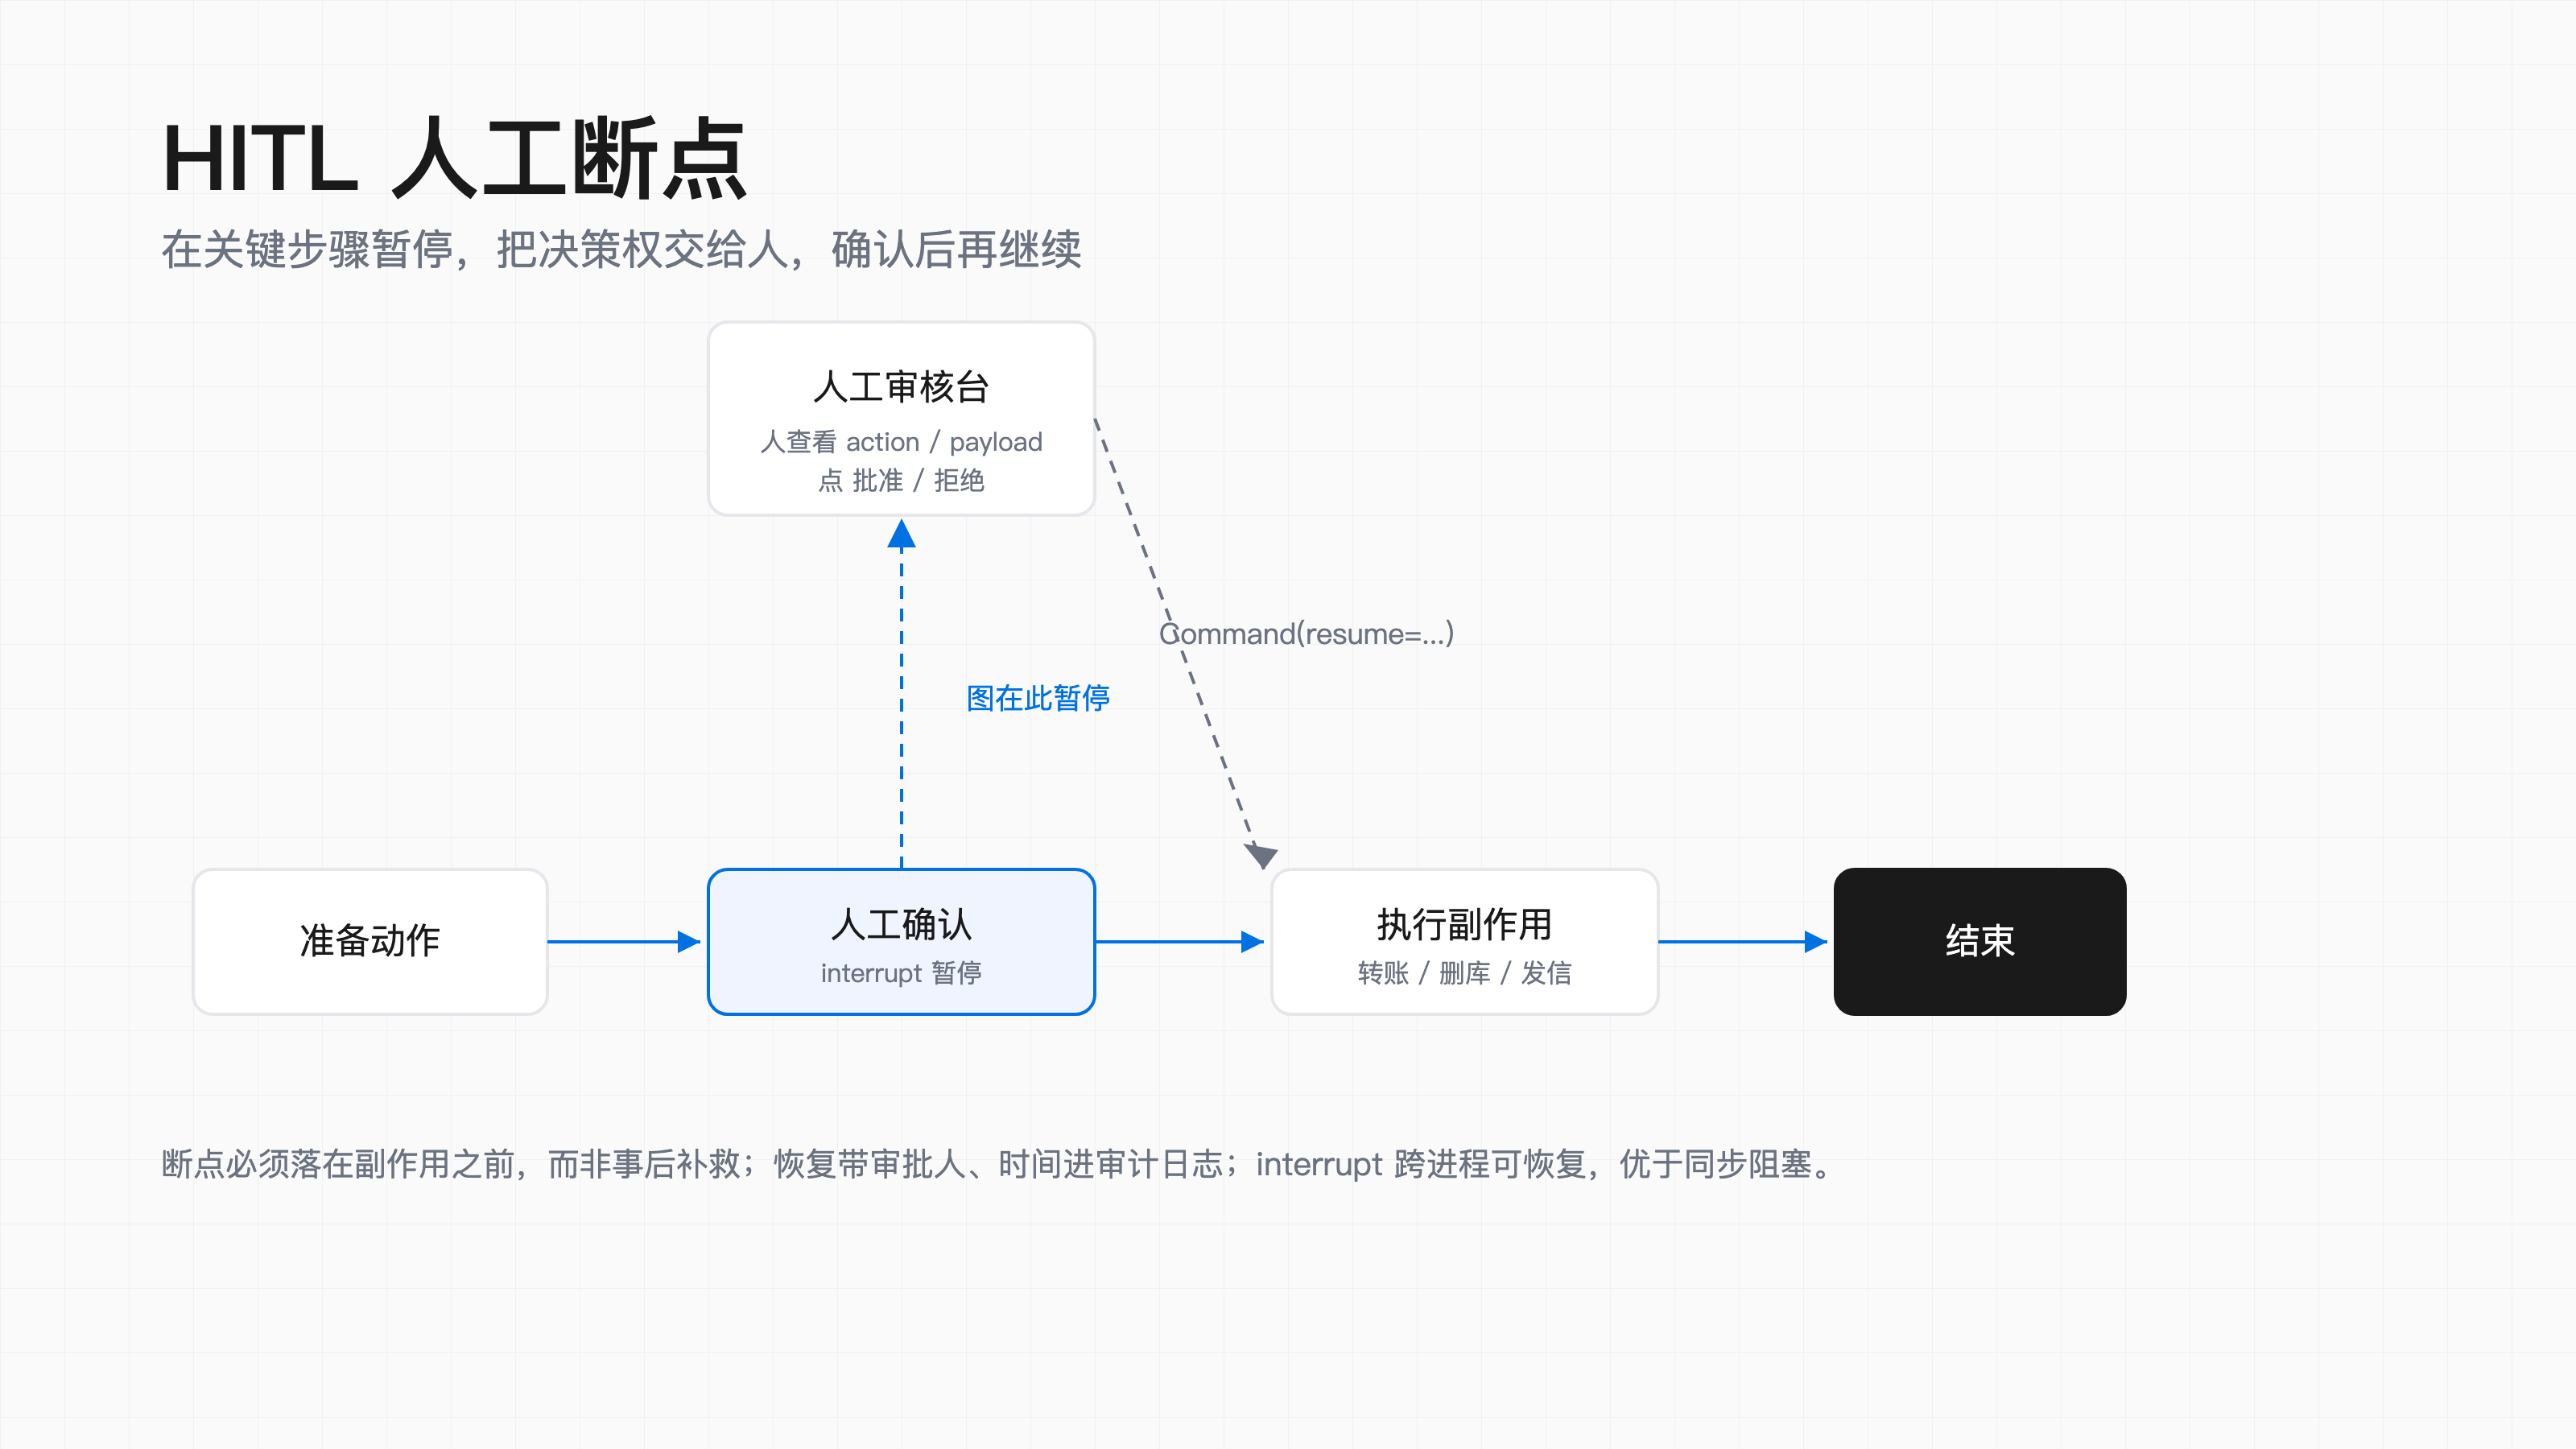
LangGraph 的 interrupt() 是这个模式的标杆实现:它不是在代码里写个 input() 卡住线程,而是在状态机层面暂停图执行,把需要确认的内容交还给调用方,外部用 Command(resume=...) 恢复。这意味着暂停可以跨进程、跨网络、带超时、可审计。
from langgraph.graph import StateGraph, START, END
from langgraph.types import interrupt, Command

def approval_node(state):
    # interrupt 暂停图,把待确认信息交还调用方
    decision = interrupt({
        "action": state["pending_action"],
        "payload": state["payload"],
    })
    return {"status": "approved" if decision["approve"] else "rejected"}

builder = StateGraph(dict)
builder.add_node("approval", approval_node)
builder.add_edge(START, "approval")
builder.add_edge("approval", END)
graph = builder.compile()

# 第一次调用:图在这里暂停,返回需要人工确认的内容
result = graph.invoke({"pending_action": "transfer", "payload": {"amount": 5000}})

# 人工在后台确认后,用 Command 恢复
result = graph.invoke(Command(resume={"approve": True}))- 断点要落在副作用之前 转账节点之前先 approval,而不是转完再问"要不要撤回"
- 恢复必须带上下文 人确认了什么、谁确认的、什么时候,这些要进审计日志
- 图的 interrupt 优于同步阻塞 如果只是简单阻塞,中间件在
process_request置blocked_pending_human也行,但可恢复性和持久化远不如 interrupt
第五节:组合与顺序,以及反模式
中间件最容易被低估的一点:顺序即语义。它们叠成一条栈,前一个的输出是后一个的输入,换个顺序行为完全不同。
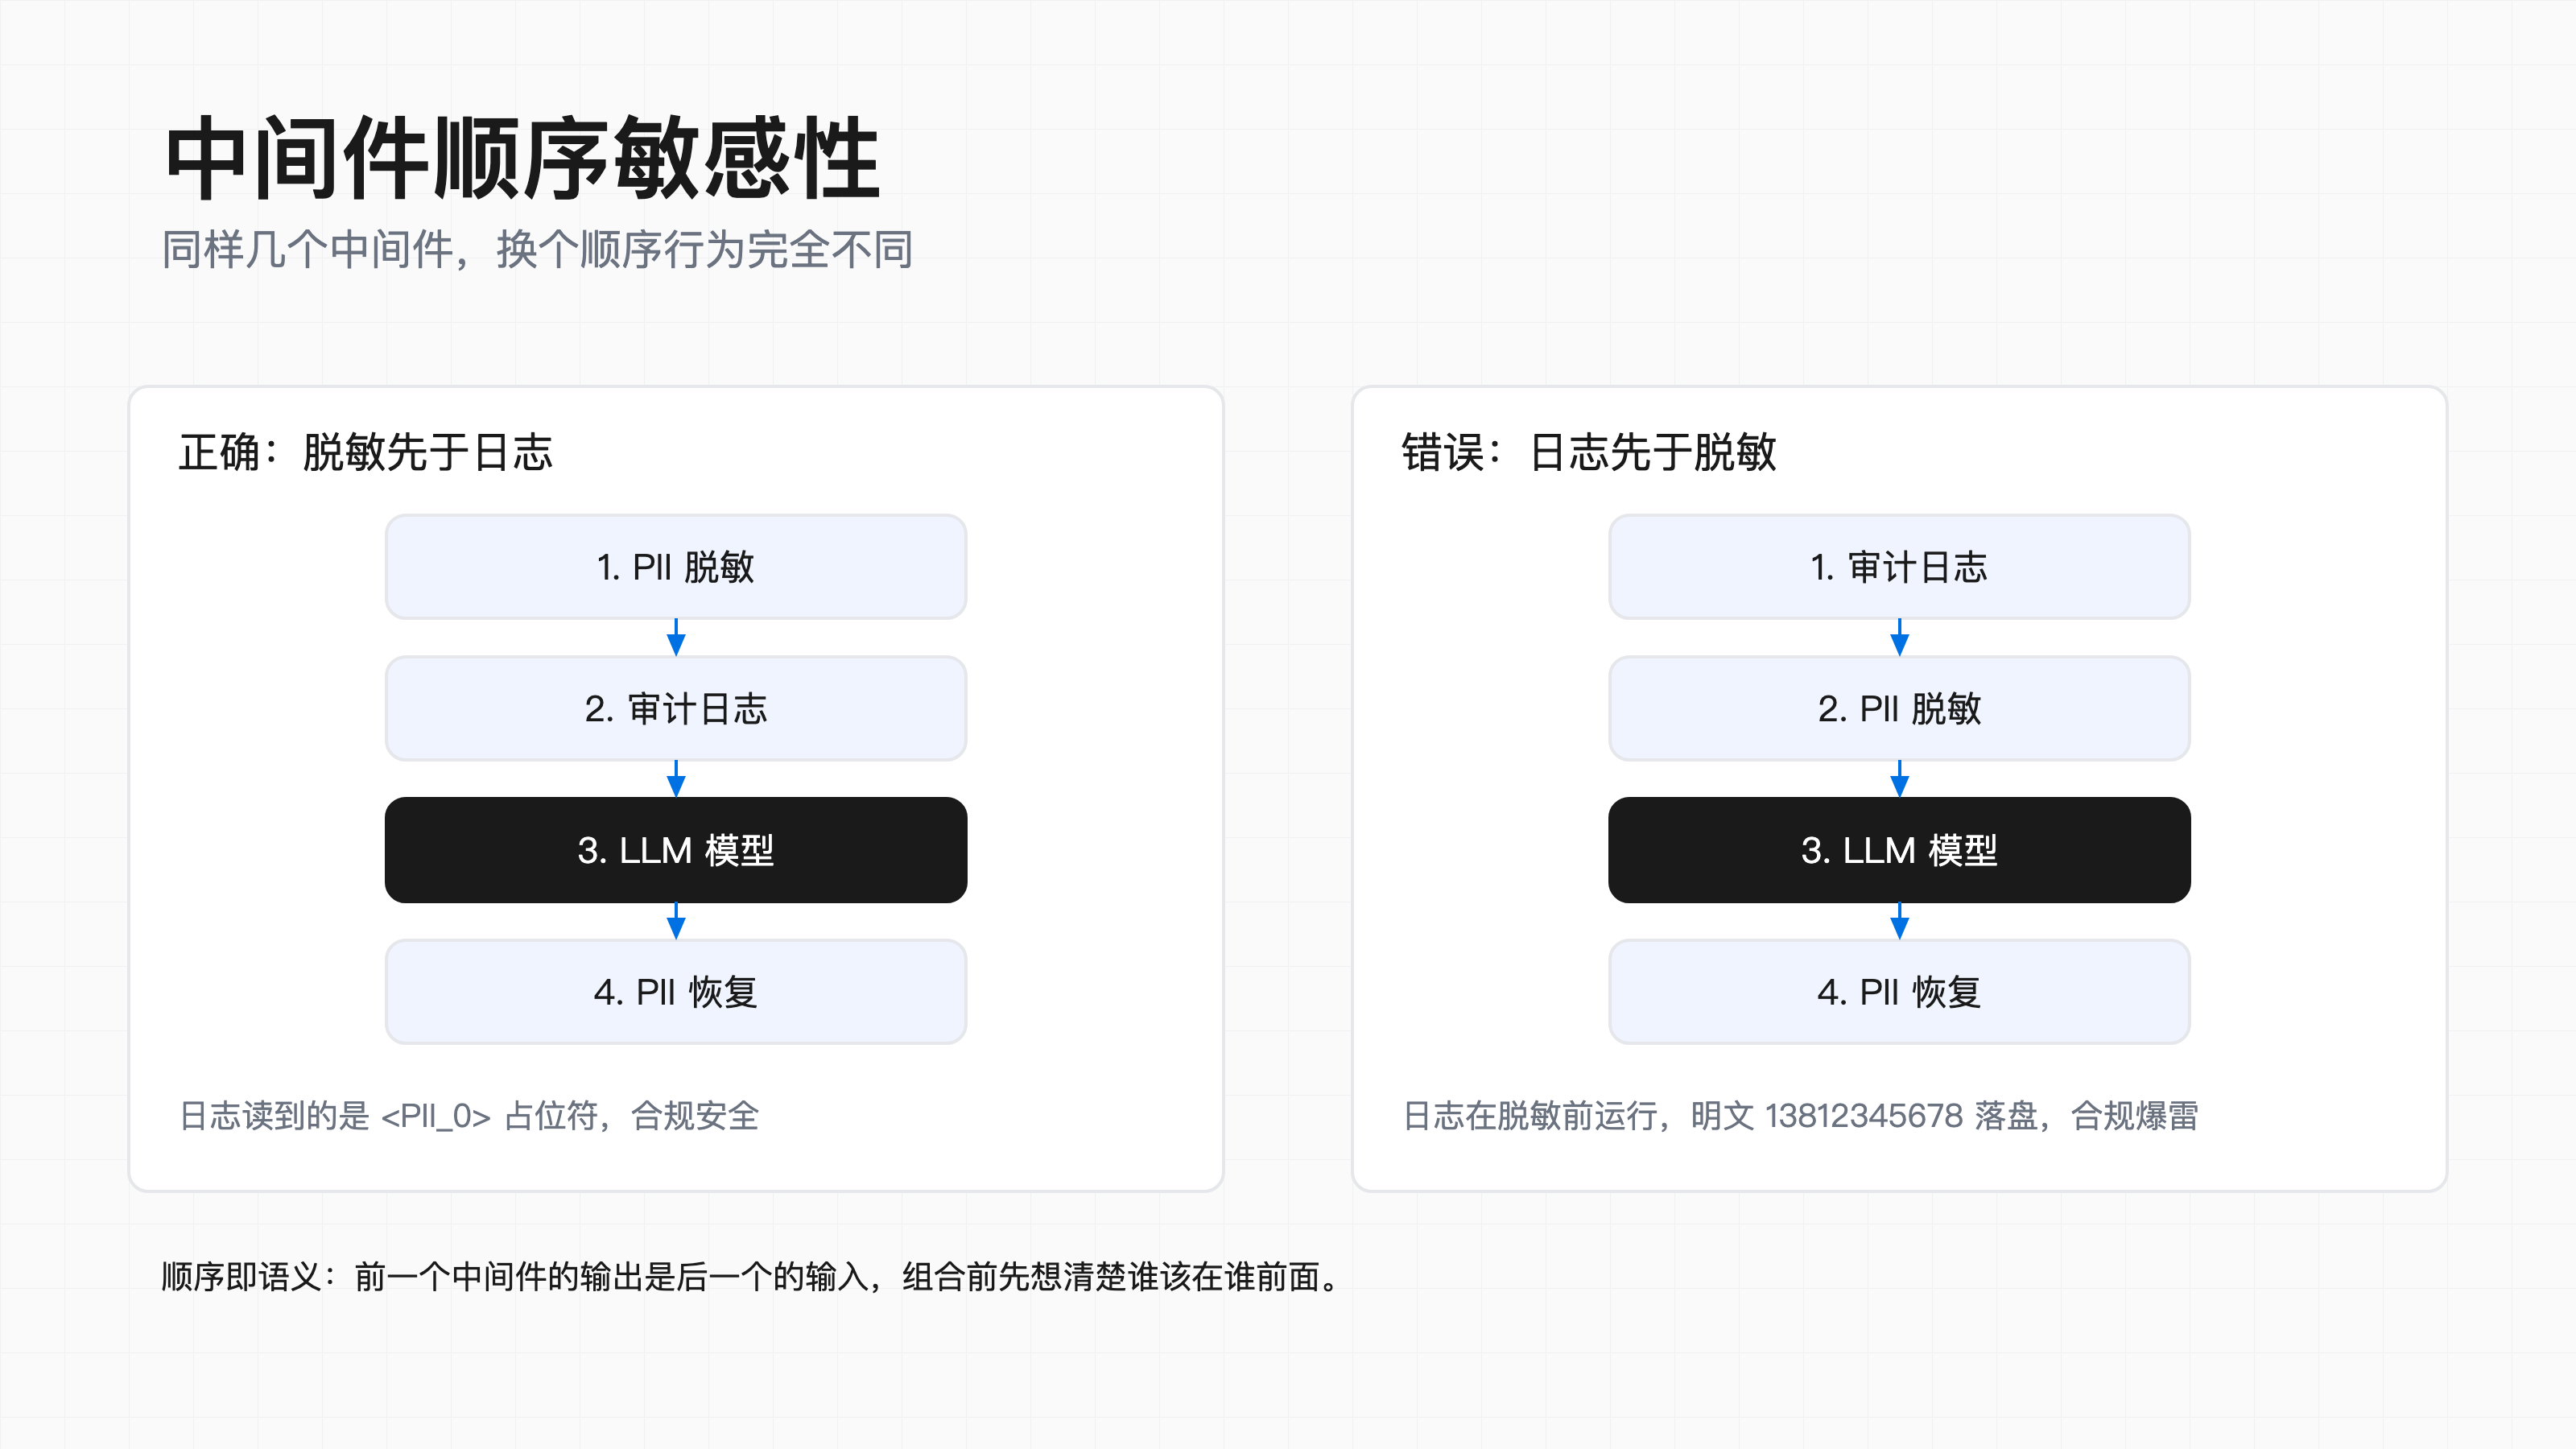
最经典的坑是日志中间件和 PII 中间件的位置关系。如果日志在脱敏之前运行,明文 PII 就写进了日志——合规直接爆雷。正确顺序是脱敏先行,日志后行,日志里只有占位符。
- 脱敏要覆盖压缩的子调用 压缩中间件会调一个子模型去总结历史,如果 PII 脱敏只包住主调用没包住子调用,历史里的隐私会在压缩那一步裸奔。要么让脱敏也包住 summarizer,要么保证压缩发生在脱敏之后、且子调用复用同一套脱敏
- HITL 要挡在副作用最前面 审批节点必须早于任何写操作,顺序错了就是"先斩后奏"
- 响应方向逆序恢复 PII 恢复必须是最后一个响应钩子,否则恢复出的明文会被后面的中间件(比如再次日志的环节)看到
反例与反模式,这些是我在 code review 里打回最多的写法:
- 反模式一:巨型 prompt 把脱敏规则、压缩指令、校验逻辑、人工确认提示全写进一个超长 system prompt。模型听不听随缘,最关键的是没法单测——你永远无法确认"脱敏"这个关注点真的生效了,只能靠肉眼看输出
- 反模式二:逻辑散落业务代码 在 handler 里随手写
if '1' in text: hide(),脱敏、压缩、校验各写各的,顺序藏在调用时序里,新人根本看不到全貌,一改就串 - 反模式三:顺序随意 先打日志再脱敏导致明文落盘;先压缩再脱敏导致子调用泄露;恢复明文的钩子排在审计钩子之前导致审计看到明文
- 反模式四:HITL 写死同步阻塞 在推理路径里直接
input()或同步等待,没法在异步服务、分布式部署里恢复,重启即丢状态,也无法超时和审计
回到本质:中间件的价值不是"多一层包装",而是把横切关注点变成可测试、可组合、顺序明确的单元。当脱敏是一个中间件、压缩是一个中间件、人工确认是一个中间件,你就能像搭积木一样组合它们,每个都能单独写单测,组合起来行为可预测。这才是 AI 工程化该有的样子。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号