【征文】从 47 道简答题到可复算的学情画像:我用 WorkBuddy 把一份"没法算"的问卷做成了评价体系
原创
【征文】从 47 道简答题到可复算的学情画像:我用 WorkBuddy 把一份"没法算"的问卷做成了评价体系
原创
用户12833963
发布于 2026-10-21 17:01:06
发布于 2026-10-21 17:01:06
【征文】从 47 道简答题到可复算的学情画像:我用 WorkBuddy 把一份"没法算"的问卷做成了评价体系
素材域:高等教育 · 学情调查 · 大学生质性评价
本文记录一次真实的学情调查分析:91 人 × 47 题、4,277 个自由文本作答单元格,用 WorkBuddy 建五维分类、五档编码与"统计四件套",把一份"算不出可靠数"的问卷做成可复算的评价体系,并沉淀为可复用的设计规范。
一、一个真实的教学难题:91 份问卷,4277 个格子,却算不出一个可靠的数
我是广州城市理工学院汽车与交通工程学院的一名教师,主讲汽车理论、汽车设计等课程。2025 年春季学期,我对两个教学班共 91 名学生发放了一份 47 题的教学学情调查——简答题为主,学生用自由文本作答。
回收后的窘境,做过学情调查的老师大概都懂:
- 91 人 × 47 题 = 4,277 个作答单元格,其中 1,174 个不同的值——"是的""是的,我一般会""应该会""看情况吧"……全是自由文本;
- 想算一个"认同率",却发现口径根本没法定义:47 题里既有是非判断,又有"每天学几小时"的填空,还有"谈谈你的理解"的开放题——把它们塞进同一个分母,等于把秒表和卷尺相加;
- 就算硬算出一个百分比,也回答不了我最关心的问题:某题的"高分"究竟是全班共识,还是两极分化?
这份问卷的数据一放就是一年多。直到 2026 年 9 月,我把它连同一批归档资料投喂给了 WorkBuddy 中的执行体,用 10 天左右的时间,把它做成了三个可直接落地的成果:五维题项分类体系、五档编码与统计四件套、一份 91 人的完整分析报告——并进一步沉淀为一份可复用的《学情调查设计规范 v1.0》。
这篇文章完整还原这个过程:输入材料 → 配置 → 操作步骤 → 产出物,给同样被"自由文本问卷"困住的高校同行一条可复用的路径。
二、输入材料:把"历史包袱"原样投喂,而不是先清洗
我没有预先清洗数据,而是把所有原始材料直接投进去,让它先读原文、再提方案:
- 问卷母本:20250414 教学学情调查-题目.doc(47 题,含一张文档内嵌的旧四维归类表);
- 作答明细:1 班 48 人、2 班 43 人的问卷导出表;
- 一份此前的旧分析(其中"认同率"等指标口径存疑)。
第一步的产出就让我意外:直读原文后发现,问卷母本存在"占位语串行"残迹——问卷平台把上一题的"正确答案:实事求是回答"错位混进了下一题的题干位。第 20 题甚至因此整题失效:84 条作答里,17 人照抄"实事求是回答"、9 人只答"实事求是"、1 人直接写"这题没太看懂什么意思"、1 人只打了个问号——无效题的判定不是猜的,是有直接证据的。
经验一:投喂原始材料时不要"帮忙"清洗。残迹、错位、内嵌旧表,恰恰是发现问卷设计缺陷的线索
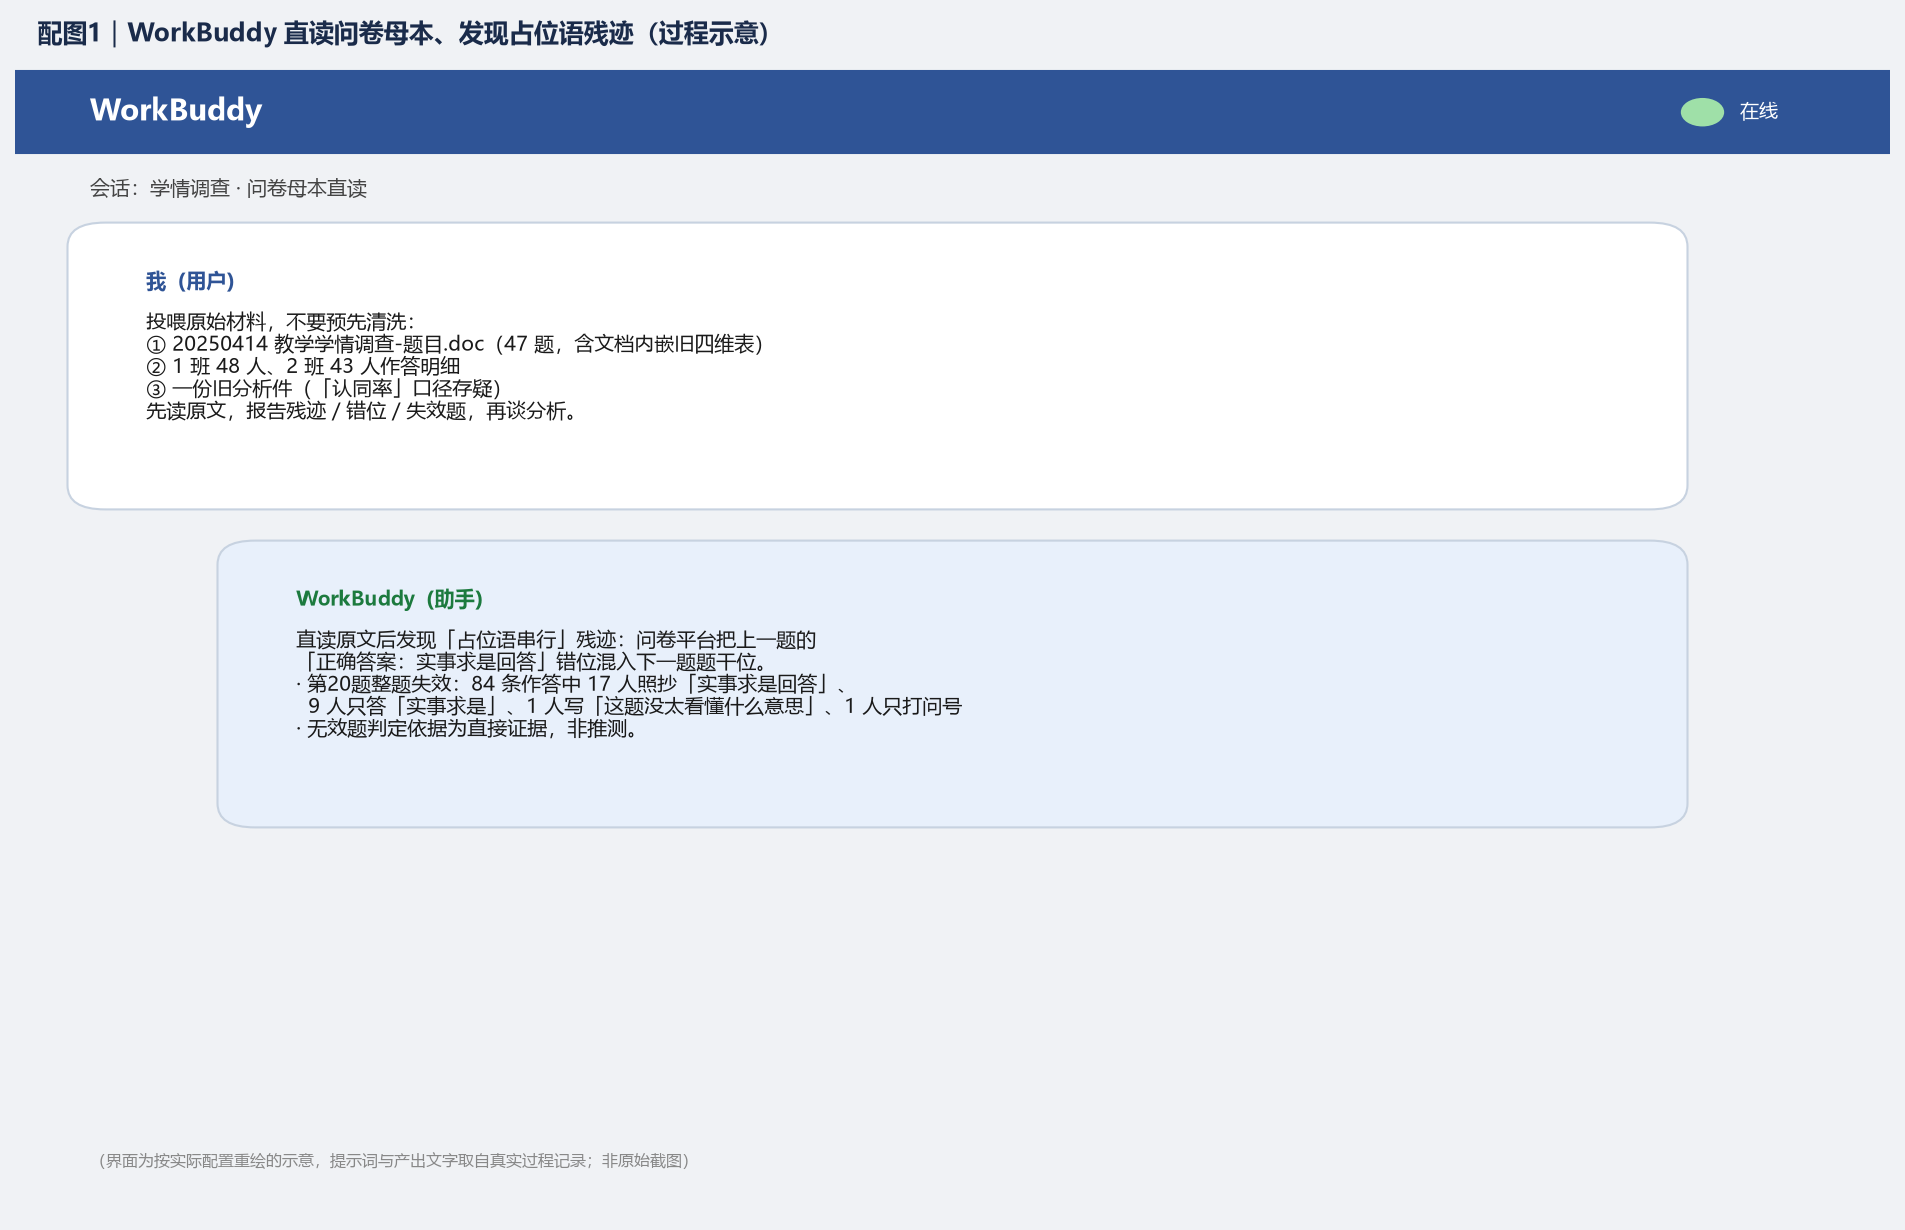
配图1_问卷直读残迹.png
图 1、WorkBuddy 对话中投喂问卷母本、直读原文并发现占位语残迹的界面
三、配置:让执行体带着"铁律"干活
本次的执行体是我在 WorkBuddy 中培养的领域助手,核心配置三条,均可直接复用:
- 岗位守则写入身份文件:①数字照原文精确摘录,严禁编造;②抓不到/读不了就如实说"待补";③引用学生原话原貌照录——笔误照录、存疑处〔校:××〕随文标注,不润色。
- 用任务台账驱动长任务:把"学情调查分析"拆成分类统计→编码口径→逐题分析→班际对比→观点选编五份交付件,逐件挂单、逐件销号。
- 统计中间产物落盘:编码结果存 JSON、报表存文本文件,为"可复算"留底(见下文步骤 3)。
对高校教师来说,第 1 条最重要:学情数据是要写进教研论文的,编造一个数字就等于给论文埋雷。
四、操作步骤:五步,把自由文本变成可算、可比、可复算的量纲
步骤 1:闭合五维题项分类(先定骨架)
逐题判读 47 题的归属,以文档内嵌的旧四维表为基准做修正,得到五维闭合方案:
调查维度 | 题项数 | 说明 |
|---|---|---|
自我认知 | 24 | 含末题元题目(直接测"这次调查本身有没有用") |
教育理念 | 7 | 师反馈/师互动等 |
学习方法 | 13 | 含 3 题"补归"(旧表完全遗漏,44≠47 的缺口所在) |
职业发展 | 1 | 学术活动与讲座 |
思政认知 | 2 | 自旧表"职业发展"中分出,对应课程思政落点 |
合计 | 47 | 24+7+13+1+2=47,与自述题量闭合 |
注意那处 44≠47:旧表漏了 3 题。没有"闭合校验"这一步,这个缺口会一路带进论文。
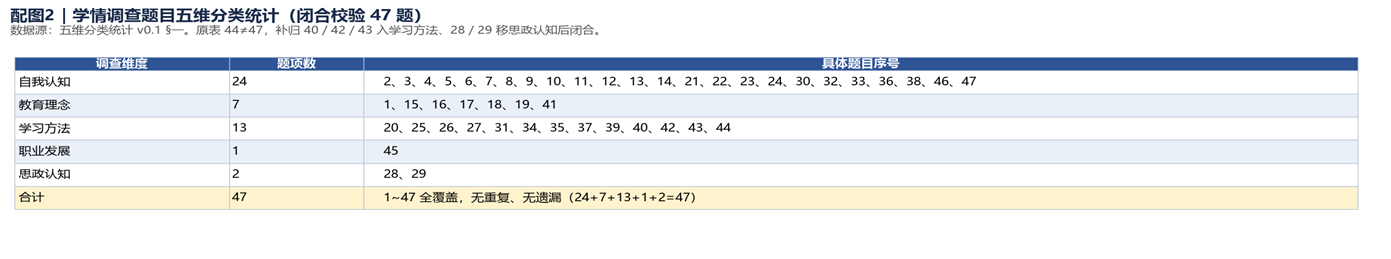
图 2、五维分类统计交付件的文档视图(注意脱敏路径中的个人录名)。
步骤 2:建立五档编码量表(统一量纲)
这是整套方法里最可照抄的一块。 所有自由文本按三级判定映射到五档:
判定级 | 规则 |
|---|---|
第一级 | 看作答首现关键词直接定档 |
第二级 | 识别显式否定("不""没""从不"等) |
第三级 | 含混兜底记中性;纯叙述不编码 |
五档量表与双刻度换算(可直接抄进 Excel):
档位 | 0–1 刻度(算比率用) | 1–5 刻度(算均分用) |
|---|---|---|
认可 | 1.0 | 5 |
偏向认可 | 0.5 | 4 |
中性 | 0.0 | 3 |
偏向不认可 | −0.5 | 2 |
不认可 | −1.0 | 1 |
0–1 刻度用于算比率,1–5 刻度用于算均分——与学校原有 5 分制评价天然可比,这一点很关键:教师看均分就知道学生在校评价轴上处于什么位置。
91 人实测:43 道定序题未编码残留 0 条,覆盖率 100%。
步骤 3:用"统计四件套"替代"认同率"
指标 | 算法(可直接抄) | 解决什么 |
|---|---|---|
认可率 | (认可 + 偏向认可)÷ 有效作答 | 口径明确、可复算 |
NPS 净认同度 | (认可+偏向认可 − 偏向不认可 − 不认可)÷ 有效作答 × 100,取值 −100~+100 | 一个数表达正负净优势 |
平均分 | 五档按 1–5 刻度映射后取均值 | 保留强度信息,教师一看就懂 |
离散度 | 极差或标准差 | 识别"看似共识、实为撕裂"的分化题 |
这里有一个值得单独讲的插曲:历史分析件的 NPS 书写公式与逐题结果表对不上(按书写式复算 Q17 得 +1.1,结果表却是 +8.0)。我让执行体反解校准——以 9 组"五档人数+净认同度"为约束枚举候选公式,唯一 9/9 全中者补上了"+偏向认可"项。结论:结果是实际跑出来的、公式是事后补记漏了一项,按结果为准、显式订正、留痕不改原件。
经验二:凡"公式与结果表不一致",一律反解校准,不默默沿用任一口径。这条纪律现在写进了我们的设计规范。
步骤 4:跑分析,读"落差带"而不是读排名
91 人的基线数据里,最有教学价值的不是哪题分高,而是"态度—行为落差带":
认知题(高) | 行为题(低) | 落差 |
|---|---|---|
Q16 老师反馈有用 4.82 | Q17 主动求反馈 3.17 | 1.65 |
Q22 反思有帮助 4.83 | Q36 定期总结梳理 3.76 | ≈1.0 |
Q27 竞赛有助动力 4.56 | Q26 参与过竞赛 3.61 | 0.95 |
学生不缺认识,缺的是可执行的最小习惯——这直接改写了我下一轮的教学设计(低门槛反馈入口、周计划卡),比一个笼统的"学生认同度 85%"有用得多。
配套的判读规则同样重要,四条一起用:
均分 | 离散度 | 判读 |
|---|---|---|
高 | 小 | 真共识 |
高 | 大 | 表面共识——找中性档人群个别了解(实测 Q40"学术氛围"中性档 13 人为全卷最多,不宜读成负面) |
低 | 小 | 真短板(Q17 即是,NPS 仅 +8.0,几近五五开) |
还有两处细节:唯一反向题 Q12 必须翻转计分并双标(含 Q12 自我认知 4.32/剔除 4.43,剔除值才是真实水平);"每天自主学习时长"用中位数 2.00 小时而非均值 2.67 小时——5 个 ≥6 小时的高时长学生把均值拉高了。
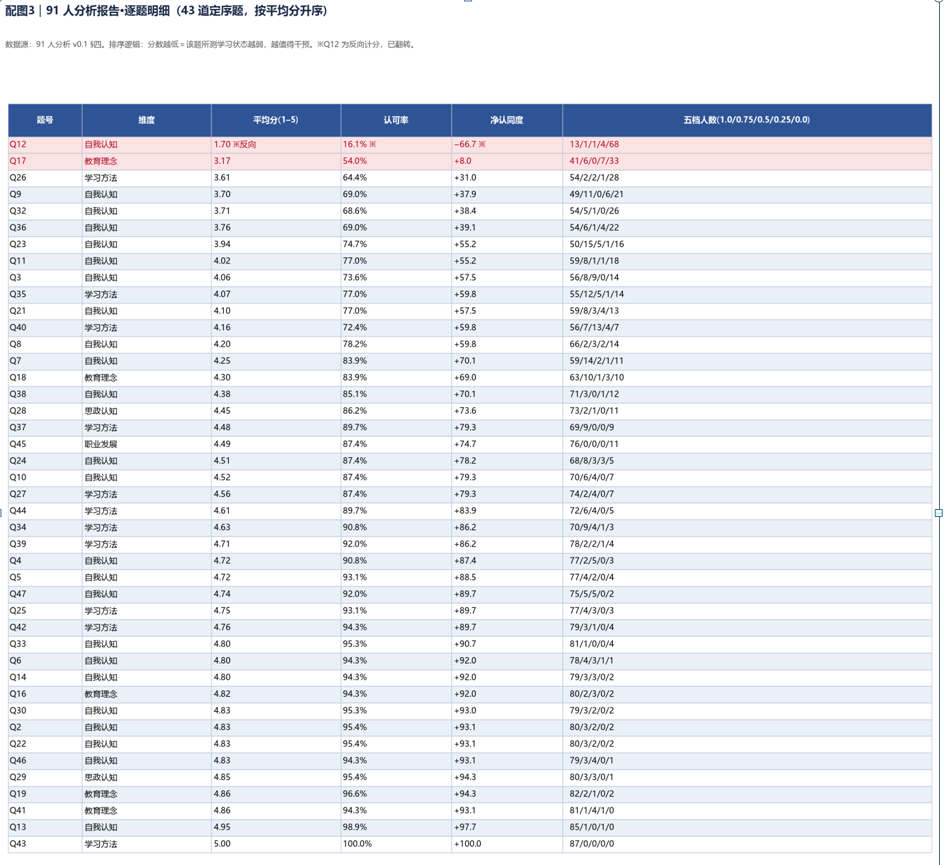
图 3、91 人分析报告中"逐题明细(按平均分升序)"表格视图(脱敏:隐去序号列)。
步骤 5:班际对比守"诚实纪律"
两班维度对比时,2 班在 8 题上反超,但差值全部在 +0.21 以内,且反超项恰是两班共同最弱题——最终结论写成"没有一道题显示 2 班具有实质性优势"。不好看,但比包装出来的虚假优势有价值。判据是 Cohen's d:只把 |d| ≥ 0.5 当作实质差异。
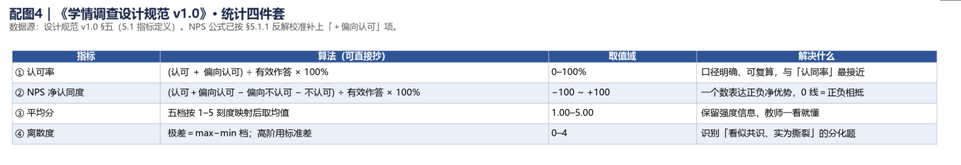
图 4、《学情调查设计规范 v1.0》中"统计四件套"章节视图。
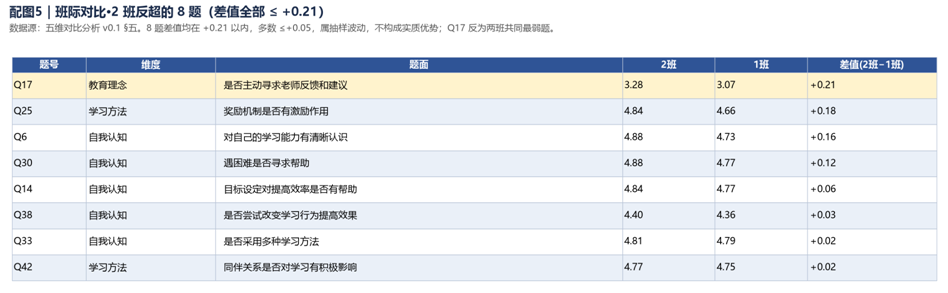
图 5班际对比表中"反超 8 题、差值 ≤+0.21"段落。
五、产出物:从一次性分析到可复用资产
本轮共沉淀四层资产,均已归档:
- 91 人分析报告:十章结构,含逐题五档人数明细(读者可自行验算每个比率);
- 五维题项分类表+三处修正说明:可直接抄入教研论文,服务思政论文与质性评价课题;
- 优秀观点选编:736 条候选(去标点空白 ≥8 字),先剔除 AI 粘贴件再遴选——实测发现 6–8 名学生的多题答案呈"论文体"同构、含无出处伪精确引用,长答案 ≠ 优秀观点,这是本轮最重要的反向发现;
- 《学情调查设计规范 v1.0》:把上述全部经验固化为"下次调查直接照做"的十二步复用清单,含题号冻结、板块三段式(事实→态度→行为,缺"行为"环是最常见缺陷)、施测前残迹清理清单、报告必附"统计口径与可复算说明"。
最后这一层才是 WorkBuddy 带来的质变:同类的调查,第二次起就不用从零摸索了——而当"三份成果被思政论文、质性评价、教育部社科课题三线共用"时,五维口径的统一也让交叉引用不再打架。
六、可照抄的提示词骨架
【角色】你是学情调查分析工具,不是写作助手。
【输入】<问卷母本>、<作答明细表>、<旧分析件(口径存疑)>
【任务】
- 直读问卷母本原文,先报"残迹/错位/失效题",再谈分析;
- 逐题判读维度归属,做闭合校验(各维度题数之和 = 总题数);
- 按五档量表编码,输出逐题五档人数明细(留存 JSON,供复算);
- 计算四件套:认可率 / NPS / 平均分 / 离散度;
- 标出"态度—行为落差带"与"高分离散题"。
【硬约束】
C1 数字一律来自输入材料,严禁编造、严禁估算;
C2 公式与结果表不一致时,反解校准并显式订正,不得沿用任一版本了事;
C3 班际差异只把 |Cohen's d| ≥ 0.5 判为实质差异,其余一律写"无实质优势";
C4 引用学生原话原貌照录,不润色;
C5 中间产物落盘,保证任何人可复算。
【产出】①分类表 ②编码明细 ③四件套报表 ④落差带清单 ⑤口径与复算说明
七、数据来源
- 本文全部数字照录以下既有交付件:《学情调查设计规范 v1.0》(2026-10-01);《学情调查题目五维分类统计 v0.1》《2022 新能源 2 班学情调查 91 人分析 v0.1》《新能源 1 班与 2 班学情五维对比分析 v0.1》(2026-09-23)。素材为 2025 春季学期两班 91 人 × 47 题学情调查的本地归档数据,未做外部数据收集;学生信息已按匿名口径处理,全文不含学生姓名与可识别个人的序号组合。
*本文为个人教学与教研工作流分享,数据均来自本人本地归档的学情调查记录,已去标识化处理。*
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号