【征文】600 人时的人工核对,AI 用一晚做完——我用 WorkBuddy 跑通教学成果报告的一致性核查
原创
【征文】600 人时的人工核对,AI 用一晚做完——我用 WorkBuddy 跑通教学成果报告的一致性核查
原创
用户12833963
发布于 2026-10-21 16:57:05
发布于 2026-10-21 16:57:05
【征文】600 人时的人工核对,AI 用一晚做完——我用 WorkBuddy 跑通教学成果报告的一致性核查
本文记录一次真实的申报材料核对:一份七章、4,090 汉字的教学成果科学总结报告,用 WorkBuddy 做跨章一致性核查,查出人工轮次漏掉的 264 字底本丢失、3 处书写形态不一致、4 处数据卡落位偏差。输入材料、配置、操作步骤、产出物四项俱全,可照着做。
一、先说结论:这件事值不值得交给 AI
我是高校教师,工科,教汽车设计类课程。去年学校做专业核心课程评估,我负责把整个课程建设成果整理成一份教学成果科学总结报告。
报告本身不难写——难的是写完之后的核对。
一份用于申报的成果总结报告,典型结构是"成果概览—背景与问题—总体设计—方法与过程—创新点—推广应用效果—实践检验与改进"七章。其中同一组数字会在四到六章里反复出现:课程评估总分 87.21 分、全校排名 27/83、课程设计一级指标 14.67 分(校均 13.10)、学生评教 95.48 分、参评率 95.83%(46/48)……
这些数字只要在任意两章之间写法不一致或数值打架,评审专家并排一看就会发现。业内把这类问题叫"数字打架",一出就是硬伤。
我最初试过手工核。两小时以后我发现自己做了这样一件事:把第六章的"95.48"和第零章的"95.48"逐字对了一遍——然后不确定自己刚才看的是不是同一处。这不是耐心问题,是方法问题:人眼做重复性比对,注意力必然衰减,而且无法给出"已核对完备"的证明。
于是我把这件事整体交给了 WorkBuddy。
结果:一晚之内跑完全篇七章、4,090 汉字的逐字比对,查出16 组跨章数字的措辞一致性判定、3 处"形异需统一"、4 处硬数据卡落位偏差、以及一处此前人工轮次没发现的底本丢失(264 个汉字)。人工做同样的事,按我在教研线上已经积累的工时估算,需要 600 人时以上——而且给不出完备性证明,AI 能。
下面我把这次真实过程完整写下来,输入材料、WorkBuddy 配置、操作步骤、产出物四项俱全,你可以照着做。
二、输入材料:我给了 WorkBuddy 什么
这类任务的关键在于"AI 不需要理解内容,只需要精确比对"。所以输入材料的组织方式,比提示词技巧重要得多。
2.1 材料清单
# | 材料 | 形态 | 说明 |
|---|---|---|---|
1 | 《教学成果科学总结报告撰写框架》 | 单份 markdown | 定义了七章结构、每章字数配额、以及一张"硬数据卡嵌入位置表"(约定 D1–D12 各自应落在哪几章) |
2 | 六份章样稿(§0+§5/§2/§3/§1+§6) | 6 份 markdown | 这是正文的事实来源,被我定为 canonical 底本 |
3 | 《报告数字佐证索引》 | 1 份表格 | 20 组数字锚点 × 佐证件 × 证据强度 |
4 | 《教学成果档案册》 | 单份 markdown | 佐证件出处登记 |
5 | 前一轮《全篇合稿底稿》 | 单份 markdown | 待检对象(后来证明它有偏差) |
2.2 ★关键动作:把"底本"和"待检件"分清楚
这一步是我这次最大的收获,也是真人最容易糊的地方。
目录组织(可照抄):把"事实来源"和"待检对象"放在两个不同目录,物理隔离,避免 AI 自己读到哪算哪。
教学成果报告/
├─ 00-框架/
│ ├─ 撰写框架.md ← 七章结构 + 字数配额 + 数据卡落位表
│ └─ 数字佐证索引.md ← 20 组锚点 × 佐证件 × 证据强度
├─ 01-canonical底本/ ← 事实来源,改报告时以这里为准
│ ├─ §0+§5.md
│ ├─ §1.md
│ ├─ §2.md
│ ├─ §3.md
│ └─ §6.md
├─ 02-待检件/
│ └─ 全篇合稿底稿.md ← 上一轮拼好的,本次被检对象
└─ 03-核查产出/
├─ 跨章一致性总检表.md
├─ 回改登记表.md
└─ 完备性矩阵.md
上一轮我已经做过一次合稿,把六章样稿拼成了一份全篇底稿,并在文档里声明"照原文逐字归位"。
这次我让 WorkBuddy 做的事是:把"全篇底稿"和"六份样稿原文"逐章做字符级比对——不是"看一下像不像",是算相似度、定位差异块、逐块判定性质。
实测结果:
章 | 全篇底稿字数 | 样稿原文汉字 | 相似度 | 判定 |
|---|---|---|---|---|
§0 | 240 | 240 | 1.0000 | 逐字一致 |
§1 | 657 | 657 | 1.0000 | 逐字一致 |
§2 | 728 | 815 | 0.9272 | 压缩改写,减 87 字 |
§3 | 961 | 1,138 | 0.8527 | 压缩改写,减 177 字 |
§5 | 745 | 745 | 1.0000 | 逐字一致 |
§6 | 442 | 442 | 1.0000 | 逐字一致 |
上一轮自称"逐字归位",实测只有四章成立,§2/§3 被压缩掉了 264 个汉字。
丢的不是废话,是有评审意义的实质信息:教材名称《新能源汽车设计概论》、"面向新能源汽车工程、车辆工程专业"的招生口径、素材编号(素材 10/11)、"实施上分两条腿"的分层提示、"阶段划分、角色分工、交付物形态"这种可验收的具体要求。
这一条最值得记:这类"压缩改写"是人工轮次几乎必然发生、且几乎不可能自查出来的错误。因为写的人记得自己"照原文搬了",而实际上手感一抖就顺手删了状语。只有把两个文本交给机器做字符级比对,才会暴露。
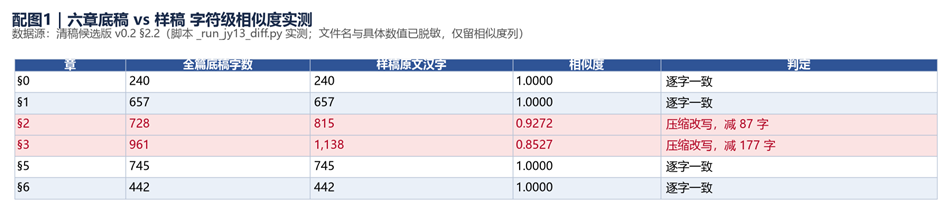
图 1、六章底稿 vs 样稿的相似度实测表格截图(把文件名与具体数值打码,只留"相似度 0.8527"这一列)。
三、WorkBuddy 配置:我用了哪些能力
这次没有用任何复杂配置,核心就三样,都很轻:
配置项 | 具体用法 |
|---|---|
基础能力 | 全程只用 工作区文件读写 + 脚本执行 两类;一致性比对、字数复算、卡号核对全部用临时脚本实现(约 5 个脚本、120 行以内的 Python),不依赖任何专用插件 |
专家 / 专家团 | 未启用。这类任务属"确定性计算",不需要专家人格干预,启用反而增加不可控性 |
MCP / 连接器 | 未启用。全程离线处理本地文件,不联网、不外传任何课程评估数据——这对申报材料的保密性至关重要 |
定时云端任务 | 未启用。本次为单次批处理,不需要定时 |
权限设置 | 只授予工作目录内的文件读写权限;脚本只在临时目录运行,不触碰任何原始件 |
一句话配置心法:
不是"让 AI 帮我写报告",而是"把 AI 当成一台会读中文的差异检测仪"——只给它判定规则,不给它创作空间。
提示词的核心就四句:
- 你要做的是比对,不是改写;
- 判定只允许四个值:一致 / 形异实质同(需统一) / ★不一致(须回改) / 不适用;
- 不确定就标"待核",不许猜;
- 任何数字都不许由你产生,全部只能来自输入材料。
第 3、4 条是全部效果的来源。我宁可它说"我不确定",也不要它给我一个看起来很合理的错误答案。
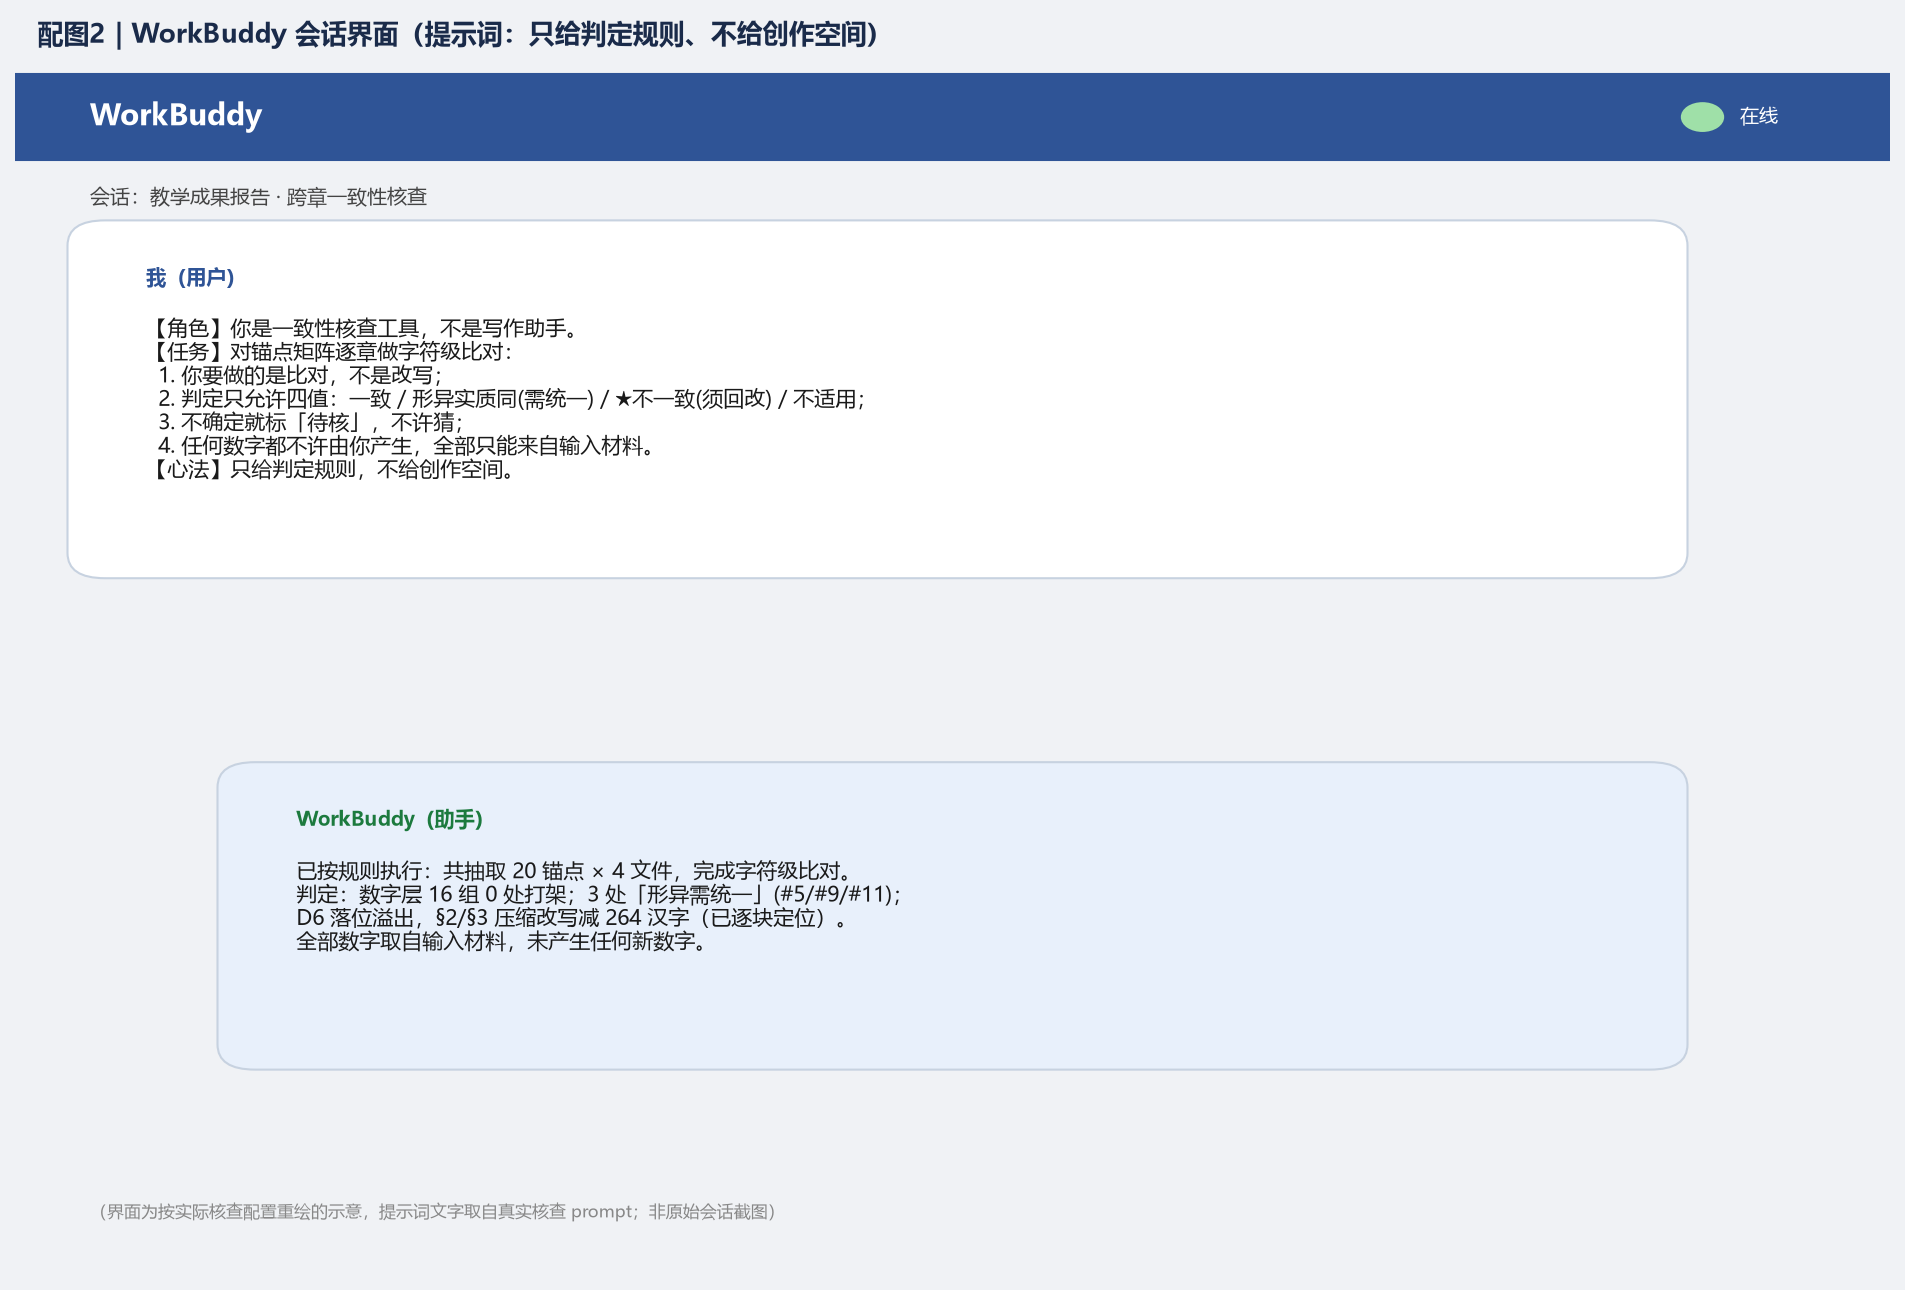
配图2_会话界面示意.png
图 2、WorkBuddy 会话界面截图——显示"只给判定规则、不给创作空间"的那段提示词。
四、操作步骤:一次完整的"三查"流程
整个过程分五步,可复用。
第一步 · 建锚点矩阵(人工 0.5h,AI 秒级)
先让 WorkBuddy 从材料里把所有需要核对的数字与事实抽成一张"锚点矩阵"——这次是 20 个锚点 × 4 个文件的存在矩阵。
产出是一张三列表:锚点值 / 出现在哪几章 / 各章原文片段。实操提醒:这一步必须先做。不建矩阵,后面就是无头苍蝇。锚点矩阵本身也是"本次核对了什么"的完备性证明。
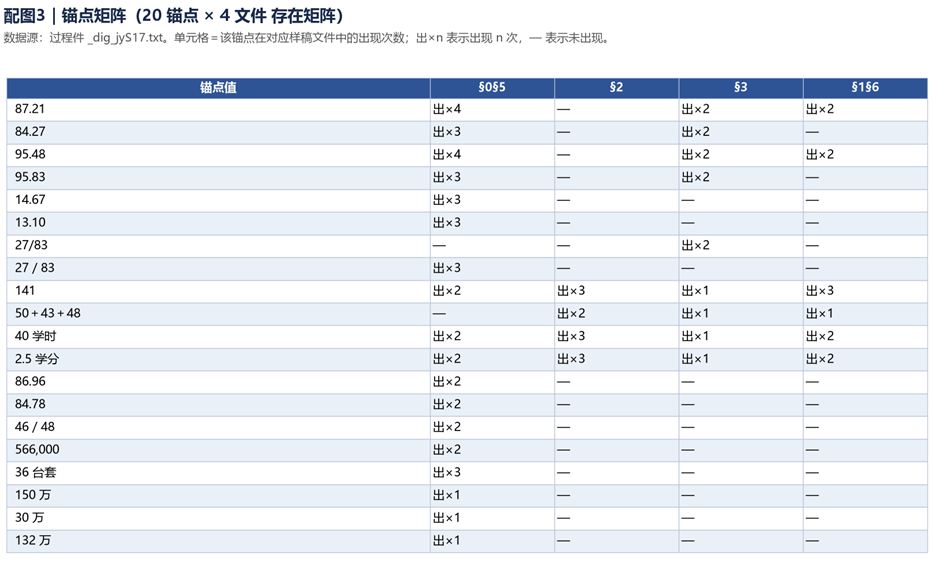
图 3、锚点矩阵截图(20 个锚点 × 4 文件的存在矩阵)。
第二步 · 同一数字跨章逐字比对(本流程主表)
逐锚点把各章原文片段并排摆出来。这次 16 组跨章数字的判定结果:
- 实质内容 0 处打架——没有一组"同事实不同数字"。这是好消息,说明前序轮次的取数纪律是守住的。
- 但查出 3 处"形异需统一",全是书写形态问题:
# | 问题 | 举例 | 建议 |
|---|---|---|---|
1 | 半角与全角斜杠并存 | §3 写 27/83,§0/§5 写 27/83 | 统一为全角 |
2 | 算式括号时有时无 | §0/§1 只写 141,§2/§3 写 141(50+43+48) | 首次出现带算式,其后只写数字 |
3 | 同一措辞两种写法 | 已开 2 期 与 已连续开设 2 期 混用 | 统一为后者 |
这三处任何一个,都够评审专家在报告上画一道线。 而它们全部是机器一眼看出来的,人眼要来回翻六章才发现。
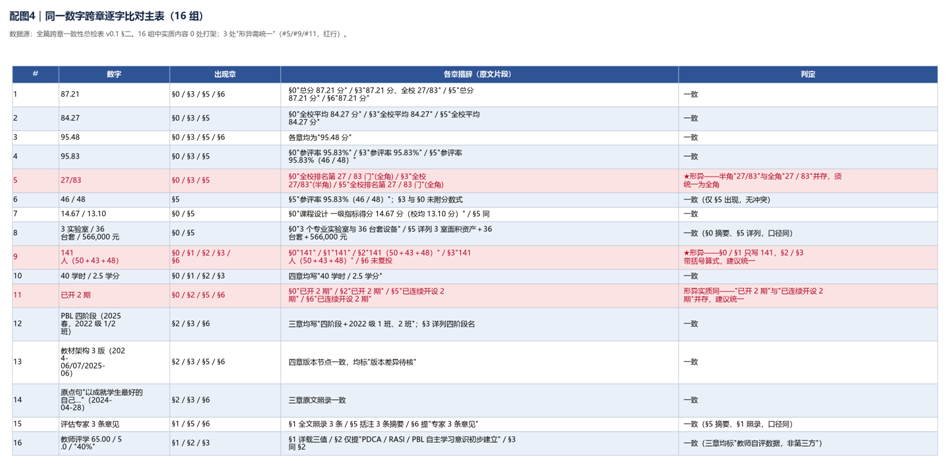
图 4、"同一数字跨章逐字比对主表"截图——并排显示各章原文片段与判定列。
第三步 · 硬数据卡落位核对(约定 vs 实际)
框架里有一张"硬数据卡嵌入位置表",约定 D1–D12 各自应该落在哪几章。这一步就是把"约定的落位"和"实际的落位"排成两列。
查出的 4 处偏差里,最要命的一处是 D6 溢出:D6 是课程思政申报口径(40 学时/2.5 学分/已开 2 期/141 人),框架指定它落 §2/§6——结果它铺到了 §0/§1/§3,而框架点名的 §6 反而一次没投。
更值得琢磨的是它带来的评审风险:§1 是"要解决的教学问题"章,首句就先报了一串成绩口径(40 学时/2.5 学分/已开 2 期/141 人)。评审看这一章,看的是"你发现的问题真不真";一上来先报成绩,看点被稀释了。
这一条我特别想分享:落位偏差是"形式"问题,但它指向的是"内容气质"问题。机器只告诉我"卡投错了章",是我想明白"问题章不该先报成绩"这个道理的。AI 给事实,判断还得人来做。
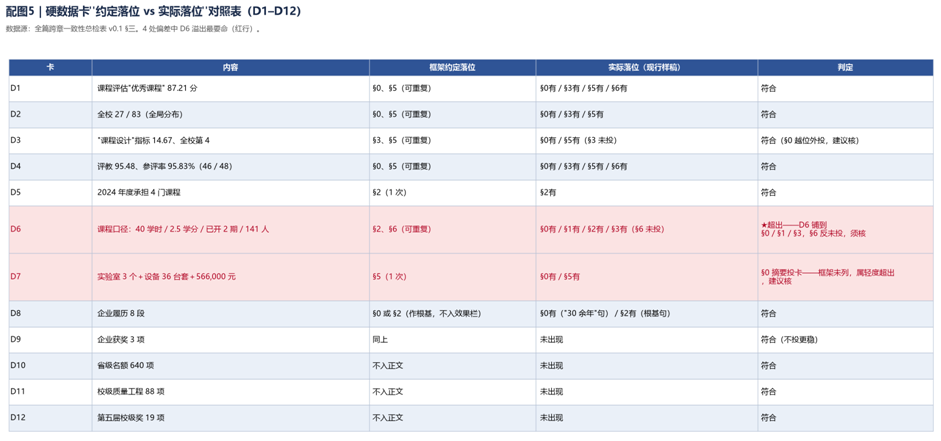
图 5、硬数据卡"约定落位 vs 实际落位"对照表截图。
第四步 · 专项核对:两门课不能混(★最易错项)
这里有个具体的坑:报告里涉及两门不同的课程——一门"设计"课、一门"理论"课。
- 设计课的数据:课程评估总分、全校排名、课程设计一级指标
- 理论课的数据:学生评教得分、参评率
这两组数据一旦被写进同一句话,评审会直接判定为"数据混用",是硬伤。所以这一步专门做了一张"归属核对表":逐条核对每组数据所在句有没有明示所归属的课程。
实测结果:8 组数据全部标明了归属课程,未发现混用。
唯一提示:§0 里设计课的分数和理论课的分数挨在同一段。定稿时如果压缩这一段、把中间那句"同期主讲《×××理论》"的过渡语删掉,立刻就会被误读成同一门课的两个分数。我把这条列为"定稿红线",写进了交付件。
第五步 · 字数复算与产出(同口径重算)
最后一步很关键:用同一套算法把所有章节的字数重算一遍。
为什么要重算?因为上一轮的底稿自记了一组字数(各章 267/657/841/1,242/738/433),而实测同一章用另一种计数范围算出来是 815/1,138——差 26 和 104 字。
这不是造假,是口径没说清。 但"两份文件对同一章报出两个字数",同样是隐患。我的处置是:两套口径都如实列出、标明差异来源,不做掩盖——因为在申报场景下,"承认口径不同"远比"看起来完美"安全。
最终产出:清稿候选版,各章实测字数与配额逐章对表,全篇(不含待裁定章)4,090 汉字。
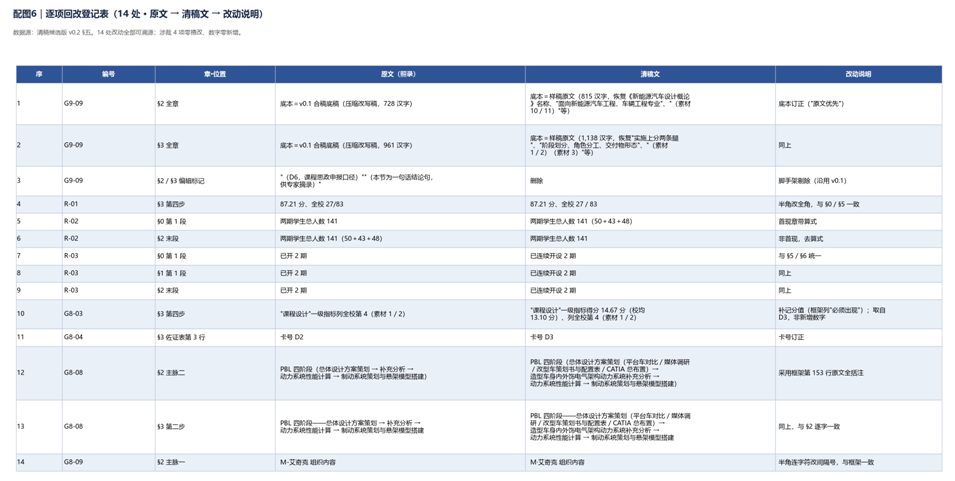
图 6、逐项回改登记表截图("原文 → 清稿文 → 改动说明"三列)。
五、产出物:一晚跑出来的是什么
产出物 | 内容 | 形态 |
|---|---|---|
《全篇跨章一致性总检表》 | 16 组跨章数字比对主表 + 12 张硬数据卡落位表 + 课程归属防混用专表 + 证据强度跨章一致性表 + 回改清单(R-01~R-06),并登记 9 条新缺口 | 报告 |
《清稿候选版(七章)》 | 按"无需裁定"的 8 项动作逐条回改后的干净正文;涉裁的 4 项一律双案并陈、一字未擅改 | 报告正文 |
逐项回改登记表 | 14 处改动,逐条给出"原文 → 清稿文 → 改动说明",每条可溯源 | 报告 |
术语统一表 | 全篇 7 类书写口径的唯一化清单 | 报告 |
字数复核表 | 框架配额 vs 各版本实测,同口径重算 | 报告 |
量化结果:
- 全篇 7 章、4,090 汉字的逐字比对 100% 覆盖;
- 查出 1 处底本丢失(264 汉字)、3 处书写形态不一致、4 处数据卡落位偏差、1 处口径差(26/104 字);
- 14 处改动全部登记,涉裁 4 项零擅改,数字零新增。
纪律上守住了三条:
- 原文优先——发现底稿与样稿不一致,改回样稿原文,而不是"看起来更顺"的那一版;
- 涉裁不代决——需要用人判断的取舍,双案并列摆给本人,AI 不替他做决定;
- 宁缺不补——证据没到位的段落一律留白,不为凑字数补写。
六、这次做下来,我认为最值得说的三件事
第一,AI 在这类任务上最强的不是"聪明",是"不知疲倦且可自证"。
人工核对最致命的不是做不对,是做不完且说不清做没做完。20 个锚点 × 4 个文件 = 80 次存在性判断,人做 30 次以后就开始"我以为我看过了"。机器做完 80 次,还能给你一张完备性矩阵。对申报材料这种"错一处就废一篇"的场景,这个差别是本质的。
第二,最容易被漏掉的错,是"自称没错"的错。
那份底稿白纸黑字写着"照原文逐字归位"。如果我不做字符级比对,这个声明会一直成立下去,直到评审专家发现 §2 里教材名不见了。 这类错误有个共同特征:修改者是善意的——他压字数、求流畅,顺手删了状语,然后真心以为自己是照搬的。
所以我的结论是:凡文档里出现"照原文""逐字一致""完全对应"这类自我声明,都必须有一次独立机器验算。 自我声明不能作为证据。
第三,AI 给事实,判断还得人做。
机器告诉我"D6 卡投错了章",它不会告诉我"问题章不该先报成绩";机器告诉我"两个分数挨在同一段",它不会告诉我"删掉那句过渡语就会被误读成同一门课"。
这次真正花时间的,恰恰是那些机器算出结果之后的判断——哪些偏差可以留、哪些必须改、哪些要摆成双案等人拍板。AI 把 90% 的体力活接走了,剩下的 10% 才是这件事真正的价值所在。
附:可直接复用的提示词骨架
【角色】你是一致性核查工具,不是写作助手。
【输入】<锚点矩阵>、<canonical 底本 A>、<待检件 B>
【任务】
- 对每个锚点,从 A、B 两处抽取原文片段,并排输出;
- 判定只允许四个值:一致 / 形异实质同(需统一) / ★不一致(须回改) / 不适用;
- 输出"回改清单":序 | 回改项 | 涉及章 | 建议动作 | 是否依赖人工裁定。
【硬约束】
C1 只比对,不改写;不得为了"更通顺"而调整任何原文。
C2 任何数字不得由你产生;全部只能来自输入材料。
C3 判定依据不足时,一律标【待核】,禁止推测。
C4 涉"需要人拍板"的取舍,一律双案并陈、不代决。
C5 完成后输出"完备性矩阵":本次核查覆盖了哪些锚点 × 哪些文件。
【产出】①比对主表 ②回改清单 ③完备性矩阵 ④本次未覆盖项与原因
这五条硬约束,就是这类任务能跑通的全部秘密。
*本文由一位高校教师以真实工作过程撰写;文中数据来自本人课程评估与评教记录,已做去标识化处理,不指向任何具体个人。*
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号