Linux:文件系统
原创
Linux:文件系统
原创
武状元
发布于 2026-10-21 10:44:03
发布于 2026-10-21 10:44:03
引言
我们都知道电脑中的文件存在磁盘中,那么磁盘是如何把数以万计的文件进行归类摆放,让我们能快速找到的呢?操作系统中存在一个文件系统,它负责将文件以目录的形式组织起来,并通过路径帮我们快速找到所需要的文件。这就像图书馆:几百万册书按分类摆进一排排书架,每本书有自己的编号,顺着索引就能找到它。
1.磁盘结构
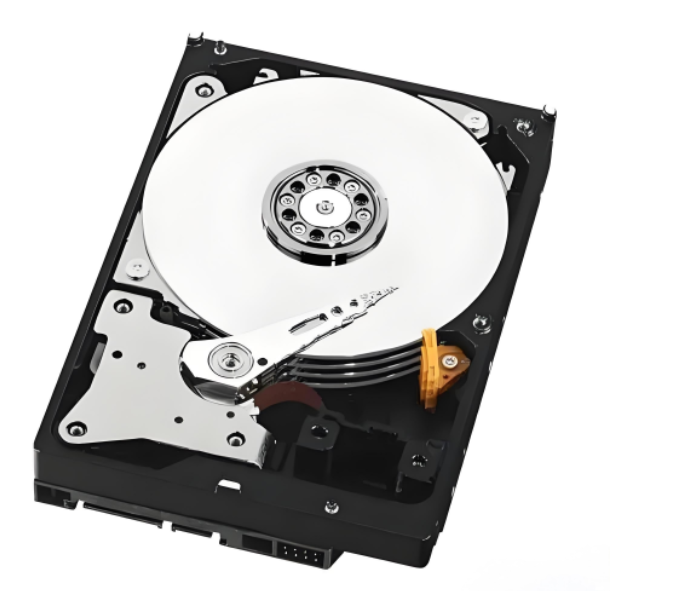
磁盘
磁盘的物理结构如图所示,一个磁盘由多个盘片叠加而成。盘片的表面涂有磁性物质,这些磁性物质用来记录数据。因为正反两面都可涂上磁性物质,故一个盘片可能会有两个盘面。每个盘片被划分为一个个磁道,每个磁道又划分为一个个扇区。其中,最内侧磁道上的扇区面积最小,因此数据密度最大。最外面的扇区数据密度最小,数据最多。每个盘面对应一个磁头。所有的磁头都是连在同一个磁臂上的,因此所有磁头只能“共进退”。磁盘的物理结构决定了最外面的磁道读取速度最快,因为磁盘在最外面的磁道线速度最快。
由于磁盘读取数据需要磁头读取,针对这一特性,在早期linux内核中,会使用电梯算法获取磁盘的数据,电梯算法就是像电梯一样获取数据,先是从头到尾获取一遍数据,然后在从尾到头。这样获取数据就是因为磁头的存在。因此,磁盘不能随机读取数据。
在磁盘中,扇区是磁盘存储数据的基本单位,一个扇区存储512 字节,哪怕只修改一个扇区内的一个字节,也必须把这 512 个字节全部加载到内存里,修改完后再写回扇区。
2.文件系统
硬盘是典型的“块设备”,“块设备”支持随机读取,与“块设备”相对应的是字符设备,我们的键盘就是一种字符设备,不支持随机读取,只支持顺序读取 操作系统读取磁盘数据的时候,其实是不会一个个扇区地读取,这样效率太低,而是一次性连续读取多个扇区,即一次性读取一个块 一般情况下连续八个扇区为一个块,大小为 4 KB,块是文件存取的最小单位
我们知道,文件 = 内容 + 属性。在 Linux 里,文件的内容和属性是分开存储的:内容放在数据块里,属性则用一个结构体来描述。这个描述文件属性的结构体就叫 inode。
inode 里保存的是文件的属性信息,比如文件大小、权限、时间戳、数据块位置等。一个 inode 通常占 128 字节;如果按常见的 4KB 数据块来算,一个块可以放下 32 个 inode。不过这是 ext2、ext3 时代的典型情况。ext4 默认把 inode 扩大到 256 字节,所以一个 4KB 块里通常只能放 16 个 inode。
这里有个关键点:文件名不会作为属性保存在 inode 中。因为文件名是字符串,长度可变,如果把它塞进 inode,就无法保证每个 inode 大小一致。为了识别文件,inode 里会有一个 inode 编号,用来唯一标识这个文件。
当文件系统和内存交互时,会一次性把一批 inode 读到内存里。如果两个文件的 inode 存储位置很近,往往意味着它们的创建时间接近,可能有一定关联。这种按块读取的方式也能提高读取相邻文件时的效率。
块组里都有什么?
一个块组里主要有这些区域:
- data blocks:里面有很多以 4KB 为单位的小数据块,文件内容就存在这里。
- block bitmap:记录 data blocks 中哪些数据块已经被占用,哪些还空着。
- inode bitmap:记录 inode table 中哪些位置被占用,哪些位置空闲。
- inode table:存放所有 inode 的表。
- GDT:块组描述符,描述块组的属性信息。
- super block:超级块,描述整个文件系统的信息。
删除文件时,并不需要真的把 inode 和 data blocks 里的内容全部抹掉,只需要把对应位图里的比特位置空即可。也就是说,这个位置被标记为“空闲”,后续可以重新分配。注意,这并不等于安全擦除,原数据在磁盘上可能仍然残留。
GDT 描述的是块组属性,比如这个块组里 inode table 从哪里开始、data blocks 从哪里开始、空闲 inode 和数据块还有多少等。整个分区分成多少个块组,就有多少个块组描述符。块组描述符在每个块组的开头都会有一份拷贝。
super block 描述的是整个文件系统的文件信息,比如一个组里有多少块、有多少 inode 等基本信息。因为每个组的大小构成通常相同,只要知道一个组里有多少块,就能结合文件系统总大小推算出有多少个组。super block 一旦被破坏,整个文件系统就可能不可用。不是每个块组里都有 super block,但有 super block 的组里的 super block 内容是完全一样的,相当于备份。
可以这样理解:block bitmap 像书架上“已借出”的卡片,翻一下就知道哪一格还空着;super block 则像图书馆的馆藏总目录,馆里有多少书、分几个区,全记在里面。
格式化和编号
文件系统的载体是分区。格式化,本质上就是把整个文件系统中相关的管理信息清零并重新建立。
inode 和数据块的编号是跨块组统一编号的:在同一个分区里,无论文件在不在一个块组,一个编号只能标识一个文件。但要注意,这种“跨组统一”是在同一个分区内部,不同分区各自有自己的文件系统结构。
这里有个很容易困惑的问题:我们平时找文件都是用文件名,从来不用 inode 编号,那为什么又说文件名不保存在 inode 里?我们到底是怎么通过文件名找到文件的?
答案是:目录本身也是一个文件。
目录也按照文件的方式保存,有自己的 inode 和数据。目录的数据内容里保存的,是“文件名到对应文件 inode 的映射关系”。所以,文件名其实保存在当前文件所属目录的数据内容中,而不是保存在文件自己的 inode 里。
这也是为什么执行文件时必须给出文件路径。操作系统要先打开文件所在路径,读取对应目录的数据内容,拿到文件名与 inode 的映射关系,才能在磁盘上找到文件的 inode 和数据块,然后才能执行。想打开某个目录,又必须打开它的上级目录。因此,找到任何一个 Linux 文件,都要从 / 根目录开始进行路径解析,直到找到目标文件。
路径缓存
如果每次访问文件都从 / 开始逐级解析,效率显然太低。上一次已经解析过的路径,访问另一个文件时又要解析一次,很浪费。
所以操作系统会把历史访问过的目录路径组织成一棵多叉树缓存起来。以后再打开相关路径时,如果前面已经被载入,就直接在这棵树里搜索;找到就直接使用,没找到就从磁盘加载,并把新路径加入缓存。
这棵树中的节点同时还会挂在 LRU 结构中,用于节点淘汰;也会挂在哈希表中,方便快速查找。整体上,这就构成了 Linux 的路径缓存结构,也就是 dentry 缓存相关机制。打开或访问任何文件,都先在这棵树里根据路径查找;找到就返回属性 inode 和内容,没找到再从磁盘加载路径并缓存新路径。
挂载
还有一个问题:我们怎么知道文件存储在哪个分区里?inode 不是不能跨分区吗?
分区格式化后还不能直接拿来用,它一定要和某个特定目录关联起来。进入这个目录,就相当于进入这个分区,这个操作叫 挂载。每个分区一定会被挂载在某个路径下。创建文件时,文件路径中肯定有一段路径挂载了某个分区,所以文件就会创建在那个分区里。后续使用时,也根据文件路径确定它属于哪个挂载分区,然后到对应分区里找文件的 inode。
确定文件属于哪个分区采用“就近原则”:离文件最近的有挂载分区的路径,其对应的分区就是文件所在分区。
另外,每个文件的 struct file 中都有一个 dentry 指针,指向自己的 dentry 对象。dentry 里保存的是当前文件在目录树中的位置,以及对应的 inode。这样,文件对象、目录项和 inode 就串起来了。
总结一下:inode 管属性,数据块管内容,目录数据保存“文件名 → inode 编号”的映射,路径解析从 / 开始逐级找目录,路径缓存加速查找,挂载则把分区接到目录树上。Linux 找到文件的整个过程,就是沿着目录树、借助缓存和挂载关系,最终定位到 inode 和数据块的过程。
task_struct(进程)
   |
   +-- files_struct
          |
          +-- fd 数组 ----------> struct file
                                     |
                                     +--> dentry --> inode --> 数据块
                                          |
                                          +-- 同时挂在 dentry 缓存树上
                                              (多叉树 + LRU + 哈希表)
总结
回顾全文,Linux 文件系统的核心可以概括为一句话:磁盘提供存储空间,文件系统把空间组织成块组,inode 管理文件属性,数据块保存文件内容,目录保存“文件名 → inode 编号”的映射,路径解析和缓存负责快速定位,挂载把分区接入目录树。
从物理磁盘看,数据最终落在扇区上;操作系统按块读取,块是文件存取的基本单位。文件由内容和属性组成,内容放在 data blocks 中,属性放在 inode 中。inode 不保存文件名,只保存 inode 编号和属性信息;文件名保存在目录的数据内容里,因此目录本身也是一个文件。
总的来说,使用文件系统可以帮助我们快速的找到相应的文件,然后使用文件,由于以后的硬盘空间会越来越大,文件系统也会占用相当大的空间,学习文件系统有利于我们了解linux系统。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号