WorkBuddy 提示词实战:改掉否定词之后,我的 AI 出图返工率砍了一半(5 条铁律 + 11 项自检)
原创
WorkBuddy 提示词实战:改掉否定词之后,我的 AI 出图返工率砍了一半(5 条铁律 + 11 项自检)
原创
用户12709751
发布于 2026-10-20 18:23:57
发布于 2026-10-20 18:23:57
我最初写提示词的思路是"越细越好"。有一次给一个镜头写了八百多字,规则列了二十多条,自觉天衣无缝。出来的图:人物站在屋顶上,南瓜比人还大,两个人长着同一张脸。
后来才明白,提示词不是规则清单,是画面描述。这篇讲的是我在 WorkBuddy 上出图的完整配置、写提示词的五个步骤,以及一份可以直接抄的自检清单。
一、输入材料
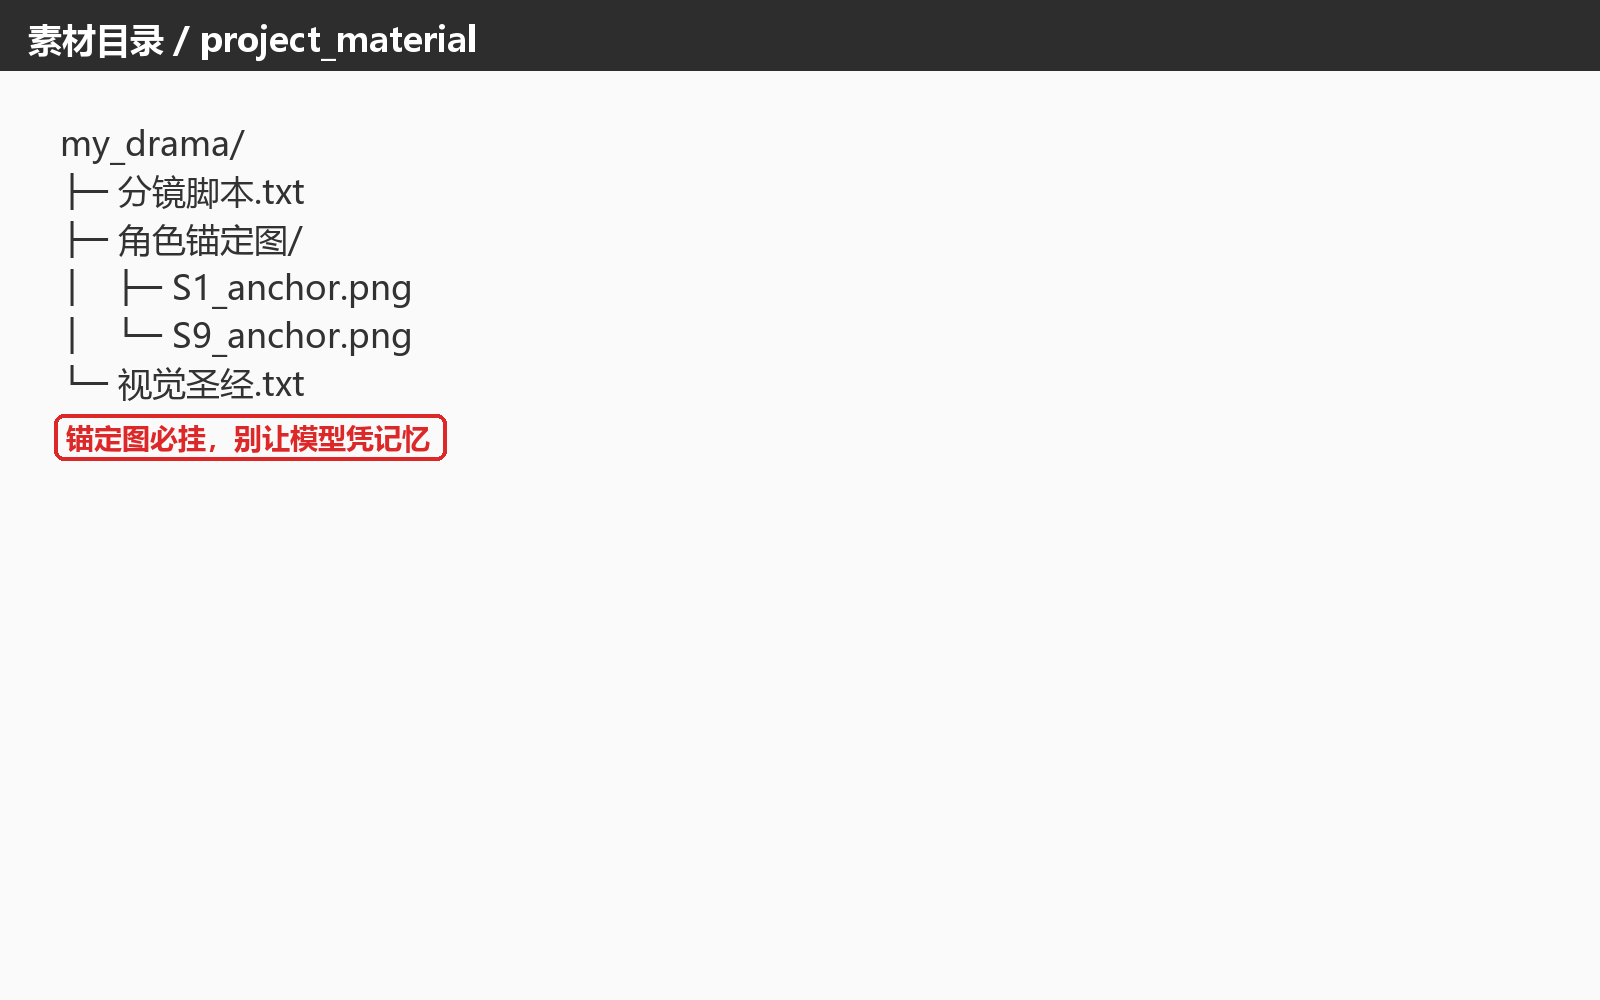
1. 分镜脚本:每镜一句话画面描述 + 一句台词。
2. 角色锚定图:有锚定图的角色必须挂,别指望模型"记得"上次长什么样。
3. 视觉圣经文件:服装、配色、光线方向,写死在文件里。
二、WorkBuddy 配置
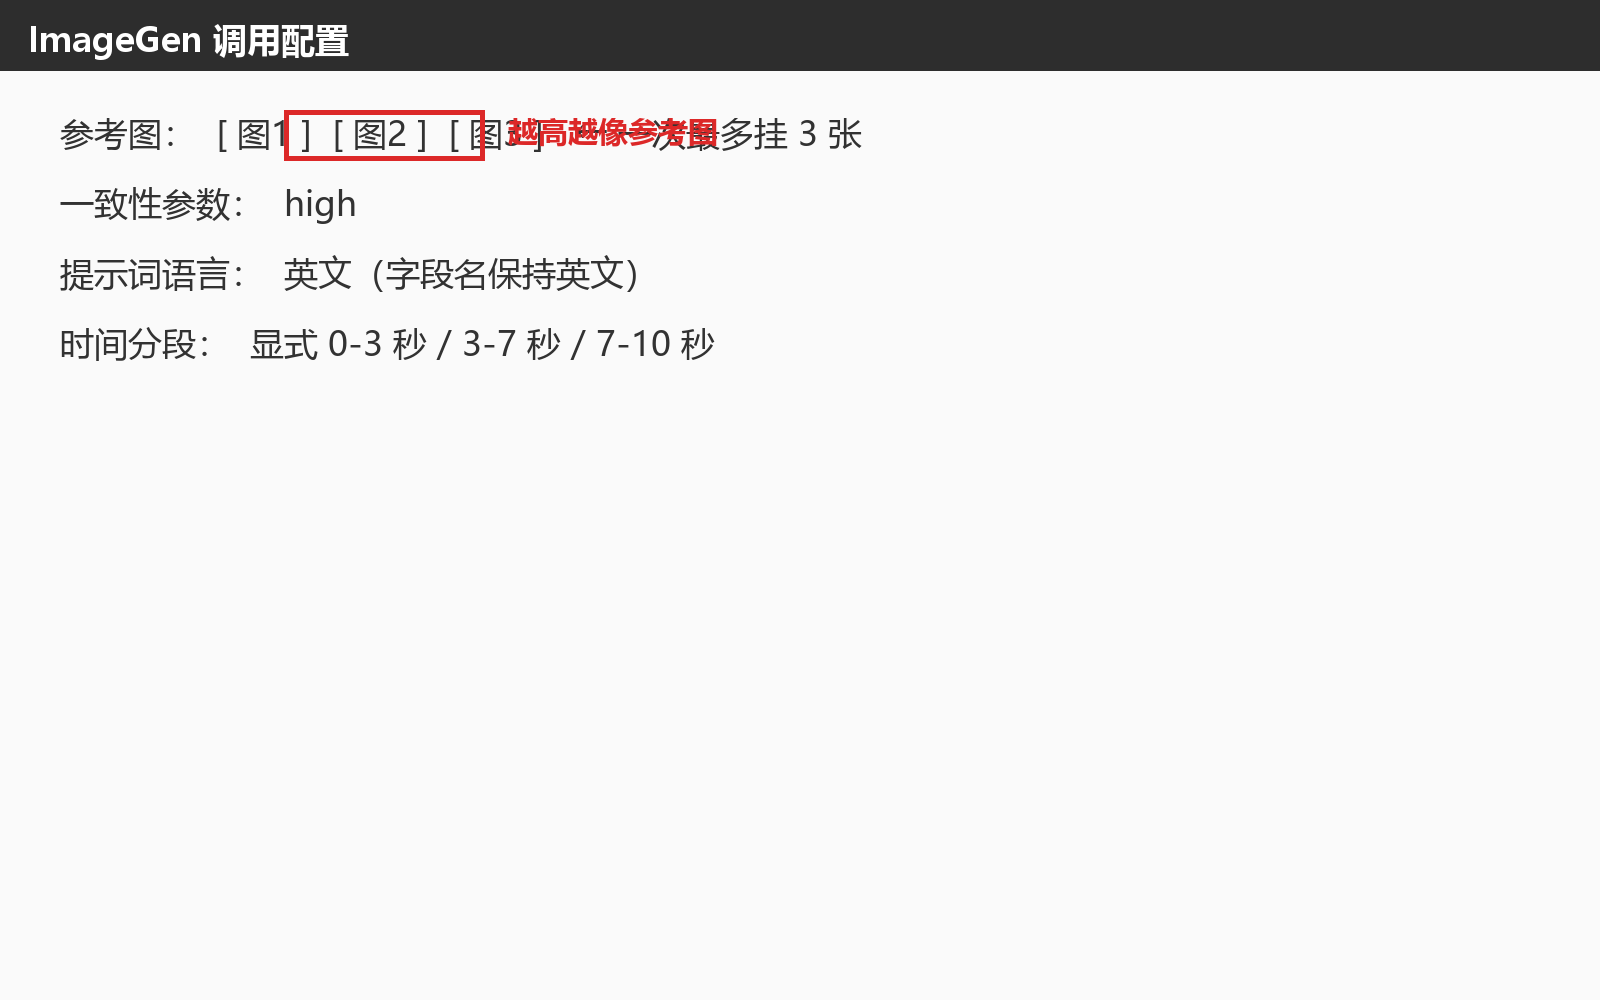
出图用 WorkBuddy 的 ImageGen,一次最多可同时挂三张参考图,一致性参数设成 high。
写提示词的三条技术设定:
用英文写,效果通常优于中文;但字段名保持英文,不要翻译。
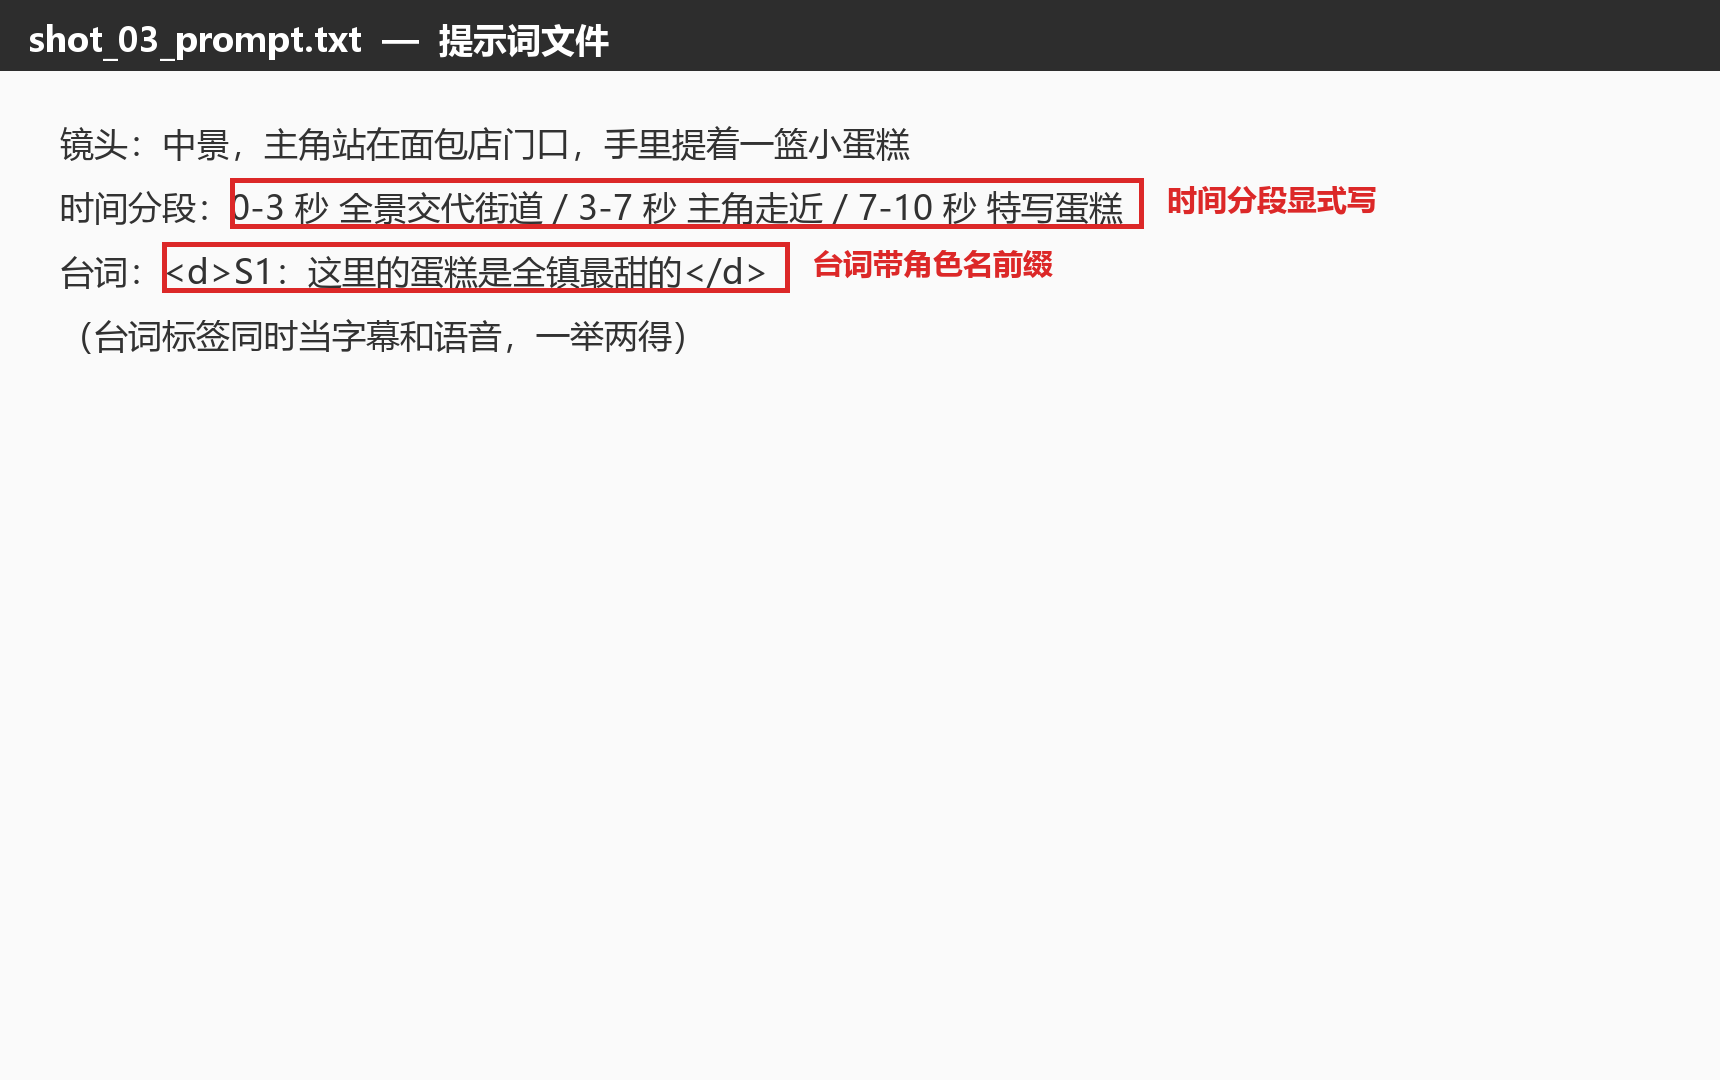
时间分段必须显式写,0-3 秒、3-7 秒、7-10 秒这样分开。
台词用固定标签包起来,这个标签同时充当语音和字幕,一举两得。
三、操作步骤:写一条提示词的五步
步骤 1,先写画面,不写规则。
把你想看到的画面原样描述出来。规则是给人和流程看的,模型吃的是画面。
步骤 2,全局扫一遍否定词,逐个改写。
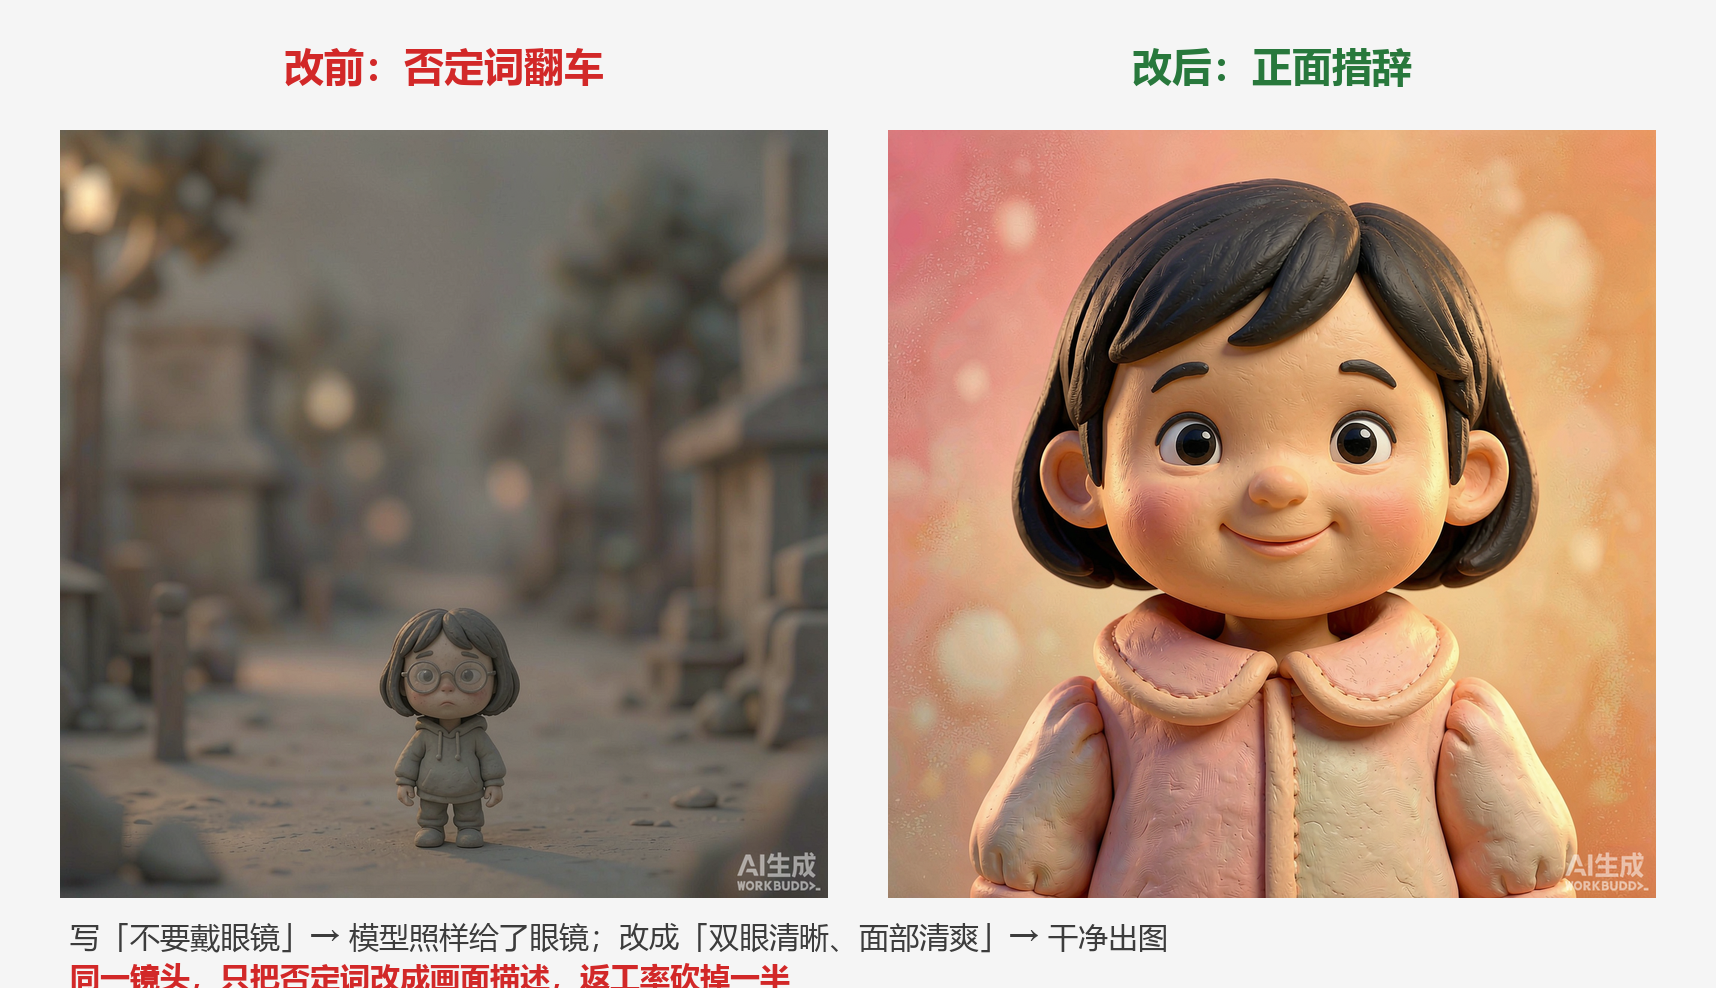
这是我改动最小、收益最大的一步。模型对否定词的处理很糟糕——你写"不要戴眼镜",它大概率给你一副眼镜,因为否定句把"眼镜"这个词强化了一遍。正确写法是描述你想要的画面本身。
改写对照表(左侧是错写法,右侧是改完的):
不要戴眼镜 → 双眼清晰可见,额头与鬓角完全露出,面部保持清爽
两个配角不能长得一样 → 两个配角发型、服装配色、身高各不相同
背景不要太模糊 → 背景元素保持清晰锐利的边缘
画面里不要出现文字错字 → 画面内文字字形工整、笔画完整
人物不要太小 → 人物占据画面高度的百分之五十到六十
不要穿现代服装 → 人物身着该时代的立领长衫,布料为粗织棉麻
我现在写完提示词会全局搜一遍"不""没""别",搜到就改写。单这一条,返工率就砍掉一半。
步骤 3,把逻辑点展开成描述句。
空间关系、遮挡关系、视线方向最容易出错,必须写成完整描述句,不能靠模型脑补。
举例,过肩镜头我会这么写:"前景角色以侧面或背侧面对向镜头,占据画面右侧三分之一,其眼镜腿与耳钉在前景中清晰可见;后景角色正面朝向镜头,位于画面左侧。"
我踩过最典型的一次,就是提示词里只写了"背影",结果人物所有配饰全部消失。
步骤 4,挂编号与锚定图。
出场顺序编号(主体1、主体2,等于图片列表索引)和全剧固定 ID(S1、S9)两套都要写,锚定图必须挂上。
步骤 5,切时间分段 + 台词带角色名前缀。
台词写成"角色名:台词",否则字幕和语音对不上人。
四、产出物
- 每镜提示词文件,可当模板复用
- 一份 11 项自检清单:
1. 主体编号与图片顺序是否对上
2. 两套编号是否都写了
3. 角色与建筑、植物的比例是否显式说明
4. 前景配饰是否可见
5. 视线与朝向是否明确
6. 光线方向是否统一
7. 服装是否与视觉圣经一致
8. 有无负面词汇
9. 时间分段是否完整
10. 台词是否带角色名前缀
11. 提示词与磁盘文件是否逐字一致
五、踩坑记录
1. 二十条规则堆在一起,模型会顾此失彼。规则要翻译成画面,比如"两个配角各不相同"比"不得重复"管用得多。
2. 画面内文字规则要按平台拆。小红书封面、B站视频帧、抖音竖屏,我分了三套写,混用会出现字被切掉或字号小到看不见。
3. 出图前没报费用就调了生成工具,一次批量渲染烧掉的成本够出三集分镜图。现在这条写进了 AI 的行为准则:没报费用不许动手。
4. 提示词和磁盘文件不一致,这次效果好下次复现不出来,等于花钱买了一次性运气。
六、总结
从"写得多"转到"写得对",我花了两个月。如果你刚开始,建议只做一件事:把最近一条提示词里的所有否定词按对照表改掉,出一次图,你会立刻看到区别。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号