多租户K8s集群CPU被打爆:ES|QL揪出吵闹邻居,1.7核占满2核,storefront达标率从99.6%崩到59%再恢复
原创
多租户K8s集群CPU被打爆:ES|QL揪出吵闹邻居,1.7核占满2核,storefront达标率从99.6%崩到59%再恢复
原创
点火三周
发布于 2026-10-19 10:58:48
发布于 2026-10-19 10:58:48
Kubernetes 中的“吵闹邻居”将 storefront 在 500 ms 内完成响应的请求占比从 99.6% 拉低到了 59%。整个过程中,节点上的每个 Pod 都一直保持运行,没有发生任何重启或告警。某个批处理工作负载占用了该 worker 节点 2 个核心中的 1.7 个,导致 storefront 只能获得所需 CPU 的 60%。通过对 Elastic Distribution of OpenTelemetry (EDOT) Collector 采集的 kubelet 指标 执行 Elasticsearch Query Language (ES|QL) 查询,我们定位到了问题并追溯到了对应的 deployment;将该 deployment 的 CPU 上限设置为 500m 后,99.8% 的请求重新回到了 500 ms 以内。随后,一个 ResourceQuota 将该命名空间的资源消耗限制在预算之内,一个 延迟 Service Level Objective (SLO) 则从那时起持续跟踪 storefront 的表现。
前置条件
• Elasticsearch 和 Kibana 9.4+。以及 TS 命令。
• 一个已通过 Kubernetes quickstart 安装 EDOT Collector 的 Kubernetes 集群,同时准备好 kubectl 和 Helm。
• 受影响服务的延迟指标。示例中使用了一个 k6 探针,它通过 OpenTelemetry (OTel) 导出 k6_http_req_duration 指标。
• 一个具有 SLO 写入权限 的 Kibana API key,用于最后一部分操作。
你可以在 这里 找到配套的 notebook。它完整复现了本文中的整个实验,包括租户标签和 SLO,并在最后进行了清理。
场景描述:多租户集群中的批处理导出与 storefront
两个租户共享一个双节点 kind 集群中的 worker 节点。该 worker 节点被限制为 2 个 CPU。
• team-storefront 运行一个 NGINX deployment,负责对 8 MiB 的响应进行 gzip 压缩。它请求 10m 的 CPU,且没有设置 CPU 上限。
• team-batch 运行 batch-export,一个包含 4 个 CPU worker 和 384 MiB 内存分配的 stress 容器。它请求 1 个 CPU,上限为 2 个。
• worker 节点之外的一个 k6 探针每次发送一个请求,间隔 200 ms。一个正常请求应在 500 ms 内返回 HTTP 200。单独运行时,storefront 在阈值内响应了 99.6% 的探针请求。
整个运行期间,worker 节点的 MemoryPressure 条件 始终为 false,因此这是一个 CPU 争用案例。Docker 限制是 kubelet 无法感知的 CFS 配额,因此 Kubernetes 仍然将 Docker 虚拟机(VM)的 6 个 CPU 报告为节点容量,查询比较的是消耗的 CPU 核心数,而不是容量百分比。
步骤 1:为 Kubernetes 指标添加租户标签
将归属标签添加到每个 deployment 的 Pod 模板中,这样 collector 就可以从 Pod 上读取它们:
spec: template: metadata: labels: tenant: batch app.kubernetes.io/name: batch-export使用稳定且低基数的值,例如团队名称或应用名称。然后将以下覆盖配置添加到 quickstart 的 Helm values 中:
collectors:
  daemon:
    config:
      processors:
        k8s_attributes:
          extract:
            labels:
              - tag_name: tenant
                key: tenant
                from: pod
              - tag_name: app
                key: app.kubernetes.io/name
                from: pod
Kubernetes attributes processor 会将这两个 Pod 标签复制到每个指标文档中,作为 resource.attributes.tenant 和 resource.attributes.app。请将该配置块与你的安装中已有的任何标签提取规则进行合并。
步骤 2:使用 ES|QL 查询确认延迟症状
从响应变慢的服务入手。以下查询按分钟绘制探针的 p95 延迟:
FROM metrics-generic.otel-*
| WHERE @timestamp >= NOW() - 30 minutes
    AND service.name == "noisy-neighbor-probe"
    AND attributes.tenant == "storefront"
| STATS p95_ms = PERCENTILE(k6_http_req_duration, 95)
    BY minute = BUCKET(@timestamp, 1 minute), tenant = attributes.tenant
| EVAL p95_ms = ROUND(p95_ms, 1)
| SORT minute
| LIMIT 100
Managed OTLP (mOTLP) endpoint 将 k6 的持续时间直方图存储为 exponential_histogram 字段,PERCENTILE 可以直接读取该字段。如果你的管道通过 Elasticsearch exporter 写入的是传统直方图类型,请在调用 PERCENTILE 之前将该字段转换为 tdigest。k6 以固定的 bucket 边界导出持续时间,每个 bucket 存储为一个代表性值,因此百分位数会重复出现一些数字。175 ms 代表 100–250 ms bucket,625 ms 代表 500–750 ms bucket,因此应将百分位数理解为范围值。
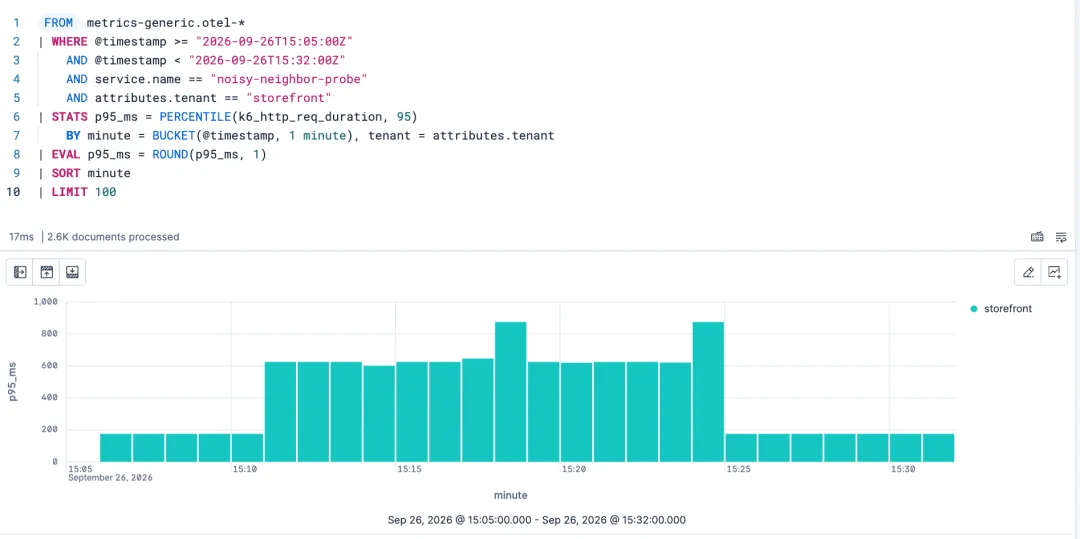
ES|QL chart of storefront p95 latency rising from 175 ms to over 600 ms during Kubernetes CPU contention
ES|QL chart of storefront p95 latency rising from 175 ms to over 600 ms during Kubernetes CPU contention
在该场景中,批处理导出开始前 p95_ms 为 175,在其运行的 13 分钟里则在 601 到 875 之间。同一时间段内,storefront Pod 报告的 k8s.container.restarts 为 0,k8s.pod.phase 为 2(即 Running)。这两个指标都来自 k8s_cluster receiver,位于 metrics-k8sclusterreceiver.otel-* 中。
步骤 3:按受影响 Kubernetes 节点上的租户对 CPU 使用量排名
storefront Pod 运行在 noisy-neighbor-worker 上。你可以从它的任意指标文档上的 k8s.node.name 读取到该信息。以下查询对该节点上的所有内容进行排名,且不预设哪个租户是罪魁祸首:
TS metrics-kubeletstatsreceiver.otel-*
| WHERE @timestamp >= NOW() - 2 minutes
    AND k8s.cluster.name == "noisy-neighbor"
    AND k8s.node.name == "noisy-neighbor-worker"
| STATS cpu_cores = SUM(AVG_OVER_TIME(k8s.pod.cpu.usage)),
        memory_bytes = SUM(AVG_OVER_TIME(k8s.pod.memory.working_set)),
        cpu_limit_used = MAX(AVG_OVER_TIME(k8s.pod.cpu_limit_utilization))
    BY k8s.node.name, k8s.namespace.name, resource.attributes.tenant
| EVAL cpu_cores = ROUND(cpu_cores, 3),
       memory_mib = ROUND(memory_bytes / 1048576.0, 1),
       cpu_limit_used_pct = ROUND(cpu_limit_used * 100, 0)
| DROP memory_bytes, cpu_limit_used
| SORT cpu_cores DESC
| RENAME k8s.node.name AS node, k8s.namespace.name AS namespace,
    resource.attributes.tenant AS tenant
| LIMIT 5
AVG_OVER_TIME 会在时间窗口内对每个 Pod 的序列进行平均,外层 SUM 再将各平均值按命名空间和租户累加。如果直接对原始采样点求和,同一个 Pod 会在每个采样点各被计数一次。在进行事故复盘时,请将 NOW() 替换为固定的开始和结束时间戳。
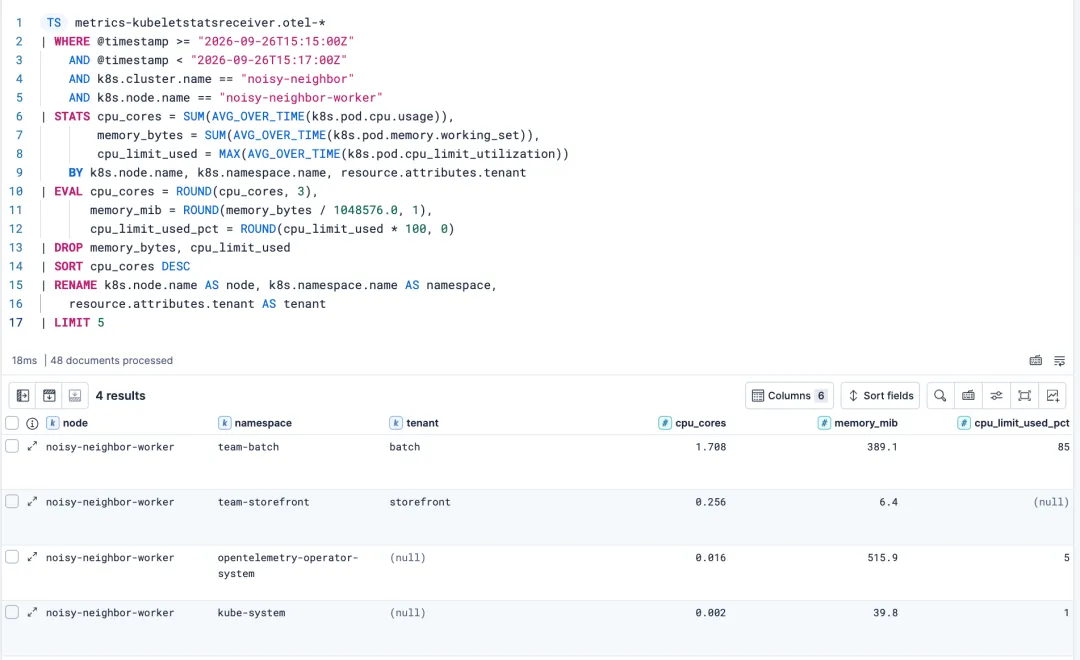
ES|QL query ranking tenants on a Kubernetes node, showing the noisy neighbor at 1.708 of 2 cores
ES|QL query ranking tenants on a Kubernetes node, showing the noisy neighbor at 1.708 of 2 cores
三个数字描述了这次争用:
• team-batch 消耗了 1.708 个核心,占其 CPU 上限的 85%。它之所以没有超过 2 个 CPU 的上限,仅仅是因为 worker 节点已经没有更多 CPU 可分配了。
• team-storefront 消耗了 0.256 个核心。在基线时间段内执行相同查询返回 0.418,因此 storefront 只获得了所需 CPU 的约 60%。一个等待 CPU 的 Pod 只会报告它实际获得的 CPU 时间。
• 同一窗口内 worker 节点的 k8s.node.cpu.usage 平均为 2.0 个核心,这已经是该 worker 节点的全部 CPU。通过同一个 TS 查询使用 STATS MAX(AVG_OVER_TIME(k8s.node.cpu.usage)) BY k8s.node.name 即可获得该值。
tenant 为 null 的行是未打标签的工作负载。在将其资源消耗归因到某个团队之前,请先找到它们的属主。
步骤 4:将租户追溯到其 Kubernetes deployment
将查询范围缩小到排名最高的命名空间,并按应用标签和属主 deployment 进行分组:
TS metrics-kubeletstatsreceiver.otel-*
| WHERE @timestamp >= NOW() - 2 minutes
    AND k8s.cluster.name == "noisy-neighbor"
    AND k8s.namespace.name == "team-batch"
| STATS cpu_cores = SUM(AVG_OVER_TIME(k8s.pod.cpu.usage)),
        memory_bytes = SUM(AVG_OVER_TIME(k8s.pod.memory.working_set))
    BY resource.attributes.app, k8s.deployment.name, k8s.node.name
| EVAL cpu_cores = ROUND(cpu_cores, 3),
       memory_mib = ROUND(memory_bytes / 1048576.0, 1)
| DROP memory_bytes
| SORT cpu_cores DESC
| RENAME resource.attributes.app AS app,
    k8s.deployment.name AS deployment, k8s.node.name AS node
| LIMIT 10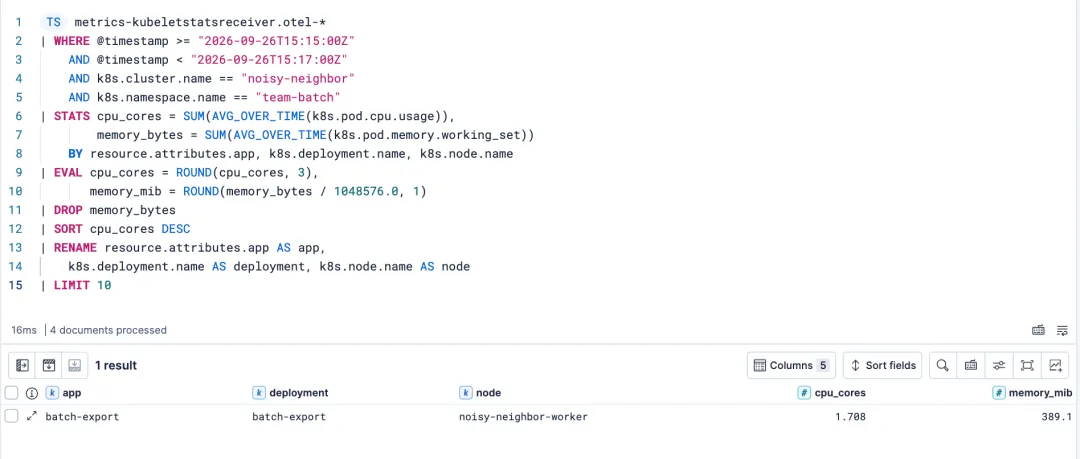
ES|QL query tracing the Kubernetes noisy neighbor to the batch-export Deployment using 1.708 CPU cores
ES|QL query tracing the Kubernetes noisy neighbor to the batch-export Deployment using 1.708 CPU cores
标签和 deployment 元数据都指向 batch-export。对于由 Job 或 StatefulSet 拥有的工作负载,请按 k8s.job.name 或 k8s.statefulset.name 分组。
接下来,将每个容器的 CPU 使用量与其 request 进行比较:
TS metrics-kubeletstatsreceiver.otel-*
| WHERE @timestamp >= NOW() - 2 minutes
    AND k8s.cluster.name == "noisy-neighbor"
    AND k8s.node.name == "noisy-neighbor-worker"
    AND k8s.namespace.name IN ("team-storefront", "team-batch")
| STATS cpu_request_used = MAX(AVG_OVER_TIME(k8s.container.cpu_request_utilization))
    BY k8s.namespace.name, k8s.deployment.name, k8s.container.name
| EVAL cpu_request_used_pct = ROUND(cpu_request_used * 100, 0)
| DROP cpu_request_used
| SORT cpu_request_used_pct DESC
| LIMIT 10
storefront 的 nginx 容器运行在其 request 的 2,546% 之上,stress 则运行在 170%。两者都超过了各自的 request。
在节点饱和的情况下,request 决定了每个容器的 CPU 权重,batch 的 1000m 权重大于 storefront 的 10m。步骤 3 中的分配比例并不是 100:1,因为 storefront 只在压缩响应时才需要 CPU。但权重仍然决定了谁需要等待,而 storefront 就是那个等待者。
EDOT 的 kube-stack values 中启用了 k8s.container.cpu_request_utilization 和 k8s.pod.cpu_limit_utilization。在普通的 kubeletstats receiver 中,这两个指标默认都是关闭的,因此如果你使用自己的 collector,请在 receiver 的 metrics 配置块下启用它们。
步骤 5:通过 CPU 上限和资源配额限制 Kubernetes 吵闹邻居
降低 batch 的上限,同时提高 storefront 的 request:
kubectl set resources deployment/batch-export -n team-batch \
  --requests=cpu=500m,memory=512Mi \
  --limits=cpu=500m,memory=768Mi
kubectl set resources deployment/storefront -n team-storefront \
  --requests=cpu=500m,memory=32Mi \
  --limits=memory=128Mi
batch 现在被限制为半个 CPU。storefront 与 batch 拥有相同的 CPU request,且不设 CPU 上限,因此它可以使用闲置的 CPU。请在你的 manifests 或 GitOps 仓库中做相同的修改,以确保下一个发布版本仍然保持该配置。Kubernetes 的 requests 和 limits 控制调度、CPU 权重和上限。延迟仍然取决于工作负载的实际需求,因此请以测量数据作为生产环境的取值依据。
当两个 rollout 都完成后,添加一个命名空间预算,这样额外的 batch 副本就需要经过评审:
apiVersion: v1
kind: ResourceQuota
metadata:
  name: batch-budget
  namespace: team-batch
spec:
  hard:
    requests.cpu: "1"
    limits.cpu: "1"
    requests.memory: 1Gi
    limits.memory: 1536Mi
    pods: "2"
该预算在新设置下可容纳两个副本,同时也覆盖滚动更新期间临时出现的第二个 Pod。如果你更早创建该配额,旧的 batch Pod 仍会以其 2 个 CPU 的上限计入配额,配额就会拒绝滚动更新所需的新 Pod。一个请求 2 个 CPU 的 Pod 会在准入阶段被拒绝,并显示 exceeded quota: batch-budget。一个 ResourceQuota 适用于命名空间中所有新建的 Pod。它不会干扰正在运行的 Pod,也不会在特定节点上预留任何资源。
步骤 6:使用相同的 ES|QL 查询验证修复效果
等待 rollout 完成,然后再次运行步骤 3 中的租户排名查询:
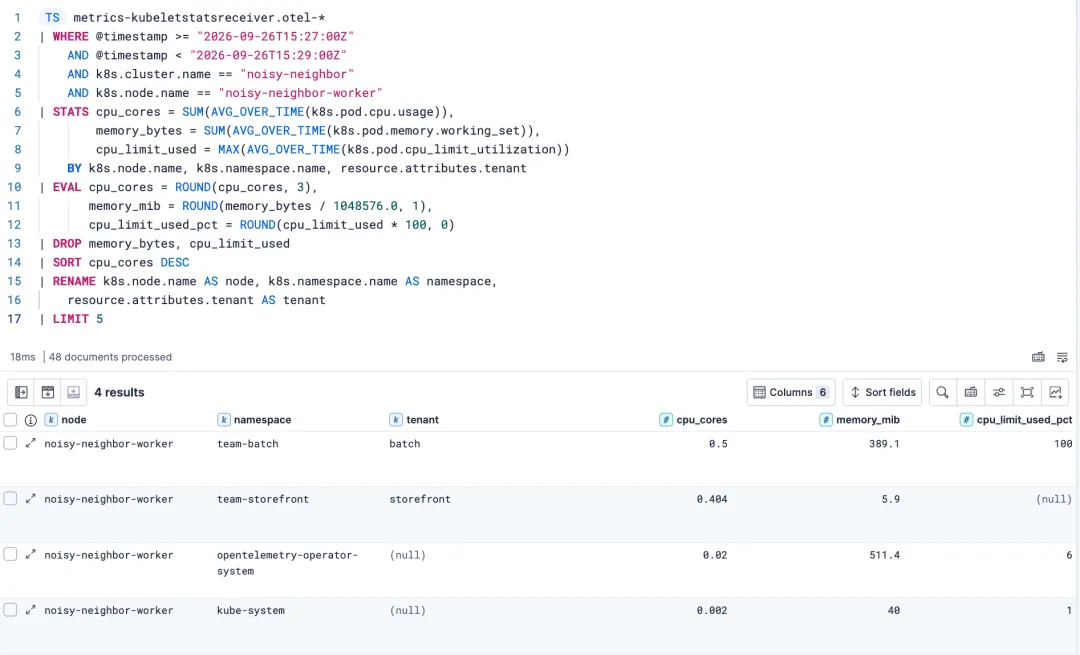
alt
相同的查询现在返回的是一个有闲置 CPU 的节点:
租户 | 基线 | 争用期间 | 修复之后 |
|---|---|---|---|
team-batch | 未运行 | 1.708 个核心,占其双核上限的 85% | 0.5 个核心,占其新 500m 上限的 100% |
team-storefront | 0.418 个核心 | 0.256 个核心 | 0.404 个核心,占其新 request 的 81% |
Worker 节点总计 | - | 2.0 个核心,已饱和 | 约 1.0 个核心 |
一个达到 CPU 上限的 Pod 会被限制(throttled)。kubeletstats receiver 没有 CFS 节流计数器,因此 k8s.pod.cpu_limit_utilization 是此数据流中最接近的信号。
探针贯穿了全部三个阶段。中位数和 p95 来自步骤 2 的查询,以 bucket 范围方式读取;请求计数和 500 ms 以下占比来自下一节中的 Service Level Objective (SLO)。表中的时间均为 UTC,Kibana 截图中的时间同样如此:
阶段 | 时间区间 | 请求数 | 中位数 | p95 |
|---|---|---|---|---|
基线 | 15:06–15:10 | 828 | 100–250 ms | 100–250 ms |
争用 | 15:11–15:23 | 1,144 | 250–500 ms | 500–750 ms |
修复之后 | 15:25–15:31 | 1,224 | 100–250 ms | 100–250 ms |
表中省略了 15:24,即执行修复的那一分钟。kubectl set resources 替换了两个 Pod,探针在 storefront Pod 重启期间记录到了整个运行过程中仅有的失败请求。修复后 worker 节点不再饱和,因此仅 batch 上限一项就足以解释这次恢复。更大的 storefront request 会在下次节点满载时生效。batch 现在处于被限制的状态,以导出速度换取 storefront 的延迟。如果导出任务有截止时间,请为它分配专用节点或增加容量。
如何确保 Kubernetes 吵闹邻居问题不再复发?
Requests、limits 和配额强制规定了资源分配。而 SLO 则衡量该分配是否足以满足服务的需求。本方案中,当探针请求在 500 ms 内返回 HTTP 200 时,计为一个好请求,目标是在滚动 30 天内达到 99%。该阈值来自基线测量。单独运行时,storefront 在 500 ms 内响应了 99.6% 的探针请求;而在争用期间,只有 59% 达标。500 ms 同时也是 k6 的一个 bucket 边界,因此 SLO 计数的是完整的 bucket,绝不会拆分某个 bucket。
在 k6 探针的环境中设置 OTEL_EXPORTER_OTLP_METRICS_TEMPORALITY_PREFERENCE=DELTA 来运行它。k6 没有文档化该变量,但它的 OTel 输出基于 OTel Go SDK,该 SDK 的 OTLP exporter 会读取这个变量。使用 delta temporality 后,每个导出的直方图只包含新请求,因此 SLO 会将每个请求恰好计数一次。在 k6 2.x 上,还需要设置 K6_OTEL_METRIC_PREFIX=k6_,因为该版本导出的指标名是 http_req_duration,没有此前缀。通过 Kibana SLO API 创建此 SLO,该 API 可以直接接受 exponential_histogram 字段。Kibana 9.5.4 的表单界面尚未列出该字段。将以下内容保存为 storefront-slo.json:
{
  "id": "noisy-neighbor-storefront",
  "name": "Storefront fairness: 99% successful probes under 500 ms",
  "description": "Track storefront HTTP probes while batch work shares its node.",
  "indicator": {
    "type": "sli.histogram.custom",
    "params": {
      "index": "metrics-generic.otel-*",
      "timestampField": "@timestamp",
      "filter": "service.name: \"noisy-neighbor-probe\" and attributes.test-id: \"noisy-neighbor-final\"",
      "good": {
        "field": "k6_http_req_duration",
        "aggregation": "range",
        "from": 0,
        "to": 500,
        "filter": "attributes.status: \"200\""
      },
      "total": {
        "field": "k6_http_req_duration",
        "aggregation": "value_count"
      }
    }
  },
  "budgetingMethod": "occurrences",
  "timeWindow": {
    "duration": "30d",
    "type": "rolling"
  },
  "objective": {
    "target": 0.99
  },
  "groupBy": [
    "attributes.tenant"
  ],
  "settings": {
    "syncDelay": "1m",
    "frequency": "1m"
  }
}
请求体中有三个部分承载了核心定义:
• good 对状态码为 200、持续时间在 0 到 500 ms 之间的响应进行计数。
• total 对所有持续时间计数,因此失败的请求始终保留在分母中。
• occurrences 按请求数进行预算。一个请求很少但延迟高的慢分钟,比一个请求很多且延迟高的慢分钟造成的预算消耗更小。
attributes.test-id 过滤器用于隔离单次探针运行。对于长期运行的 SLO,请用一个稳定的服务和环境作为过滤条件。将文件提交到你的 Kibana 端点:
curl --request POST "$KIBANA_URL/api/observability/slos" \
  --header "Authorization: ApiKey $KIBANA_API_KEY" \
  --header 'Content-Type: application/json' \
  --header 'kbn-xsrf: true' \
  --data-binary @storefront-slo.json
打开 SLOs,选择 storefront 实例,然后查看 Definition。新数据会在一分钟同步延迟和下一次 transform 运行后出现:
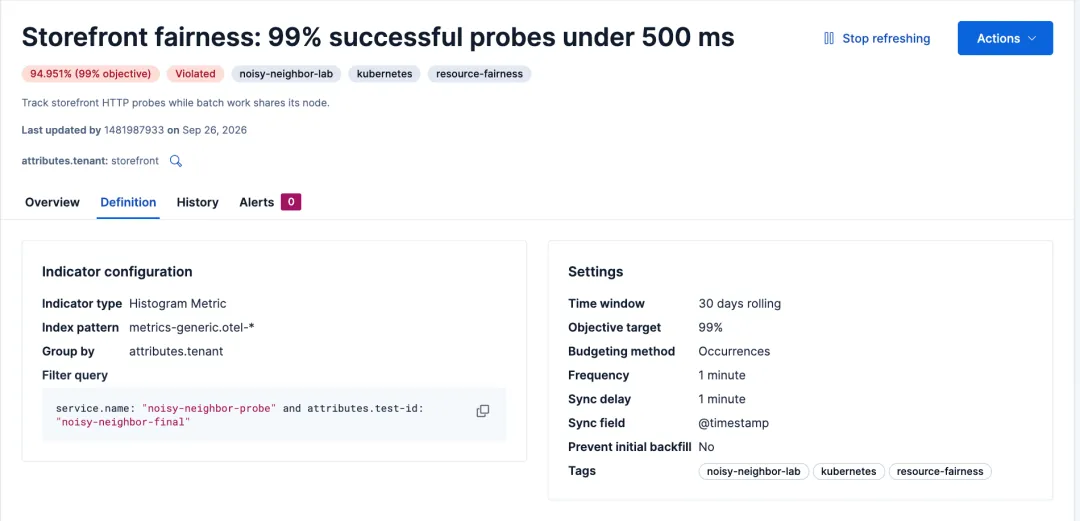
Kibana latency SLO definition: histogram metric indicator, 30-day rolling window, 99% objective target
Kibana latency SLO definition: histogram metric indicator, 30-day rolling window, 99% objective target
修复后大约 55 分钟,burn rate 面板 的六小时视图将这次事故显示为单个尖峰,并报告 Acceptable value:六小时 burn rate 为 5.36 倍(低于 6 倍阈值),三十分钟 burn rate 为 0.45 倍。历史 Service Level Indicator (SLI) 读数为 94.95%,而目标为 99%。此刻 SLO 仅积累了约一个多小时的数据,因此这次事故仍然对它有较大影响;随着好请求不断累积,该数值会逐步回升。
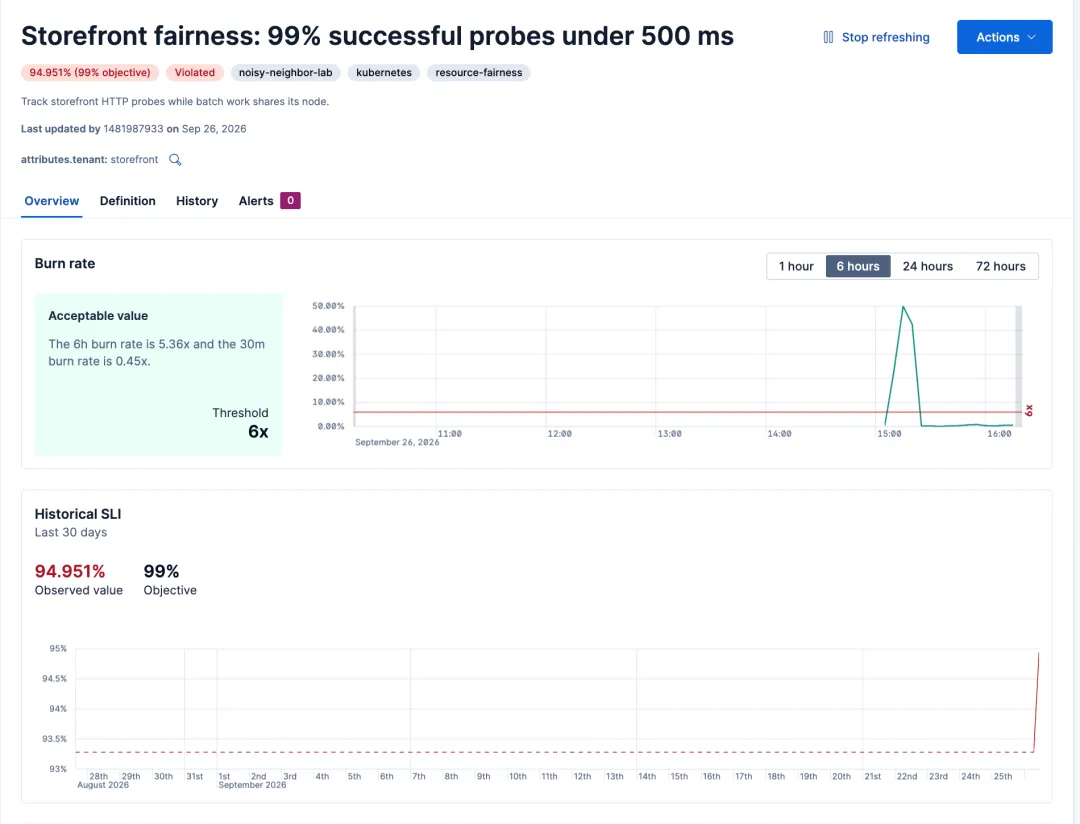
Kibana SLO burn rate panel showing the Kubernetes noisy neighbor incident as a single spike at 5.36x
Kibana SLO burn rate panel showing the Kubernetes noisy neighbor incident as a single spike at 5.36x
修复之后请保留这段历史数据。它记录了这次事故对服务质量造成的实际损失。添加一条 SLO burn rate rule,以便预算再次被耗尽时及时收到通知。没有新数据进入的 SLO 会保持静默,因此还应针对探针静默本身设置告警。
限制吵闹邻居之后的变化
这次排查的起点是一个 p95 延迟从 100–250 ms 区间飙升到超过 500 ms 的 storefront,而期间所有 Pod 都在正常运行。一条 ES|QL 查询对该节点上的租户进行了排名,显示一个批处理导出的资源消耗占用了 worker 节点 2 个核心中的 1.7 个。第二条查询将其追溯到 batch-export deployment,第三条查询显示 storefront 运行在其 10m CPU request 的 2,546% 之上。将 batch 的上限设置为 500m 后,99.8% 的请求重新回到了 500 ms 以内,一个 ResourceQuota 则为该命名空间设定了资源天花板。SLO 记录下了这次事故,并将持续衡量该服务的表现。
更多 Kubernetes 监控查询与 SLO 模板
• 用于 Kubernetes 监控的常见 ES|QL 查询,涵盖重启、Pod 阶段和内存利用率
• Kubernetes 可观测性:将告警转化为错误预算的 SLO 模板
• TS 命令参考文档
• Kubernetes 文档中的 Pod 和容器资源管理
• 创建 SLO burn rate rule
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号