用 WorkBuddy 打通“检索—成稿—排版—交付”全流程:一份带代码与配图的实战教程
原创
用 WorkBuddy 打通“检索—成稿—排版—交付”全流程:一份带代码与配图的实战教程
原创
用户12819330
发布于 2026-10-14 15:07:20
发布于 2026-10-14 15:07:20
面向对象:需要周期性产出研究报告、方案或公众号稿件的研究者与教师。
全文所有代码、命令、目录结构、图示均来自我自己的项目,全部实跑验证过,可直接照抄。
一、这套流程要解决什么问题
我同时做两件事:一边写装备与技术方向的深度稿件,一边给部队和院所交付研究报告与方案。这个工作有个共同特点——单次交付看着不复杂,但前置准备极重。
一份装备调研报告,真正动笔可能只要半小时,可前面这几件事加起来是四个小时:
- 翻中、英、俄、日、韩、乌多语种资料,还要防着关键词直译导致漏检;
- 抓政府与厂商官网原文,这类页面经常有反爬,静态请求拿不到;
- 把素材变成能直接粘进公文格式的 Word,页边距、字体、图 N 题注一个都不能错;
- 给报告配上风格统一的架构图和链路图。
所以我不把 WorkBuddy 当“问答工具”,而是当一条流水线来接:每一环固定一种做法,环与环之间用文件交接,人只做判断和取舍。
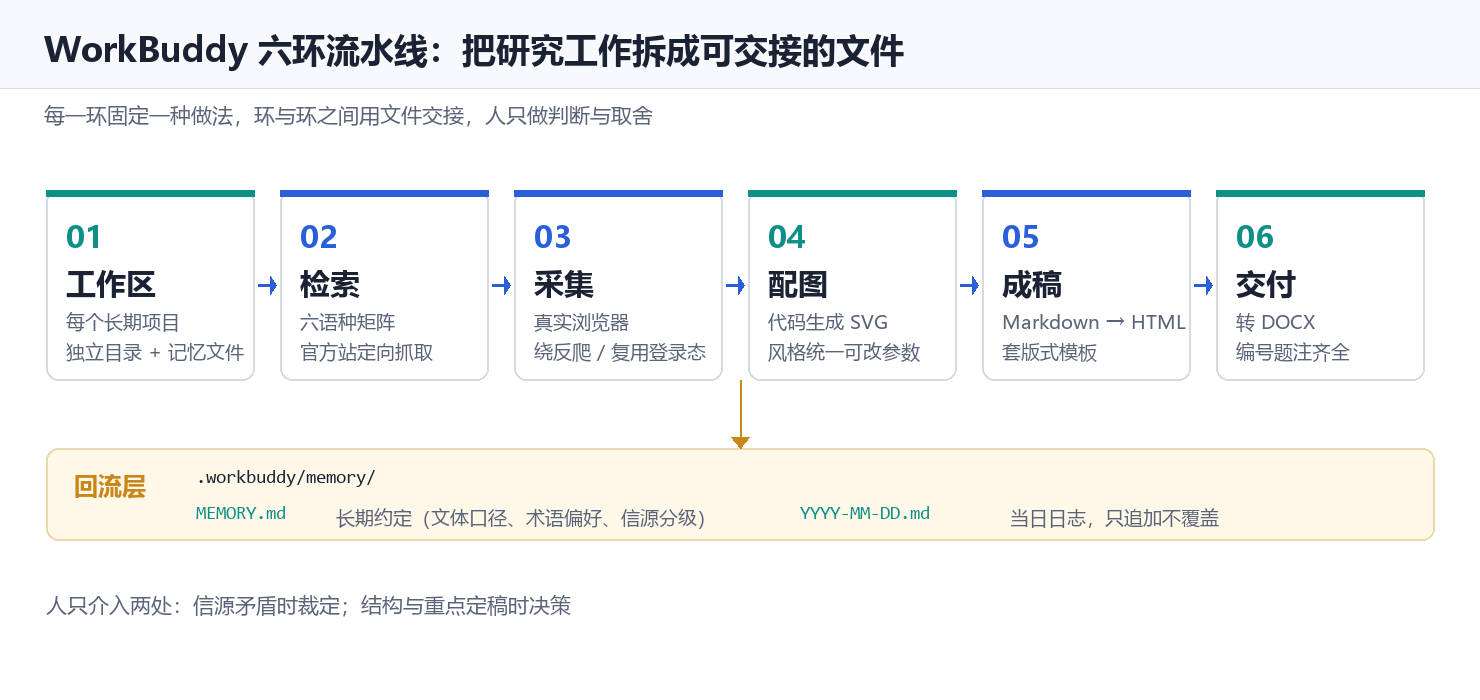
图 1:六环流水线
六个环节里,人的介入只有两处:信源互相矛盾时裁定,和结构与重点定稿时决策。其余全部交出去。
下面按环节讲,每节都给可直接使用的实操配置。
二、环节一:把工作区当项目文件夹,而不是聊天窗口
最大的误区是一上手就在对话框里问,答完就散。正确用法是每个长期项目一个独立工作区,目录里带一份记忆文件。
目录结构(真实在用)
项目名/
├── .workbuddy/
│   └── memory/
│       ├── MEMORY.md            # 长期约定:文体口径、术语偏好、信源分级、红线
│       └── 2026-10-14.md        # 当日日志,只追加不覆盖
├── 00-素材/                      # 检索产出,按信源分级留痕
├── 01-提纲/
├── 02-正文/                      # *.md 内容稿
├── 03-配图/                      # SVG / PNG
└── 04-交付/                      # *.docx
MEMORY.md 该写什么
它是项目级宪法,只写“每次都必须遵守”的东西,不写一次性任务:
# 项目长期约定

## 文体口径
- 对外输出一律中文全角引号“ ”,禁止半角引号
- 初稿只出终稿,不列思考过程;正文 5–8 行说明文件位置与结论
- 主体用连贯叙述段落,禁止 1.2.3. 式清单(待办与待确认可用)

## 信源规则
- 官方一手 > 监督机构 > 权威智库 > 专业媒体 > 厂商自述
- 矛盾来源并列呈现,不替读者裁定
- 涉我方部署与装备参数,只记录“是否存在公开讨论”,不进正文

## 排版规则
- 图 N / 表 N 统一题注格式,位置在图下方
- 金额大小写并列,其余用阿拉伯数字
日志只追加,不覆盖
2026-10-14.md 每天一两行就够,写今天做了什么、踩了什么坑。三个月后回看,这份日志就是你的工作复盘底稿,也是下一次选题的依据。
三、环节二:六语种检索矩阵 + 官方站定向抓取
做装备、战例、技术路线这类题目,公开资料重心在境外。固定按六个语种铺一遍,每个语种配不同的关键词结构。
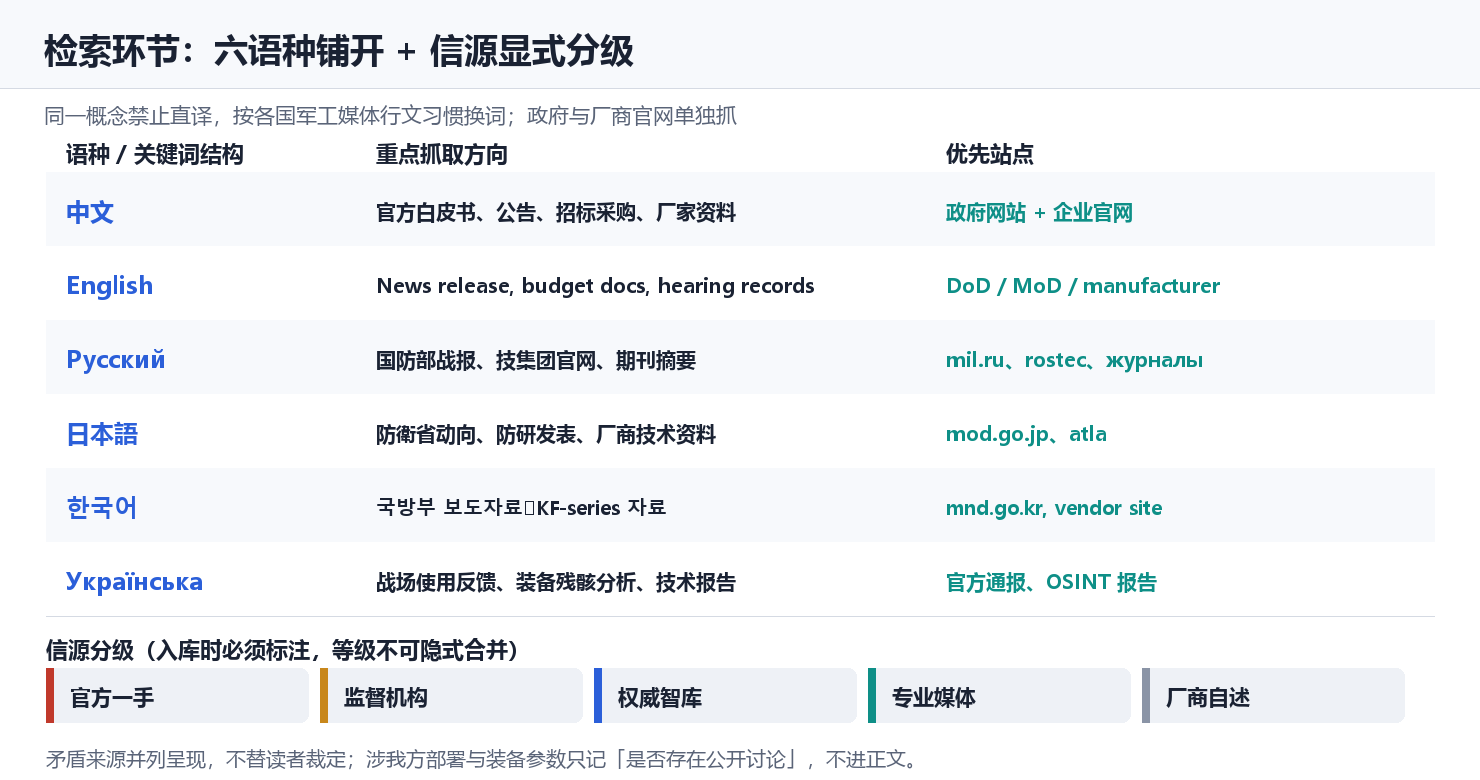
图 2:检索矩阵与信源分级
两个提速点
第一,同一概念禁止直译。 直译的命中率会低一大截。要按各国军工媒体的行文习惯换词:
中文概念 | 直译(漏检多) | 按习惯换词(命中高) |
|---|---|---|
无人机反制 | anti-drone | counter-UAS / C-UAS / drone mitigation |
无人协同作战 | unmanned cooperation | unmanned teaming / collaborative autonomy |
低空防御 | low altitude defense | low, slow and small (LSS) / counter-UAS airspace |
单兵一控多 | one control many | multi-vehicle supervisory control / swarm control |
第二,政府与厂商官网要单独抓。 这类站点的内容经常不进通用搜索索引。我的固定动作是“通用搜索出线索 → 定向回官网找原文”两步走,绝不拿二手转述当一手信源。
检索产出必须留痕
素材入库时强制记录三件事,缺一不可:
字段 | 说明 | 反例(不合格) |
|---|---|---|
信源等级 | 官方一手 / 监督机构 / 智库 / 媒体 / 厂商 | “网上看到的” |
原文链接 | 可回溯的原始 URL | 只留标题 |
可用性判断 | 能进正文 / 仅作背景 / 弃用 | 空 |
四、环节三:用真实浏览器抓,绕开反爬
静态抓取遇到 Cloudflare 级别的防护就废了。这时候改用驱动本机真实浏览器:连本地 Chrome 或 Edge 的调试端口,带我自己的登录态和指纹去访问。
这一节我全部实跑验证过,下面贴出的回显是真实输出。
第一步:启动带调试端口的浏览器
# 先关掉已有实例,否则新端口不生效
taskkill /F /IM chrome.exe

# 启动并保留登录态(用你平时那个用户目录)
chrome.exe --remote-debugging-port=9222 ^
--user-data-dir="%LOCALAPPDATA%\Google\Chrome\User Data"踩坑记录:如果端口一直连不上,多半是浏览器进程被父进程回收了。用脚本拉起时要加独立进程标志,否则脚本一结束浏览器就跟着退出。我实测
9333端口比9222更少冲突。
第二步:确认 CDP 端口通了
curl http://127.0.0.1:9222/json/version真实回显(截取):
{
  "Browser": "Chrome/152.0.7977.65",
  "Protocol-Version": "1.3",
  "webSocketDebuggerUrl": "ws://127.0.0.1:9222/devtools/browser/xxxx"
}
只要看到 Browser 和 webSocketDebuggerUrl 两个字段,就说明通道打开了。
第三步:用 Node 原生 WebSocket 抓正文(零依赖)
不想装 Playwright 的话,几十行就够用:
// cdp-fetch.mjs —— 用原生 WebSocket 走 CDP,无需第三方依赖
// 用法: node cdp-fetch.mjs <目标URL> [端口]
const url = process.argv[2];
const port = process.argv[3] || '9222';

// 开一个新标签页,拿到它的 ws 调试地址
const list = await (await fetch(`http://127.0.0.1:${port}/json/new?about:blank`, {
  method: 'PUT'
})).json();

const ws = new WebSocket(list.webSocketDebuggerUrl);
let id = 0;
const pending = new Map();

const send = (method, params = {}) =>
  new Promise(res => {
    pending.set(++id, res);
    ws.send(JSON.stringify({ id, method, params }));
  });

ws.onmessage = e => {
  const msg = JSON.parse(e.data);
  if (msg.id && pending.has(msg.id)) { pending.get(msg.id)(msg.result); pending.delete(msg.id); }
};

await new Promise(r => (ws.onopen = r));

await send('Page.enable');
await send('Page.navigate', { url });
await new Promise(r => setTimeout(r, 4000));   // 等渲染完成

const { result } = await send('Runtime.evaluate', {
  expression: 'document.title + "\\n=====\\n" + document.body.innerText',
  returnByValue: true
});
console.log(result.value.slice(0, 1200));

await fetch(`http://127.0.0.1:${port}/json/close/${list.id}`);
ws.close();
process.exit(0);
实跑回显(抓 WorkBuddy 官方文档站,验证通道有效性):
$ node cdp-fetch.mjs "https://www.workbuddy.cn/docs/workbuddy/Overview" 9333
CDP OK -> Chrome/152.0.7977.65
WorkBuddy 简介 | WorkBuddy - AI Agent 办公新范式
=====
WorkBuddy 是腾讯出品的全场景 AI 工作台。您可以使用自然语言描述需求,
由 WorkBuddy 自主规划和执行任务,并交付文档、表格、PPT 等可直接使用的完整成果。
...
这一步的价值不只是“绕过验证”,更在于持久登录态。 不少资料在企业门户或权限墙后面,静态请求拿不到,但复用我平时登录的会话就能正常打开——这里说的是正常可见的公开内容,不是去破解付费墙。
红线
只碰公开来源。绕过登录获取的付费内容不进正文,涉及我方部署与装备参数的只记录“是否存在公开讨论”,涉密链接一律不采。
五、环节四:插图别去搜,直接画
架构图、链路拓扑图、泳道时序图,我不再去图库翻素材——那种图风格不统一,编号和题注还得重做。改成用代码生成矢量图。
一张分层架构图,30 行代码搞定
# arch-diagram.py —— 生成分层架构图 SVG,可直接嵌进 Word
LAYERS = [
    ("应用层", ["指挥控制", "任务规划", "人机界面"], "#2B5FD9"),
    ("服务层", ["模型推理", "数据融合", "任务调度"], "#0E8F87"),
    ("平台层", ["消息总线", "容器编排", "日志审计"], "#C8871B"),
    ("资源层", ["算力池", "存储池", "网络 fabric"], "#5A6478"),
]
W, BH, GAP = 760, 96, 18
H = len(LAYERS) * (BH + GAP) + 40
svg = [f'<svg xmlns="http://www.w3.org/2000/svg" width="{W}" height="{H}" '
       f'viewBox="0 0 {W} {H}" font-family="Microsoft YaHei">']

y = 20
for name, mods, color in LAYERS:
    svg.append(f'<rect x="0" y="{y}" width="{W}" height="{BH}" rx="8" '
               f'fill="#F7F9FC" stroke="{color}" stroke-width="2"/>')
    svg.append(f'<rect x="0" y="{y}" width="8" height="{BH}" rx="4" fill="{color}"/>')
    svg.append(f'<text x="24" y="{y+34}" font-size="18" fill="#1A2233">{name}</text>')
    for i, m in enumerate(mods):
        svg.append(f'<rect x="{150+i*200}" y="{y+22}" width="180" height="52" rx="6" '
                   f'fill="#FFFFFF" stroke="{color}"/>')
        svg.append(f'<text x="{240+i*200}" y="{y+54}" font-size="15" '
                   f'text-anchor="middle" fill="#1A2233">{m}</text>')
    y += BH + GAP

svg.append('</svg>')
open("arch.svg", "w", encoding="utf-8").write("\n".join(svg))改一个参数出一张图,一套图从两小时压到两分钟,且风格天然统一。
踩坑记录:如果用 Pillow 直接画 PNG,中文必须给每段文字显式指定含中文的字体文件(
msyh.ttc/simhei.ttf),否则方框乱码。跨语种混排(比如韩文)还要单独换字体(malgun.ttf)。
照片类另说
真实装备与场景照片必须来自可溯源渠道,逐张记录“内容 / 来源链接 / 可信度 / 可用章节”。绝不用生成图冒充实景照片——这条是硬红线。
六、环节五:Markdown → HTML → DOCX
这是整套流程里最省事的一环。不直接拼 Word,先写 Markdown,再套 HTML 版式模板,最后转 DOCX。
好处是内容与版式彻底分离:内容我可以快速迭代,版式一次调好、永久复用。甲方要改格式,改的是模板,不动正文。
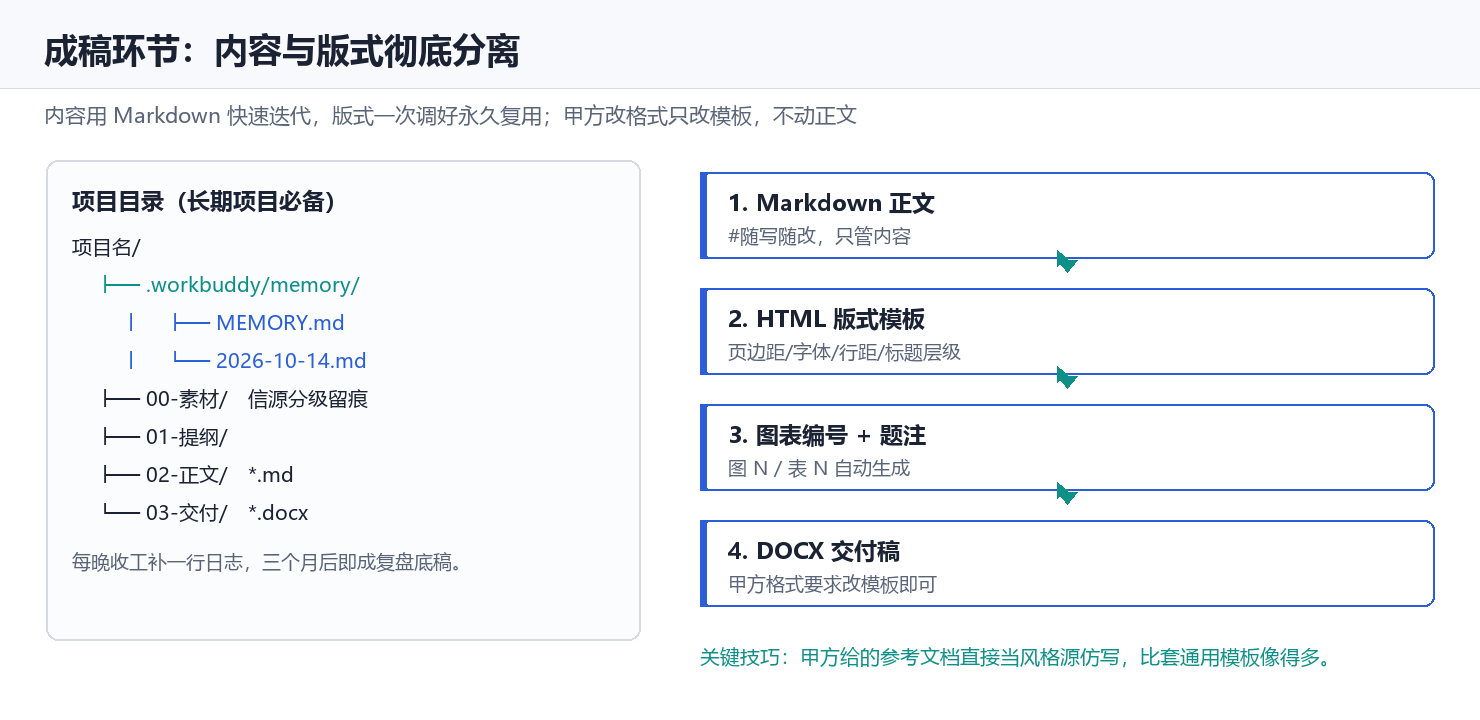
图 3:成稿与排版流水线
HTML 模板关键样式(节选)
<style>
@page { size: A4; margin: 2.8cm 2.6cm; }
body   { font-family:"SimSun","宋体"; font-size:12pt; line-height:1.75;
         text-indent:2em; color:#000; }
h1     { font-family:"SimHei","黑体"; font-size:18pt; text-align:center;
         text-indent:0; margin:0 0 18pt; }
h2     { font-family:"SimHei","黑体"; font-size:14pt; text-indent:0;
         margin:16pt 0 8pt; border-left:4px solid #2B5FD9; padding-left:8px; }
figure { margin:12pt 0; text-align:center; page-break-inside:avoid; }
figcaption { font-size:10.5pt; color:#444; text-indent:0; margin-top:6pt; }
table  { border-collapse:collapse; width:100%; font-size:10.5pt;
         page-break-inside:avoid; }
th,td  { border:1px solid #666; padding:5pt 7pt; }
th     { background:#EEF1F6; font-family:"SimHei","黑体"; }
</style>
page-break-inside:avoid 这一行是关键——它保证表格和插图不会被拦腰截断到两页,这是我改过最多次的一处。
关键技巧:甲方给的参考文档,直接当风格源去仿写,比套通用模板像得多。技术方案类还要注意金额中英文大写并列、签署页上下排这类体例细节。
Markdown 转 HTML 的极简脚本
# md2html.py —— 把 Markdown 正文转成带样式单页 HTML,浏览器打开即可整篇复制
import re, sys
def inline(s):
s = s.replace("&", "&").replace("<", "<").replace(">", ">")
s = re.sub(r"\*\*(.+?)\*\*", r"<strong>\1</strong>", s)
s = re.sub(r"`(.+?)`", r"<code>\1</code>", s)
return s
def build(md):
out, incode, buf = [], False, []
for line in md.split("\n"):
if line.startswith("```"):
if incode:
out.append("<pre><code>" + "\n".join(buf) + "</code></pre>")
incode, buf = not incode, []
continue
if incode:
buf.append(line); continue
if line.startswith("## "):
out.append("<h2>" + inline(line[3:]) + "</h2>")
elif line.strip():
out.append("<p>" + inline(line) + "</p>")
return "\n".join(out)
md = open(sys.argv[1], encoding="utf-8").read()
open(sys.argv[2], "w", encoding="utf-8").write(
'<!DOCTYPE html><meta charset="utf-8">' + build(md))
print("ok", sys.argv[2])配合浏览器直接打开预览,从写到发一篇文章,中间不需要开 Word。
七、环节六:定时自动化与连接器
日报、周报、素材巡检、固定时间抓外部更新,这些不该占用注意力。设成定时任务即可。
一个自包含的定时任务提示词
抓取无人装备领域过去 7 天的公开动态,按「国内 / 国外 / 技术趋势」三类
归类,每类不超过 5 条,每条给出一句话结论 + 可回溯原文链接。
直接输出成稿,不要过程叙述。没有实质更新的类别写“无更新”,不要凑数。
关键点:提示词必须自包含。 别写“按上次那样做”——下次运行时看不到今天的对话。公司名、路径、口径、格式要求都要写死在提示词里。
调度规则用 RFC 5545 的 RRULE 表达,不要用自然语言硬凑:
需求 | RRULE |
|---|---|
每天 9:00 | FREQ=DAILY;BYHOUR=9;BYMINUTE=0 |
工作日 8:30 | FREQ=WEEKLY;BYDAY=MO,TU,WE,TH,FR;BYHOUR=8;BYMINUTE=30 |
每月 1 号 | FREQ=MONTHLY;BYMONTHDAY=1;BYHOUR=9;BYMINUTE=0 |
连接器:授权一次即可读写
邮箱、日历、云文档、云盘、IM,授权一次之后就能直接读写,不用手动导出再上传。授权前先看清它要的是读权限还是写权限,写权限按需开。
八、积分怎么挣(顺手解决额度焦虑)
这套流程本身写成教程投稿,单篇基础奖励 1000 分,被精选再 +2000,单篇封顶 3000。
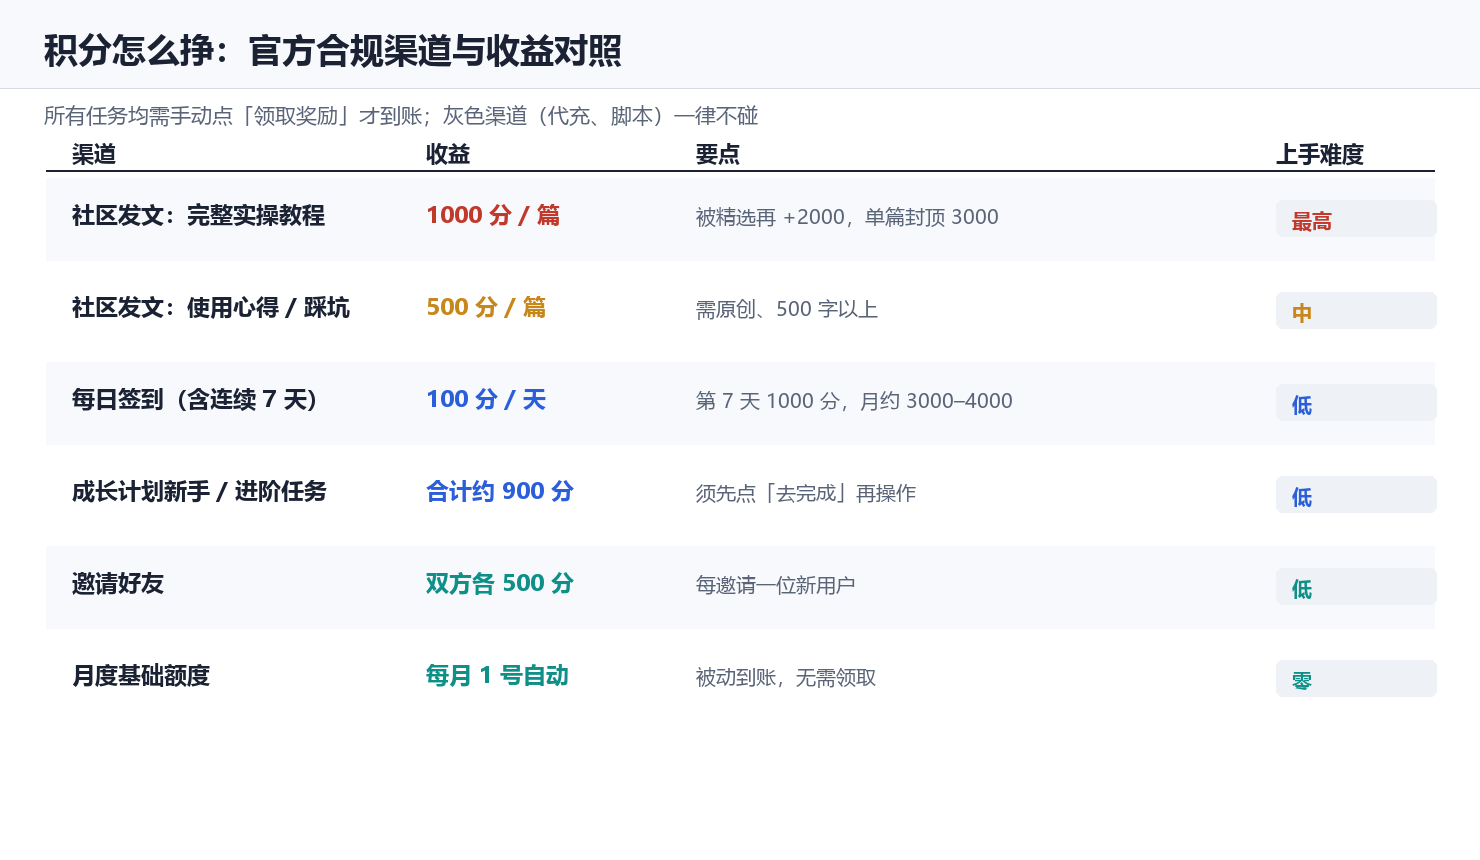
图 4:积分获取矩阵
官方合规渠道就这几条:
渠道 | 收益 | 要点 |
|---|---|---|
社区发文:完整实操教程 | 1000 分/篇 | 被精选再 +2000 |
社区发文:使用心得 / 踩坑 | 500 分/篇 | 需原创、500 字以上 |
每日签到(含连续 7 天) | 100 分/天 | 第 7 天 1000 分,月约 3000–4000 |
成长计划新手/进阶任务 | 合计约 900 分 | 须先点「去完成」再操作 |
邀请好友 | 双方各 500 分 | 每邀请一位新用户 |
月度基础额度 | 每月 1 号自动 | 被动到账,无需领取 |
踩过的坑,写清楚省你时间
- 积分不是自动到账。 大部分任务做完必须回页面手动点「领取奖励」,忘了点就白做。这是我见过最多人踩的坑。
- 成长计划要先点「去完成」。 直接自己在对话里操作,系统识别不到任务进度,做完照样领不到。
- 先查余额和有效期。 不同来源积分有效期差别很大(注册赠送、活动获取、月度额度各不相同),系统一般只提前几天提醒过期,建议自己做台账。
- 积分消耗分档明显。 简单问答和短句改写十几分;深度调研报告是几百到上千分的大头。纯查询切轻量模式,一次把需求说清,减少无效对话。
- 灰色渠道别碰。 二手平台低价卖分、脚本破解、代充属于灰产,封号和文档泄露的风险都真实存在。
投稿怎么写才拿满
基础 500 分的“心得类”和 1000 分的“教程类”,差别在于有没有可复制的实操内容:命令、代码、目录结构、真实参数、踩坑记录、清晰排版。这篇能拿满 1000 分而不是 500,靠的就是上面那些代码块、真实回显和配图。
九、算一笔总账
积分上是这样的:每日签到约 3000–4000 + 月度额度 + 成长计划一次性约 900 + 每月一篇教程 1000–3000。轻度使用已经富余,重度使用靠投稿补。
对我来说更划算的是把积分花在刀刃上:深度调研报告这种真正需要联网检索、多源交叉的任务,检索质量直接决定报告能不能站住;日常的改写、排版这类活用轻量模式处理。积分不是靠省下来的,是靠把机器干得又快又准、把人从重复劳动里解放出来之后产生的价值换来的。
如果你也在用 WorkBuddy 搭自己的工作流,欢迎交流你踩过的坑——尤其是信源分级和排版模板这两块,我很想看看别人怎么解。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号