从"模型"到"编排":企业级 Agentic Workflow 的分布式技能调度实战
原创
从"模型"到"编排":企业级 Agentic Workflow 的分布式技能调度实战
原创
OneCode
发布于 2026-10-12 11:42:38
发布于 2026-10-12 11:42:38
把大模型接进企业只是起点;真正难的是把业务流程、规则与知识编排成一组可寻址、可调度、可治理的智能体技能。本文先以已落地的优秀方案(Berkeley 的 Compound AI Systems、Anthropic《Building Effective Agents》、吴恩达的 Agentic Workflow 四模式、MCP、Google A2A、HITL)确立支撑点,再映射到 ooder-platform 的真实实现:分层、技能中心、北向/南向、skillsFlow、Agent 委派与人在环。
0支撑点:从"模型"到"编排"的行业共识
本文不发明新名词,只把已被验证过的做法对齐到一起。过去两年企业 AI 落地最清晰的一条主线是:从"调模型"转向"编排系统"。
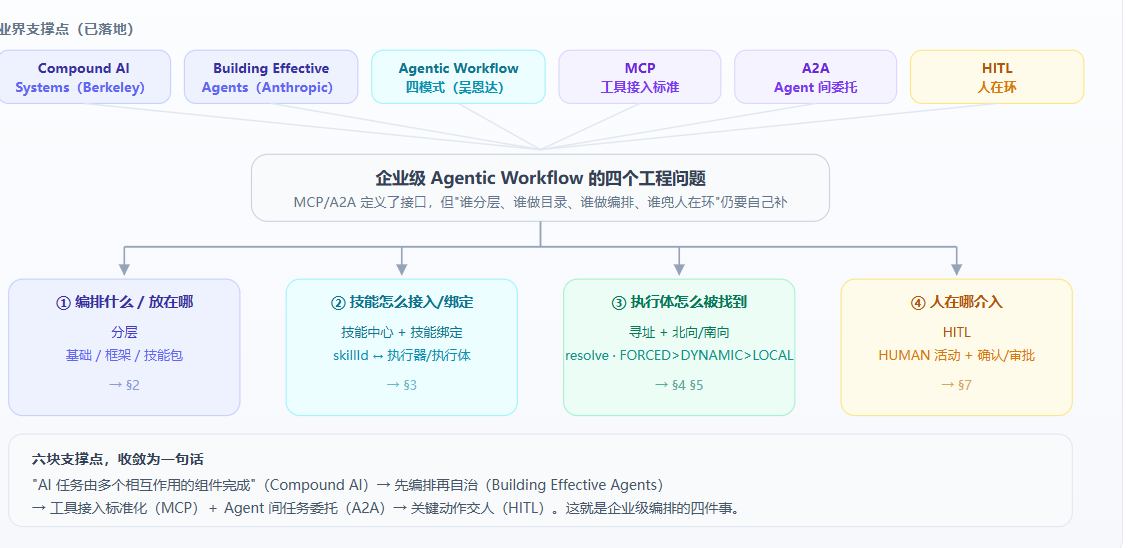
图 1 业界支撑点 → 企业级 Agentic Workflow 的四个工程问题 → 本文结构。
方案 / 研究 | 核心主张 | 关键结论 | 映射到本文 |
|---|---|---|---|
Compound AI Systems(Berkeley BAIR,2024.02) | 从"单模型"到"多组件复合系统" | "AI 任务由多个相互作用的组件完成——包括多次模型调用、检索器与外部工具" | 分层(基础/框架/技能包)+ 技能网络 |
Building Effective Agents(Anthropic,2024.12) | 先 workflow,再 agent | "绝大多数自称 agent 的产品其实是编排好的 workflow,这没问题";用最简单可行的编排 | skillsFlow 的"活动 + 迁移"编排 |
Agentic Workflow 四模式(吴恩达,2024) | Reflection /Tool Use/ Planning /Multi-Agent | 工具调用与多智能体协同是核心模式 | 技能调度(Tool Use)+ 多执行体协同 |
MCP(Anthropic,2024.11) | 工具 / 上下文接入标准化 | 把"外部工具与数据源"接成统一接口 | 技能绑定:skillId ↔ 执行器/执行体 |
A2A(Google 2025.04 → Linux Foundation 2025.06) | Agent 间任务委托的开放协议 | 让不同 Agent 能互相发现并委托任务 | 北向/南向 + 技能中心resolve+/api/agent/task |
HITL 人在环 | 人介入关键节点 | 关键动作交由人确认 / 审批(MIT Sloan × BCG 常被引用:全自主 12% vs 人介入 87%) | HUMAN 活动 +HumanStore/ConfirmBar |
为什么先讲这个
分布式、寻址、协议、人在环这些"重活",恰好是 MCP(工具接入)与 A2A(Agent 互调)的开放标准没有替你覆盖的部分——它们定义了接口,但谁来分层、谁来做目录、谁来做编排、谁来兜人在环,仍是企业落地必须自己补上的工程。
1编排什么?——业务流程与业务能力
先把"被编排的对象"说清楚。它不是抽象概念,而是企业里本就存在的东西:业务流程、业务规则、领域知识,以及把它们绑定到"能干的技能"上。
组成 | 在企业里长什么样 | 在本架构里的载体 |
|---|---|---|
流程 | "报销单先部门审批、再财务复核、最后出纳付款" | 流程定义(活动 Activity + 迁移 Transition) |
规则 | "金额超过 5000 必须走总经理审批" | 迁移的condition+noMatchPolicy+ 寻址优先级 |
知识 | 术语、口径、政策解释("什么算差旅费") | 框架层的领域知识+ 检索绑定 |
能力 | "查询流水""生成日报""发起审批" | 技能(skill),绑定到具体执行体 |
为什么难? 因为三条物理边界会同时出现——这也是多智能体系统绕不开的复杂度来源:
边界 | 强制面对的问题 | 被打破的隐含假设 |
|---|---|---|
进程边界 | Agent 由不同团队、不同语言、不同发布节奏交付,不能共享内存/事务 | "把上下文对象传过去" |
浏览器边界 | 流式输出只存在于人连接的节点;执行体节点上没有浏览器 | "边生成边推给前端" |
组织边界 | Agent 归属不同域(财务/办公/研发),有授权、审计、数据出域边界 | "谁都能调谁" |
2放在哪?——基础 / 框架 / 技能包
一句话定义
基础(Base)持平台,框架(Framework)持领域,技能包(Skill Package)持实现;基础层永远不持领域,技能包层永远不定义契约。
这正对应 Compound AI Systems 的"组件分层":不同组件职责不同、演进节奏不同,必须解耦。它回答的是"变更节奏撕裂"——平台底座月级、领域规范按客户周期、业务技能天/小时级。
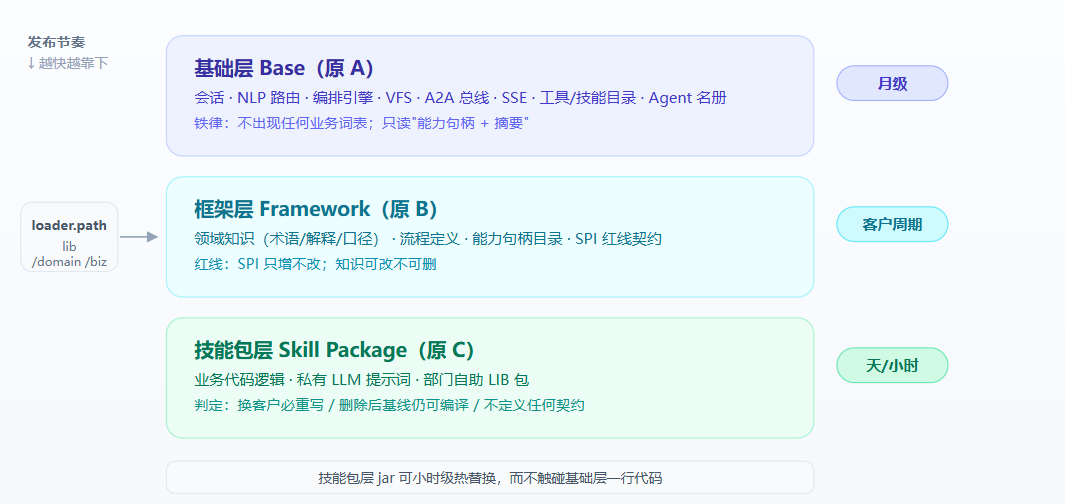
图 2 三级架构与发布节奏:分层让变更节奏正交——企业技能包能"天级演化"的物理前提。
2.1 三层角色画像
基础层 · 原 A
企业 AI 基础设施
零业务基线,月级发布。承载会话/路由/编排/VFS/A2A/SSE/技能目录/名册。铁律:不知道框架/技能包层存在。
框架层 · 原 B
领域知识资产与中枢
企业知识的家,客户周期发布。承载领域知识、配置、流程三件套与 SPI 红线契约。
技能包层 · 原 C
部门自助技能生产车间
业务实现,天/小时级发布。业务代码、私有提示词、自助 LIB。不定义任何契约。
2.2 归属矩阵与发布形态
资产 | 归属 | 载体 | 节奏 |
|---|---|---|---|
会话 / 编排 / A2A / SSE / 技能目录等平台能力 | 基础 | 平台基线 jar | 月 |
领域知识(术语 / 解释 / 口径) | 框架 | lib/domain | 客户周期 |
流程定义与配置 | 框架 | lib/domain | 客户周期 |
SPI 契约(红线接口) | 框架 | lib/domain | 只增不改 |
业务代码 / 私有提示词 / 自助 LIB | 技能包 | lib/biz | 天/小时 |
2.3 "端口化":让基础层持续"戒业务"
标签 | 含义 | 典型手法 |
|---|---|---|
端口 | 基础层保留调用点,实现经 SPI 端口下沉 | 只依赖ooder-*-spi零依赖契约 |
迁 C | 整类/场景迁出基础层 → 技能包 | 业务编排类、场景实现 |
迁 Agent | 迁到独立 Agent 服务 | 模板面 / 生成面本体 |
迁设计器宿主 | 设计器类归"开发期宿主" | net.ooder.rad.**外迁ood-plugs/ooder-rad |
薄化 | 基础层保留,外部类型收敛为本地薄 DTO | ProjectDescriptor→ 基础层自有ProjectRef |
门禁:让"戒业务"可机器判定
G1 业务词表扫描、G2 SPI 变更闸(只增不改)、G3 知识禁删闸。
3技能怎么接入、怎么被找到?——技能中心与寻址
MCP 解决"工具怎么接成一个统一接口";企业还差一件事:这些技能散落在不同节点上,谁来当目录? 答案是技能中心。
3.1 技能中心:一个独立进程的"技能 DNS"
skill-center 是独立 Spring Boot 进程(端口 8125,库 ooder_skillcenter),是全平台技能事实的唯一权威目录——不执行任何技能,只回答"谁有什么技能、在哪个节点、这次投给谁"。
分层 | 路径 | 调用方 | 鉴权 |
|---|---|---|---|
nodeClient(写/上报) | /api/sc/node/** | 各节点 | register 免;其余需sessionToken |
appClient(读/解析) | /api/sc/app/** | 各服务消费方 | Authorization: Bearer <共享令牌> |
adminClient(运维) | /api/sc/admin/** | 管理统计台 | X-Cluster-Admin-Token |
端点 | 作用 |
|---|---|
POST /api/sc/node/register · activate · login · heartbeat | 节点生命周期五步主线 |
POST /api/sc/node/report/roster | 名册镜像上报(nodeId + agents[]) |
PUT /api/sc/node/{id}/skills | 技能行上报(谁现在可达) |
POST /api/sc/app/resolve | 中心寻址(只回答"投给谁",不投递) |
GET /api/sc/admin/stats | 全局统计 |
线上实测(2026-10-11 生产):
{
  "catalogSkills": 254,
  "byKind": { "chat_tool":108, "capability":39, "nlp_skill":39,
              "unified_action":37, "chat_scene":24, "declarative":7 },
  "byNode": { "studio-8014":247, "studio-8018":247, "studio-8104":247,
              "studio-8199":225, "bpm-5340":7 },
  "agentCount": 4,   "agents": 14,
  "nodes": { "total": 11, "online": 8 }
}
读法
254 个技能分布在 4 个 studio 节点上——这就是"分布式技能网络"的真实形态:技能随节点分布、按需寻址。
3.2 技能绑定:从"技能"到"执行体"
MCP 把工具接成统一接口;这里多做了一层——技能绑定:
绑定 | 位置 | 字段 | 消费方 |
|---|---|---|---|
skillId ↔ sceneGroupId | agent-sdk/skills-framework | skillId/sceneGroupId/config/status | UserSceneGroupManagerImpl/BidirectionalSyncCoordinator |
skillId ↔ capId | scene-engine/scene/core | skillId/capId/priority/load(recordInvoke()) | SceneGroupInitializer(初始化期写"能力→最佳技能"绑定) |
3.3 分布式部署与角色
配置项 | 含义 |
|---|---|
ooder.cluster.node-name | 节点名(如studio-8014),名册主键 |
ooder.cluster.service-port | 节点服务端口 |
ooder.cluster.bootstrap-url | 集群引导地址 |
ooder.agent-sdk.gossip-port | 节点间 gossip 端口(发现与心跳) |
角色 | 状态 | 账号 | 部署 | 说明 |
|---|---|---|---|---|
MCP_AGENT | 有状态 | 独立账号 | 独立部署 | 业务执行体(技能+场景);SCENE/STUDIO/RAD只是其场景化别名 |
ROUTE_AGENT | 有状态 | 寄宿 | 内置 | 路由 / 编排 + 宿主内执行 |
END_AGENT | 无状态 | 无账号 | 部署即用 | 纯技能末端执行体 |
4怎么串起来跑?——skillsFlow 编排引擎
Anthropic 的忠告是"能用编排(workflow)就不用自治 agent"。skillsFlow 就是这个"编排"的内核:把过去 5 套并行执行模型统一为 1 套流程驱动引擎,并拆出三类执行引擎:
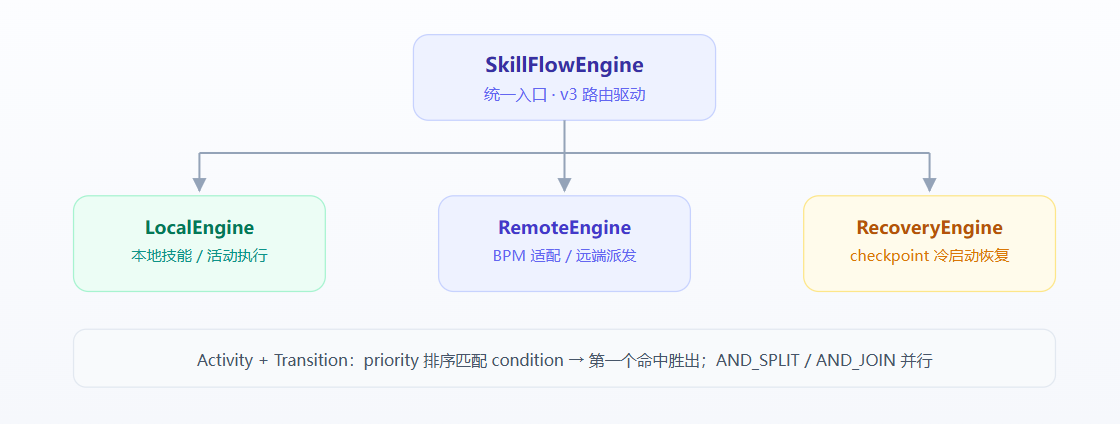
图 3 skillsFlow:把 5 套并行执行模型统一为 1 套,并拆出本地/远端/恢复三类执行引擎。
执行模型一句话说清:① 一个 Activity 执行完,遍历所有 sourceId = currentActivity 的 Transition;② 按 priority 排序、匹配 condition,第一个匹配者胜出;③ 无匹配触发 noMatchPolicy;④ 并行用 AND_SPLIT/AND_JOIN;⑤ 每个活动实例带 checkpoint → 串并行、断点重启、冷启动恢复、回归重试。
对照业界
这正覆盖 Building Effective Agents 的几种编排模式——Prompt Chaining(顺序迁移)、Routing(condition 分支/网关)、Parallelization(AND_SPLIT/JOIN)、Orchestrator-Workers(父流程 + 子流程/活动集);而"活动 + 迁移"就是吴恩达所讲 Tool Use / Planning 的确定化载体。
5北向与南向:控制面、数据面与 P2P
A2A 定义了"Agent 之间怎么委托任务",但通道怎么分、谁对中心、谁对节点,是企业要自己定死的。这里有一个容易踩的坑:同一个词有两套意思,先定口径再使用。
5.1 口径一(skill-center / 控制面视角)——本文主线
方向 | 定义 | 通道 | 前缀 / 主题 |
|---|---|---|---|
北向 | 节点 → 中心的控制面(注册/激活/登录/心跳/上报/查询/解析) | HTTP | /api/sc/** |
南向 | 中心 → 节点的数据面(任务下发 / 事件投递) | MQTT | ooder/node/{nodeId}/inbox(定向)ooder/event/A2A/{sceneGroupId}(组播) |
三条不可逾越的边界:① 方向——北向不承载业务数据,南向不做寻址决策;② 语义——/api/sc/** 是"向中心报到",/api/agent/** 是"对外提供服务";③ 权威——目录/地址/会话以中心为准,agent 名册以 Studio roster 为单主。北向五步主线:register → activate → login → heartbeat(周期) → report。
5.2 口径二(agent-sdk / 网络视角)——P2P 南向
服务层 | 面向 | 特征 | 落地手法 |
|---|---|---|---|
Northbound 北向 | 外部网络 | 复杂、灵活 | UDP/P2P、域安全、技能分享 |
Southbound 南向(P2P) | 内部网络 | 简单、确定性 | HTTP 优先、MCP 端点、UDP 辅助 |
南向(P2P)四套协议:DiscoveryProtocol(发现/自组网)、RoleProtocol(自决 MCP/ROUTE/END)、LoginProtocol、CollaborationProtocol(receiveTask/submitTaskResult/syncState/getGroupMembers)。发现为混合发现:DiscoveryType ∈ {LOCAL, LAN, WAN, ALL},配合 gossip 端口做心跳。
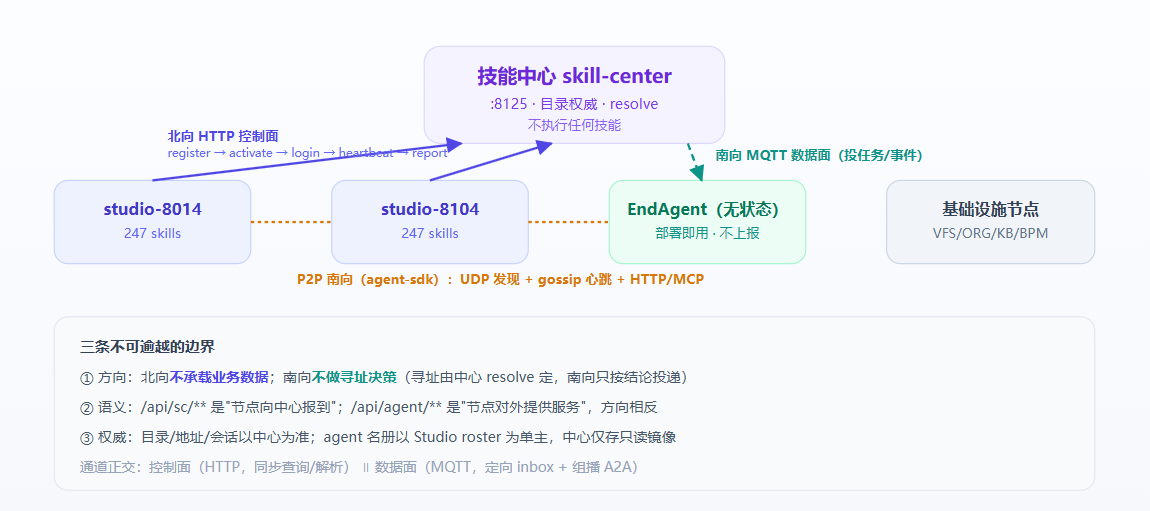
图 4 北向(节点→中心·控制面·HTTP)与南向(中心→节点·数据面·MQTT),及 agent-sdk 口径的 P2P 南向(UDP 发现 + gossip)。
5.3 链路主线:agentNode → agentRoute → skills
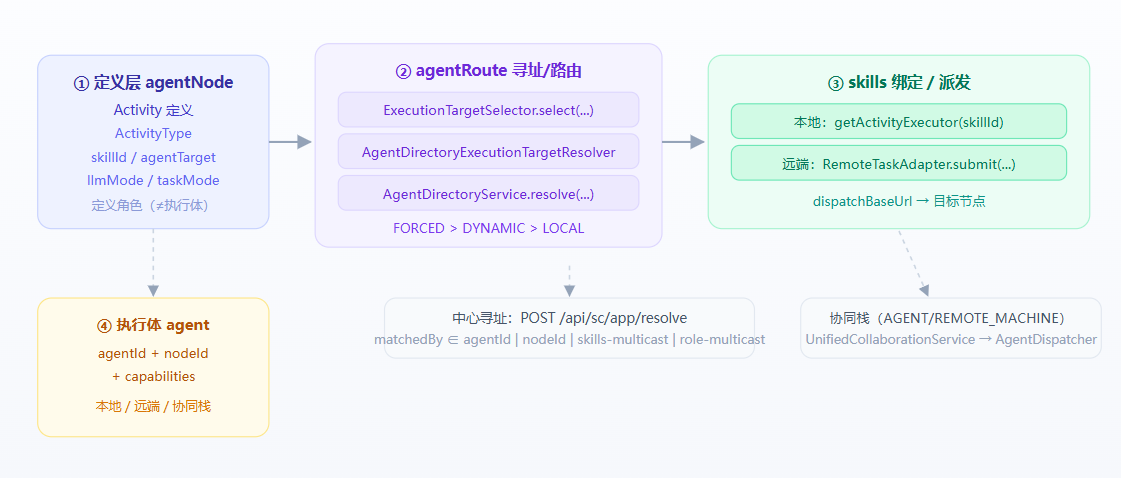
图 5 链路主线:定义层 Activity(agentNode)→ agentRoute 寻址决策 → skills 绑定/派发 → 执行体。
环节 | 类 |
|---|---|
分派总入口 | ActivityDispatcher.executeActivity |
寻址决策 | ExecutionTargetSelector→ExecutionTargetResolver→AgentDirectoryService |
寻址键映射 | AgentTargetAddressing.resolveKey / decide |
远端派发 | RemoteTaskAdapter.submit |
协同派发 | UnifiedCollaborationService+AgentDispatcher/RemoteMachineDispatcher |
命名澄清
本仓无独立 AgentRoute 类——"路由"由流程内 Transition/SplitMode/RoutingService 与执行体寻址 ExecutionTargetSelector 共同实现。
6实战:各 Agent 类型如何委派 / 绑定到具体技能
总原则
定义角色 ≠ 执行体。流程里的 LLMAgent / TaskAgent / HumanAgent / EventAgent 是定义层"活动角色"(节点类型),决定"由谁执行 / 如何推进";真正的"谁来干"是可被寻址/派发的执行体(agentId + nodeId + capabilities)。两者解耦,是分布式调度的前提。
6.1 五类活动角色与用途配置
定义角色 | ActivityType | 子模式 | 用途配置关键字段 | 执行体来源 |
|---|---|---|---|---|
LLMAgent | LLM_AGENT | llmMode | remoteAgent/capabilityId/agentTarget | ①显式remoteAgent;②否则中心寻址 |
TaskAgent | TASK | taskMode | skillId/targets[]/agentTarget | 本地执行器,或远程技能/端点 |
HumanAgent | HUMAN | humanMode | confirmType/timeoutPolicy | 人工 |
EventAgent | AGENT_EVENT | eventMode | 事件订阅 / 条件 /transitions | 暂停等待 / 埋点 |
子流程/起止 | SUBPROCESS/CALL_ACTIVITY/START/END | — | 引用定义 | 引擎内 |
角色 | 子模式取值 | 语义 |
|---|---|---|
LLMAgent | SINGLE/HARNESS/PROGRESSIVE | 单轮 / 带护栏 / 渐进式 |
TaskAgent | SINGLE/MULTI_SEQUENTIAL/MULTI_PARALLEL | 单任务 / 多任务串行 / 并行 |
HumanAgent | CONFIRM/FORM/APPROVAL/DELEGATE/EXCEPTION_INTERVENTION | 确认 / 表单 / 审批 / 委派 / 异常干预 |
EventAgent | SYNC_PAUSE(默认) /PARALLEL_HOOK | 暂停等待 → LLM 路由 / 埋点不阻断 |
6.2 派发与寻址决策
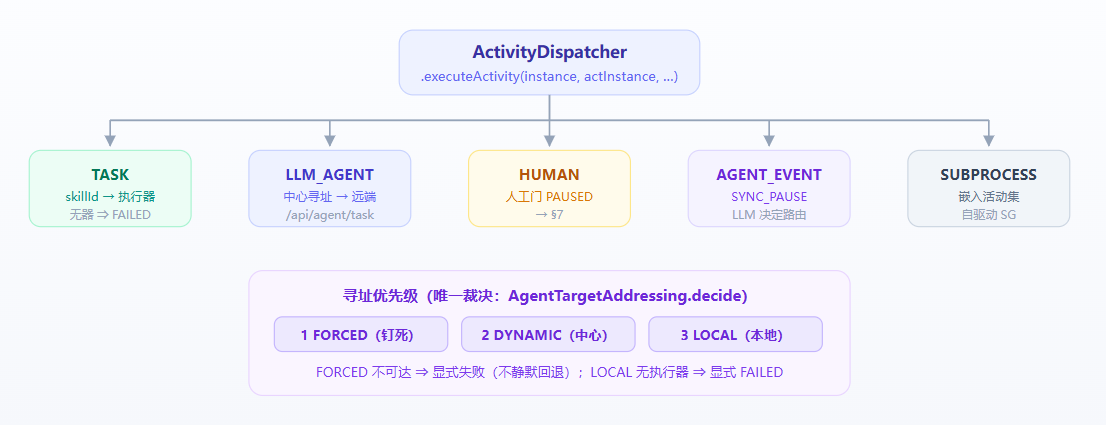
图 6 ActivityDispatcher
按 ActivityType 分派,以及各类型的寻址优先级决策。
6.3 逐类型:从定义字段到执行落点
- TASK(skillId):本地 executeSkillsTask → getActivityExecutor(skillId);无执行器 ⇒ 显式 FAILED(NO_EXECUTOR_FOR_SKILL)。远程 taskExecutionMode=REMOTE → tryExecuteRemoteLlmAgent → RemoteTaskAdapter.submit(...)。
- LLM_AGENT(capabilityId/agentTarget):mode → decide → resolveKey({domain}.{role})→ ExecutionTargetSelector.select → RemoteTaskAdapter.submit,北向端点 POST /api/agent/task。
- MCP / END_AGENT:MCP_AGENT/ROUTE_AGENT 上报 scenes[]/routeTargets[];END_AGENT 不上报。MCP 任务通路与 LLM 远端同走北向或协同栈。
- HUMAN:见第 7 节。SUBPROCESS:携带 embeddedActivities 时委托 SceneGroupExecutionEngine 自驱动。
6.4 真实示例
示例 A — LLMAgent(走中心寻址,定义期只给 role):
{
  "activityId": "bs_query_records",
  "role": "dataIngestor",
  "agentType": "LLM_AGENT",
  "skillId": "bs_query_records",
  "llmMode": "SINGLE",
  "noMatchPolicy": "SKIP",
  "requiredInputs": ["userMessage"],
  "producedOutputs": ["queryReport"],
  "config": { "domainRole": "bank_queryer", "tags": "bs,bank-statement", "stage": 0 }
}
示例 B — HumanAgent(人在环 + 可选操作):
{
  "activityId": "bs_human_confirm",
  "agentType": "HUMAN",
  "skillId": "bs_human_confirm",
  "config": {
    "confirmType": "CONFIRM",
    "operations": ["SEND","PAUSE","RESUME","TERMINATE","DELEGATE_H2H","DELEGATE_H2A","DELEGATE_H2T"]
  }
}
示例 C — 显式钉死执行体(FORCED 寻址,部署期 JSON):
{ "activityId": "bs_extract", "agentType": "LLM_AGENT",
  "config": { "agentTarget": { "mode": "FORCED", "agentId": "fin.bank-statement" } } }
寻址键:domain + role ⇒ "{domain}.{role}"(如 fin + bank-statement ⇒ fin.bank-statement,对财务名册 6/6 命中)。
7人在环上(HITL):HUMAN 交互逻辑
HITL 是业界公认的落地要点:关键动作要人介入。这里的工程难点不在"弹个框",而在"人点了确认,怎么回到正确的那个流程实例"。
7.1 三组定义字段
字段 | 取值 | 决定 |
|---|---|---|
humanMode | CONFIRM/FORM/APPROVAL/DELEGATE/EXCEPTION_INTERVENTION | 语义 + 前端面板uiType |
confirmType | CONFIRM/CHOICE/INPUT/FILE_UPLOAD/APPROVAL | 卡片交互形态 |
timeoutPolicy | 如ESCALATE_HUMAN/AUTO_CONFIRM | 超时行为(前端读为fallbackStrategy) |
7.2 前端:单一状态机 + 唯一渲染出口
- HumanStore:STATE = {PENDING, AUTO_PASSING, AUTO_PASSED, SUBMITTING, RESOLVED, FAILED, EXPIRED};去重键 keyOf = activityId|confirmId;NEVER_AUTO = [FILE_UPLOAD, INPUT, APPROVAL, CHOICE]、NEVER_AUTO_MODE = [APPROVAL, EXCEPTION_INTERVENTION](永不自动放行)。
- ConfirmBar:唯一渲染出口;CONFIRM/APPROVAL → 服务端操作栏(availableOperations + operationPermissions 单源);超时文案按 fallbackStrategy 区分。
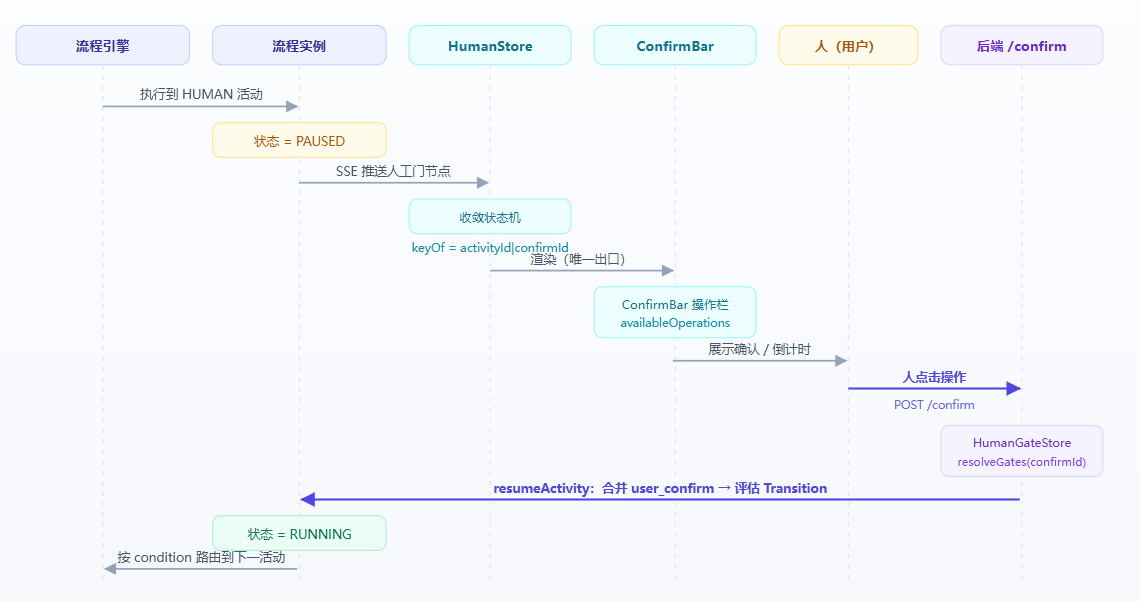
图 7 HUMAN 人在环交互时序:引擎置活动PAUSED→ SSE 推送人工门 →HumanStore收敛 →ConfirmBar渲染操作栏 → 人操作 → 后端/confirm→resumeActivity合并user_confirm并评估迁移。
跨节点人工门(最容易踩坑处)
人坐在编排节点的浏览器前,流程却卡在执行体节点上。决策必须经 flowRelay 转 GATE_DECISION 反向回投,落到正确的流程实例。
上下文键:confirmId(通常即 processInstanceId)、conversationId、activityId——三者共同保证"回填落到正确的实例、正确的活动"。人工门持久化见 HumanGateStore(超时缺省 30 分钟)。
8结语:把业务编排成可寻址的技能网络
回到开头的四个工程问题,本文的答案其实是四次解耦:
- 分层解耦(基础/框架/技能包):让变更节奏正交——平台月级、领域客户周期、技能天/小时级。
- 协议解耦(北向控制面 / 南向数据面):让"报到与查询"和"任务投递"走两条正交通道。
- 角色与执行体解耦(定义角色 ≠ 执行体):让"流程想干什么"与"谁来干"分开。
- 寻址与执行解耦(技能中心 + resolve):让"找得到"与"干得对"分开;FORCED > DYNAMIC > LOCAL + 失败显式,让调度可解释、可回退、可审计。
于是业务流程不再是写死的代码,而是一张可寻址的技能网络上的流程图:活动是节点、迁移是边、技能中心是 DNS、北向管目录、南向投任务、skillsFlow 是编排器、HUMAN 是流程里的一等公民。企业拿到的,不是几个跑得起来的 Agent,而是一套自己能持续编排、持续演化、持续调度的生产能力。
本文实现细节基于 ooder-platform 仓库真实代码与线上实测整理;代码基线以 main 分支近期提交为准。"南北向"存在两套口径,正文已分别标注。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号