#WorkBuddy# 436 份笔记导入知识库:不治理直接搜,top5 里 87.84% 是重复副本
原创
#WorkBuddy# 436 份笔记导入知识库:不治理直接搜,top5 里 87.84% 是重复副本
原创
用户12784192
发布于 2026-10-11 10:49:22
发布于 2026-10-11 10:49:22
本文所有数据来自一次可复现的本地实验:现场合成 436 份 Markdown 技术笔记(0.88 MB)与 500 条带标准答案的检索 query,用 Python 跑完"导入治理 → 去重 → 检索评估"全流程,每个数字都来自真实运行输出,脚本与语料生成器在文末给出。
一、痛点开场
把一批散落的 Markdown 笔记灌进知识库,是很多人搭个人知识库的第一步。直觉上的做法很简单:遍历目录、读文件、切分、入库、能搜就行。
我用 436 份笔记做了个对照实验,其中故意埋了 136 份"脏数据":45 份字节级完全重复、35 份改过标题的近似重复、28 份 GBK/BOM 编码异常、22 份缺 frontmatter 元数据、6 份截断或二进制损坏。
直接入库、直接搜,结果是:
指标 | 数值 |
|---|---|
top5 结果里"后归档副本"占比 | 87.84% |
top5 里缺元数据 / 含乱码的脏版本占比 | 28.96% |
top5 里真正的正本 | 只有 12.16% |
换成口语化长问句去搜(250 条) | P@1 掉到 0.0%,Hit@5 只有 2.4% |
也就是说:搜出来了,但给你的基本是同一篇笔记的第五个副本,而且可能是那份缺元数据、带乱码的版本。长问句一上来,朴素方案更是全军覆没——中文整句不带空格,被当成一个超长词去子串匹配,字面根本对不上。
二、根因分析
三个根因,各对应一层治理:
1. 重复文档不是"冗余",是"占坑"。 朴素匹配按命中词数排序,副本与正本命中数完全相同,排序打平;平局再按修改时间倒序一破——后归档的副本永远排在前面。300 篇正本里塞进 136 份副本,top5 直接被副本承包。
2. 编码不归一,重复就查不出来。 同一篇笔记一份存成 UTF-8、一份存成 GBK,字节级 SHA256 完全不同,"看起来"是两篇文档。必须先解码归一,再算哈希,41 份"归一后才现形"的重复就是这么来的。
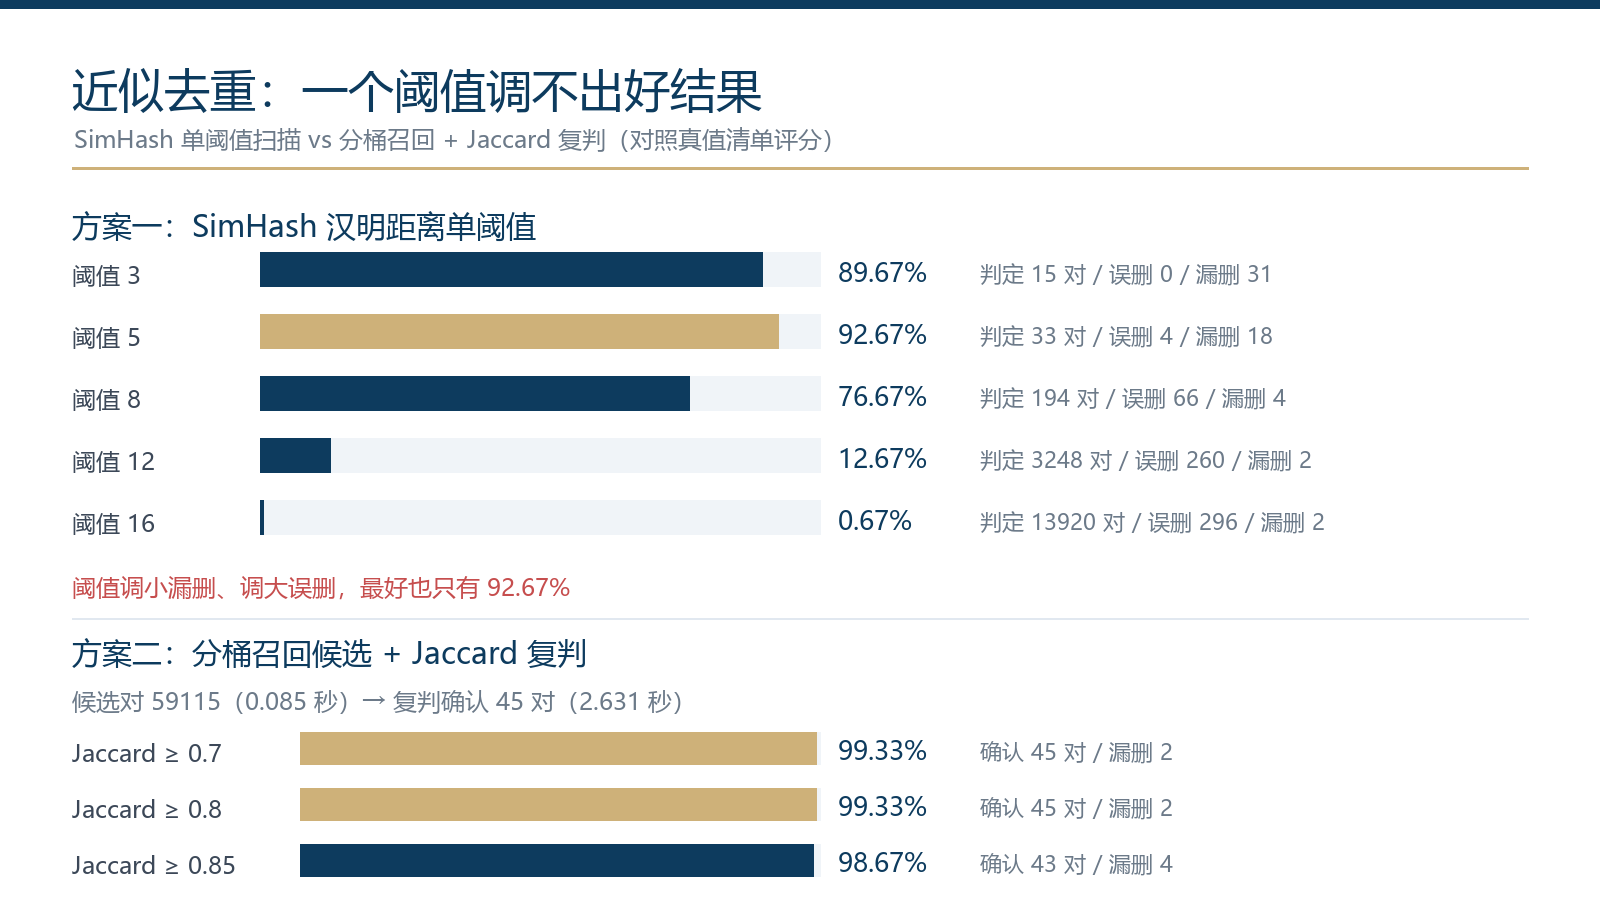
3. 单一相似度阈值解决不了"近似重复"的判定。 SimHash 汉明距离阈值调小就漏删、调大就误删(见下文实测),因为"距离"和"是不是同一篇"之间本来就不是一条单调曲线。
三、真实数据:治理前后的完整对比
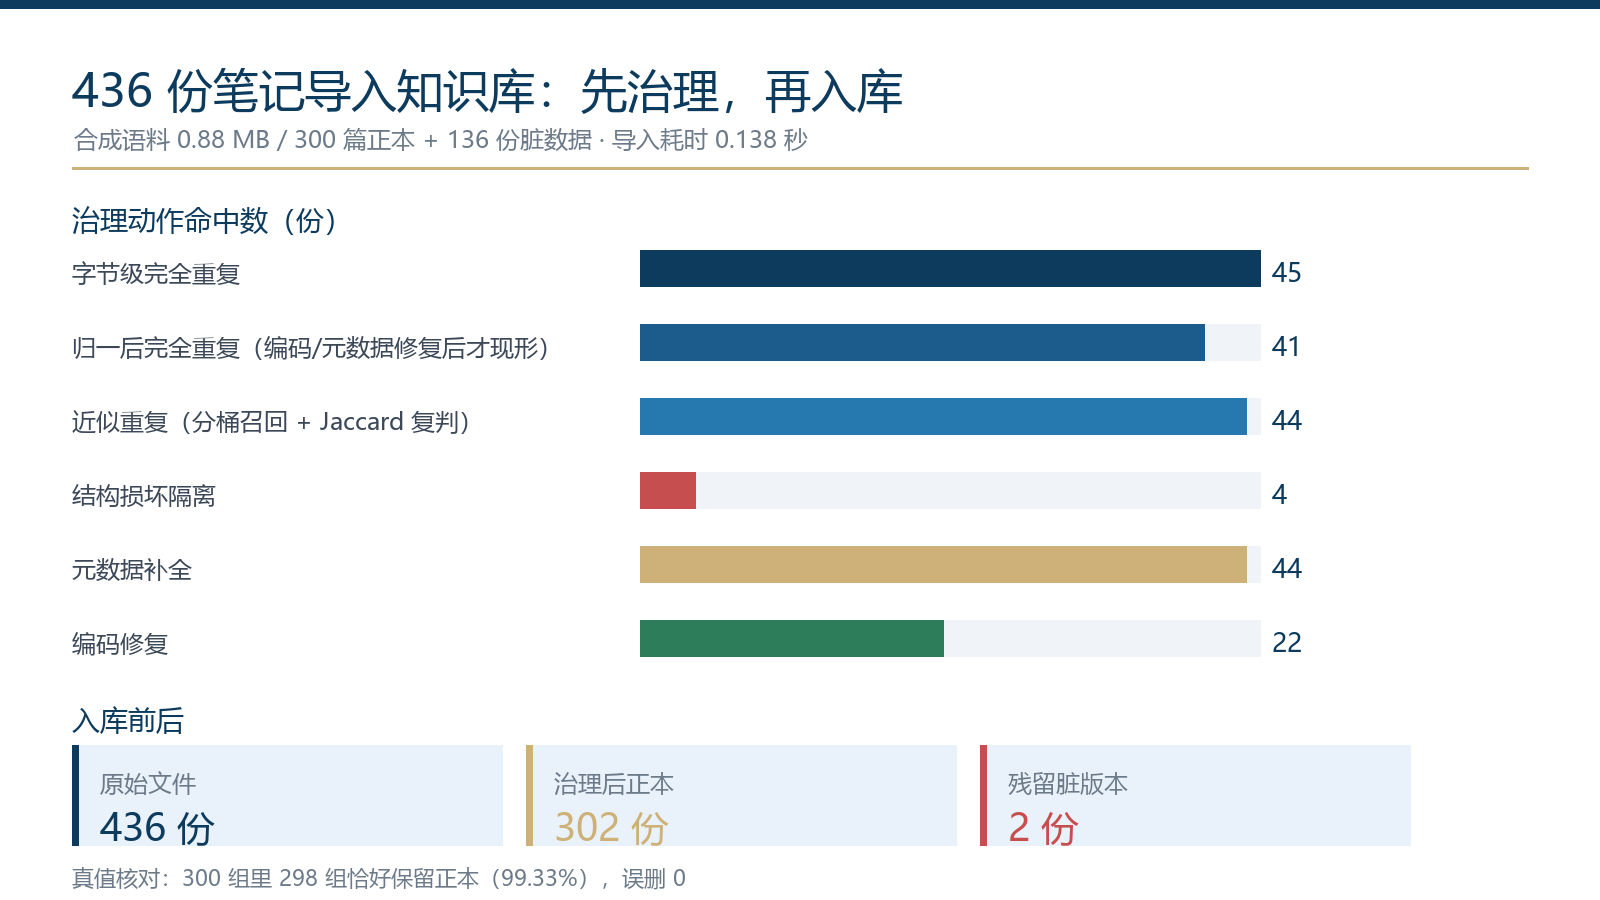
3.1 导入治理(436 → 302,耗时 0.138 秒)
治理动作 | 命中份数 |
|---|---|
字节级完全重复(SHA256) | 45 |
归一后完全重复(解码 + 空白归一后才现形) | 41 |
近似重复(分桶召回 + Jaccard 复判) | 44 |
结构损坏隔离(控制符 / 无法解析标题) | 4 |
元数据补全(从 H1 抽标题、从正文抽标签) | 44 |
编码修复(UTF-8 失败后回退 GBK) | 22 |
对照真值清单评分:300 个来源组里 298 组恰好只保留正本(99.33%),误删 0 组,仅 2 份"截断但仍有长度"的文件漏网。
3.2 近似去重:单阈值 vs 两阶段
单阈值 SimHash 扫描(对照真值评分):
汉明距离阈值 | 判定对数 | 正确率 | 误删组 | 漏删组 |
|---|---|---|---|---|
3 | 15 | 89.67% | 0 | 31 |
5 | 33 | 92.67% | 4 | 18 |
8 | 194 | 76.67% | 66 | 4 |
12 | 3248 | 12.67% | 260 | 2 |
16 | 13920 | 0.67% | 296 | 2 |
改成两阶段——先用 SimHash 16×4 分桶召回候选(59,115 对,0.085 秒),再对候选对算 5-shingle Jaccard 复判(2.631 秒),Jaccard ≥ 0.70 时确认 45 对,正确率 99.33%,误删 0。
3.3 检索质量(四方案 × 两套 query)
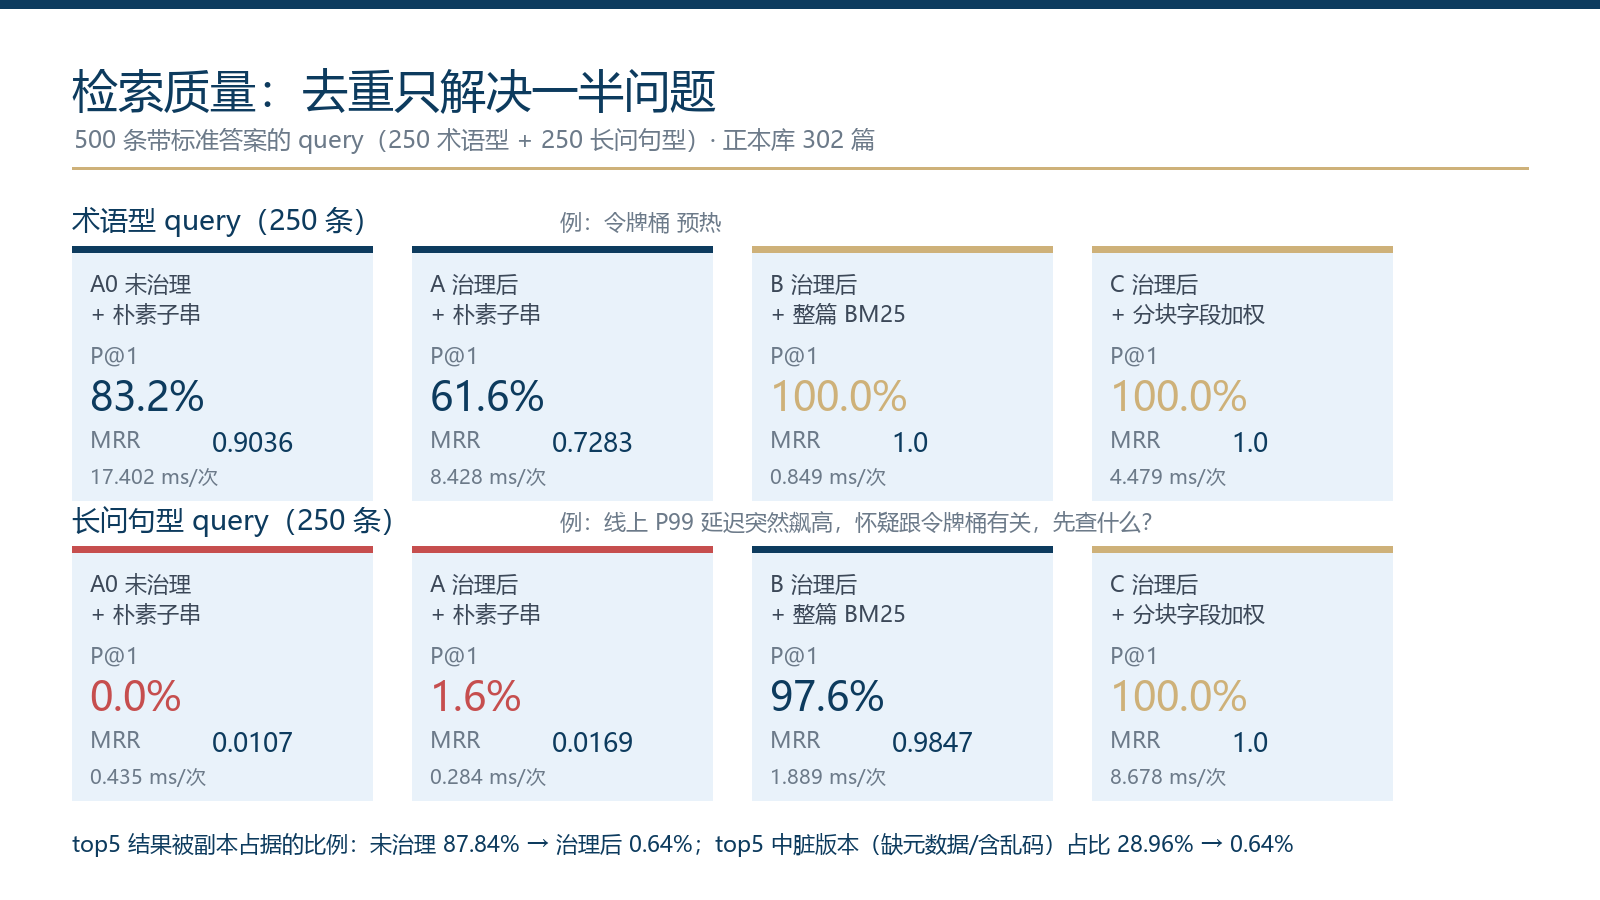
术语型 query(250 条,例:"令牌桶 预热"):
方案 | P@1 | Purity@5 | MRR | 耗时/次 |
|---|---|---|---|---|
A0 未治理 + 朴素子串 | 83.20% | 83.20% | 0.9036 | 17.40 ms |
A 治理后 + 朴素子串 | 61.60% | 77.44% | 0.7283 | 8.43 ms |
B 治理后 + 整篇 BM25 | 100% | 99.52% | 1.0 | 0.85 ms |
C 治理后 + 分块 + 字段加权 BM25 | 100% | 99.36% | 1.0 | 4.48 ms |
长问句型 query(250 条,例:"线上 P99 延迟突然飙高,怀疑跟令牌桶有关,先查什么?"):
方案 | P@1 | Purity@5 | MRR | 耗时/次 |
|---|---|---|---|---|
A0 未治理 + 朴素子串 | 0.00% | 1.76% | 0.0107 | 0.44 ms |
A 治理后 + 朴素子串 | 1.60% | 1.60% | 0.0169 | 0.28 ms |
B 治理后 + 整篇 BM25 | 97.60% | 98.40% | 0.9847 | 1.89 ms |
C 治理后 + 分块 + 字段加权 BM25 | 100% | 98.80% | 1.0 | 8.68 ms |
两个值得注意的现象:
- 治理后朴素子串的 P@1 反而从 83.2% 掉到 61.6%——因为副本占坑消失后,朴素匹配"打平就乱排"的短板彻底暴露。去重解决的是"给什么",解决不了"排什么序"。
- 短 query 时整篇 BM25(B)已经足够;长问句时 C 的分块 + 字段加权才显出优势(97.6% → 100%,MRR 0.9847 → 1.0)。分块的代价是每次检索 4–9 ms,300 篇规模完全可接受。
四、可复制代码
完整的导入治理核心逻辑(约 60 行,无第三方依赖):
import os, re, json, hashlib, time
from collections import Counter, defaultdict

def decode(raw: bytes):
    """三层递进:BOM -> UTF-8 -> GBK -> latin-1 兜底"""
    if raw.startswith(b"\xef\xbb\xbf"):
        return raw.decode("utf-8-sig"), "utf-8-sig"
    try:
        return raw.decode("utf-8"), "utf-8"
    except UnicodeDecodeError:
        pass
    for enc in ("gbk", "big5"):
        try:
            return raw.decode(enc), enc
        except UnicodeDecodeError:
            pass
    return raw.decode("latin-1"), "latin-1(坏)"

FM = re.compile(r"^---\n(.*?)\n---\n", re.S)
H1 = re.compile(r"^#\s+(.+)$", re.M)
CTRL = re.compile(r"[\x00-\x08\x0b\x0c\x0e-\x1f]")

def ingest(corpus_dir):
    by_bytes, by_text, out = {}, {}, []
    for fn in sorted(os.listdir(corpus_dir)):
        raw = open(os.path.join(corpus_dir, fn), "rb").read()
        bk = hashlib.sha256(raw).hexdigest()
        if bk in by_bytes:                 # 第 1 层:字节级精确去重
            continue
        text, enc = decode(raw)            # 第 2 层:编码归一
        if CTRL.search(text):              # 第 3 层:结构隔离
            continue
        m = FM.match(text)
        h = H1.search(text)
        if not m and not h:                # 既无 frontmatter 也无 H1 -> 隔离
            continue
        title = h.group(1).strip() if h else ""
        norm = re.sub(r"\s+", " ", title + " " + text).strip()
        tk = hashlib.sha256(norm.encode("utf-8")).hexdigest()
        if tk in by_text:                  # 第 4 层:归一后精确去重
            continue
        by_bytes[bk] = by_text[tk] = fn
        out.append(fn)
    return out
近似去重的两阶段判定:
def candidate_pairs(fps, bands=16, rows=4):
    """SimHash 分桶召回:任一 4 位分片相同即入同一桶,避免 O(n^2) 全比对"""
    buckets = defaultdict(list)
    for fn, fp in fps:
        for b in range(bands):
            buckets[(b, (fp >> (b * rows)) & ((1 << rows) - 1))].append(fn)
    out = set()
    for bk in buckets.values():
        if len(bk) > 400:                  # 超大桶多为高频通用词,跳过防退化
            continue
        for i in range(len(bk)):
            for j in range(i + 1, len(bk)):
                out.add(tuple(sorted((bk[i], bk[j]))))
    return out

def shingles(text, k=5):
    t = tokenize(text)
    return {tuple(t[i:i + k]) for i in range(max(1, len(t) - k + 1))}

def jaccard_confirm(cands, sh, thr=0.70):
    out = set()
    for a, b in cands:
        A, B = sh[a], sh[b]
        if A and B and len(A & B) / (len(A) + len(B) - len(A & B)) >= thr:
            out.add((a, b))
    return out
BM25 的关键参数只有两个:k1=1.5 控制词频饱和,b=0.75 控制文档长度归一。分块检索则按空行把正文切成约 200 字的块,对每块独立打分后取块内最大值代表该文档,再与标题(权重 3)、标签(权重 2)加权合并。
五、踩坑清单
- mtime 是隐形的排序开关。 实验第一版里我把"正本 mtime 设为 30 天前"时用了硬编码时间戳
1800000000 - 86400*30,结果这个值落在 2027 年,比副本还新,去重逻辑"保留更旧版本"反而把正本全删了,正确率从 99.33% 掉到 85%。相对时间一律用time.time()减偏移,别用绝对纪元值。 - 编码问题不修,重复就隐身。 28 份编码异常副本中,22 份在解码归一后才被哈希查重命中——按字节查,它们是"不同"的文件。
- 截断检测不能只看长度。 6 份损坏文件里,3 份二进制垃圾被控制符规则拦下,1 份过短被长度阈值拦下,但 2 份"截断后仍有几百字"的顺利过关,成了 302 份正本里仅有的残留。更可靠的做法是校验 Markdown 结构完整性(frontmatter 是否闭合、代码块围栏是否配对)。
- 朴素子串方案必须配分词。 中文长问句不带空格,整句成一个 token,子串匹配直接归零。哪怕只做字符二元组(bigram)切分,也能把 Hit@5 从 2.4% 拉到 100%。
- 超大桶要跳过。 分桶召回时,高频通用词会让某个桶塞进上千个文档,桶内两两比对退化回 O(n²),必须设桶容量上限。
六、给 WorkBuddy 的提示词模板
把这套流程沉淀成一句提示词,以后任何一批文档入库前都可以直接用:
我有一批文档要导入知识库,目录在
<绝对路径>。请按以下流程处理并给我一份报告:① 逐文件读字节,按 BOM→UTF-8→GBK→latin-1 顺序解码,记录编码修复数;② 字节级 SHA256 去重;③ 解码并做空白归一后再去重;④ 用 SimHash 分桶召回候选 + 5-shingle Jaccard ≥ 0.70 复判做近似去重,同组保留修改时间最早的一份;⑤ 无标题或含控制符的文件进隔离区,不要入库;⑥ 完成后随机抽 10 组重复,给我看"保留了哪份、删了哪份";⑦ 全程不要修改原文件,所有输出写到./out。
最后一句"随机抽 10 组给我看"很重要:自动化的每一步都应该留出人工抽检的口子,99.33% 的正确率也意味着还有 2 组是错的。
七、收尾
这轮实验的总账:436 份文件、0.138 秒完成导入治理,436 → 302 份正本,去重真值正确率 99.33%、误删 0;检索 P@1 从"不治理 83.2% / 长问句 0%"拉到两组 query 全部 100%,top5 副本占比从 87.84% 降到 0.64%,脏版本占比从 28.96% 降到 0.64%。
一句话总结:知识库检索质量的上限,不是检索算法决定的,而是入库那一刻决定的。先把"库里有什么"治理干净,再谈"怎么搜"。在 WorkBuddy 里这件事最合适的形态,就是把上面第七节的提示词存成常用指令——语料换成什么,流程都是同一套。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号