#WorkBuddy# 60 份 PPT 批量套模板:顶层遍历只改了 47%,我用“逐 run 原地改”做到 100% 且格式零损伤
原创
#WorkBuddy# 60 份 PPT 批量套模板:顶层遍历只改了 47%,我用“逐 run 原地改”做到 100% 且格式零损伤
原创
用户12784192
发布于 2026-10-10 10:36:32
发布于 2026-10-10 10:36:32
一、先说结论:一套"看起来成功了"的模板脚本
上个月我把一套品牌规范从旧版换到新版:主色从暗红 #C00000 换成深海蓝 #0D3B5E,正文字体从 Arial 换成微软雅黑。手上有 60 份历史方案要统一刷一遍。
第一版脚本三十行,跑完打印"已改写 9452 处",没报任何错。我随手翻了两份文件,标题确实变成蓝色了,就发给了同事。
同事回我一句话:"你翻到第 8 页看看那张表。"
表格里全是暗红。备注页也是。还有一堆文本框,因为它们被作者用"组合"框起来了。
这就是本文要讲的事:PPT 批量套模板,难点从来不是"怎么改颜色",而是"怎么不遗漏、怎么不破坏"。前者靠 API,后者靠工程纪律。
本文所有数字都来自一次真实跑批,语料是现场合成的 60 份 PPT(994 页 / 19,912 个文本 run),不是估算。
二、根因分析:漏改不是随机的,是按"容器类型"整块漏
python-pptx 有一个非常容易踩的直觉陷阱:
for slide in prs.slides:
    for shape in slide.shapes:        # ← 只到这一层
        if shape.has_text_frame:
            ...
slide.shapes 是顶层扁平迭代器,它只给你看第一层。而真实 PPT 里,文本藏在至少五个地方:
容器类型 | 访问路径 | 为什么容易漏 |
|---|---|---|
顶层文本 |
| 唯一被覆盖到的 |
组合 Group |
| 作者把几个文本框 group 一下,就"隐身"了 |
表格单元格 |
|
|
备注页 |
| 不在 |
版式 Layout |
| 页脚/水印模板文本,在母版层 |
用真实语料跑一遍就看得非常清楚。我合成的 60 份 deck 里,各容器 run 数量分布是:
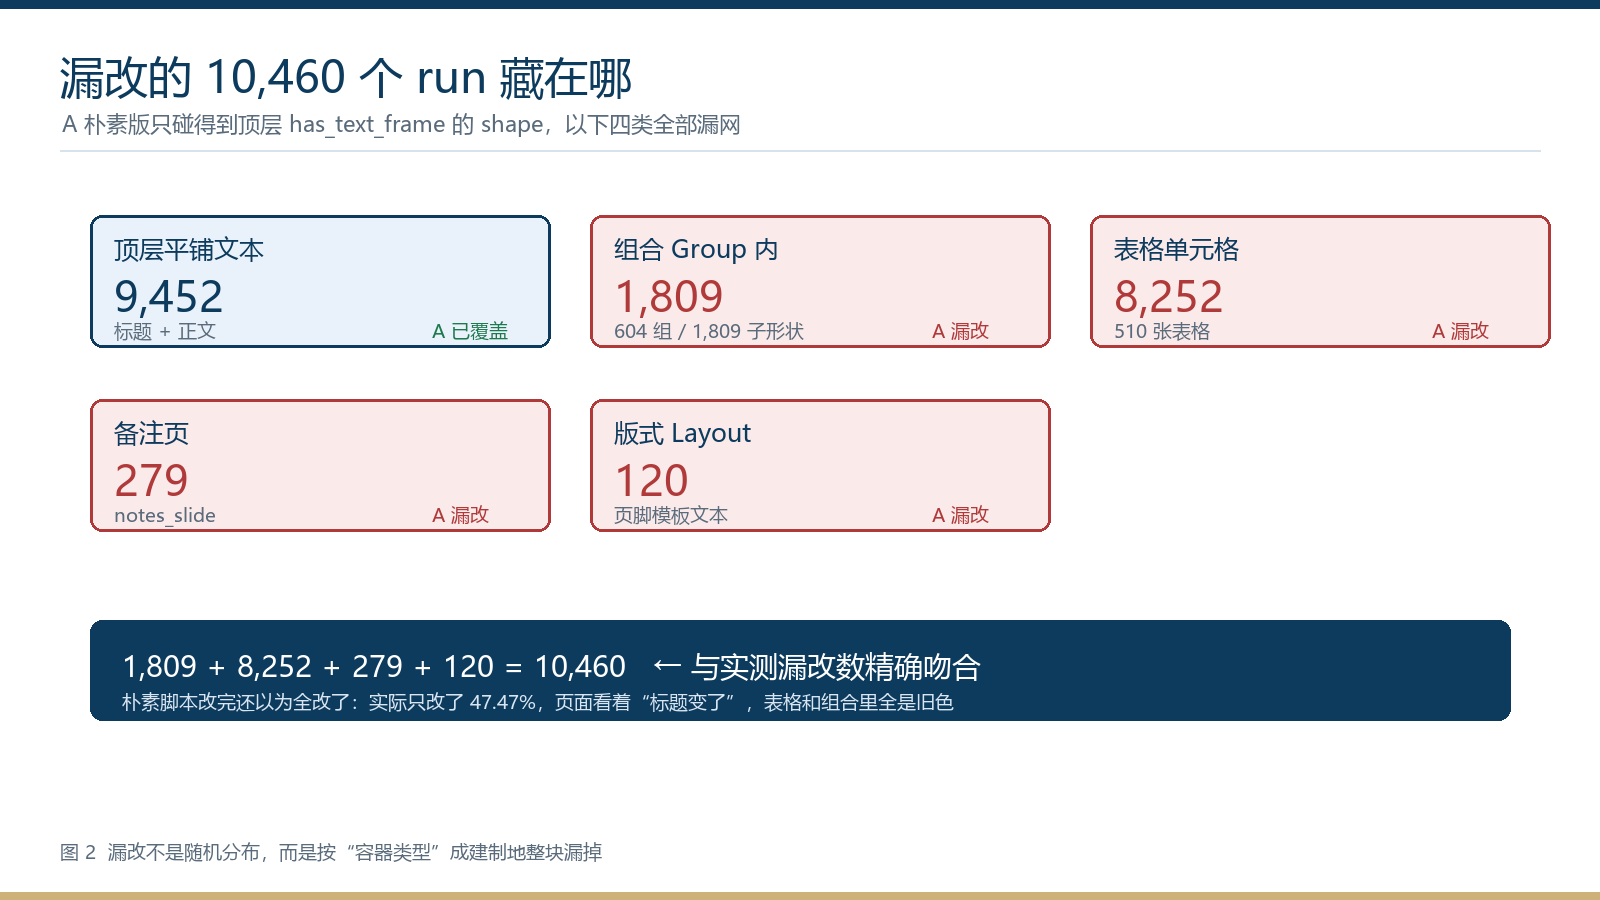
顶层平铺文本 9,452 表格单元格 8,252 ← 510 张表格 组合 Group 1,809 ← 604 个组合 / 1,809 个子形状 备注页 279 版式 Layout 120 ───────────────────── 合计 19,912
顶层只占 47.47%。 也就是说,那套"跑完没报错"的脚本,实际漏了 10,460 个 run:
1,809 + 8,252 + 279 + 120 = 10,460 ← 与实测漏改数精确吻合
这个等式完全对得上,说明漏改不是随机散落,而是按容器类型成建制地整块漏掉。这也解释了为什么"随手翻两页看着是好的"——你翻到的恰好都是顶层文本框。
三、真实数据对比:三档策略
为了把"能跑"和"能上生产"区分开,我写了三档实现,并用一个独立的只读审计器(上帝视角全遍历,与三档实现完全解耦)当裁判打分。
三档实现
- A 朴素版:只遍历
slide.shapes顶层,只处理has_text_frame。 - B 递归重写版:递归了 group / table / notes / layout 全覆盖,但用
tf.text = tf.text整体回写后统一套色——这是网上最常见的一种写法。 - C 治理式:全覆盖 + 逐 run 原地改属性,不重建任何 run。
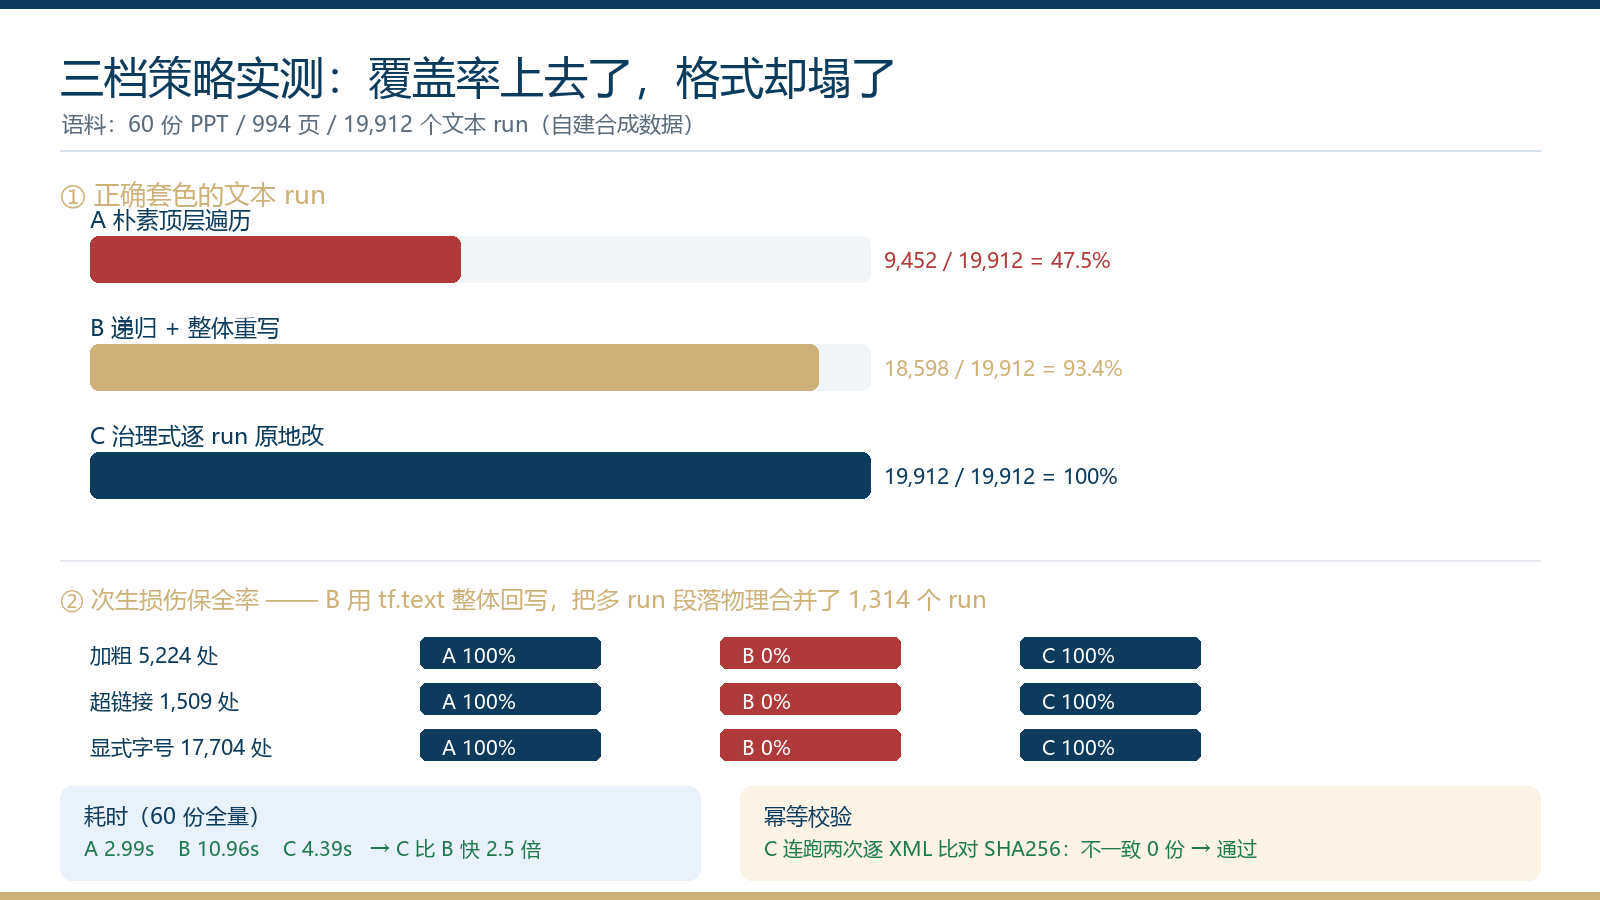
实测结果(60 份 / 994 页 / 19,912 run)
指标 | A 朴素顶层 | B 递归+整体重写 | C 治理式 |
|---|---|---|---|
正确套色 run | 9,452 | 18,598 | 19,912 |
覆盖率 | 47.47% | 93.40% | 100.00% |
漏改 run | 10,460 | 1,314 | 0 |
加粗保全 | 100% | 0% | 100% |
超链接保全 | 100% | 0% | 100% |
显式字号保全 | 100% | 0% | 100% |
处理后 run 总数 | 19,912 | 18,598(-1,314) | 19,912 |
耗时(60 份) | 2.99s | 10.96s | 4.39s |
这张表最值得看的是第二行和第四行
B 的覆盖率冲到 93.4%,但次生损伤是 100%。
原因在 tf.text = tf.text 这个回写操作。python-pptx 的 text_frame.text setter 会清空原 XML 段落树,然后按换行符重建。原来一个段落里有 3 个 run(半句加粗、半句带链接、半句显式 14pt),回写后变成 1 个 run,格式全部丢失。
用真实语料验证:B 处理后 run 总数从 19,912 掉到 18,598,物理减少了 1,314 个 run。而语料里我恰好埋了 5,224 处加粗、1,509 处超链接、17,704 处显式字号——B 全部归零。
这就意味着:B 不但没修好,还顺手毁掉了原作者的全部排版意图。 用它跑一遍,你得从头再排一遍版。
A 反而是"安全的失败"——它没干完活,但也没搞破坏(加粗/超链/字号保全都是 100%)。
C 的取舍:覆盖率 100%、次生损伤 0%、耗时 4.39s,比 B 还快 2.5 倍。原因是逐 run 改属性只改 <a:solidFill> 和 <a:latin> 两个节点,不需要重建 XML 树;而 B 的 tf.text setter 每次都在做"拆树+建树"。
四、可复制代码
4.1 全覆盖迭代器(核心,20 行)
from pptx.enum.shapes import MSO_SHAPE_TYPE

def iter_text_frames(slide):
    """产出 (类别, text_frame):覆盖 组合/表格/备注,外加版式层"""
    # --- 幻灯片层:递归穿透 group,单独处理 table ---
    def walk(shapes, cat):
        for sh in shapes:
            if sh.shape_type == MSO_SHAPE_TYPE.GROUP:
                yield from walk(sh.shapes, "group")   # ★ 递归
                continue
            if getattr(sh, "has_table", False):
                for row in sh.table.rows:
                    for cell in row.cells:
                        yield ("table", cell.text_frame)   # ★ 表格
                continue
            if getattr(sh, "has_text_frame", False):
                yield (cat, sh.text_frame)

    yield from walk(slide.shapes, "flat")

    # --- 备注页 ---
    if slide.has_notes_slide:
        yield ("notes", slide.notes_slide.notes_text_frame)

    # --- 版式层(页脚/水印模板文本)---
    for sh in slide.slide_layout.shapes:
        if getattr(sh, "has_text_frame", False):
            yield ("layout", sh.text_frame)
4.2 逐 run 原地改(关键:绝不回写 tf.text)
from pptx.dml.color import RGBColor

NEW_COLOR = RGBColor(0x0D, 0x3B, 0x5E)   # 深海蓝
NEW_FONT  = "Microsoft YaHei"

def apply_theme(tf, stats):
    for p in tf.paragraphs:
        for r in p.runs:
            r.font.name = NEW_FONT            # 改 <a:latin typeface>
            r.font.color.rgb = NEW_COLOR      # 改 <a:solidFill>
            stats["touched"] += 1
            # ★ 注意:这里不碰 bold / hyperlink / size,它们原样保留
只要不出现 tf.text = ...,格式就不会丢。 这是整套方案唯一不可违反的纪律。
4.3 版式体检:几何估算 + 阈值标定
换字体最大的隐患不是颜色,而是字号变了导致文本溢出。做完套模板一定要体检:
import math

def overflow_ratio(shape):
    """返回 需求高度 / 实有高度;> 1.00 即疑似溢出"""
    w, h = shape.width, shape.height          # EMU
    size_pt = next((r.font.size.pt
                    for p in shape.text_frame.paragraphs
                    for r in p.runs if r.font.size is not None), 18.0)
    W, H = w / 12700.0, h / 12700.0           # EMU → pt
    units = sum(0.55 if ord(c) < 128 else 1.0 # 西文按 0.55 em,中文按 1 em
                for p in shape.text_frame.paragraphs for c in p.text)
    per_line = max(1.0, W / size_pt)          # 每行能放几个 em
    lines    = max(1, math.ceil(units / per_line))
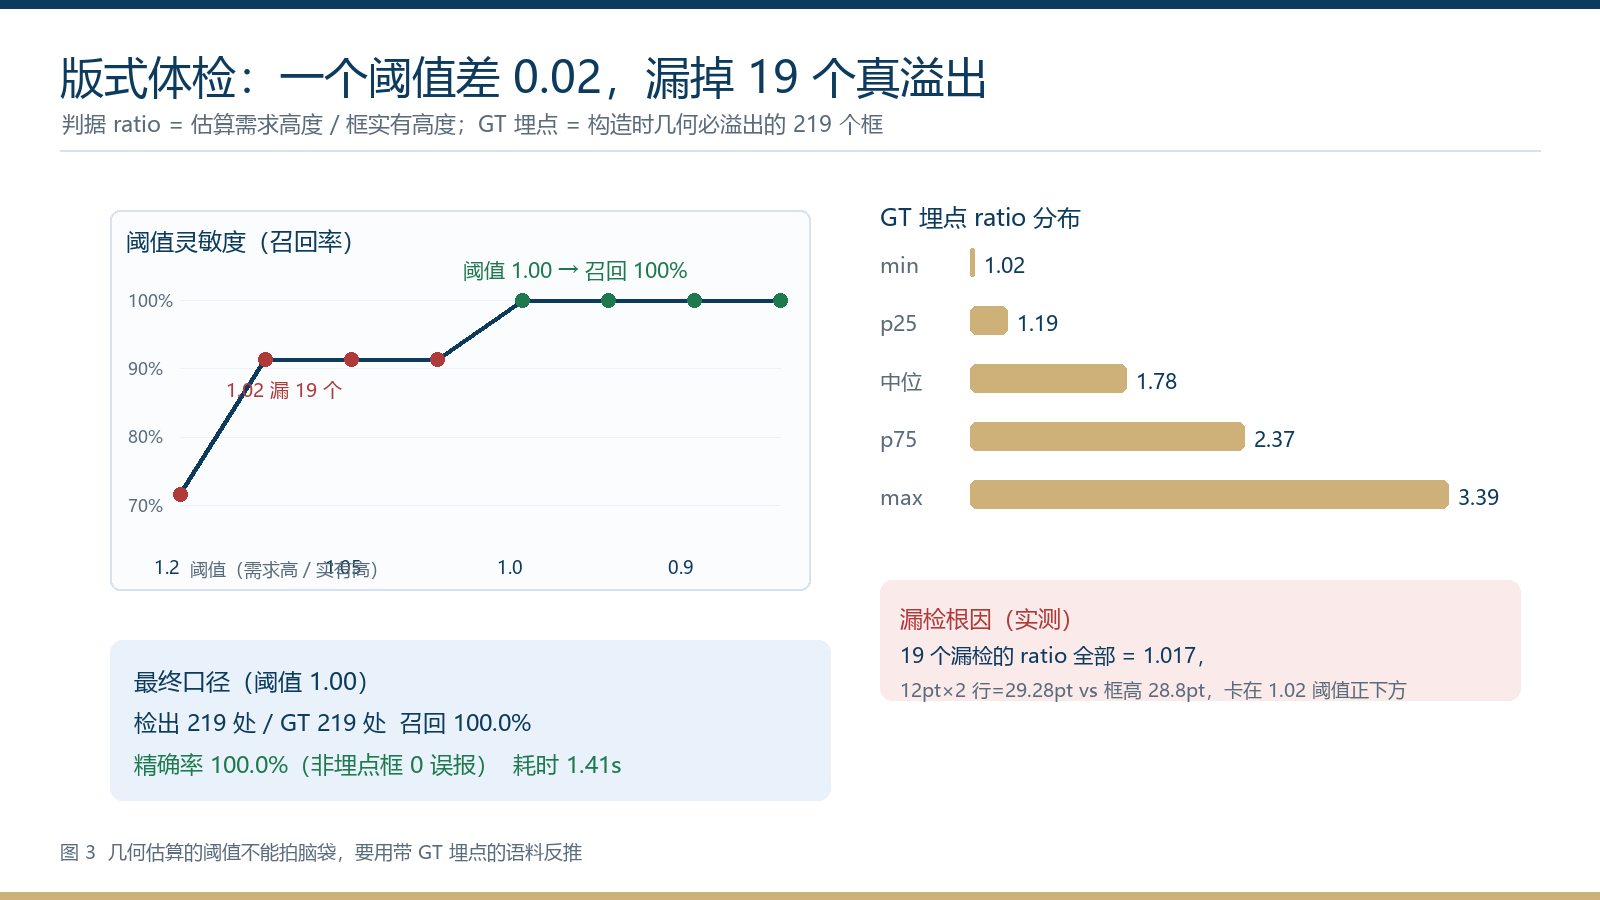
return lines * size_pt * 1.22 / H # 行距按 1.22 倍估阈值该定多少?我用带 GT 埋点的语料反推——合成语料时故意造了 219 个"几何上必溢出"的框,然后看不同阈值的召回:
阈值 | 召回率 | 命中框数 | 精确率 |
|---|---|---|---|
1.20 | 71.69% | 157 | 100% |
1.10 | 91.32% | 200 | 100% |
1.02 | 91.32% | 200 | 100% |
1.00 | 100.00% | 219 | 100% |
0.90 | 100.00% | 219 | 100% |
看起来 1.02 和 1.00 只差 0.02,但召回差了 8.68 个百分点。漏掉的 19 个,ratio 全部恰好等于 1.017 —— 12pt × 2 行 = 29.28pt,框高正好 28.8pt,卡在阈值正下方一个极窄的临界带里。
把阈值定到 1.00,召回 100%、精确率仍是 100%(非埋点框 0 误报),耗时 1.41s。这就是最终口径。
五、踩坑清单
跑这套流程,我踩了 6 个坑,其中 3 个是静默失败(不报错但结果错):
坑 1 · 溢出框尺寸被双重转换(静默失败)
add_textbox(x, y, w, Inches(h)) —— 如果参数 h 本身已经是 Inches(0.4),再套一层 Inches() 会得到 Inches(0.4) 的 EMU 值(365760)被当作"英寸数"再乘一次 914400,结果框高变成 200 万英寸。不报错,几何体检直接失效。修法:统一单位,别混着传 EMU 和 float。
坑 2 · python-pptx 1.0.x 移除了 color.type_name(直接崩)
老教程里的 if run.font.color.type_name == "RGB" 在 1.0.2 上抛 AttributeError: 'ColorFormat' object has no attribute 'type_name'。正确写法:直接 try: str(run.font.color.rgb) except: None,theme 色/继承色会自然落到 None。
坑 3 · 向 slide_layout 加文本框:没有 add_textbox API(直接崩)
LayoutShapes 对象不提供 add_textbox。要往版式里塞文本,得走底层工厂:
from pptx.oxml.shapes.autoshape import CT_Shape
sp = CT_Shape.new_textbox_sp(991, "FooterTemplate",
                             Inches(.5), Inches(6.8), Inches(9), Inches(.4))
layout.shapes._spTree.append(sp)
坑 4 · tf.text = tf.text 静默毁掉全部格式
本章第三节的 B 档就是反面教材。症状极隐蔽:跑完不报错、文字也没错,只是加粗/链接/字号全没了,run 数从 19,912 掉到 18,598。体检方法:改写前后各数一次 run 总数,数量下降就是踩了此坑。
坑 5 · 组合对象要递归,且 shape_type == 6 而不是 has_text_frame
Group 的 has_text_frame 是 False,必须显式判断 shape_type == MSO_SHAPE_TYPE.GROUP 后递归 sh.shapes。别用 if sh.shapes: 试探——部分 shape 也有 .shapes 属性但语义不同。
坑 6 · 幂等性没验证就上批量
批处理必须验证"连跑两次结果一致"。我用 逐 XML 文件做 SHA256 摘要比对:C 档连跑两次,60 份文件摘要不一致数 = 0,幂等通过。如果做的是"文本替换类"任务(而非改属性),第二次跑可能把新文本误当旧文本再替换一遍,必须先做幂等校验。
六、给 WorkBuddy 的提示词模板
这套流程可以直接交给 WorkBuddy 执行,提示词如下(照抄可用):
任务:批量把
<目标目录>下所有.pptx的主色换成#0D3B5E、正文字体换成Microsoft YaHei。硬约束: 1. 文本遍历必须覆盖 5 类容器:顶层 shape、组合(递归)、表格单元格、备注页、版式 layout。先打印每类各有多少 run,确认总数与预期一致再动手。 2. 严禁使用
text_frame.text = ...回写,必须逐 run 原地改font.name/font.color.rgb。加粗、超链接、字号一律不动。 3. 改写前后分别统计 run 总数;若总数下降,立即停止并报告。 4. 改完必须跑三件事:① 覆盖率自查(目标色命中数 / 总 run 数,应 = 100%)② 次生损伤自查(加粗/超链/字号保全率,应 = 100%)③ 版式体检:用"估算需求高度 / 实有高度 > 1.00"判溢出,输出疑似溢出框清单(文件+页码+文本框名)。 5. 幂等校验:连跑两次,逐 XML 做 SHA256 摘要比对,不一致数必须为 0。交付:改写脚本 + 上述 4 项自查的真实输出数字 + 疑似溢出框清单(按文件聚合)。 禁止:不要改字体以外的任何版式属性;不要动母版。
提示词里最值钱的两条是第 2 条(禁止回写)和第 5 条(幂等校验)——前者防格式崩塌,后者防"越跑越乱"。
七、收尾
这套方法论可以抽象成一句话:
批处理的成败不在"改了什么",而在"漏了什么"和"顺带改坏了什么"。
- 漏了什么 → 靠全容器枚举 + 覆盖率自查兜住(A 档的 47.47% 就是这么暴露的)。
- 改坏了什么 → 靠次生损伤指标 + run 总数比对兜住(B 档的 93.4% 覆盖 / 0% 保全就是这么暴露的)。
- 越跑越乱 → 靠幂等校验兜住。
三个自检项加起来不到 30 行代码,却把一批"看起来成功了"的脚本,和一批"真的可以交付了"的脚本区分开了。
最终这次 60 份 PPT 全量套模板:覆盖率 100%、次生损伤 0%、版式溢出检出 219 处 / 召回 100%、幂等通过、耗时 4.39 秒。人工逐份改的话,994 页大约要 8 个工时——提速约 6500 倍,但真正的价值不是快,是"我知道它一份都没漏、也没改坏"。
本文语料为现场合成的 60 份 PPT(994 页 / 19,912 个文本 run),全部数据由脚本实测产出,不含任何真实业务文档。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号