分类信息平台的工程实现:审核流水线、风险分级与 LBS 检索容错
原创
分类信息平台的工程实现:审核流水线、风险分级与 LBS 检索容错
原创
newlati
发布于 2026-10-10 09:41:07
发布于 2026-10-10 09:41:07
先说结论
同城分类信息平台的工程量不在"列表 + 详情 + 搜索框",而在三件事:审核能不能做成一条可回溯的流水线(谁在什么时候、按哪一版规则、把一条信息放行或拦下);风险能不能在入库前分级,让人工复核只处理真正需要人看的那一小部分;LBS 检索能不能在"用户定位与真实地址不匹配"这个常态下保持结果可用。这三件事定不稳,上线后的日常就是违规信息漏放、人工审核被打爆、以及"搜出来全是十公里外的"这类体验投诉。这篇按审核流水线、状态与权限、检索实现、数据模型四段拆实现要点。
一、审核流水线:把"发布"拆成可回溯的阶段
把"点发布就上线"改成一条流水线,是同城信息平台和普通内容管理系统的分界。一条可用的流水线大致四个阶段:
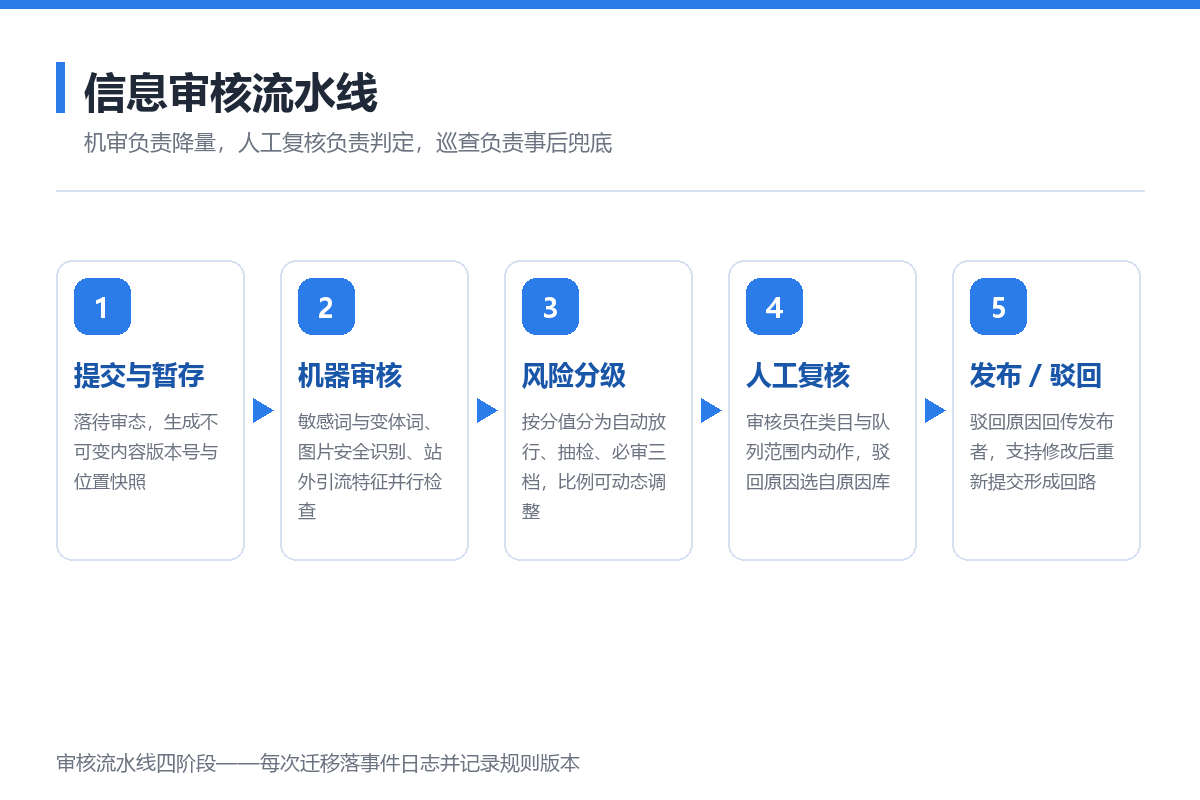
图 5:审核流水线的四个阶段——机审负责降量,人工复核负责判定,巡查负责事后兜底
- 提交与暂存:用户提交后先落"待审"态,生成不可变的内容版本号(含文本、图片对象键、发布类目、位置信息)。版本号是后续所有留痕的锚点——同一信息被多次修改,要能查到"哪一版被谁放行"。
- 机器审核:并行走三类检查——敏感词与变体词库匹配、图片安全识别(鉴黄鉴暴与违规字符)、风险特征识别(联系方式泄露、站外引流、类目错放、高频重复发布)。机审输出不是一个布尔值,而是"命中规则 + 分值 + 建议处置"。把机审做成只返回通过/不通过,后面就无法做分级。
- 风险分级与人工复核:按分值把信息分成"自动放行""抽检""必审"三档。抽检档是关键设计——全量人审撑不住量,全自动放行又一定出事,抽检比例要能按类目与用户信用动态调整(新账号、曾违规账号、涉房产招聘等高敏类目提高抽检率)。
- 发布后在架巡查:上线不等于结束。要有按类目、按时间窗、按被举报情况的批量巡检任务,处置动作(下架、限流、警告、封禁)全部落事件表,并与通知系统联动。
流水线里容易被忽略的一环是通知与申诉:驳回必须把原因回传给发布者,且要有补充修改后重新提交的入口。没有这条回路,审核成本会以客诉的形式再花一遍。
二、状态机与权限:审核动作要落在状态迁移上
信息实体建议用显式状态机而不是若干布尔字段:
待提交 → 待审 → 审核中(人工)→ 已发布 → 已下架 / 已驳回 / 已过期
关键约束:
- 迁移落事件日志:每次迁移记录触发方(用户 / 机审 / 人工 / 定时任务)、时间、规则版本、操作者身份。规则版本必须入日志——改规则后要能算出"旧规则下放行过多少条"。
- 人工操作要可用而不越权:审核员只能在自己的类目与队列范围内动作;批量操作要二次确认并留痕;驳回原因从可配置的原因库中选择,避免自由文本导致统计不可用。
- 在架状态与索引解耦:下架动作要同时从检索索引中移除,而不是只在详情页显示"已下架"——否则被下架的信息仍会被搜到。
- 过期机制:房源、招聘这类信息有时效性,要有到期自动下架策略,且策略可配置、不回溯影响历史。
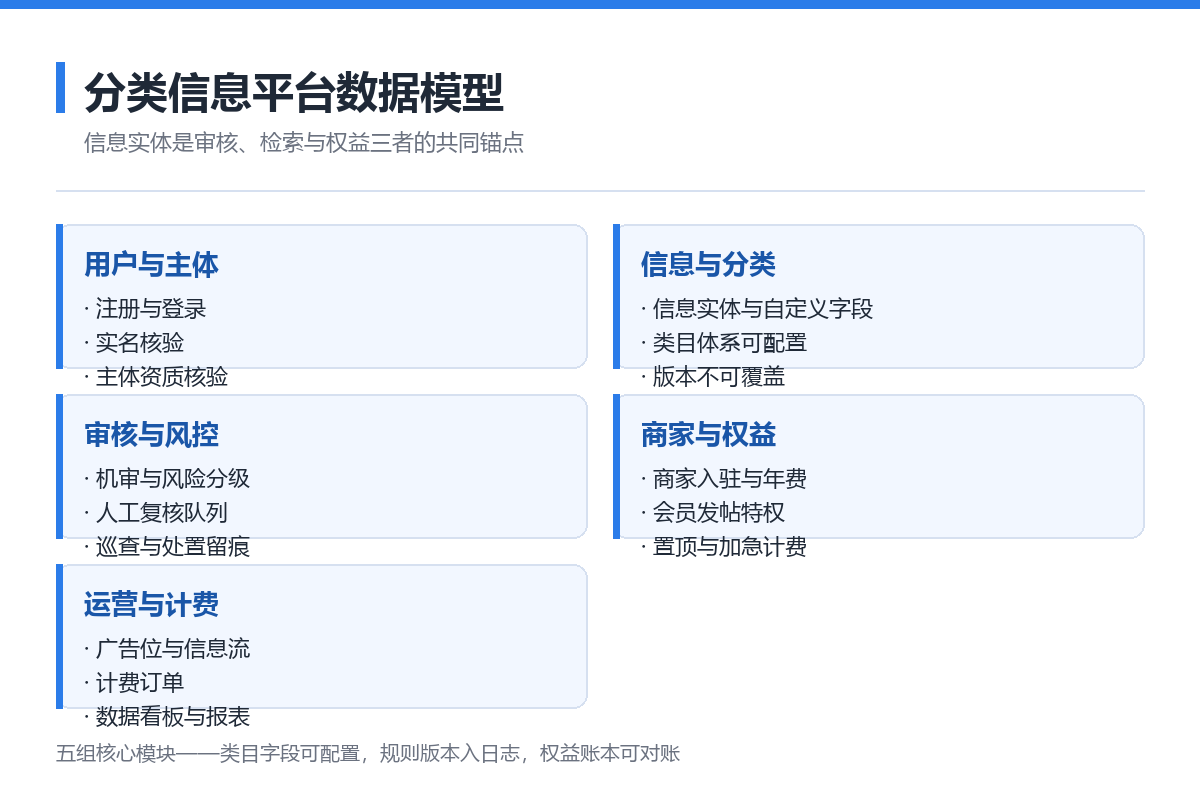
图 6:五组核心模块——信息实体是所有审核与检索动作的共同锚点
五组模块的职责与约束整理如下:
| 模块 | 核心职责 | 关键约束 |
|------|---------|---------|
| 用户与主体 | 注册、实名核验、主体资质 | 核验未通过不得发布受限类目 |
| 信息与分类 | 信息实体、自定义字段、版本 | 类目字段可配置,版本不可覆盖 |
| 审核与风控 | 机审、分级、人工队列、巡查 | 规则版本入日志,处置可回溯 |
| 商家与权益 | 入驻、年费、会员、置顶加急 | 权益账本可对账,到期自动失效 |
| 运营与计费 | 广告位、计费订单、报表 | 计费与权益变更事务一致 |
三、LBS 检索:容错比排序算法更重要
同城检索的体验问题,八成不是出在排序算法上,而是出在位置数据本身。工程上要接受三个现实:
- 定位不可信:中心点可能来自 GPS、基站、IP 或用户手选,精度差异很大。设计上应把"定位点""用户手填地址解析出的坐标""行政区域"三者分开存储,检索时以行政区域做硬过滤、以坐标做软排序,而不是直接信任单一坐标。
- 地址解析会失败:老城区、写字楼、园区是失败高发地。要有门牌号与楼栋的补充字段、以及"用户反馈位置纠偏"的写入通路,纠偏数据要能回灌到解析结果。
- 排序规则必须稳定可解释:时间、距离、置顶优先、综合分之间的权重一旦频繁调整,用户会立刻感知。建议把排序策略做成可版本化的配置,并在结果页给出"为什么这样排"的可见依据(距离、发布时间、是否推广)。
检索侧的实现要点是缓存与降级:热门类目与首页结果走缓存,地理索引按行政区域分片;当索引服务异常时,降级为按区域 + 时间的简单查询,而不是直接报错白屏。
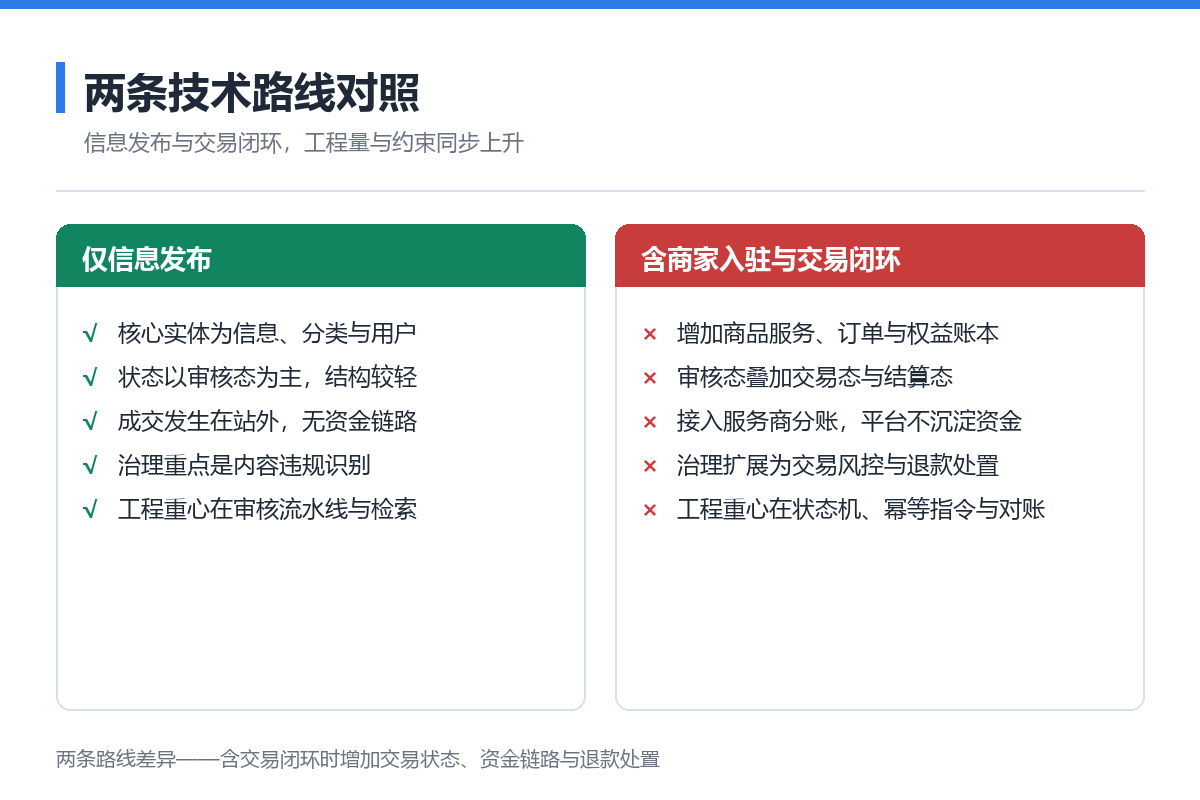
图 7:信息发布与交易闭环两条路线——后者增加交易状态与资金链路,工程量与约束同步上升
| 对比项 | 仅信息发布 | 含商家入驻与交易闭环 |
|--------|-----------|--------------------|
| 核心实体 | 信息 + 分类 + 用户 | 信息 + 商品/服务 + 订单 + 权益账本 |
| 状态复杂度 | 审核态为主 | 审核态 + 交易态 + 结算态 |
| 资金链路 | 无(站外成交) | 需接入服务商分账,平台不沉淀资金 |
| 治理重点 | 内容违规识别 | 内容违规 + 交易风控 + 退款处置 |
| 工程重心 | 审核流水线、检索 | 状态机、幂等指令、对账 |
四、内容安全能力怎么接
内容安全是外部能力 + 自建规则两层结构,不要试图只靠其中一层:
- 外部能力层:直接对接平台方或云厂商提供的内容安全接口,覆盖文本违规、图片鉴黄鉴暴、OCR 识别图中联系方式等通用能力。这一层解决"通用违规",接入成本低,但不了解你的行业黑话与本地变体写法。
- 自建规则层:维护类目相关词库、变体写法(拆字、谐音、符号间隔)、本地行业暗语、站外引流模式(微信号变体、二维码图片、电话图案)。这一层决定你能不能拦住"伪装成正常信息"的违规内容。
- 两层的协同方式:外部接口报错或超时时要有降级策略(进入人工队列而非默认放行);命中结果统一汇入一个风险事件表,供分级、统计与规则迭代使用。规则迭代要能在不重启服务的前提下生效。
小结
同城分类信息平台的工程质量取决于四套结构:审核流水线把"发布"拆成可回溯的阶段,用不可变版本号锚定所有留痕;风险分级让人工复核只处理真正需要人看的部分,用抽检比例动态平衡成本与风险;LBS 检索接受"定位不可信、解析会失败"的现实,用行政区域硬过滤 + 坐标软排序 + 纠偏回路维持结果可用;数据模型把信息实体做成审核、检索、权益三者的共同锚点。内容安全则采用"外部通用能力 + 自建类目规则"的双层结构,并保留降级与规则热更新通路。这四块在架构期定稳,后续新增类目、调整抽检比例、调整排序权重都是配置级变更;定不稳,每一次规则调整都会变成一次线上事故。附图三张按审核流水线、数据模型、两条技术路线对照分别给出结构参考。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号