元数据存储架构解析:AI时代全域可观测性基础设施
原创
元数据存储架构解析:AI时代全域可观测性基础设施
原创
慧贝行
发布于 2026-10-09 16:01:34
发布于 2026-10-09 16:01:34
一、一份报价差三倍的选型方案
今年三月,某地市大数据中心的信息科长老周把我拉去帮他看两份流量审计选型方案。两份参数表几乎重合:万兆线速、全流量采集、满足六个月留存,可报价差了将近三倍。老周指着便宜的那份问我,功能都写着一样,为什么差价这么大。
我让他把两台设备在现场各自跑满一天,再把落盘目录调出来。一份目录里是按小时切片的pcap文件,单个文件几个GB,翻开来是一整片二进制流;另一份目录里是分区的结构化数据表,一行一条会话记录,字段排得整整齐齐。参数表上它们确实一样,差别藏在数据落盘的那一瞬间。
功能表是产品的门面,落盘目录是产品的底子。这两样东西长得不一样,往后每一年的存储账单、每一次应急溯源的耗时都会跟着不一样。
元数据存储架构解析:AI时代全域可观测性基础设施
二、原生到底原生在哪:把信封上的字留在入口
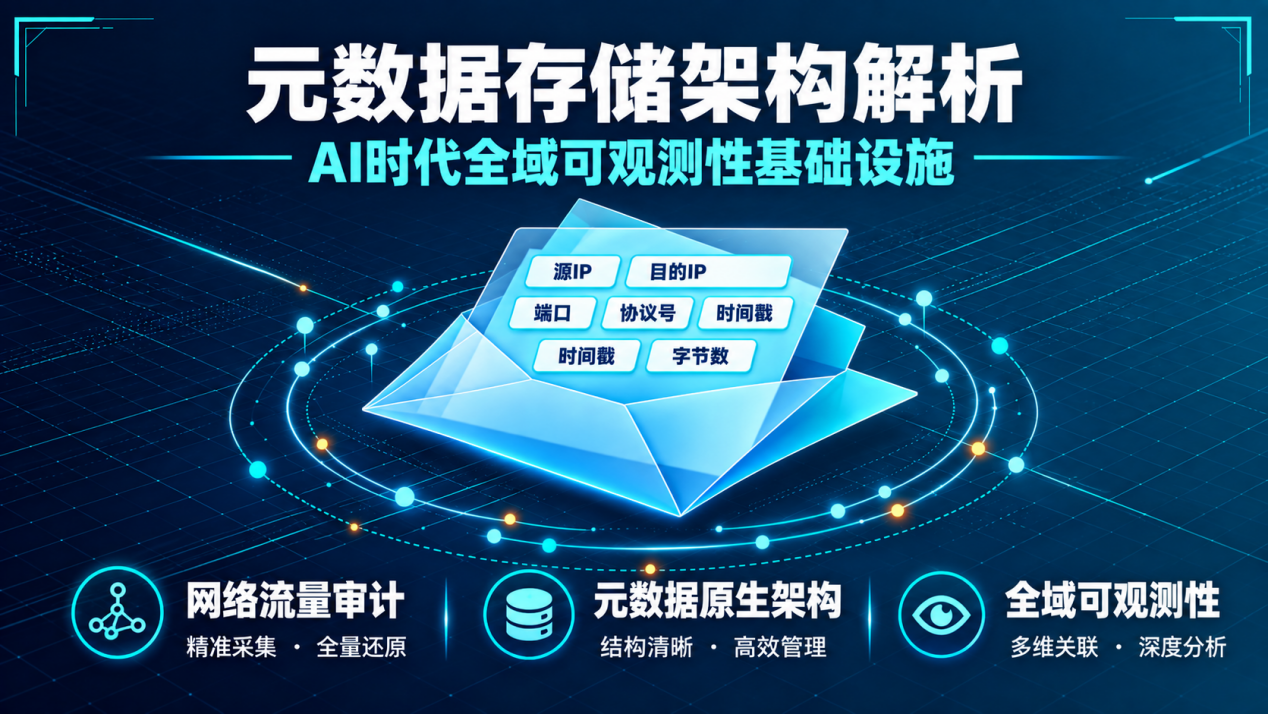
网络里的一次会话,可以比作一封信。原始数据抓包存的是整封信:信封连同里面的信纸一起塞进档案柜,要用的时候再拆开封皮;元数据存储存的是信封表面的那几行字:谁寄的、寄给谁、什么时候寄出、多厚、走的哪条邮路。信纸里的内容当然更完整,可日常审计要回答的问题,绝大多数落在信封上。
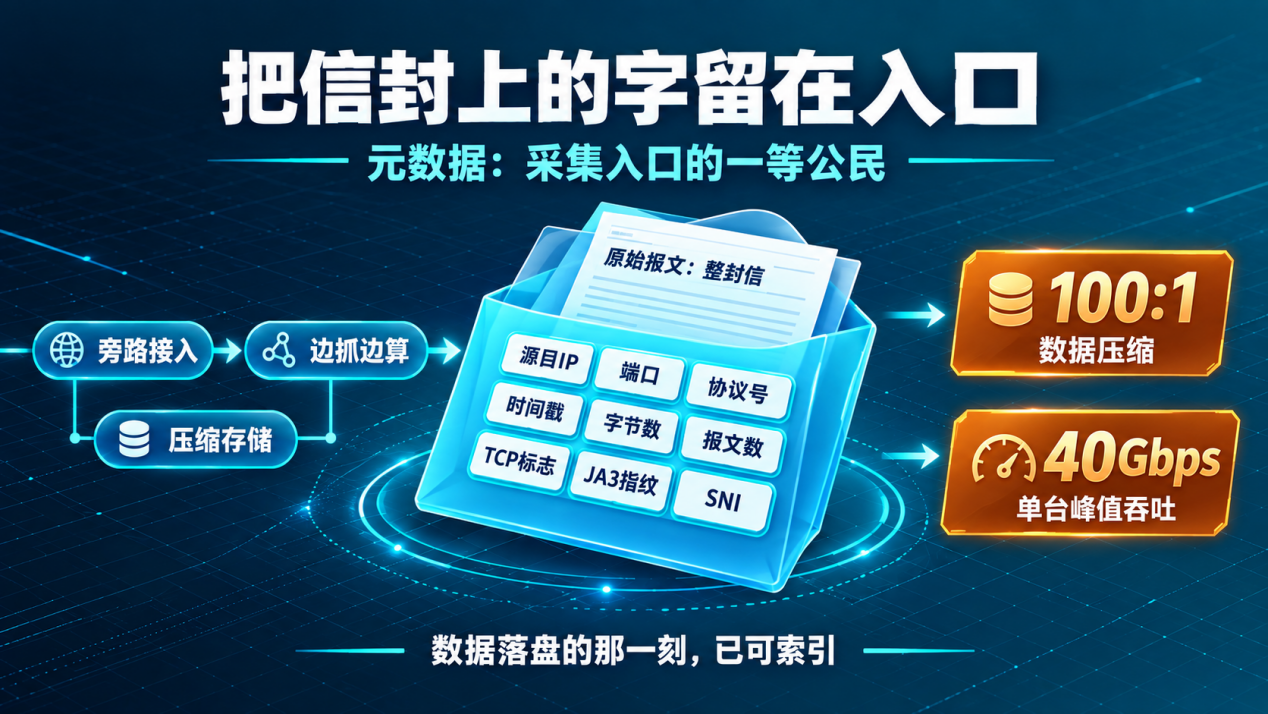
信封上的字在网络里是可枚举的。二到七层走一遍,一条会话能留下这些字段:源目IP与源目端口、协议号、开始与结束时间戳、会话持续时长、上下行字节数与报文数、TCP标志位与重传次数;再往上,DNS的查询名与应答类型、HTTP的方法、状态码、Host与User-Agent;走TLS的会话补上 ClientHello里的JA3指纹、SNI字段与证书哈希。几十个字段,落到磁盘上就是一行记录。
元数据存储架构解析:AI时代全域可观测性基础设施
行业多数现有方案也提取元数据,但它们的时序是先落原始报文、需要的时候再从报文里解析出元数据。两种做法的分野不在有没有元数据,在元数据出现的位置:一种把元数据当成事后的二次加工品,一种把它当成采集入口的一等公民。慧贝行的采集器在出口节点旁路接入,数据总线层用无锁设计、硬件自动负载均衡与采集分析器的流水线结构,一次内存访问的时间(约66纳秒)里处理完一个报文,提取出的结构化结果直接进入压缩存储。先存后算变成边抓边算,数据落到磁盘的那一刻就已经是可索引的形态。
压缩比是这个架构带来的物理红利。100:1的数据压缩,数据聚合后再压缩10倍,每秒十万条记录入库。换算到实际场景就是:10Gbps的链路上,满足《网络安全法》六个月留存要求,所需磁盘不超过20T。
加密流量另有一层讲究。行业内相当一部分设备在HTTPS面前只能看到握手,慧贝行的TLS加密流量解析把这一层往前推了一步:可解密的会话在解密后同样按二到七层字段做提取,不能解密的会话也留下握手层元数据:JA3指纹、SNI、证书哈希这几项组合起来,足以做客户端指纹比对。V2Ray、VLESS、Trojan、Reality这类把隧道建在TLS里的工具,正是靠这些字段从流量里被认出来的。
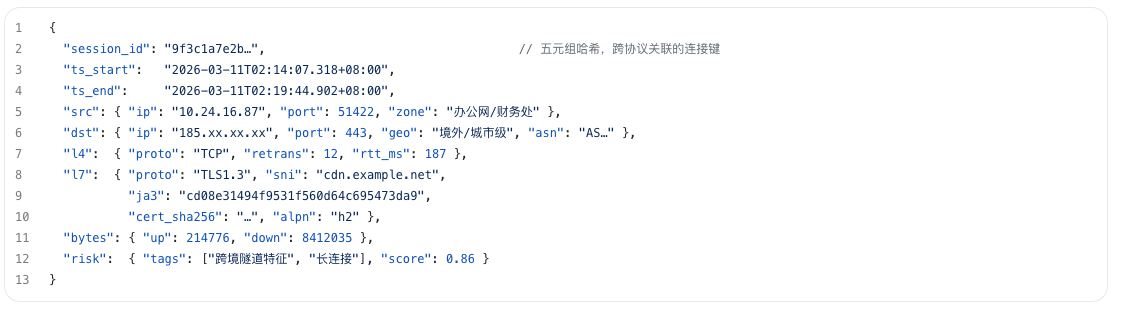
元数据还比报文更擅长跨协议关联。一次完整的入侵通常由DNS解析、TCP建连、HTTP请求三段拼成,报文路线得把三段pcap按时间轴人工对齐;元数据每条记录都带五元组和时间戳,用会话标识当连接键,三段自然串成一条时间线。
会话元数据的字段模型,落到实现层大概长这样:
元数据存储架构解析:AI时代全域可观测性基础设施
检索这一类数据走的是字段索引,不是文件扫描:
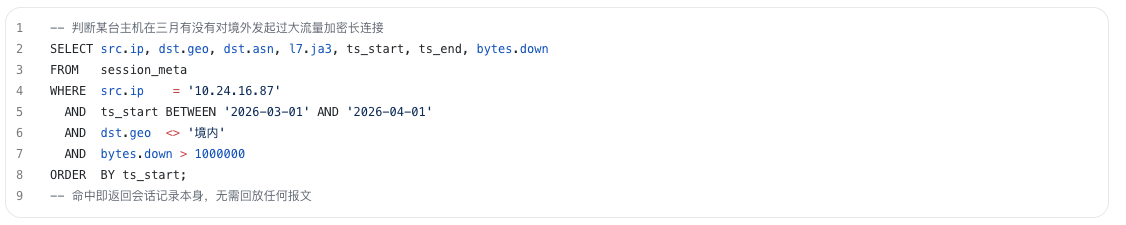
元数据存储架构解析:AI时代全域可观测性基础设施
AI就绪度跟着这个架构一起定下来了。深度学习模型吃的是结构化数据,元数据字段可以直接进特征表;原始报文得先做协议解析、特征工程、格式转换,才轮到喂模型。元数据是AI的原生语言这句判断的技术落点就在这里,不是修辞,是数据格式本身划出的能力边界。回到开头那个比喻:信封上的字之所以比信纸好用,不在于字数少,而在于它规整——规整到能建索引、能进模型,能在半年之后按任意条件被重新捞出来。
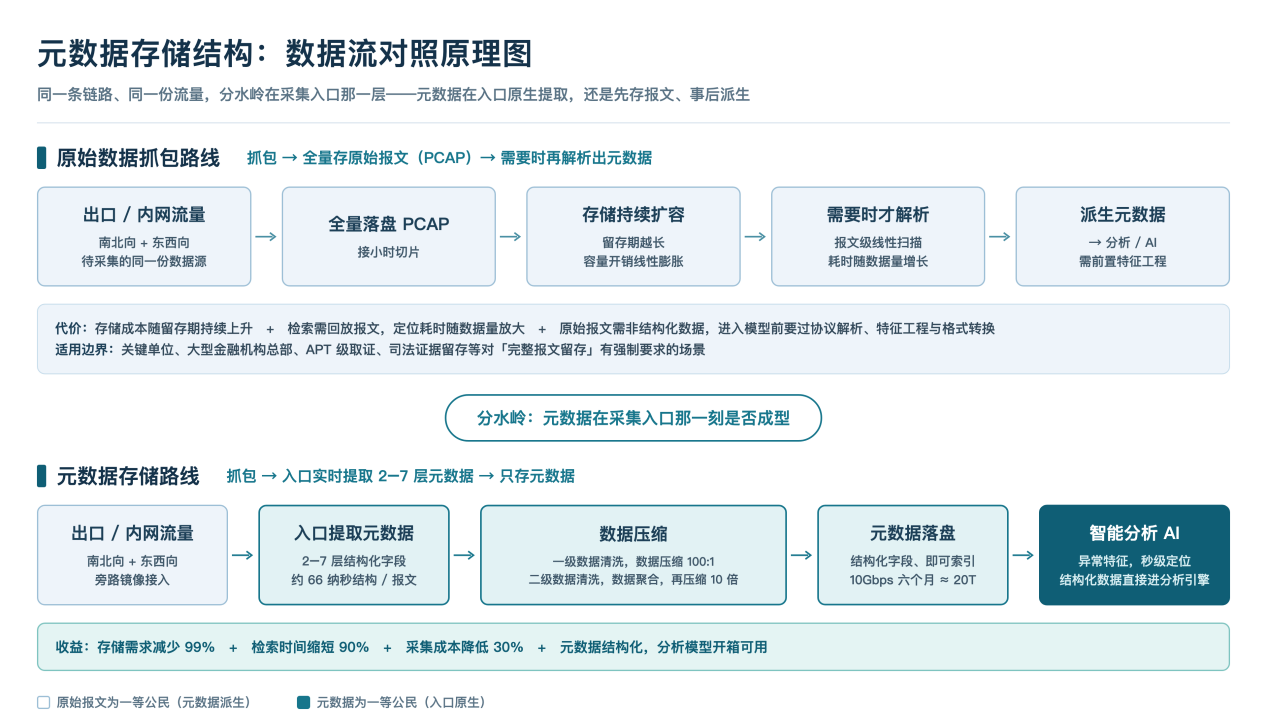
元数据数据流对照原理图
三、三组数字与它们的测试背景
架构差异终究要落到可核对的数字上。下面三组是本篇讨论所依据的内容,每组都标注测试背景。
1、存储需求减少99%。 测试背景:同一出口、同一条10Gbps链路、同一自然日的全量会话,两条路线各自落盘对比:原始报文以TB计量,元数据经100:1压缩以及二次数据聚合后压缩10倍后落到GB量级。折算到六个月留存窗口,10Gbps链路所需磁盘不超过20T。
2、检索时间缩短90%。 测试背景:在同一个六个月留存窗口内,按源IP+时间片+协议三个条件检索同一条历史会话。原始报文路线要在成片的二进制文件里做线性扫描,耗时随数据量增长;元数据路线走字段索引,直接命中。90%是这一组检索条件下的时间差,条件收得越窄,索引带来的收益越明显。
3、采购成本降低30%。 测试背景:同一招标参数集、同等审计功能配置下的报价对比,取保守区间。价格差来自成本结构:不存原始报文就没有前置分流器的采购项,存储三年之内不用扩容,日常运维一个人就可以轻松处理。
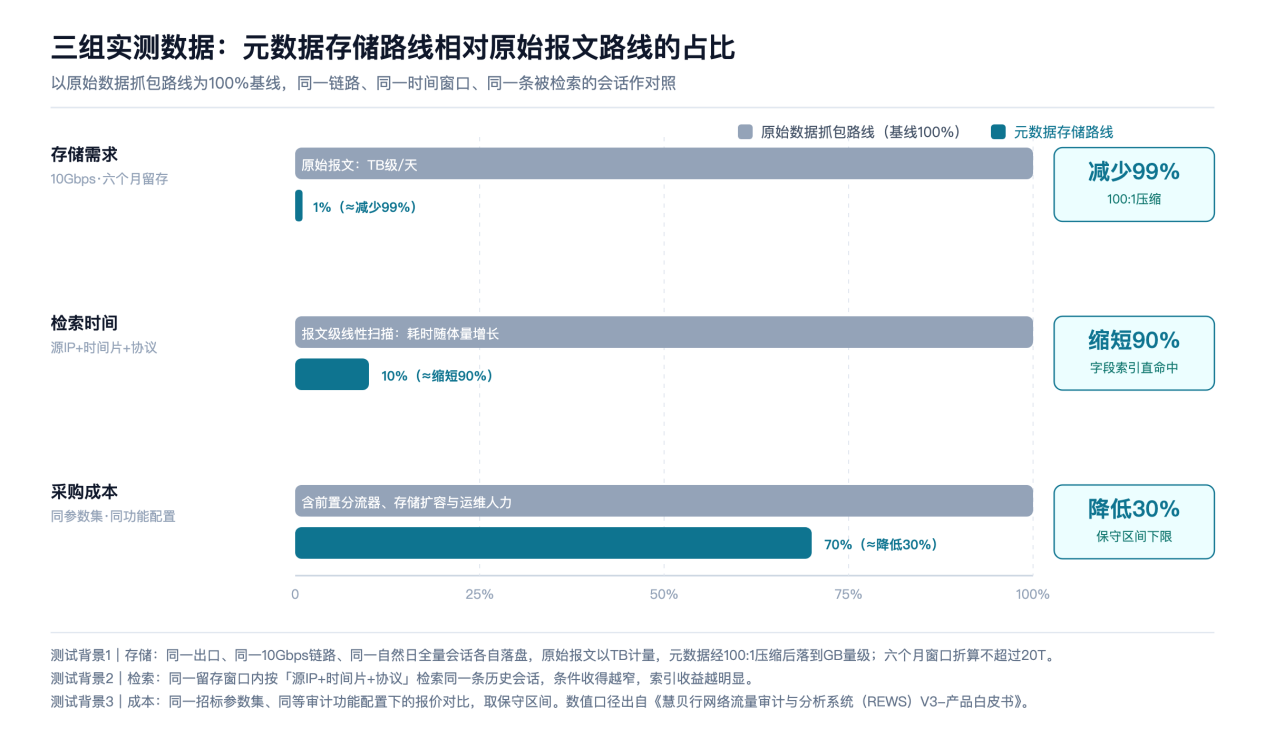
配图-元数据抓包三组实测数据图
三组数字分开看是三个指标,合起来读是同一件事:数据在采集入口被结构化的那一刻,后面每一步都需要重新计算。
四、原始报文路线在哪些场景是刚需
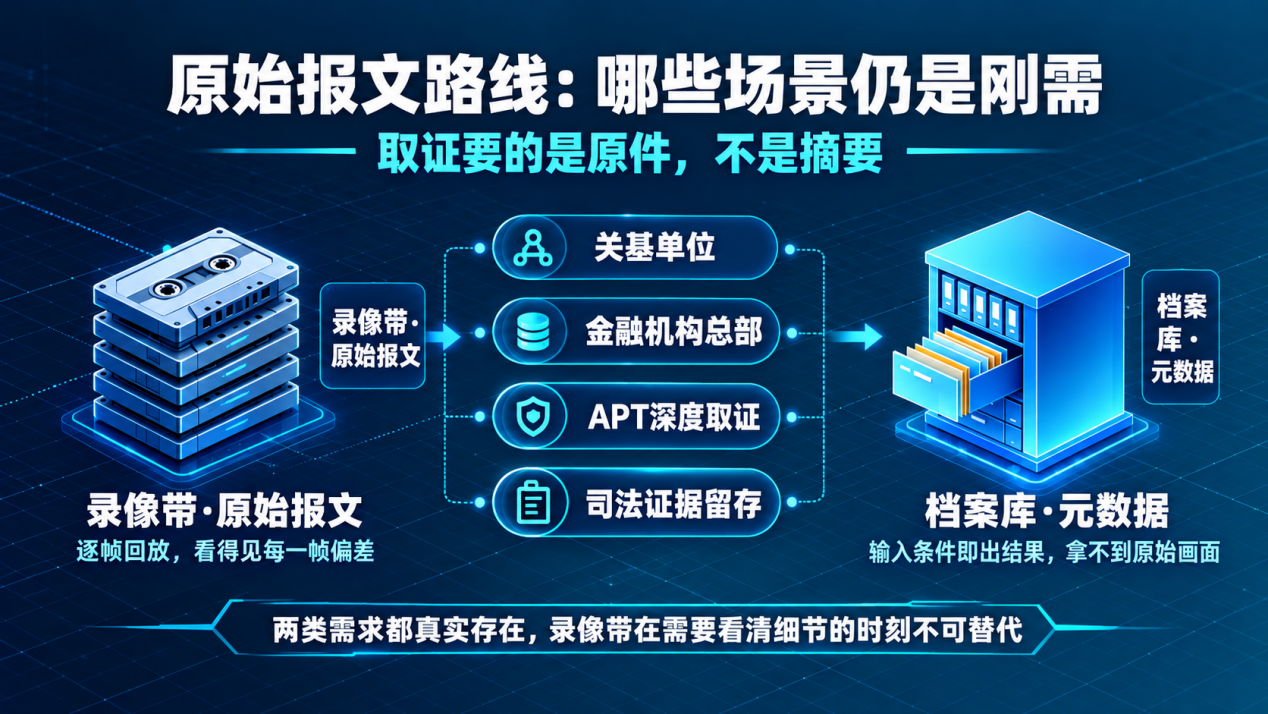
说到这里,边界必须讲清楚。原始报文路线不是被淘汰的技术,它在几类场景里仍然是刚需:关基单位、大型金融机构总部、APT深度取证,以及需要留存司法证据的案件。这几类场景的共同点是预算充足、有专业团队、对完整报文留存有明确的合规或取证要求。取证要的是原件,不是摘要。
换成前面录像带的说法:存原始报文像存了一屋子录像带,逐帧回放,连某一帧的画面偏差都看得见;存元数据像建了一座带索引的档案库,输入条件就出结果,但拿不到那一帧的原始画面。 这两类需求都真实存在,录像带在需要看清细节的时刻不可替代。
真正的问题出在客户结构上。市面大部分企业的出口带宽和存储预算,撑不起原始报文连续落盘六个月。高校、医院、地市政务、中等规模政企的诉求集中在两件事:满足等保与《网络安全法》的留存要求,出了事之后能快速定位到人。在这块战场上,元数据原生的效率差是架构性的:原始报文路线靠加硬盘、加设备补不上,瓶颈不在硬件规格,在数据形态。
元数据存储架构解析:AI时代全域可观测性基础设施
五、技术背书:方法有没有被固化,是否经过第三方验证
一套数据架构能不能落成稳定产品,看两件事:方法有没有被专利固化下来,结果有没有被第三方机构验过一遍。
网络流量分析赛道正在经历一次架构层面的分化:一边是继续加固原始报文存储,一边是把元数据当成采集入口的一等公民。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号