#WorkBuddy# 240 篇 Markdown 排版体检:8 类硬伤 0.085 秒扫完,精确率从 20.2% 到 100%
原创
#WorkBuddy# 240 篇 Markdown 排版体检:8 类硬伤 0.085 秒扫完,精确率从 20.2% 到 100%
原创
用户12784192
发布于 2026-10-07 10:41:00
发布于 2026-10-07 10:41:00
作者所处行业与岗位:信息技术服务业 · 数据与效率工具工程师 本文全部数据由脚本合成并带标准答案(240 篇 Markdown、固定随机种子 20261007),不含任何真实业务数据,任何人重跑可复现同样数字。
一、文档越多,"排版债"越还不清
团队里的长文档几乎都是 Markdown:设计文档、操作手册、周报汇总。写的人多了,毛病就齐了——中英文之间有的有空格有的没有、半角逗号混在中文里、标题从二级直接跳到五级、代码块忘了声明语言、表格忘了写表头分隔行、从 PDF 复制来的段落每行都硬断行。
这些毛病不影响"能看",但影响机器处理:批量转 PDF 时硬断行变成孤字行,代码块没声明语言渲染出来就是一坨黑字,表格缺表头在静态站点里直接散架。
我这次的实验对象是用脚本造出来的 240 篇 Markdown 长文档,共 21,579 行。造的时候故意埋了 1,186 处八类排版硬伤,并且每一处都记了行号——相当于自带标准答案,谁检测得准,跑一遍就知道。
二、根因:不是正则写错了,是正则"越权"了
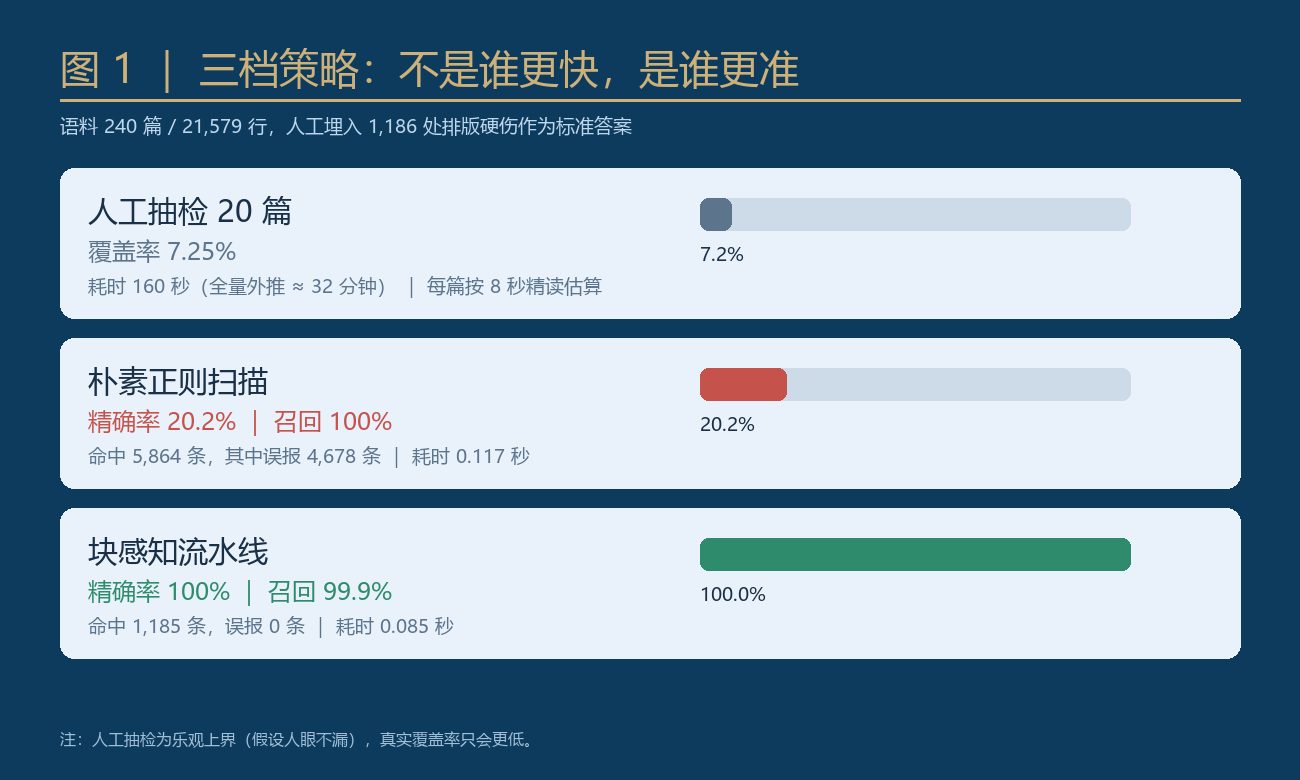
第一版我很自然地写了 8 条正则,逐行匹配、全文一把梭。结果命中 5,864 条,人工核完发现 4,678 条是冤案,精确率只有 20.2%。
问题出在同一处:正则只看行,不知道行在哪一块里。
- 代码块里的
# 一级注释被当成了标题,把层级跟踪彻底带偏; - 代码块的闭合围栏(连续三个反引号那行)被当成"未声明语言的代码块";
- 表格的每一个数据行,都被当成"缺表头分隔行"——一条规则就贡献了 1,798 条误报;
- 代码里的短行凑成三行,被当成"硬断行段落";
- Front Matter 里的
tags: [Markdown,Python]也逃不过中英文空格检查。
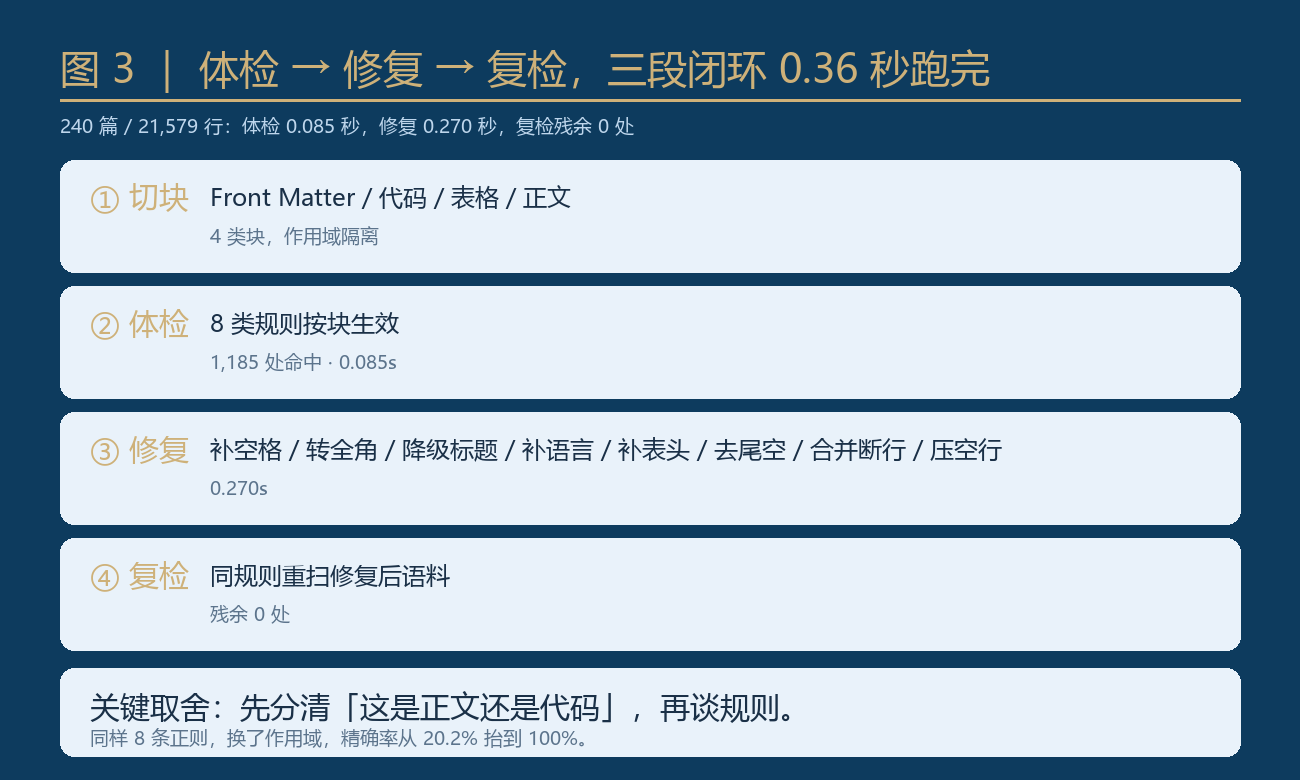
根因一句话:Markdown 是块结构语言,规则必须有作用域。 先把文档切成 Front Matter、代码块、表格、正文四类块,再让每条规则只在自己该管的块里生效——同样这 8 条正则,误报从 4,678 直接归零。
三、真实对比:三档策略跑同一份语料
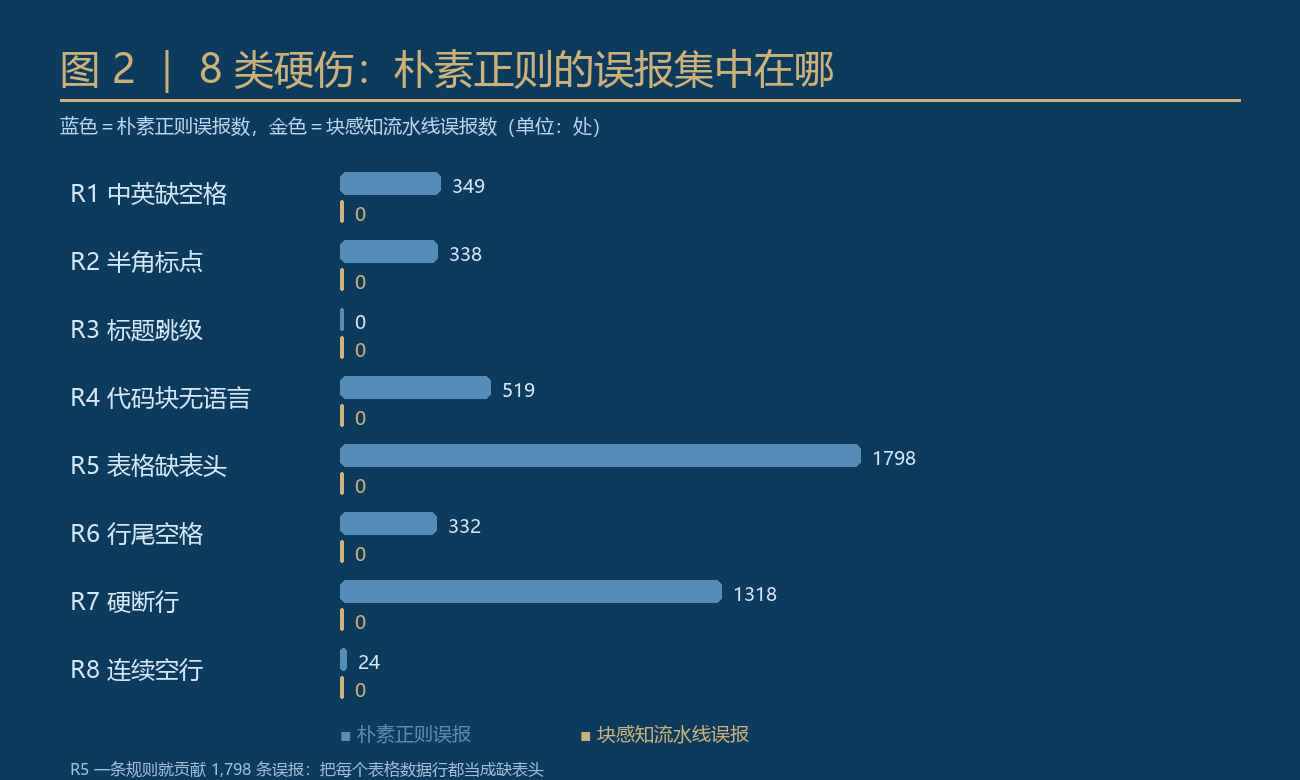
语料:240 篇 / 21,579 行 / 埋入缺陷 1,186 处(R1 中英缺空格 152、R2 半角标点 154、R3 标题跳级 146、R4 代码块无语言 138、R5 表格缺表头 119、R6 行尾空格 160、R7 硬断行 158、R8 连续空行 159)
策略 | 命中 | 真阳性 | 误报 | 精确率 | 召回率 | 耗时 |
|---|---|---|---|---|---|---|
人工抽检 20 篇 | 86 | 86 | 0 | 100% | — | 160 秒,全量外推约 32 分钟 |
朴素正则(全文一把梭) | 5,864 | 1,186 | 4,678 | 20.2% | 100% | 0.117 秒 |
块感知流水线 | 1,185 | 1,185 | 0 | 100% | 99.9% | 0.085 秒 |
人工那行是乐观上界:假设人眼精读不漏、每篇 8 秒,抽 20 篇也只能覆盖 7.25% 的问题,全量读完要 32 分钟——而流水线 0.085 秒扫完,吞吐约 25 万行/秒。
更重要的是省下的复核成本:朴素正则每报 100 条有 80 条是错的,逐条核完 5,864 条的时间远超写脚本本身;块感知流水线报 1,185 条对 1,185 条,可以直接进自动修复。
四、可复制的核心代码
切块的逻辑不复杂,状态机扫一遍:进围栏就是代码块,连续竖线开头就是表格,其余归正文。
import re

FENCE = re.compile(r"^\s*(`{3}|~{3})")   # 围栏行,避免在文内直接写三连反引号
SEP = re.compile(r"^\|[\s:\-|]+\|$")

def parse_blocks(lines):
    """把文档切成 (类型, 起, 止):fm / code / table / prose"""
    blocks, i, n = [], 0, len(lines)
    if n and lines[0].strip() == "---":                 # Front Matter
        j = lines.index("---", 1) if "---" in lines[1:] else n - 1
        blocks.append(("fm", 0, j + 1)); i = j + 1
    while i < n:
        if FENCE.match(lines[i]):                       # 代码块
            j = i + 1
            while j < n and not FENCE.match(lines[j]):
                j += 1
            blocks.append(("code", i, j + 1)); i = j + 1
        elif lines[i].lstrip().startswith("|"):         # 表格
            j = i
            while j < n and lines[j].lstrip().startswith("|"):
                j += 1
            blocks.append(("table", i, j)); i = j
        else:                                           # 正文
            j = i
            while j < n and not (FENCE.match(lines[j]) or lines[j].lstrip().startswith("|")):
                j += 1
            blocks.append(("prose", i, j)); i = j
    return blocks

def check(lines):
    """规则只在自己的作用域里生效"""
    out = []
    for kind, s, e in parse_blocks(lines):
        if kind == "code":                              # 只查"围栏有没有语言"
            head = lines[s].strip()[:3]
            if head == chr(96) * 3 or head == "~~~":
                out.append(("R4", s))
        elif kind == "table":                           # 只查表头分隔行
            if e - s < 2 or not SEP.match(lines[s + 1].strip()):
                out.append(("R5", s))
        elif kind == "prose":                           # 中英空格/半角标点/行尾空格只查正文
            for k in range(s, e):
                if re.search(r"[\u4e00-\u9fff][A-Za-z0-9]|[A-Za-z0-9][\u4e00-\u9fff]", lines[k]):
                    out.append(("R1", k))
                if re.search(r"[\u4e00-\u9fff][,;:!?]", lines[k]):
                    out.append(("R2", k))
    return out
五、三个真实的坑
坑一:标题层级要"跨块"跟踪。 我最初把层级状态放在每个正文块里,块一开始就归零,结果"代码块后面的二级标题"全被误判成跳级,一条规则冤枉了 700 多处。层级必须从文档开头一路带到结尾。 坑二:注入/修复会移动行号。 做自动修复时先删行、再插行,后面所有行号全部漂移,复检结果完全对不上。解法是结构性修改(删行、拆行、插空行)按位置从大到小执行,每执行一处就把已记录的行号校准一遍。 坑三:合并硬断行不能无脑 join。 中文行直接拼没问题,但断点若落在中英文交界("…耗时约 111" + "ms。"),直接拼就变成
111ms,修完又制造一条新缺陷。拼接前判断交界字符:中文接英文补一个空格,否则直接拼。
六、给 WorkBuddy 的提示词模板
体检和修复是两件事,分开下指令效果更稳。模板如下:
请对我目录 ./docs 下所有 .md 做排版体检,先不要改文件:把每篇切成 Front Matter / 代码块 / 表格 / 正文四类块;规则按作用域生效——中英文空格、半角标点、行尾空格只查正文和表格;标题跳级要跨块跟踪层级;代码块只查围栏是否声明语言;表格只查有没有表头分隔行;硬断行判据为"连续 3 行以上且平均行长小于 60 字符的正文段落"。输出 CSV:文件、行号、规则、原文。确认清单没问题后,再按同一份清单执行修复,修复后必须用同一套规则复检并给出残余数。
七、收尾
这套东西的价值不在 0.085 秒,而在两件事:规则有了作用域,报告才敢直接信;体检和修复用同一套规则,修完复检残余为 0 才算闭环。把"切块 + 按块生效"这个动作抽出来,8 条正则的精确率从 20.2% 到 100%,代码没多几行。
语料与标准答案由脚本合成,随机种子 20261007 固定;真实文档上的误报率会高于本次实验,但"先分块、再谈规则"这个结论不受语料影响。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号