向量数据库选型、向量化与检索调优,结合大模型搭建私有文档检索增强完整应用实践23.6
原创
向量数据库选型、向量化与检索调优,结合大模型搭建私有文档检索增强完整应用实践23.6
原创
未闻花名
发布于 2026-09-25 09:30:09
发布于 2026-09-25 09:30:09
一、前言
很多朋友接触大模型之后都会遇到一个非常现实的痛点:通用大模型知识存在时间截断,不懂企业内部文档、业务资料、私有知识库,直接提问很容易出现幻觉,编造不存在的答案。微调可以让模型学习私有知识,但微调成本高、数据更新麻烦、版本迭代繁琐,小样本场景效果并不理想。
这个时候RAG检索增强生成技术就走进了大家的视野。简单来说RAG就是检索 + 生成,不改动大模型本身权重,先从私有文档库里检索相关片段,把检索到的上下文塞进Prompt,交给大模型做总结回答。而整个RAG链路里面,向量数据库就是整套系统的底座,文档切分、向量化存储、相似度检索、召回过滤,几乎全部依赖向量数据库完成。
通常很容易把RAG简单理解成 “文档转向量存进去,查的时候搜一下”,真正上手做项目才发现,召回效果差、答案跑偏、噪声太多、上下文溢出、检索速shen度慢等一堆问题。看似简单的链路,每一个环节都有大量工程细节。实际在构建RAG应用之前,必须先搞懂RAG底层逻辑,理解向量数据库在里面承担的角色,具备独立设计向量化检索解决方案的能力,能够识别项目中常见坑点,才能更好的上手搭建属于自己的RAG原型系统。
二、RAG 基础认知
1. RAG基础概念
RAG全称Retrieval‑Augmented Generation,检索增强生成。它的核心思想,是外部知识库检索补充上下文,大模型负责理解与生成。
传统大模型的知识全部固化在模型参数权重之中,训练结束之后知识就固定下来。想要新增知识,要么重新训练微调,要么直接把知识写在prompt里面。prompt直接塞全部文档,会出现token超限,大量无关内容干扰模型输出。
RAG 把整个流程拆分成两大块:检索模块、生成模块。
- 检索模块:用户提问,把问题转为向量,去外部知识库检索和问题语义最匹配的文档片段;
- 生成模块:把用户原始问题 + 检索回来的文档片段组装成提示词,送入大模型,让模型基于检索到的真实资料输出答案。
RAG 最大优势非常突出:
- 不需要修改大模型权重,知识库更新只需要更新向量库,不用重新训练模型;
- 极大缓解大模型幻觉,答案有原始文档作为来源依据,可以做溯源引用;
- 适配私有业务数据、本地文档、实时资讯,成本远低于微调。
但 RAG 并不是万能银弹。整套系统的上限由检索质量决定。检索拿不到正确文档,再好的大模型也无法输出正确答案。很多人RAG项目效果差,问题不出在大模型,而是检索链路,尤其是向量数据库、切片策略、向量模型选择。
RAG分为简单Naive‑RAG朴素检索增强,以及高级的Advanced‑RAG,包含查询重写、重排序、自我校验、多轮检索等能力。绝大多数业务场景,都是从朴素RAG 起步,再迭代高级能力。
2. RAG完整基础链路
一套朴素RAG 分为两大阶段:索引构建阶段、推理查询阶段。
索引构建阶段:离线,只做一次,知识库更新时执行

- 1. 原始文档加载:PDF、markdown、word、网页文本等各类数据源读取;
- 2. 文档切片切分:长文档拆分成合适大小文本块chunk;
- 3. 文本向量化:调用Embedding嵌入模型,把每一段文本转为高维向量;
- 4. 向量入库:向量数据库存储文本向量,同时保存原始文本、元数据。
推理查询阶段:线上用户提问实时执行

- 1. 用户输入问题;
- 2. 问题向量化:把用户提问转为向量;
- 3. 向量检索:向量数据库执行相似度搜索,召回top‑N相似文本片段;
- 4. 过滤重排:对召回结果过滤、重排序,剔除噪声;
- 5. Prompt 组装:把检索片段和用户问题拼接;
- 6. LLM 生成:大模型接收prompt输出回答。
这里很容易只关注大模型,忽略前面5步。检索链路任何一步出问题,最终回答质量直接崩盘。向量数据库承担存储向量、高效相似度检索的核心任务,是整个RAG系统的存储引擎。
3. RAG与微调的区别
为了不会混淆 RAG 和微调,不清楚业务场景该选哪一个,这里先做一个清晰区分。
RAG 适用场景:
- 知识频繁更新,文档会新增、修改、删除;
- 需要答案溯源,需要展示回答来自哪一份原始文档;
- 私有知识库问答,文档体量较大;
- 不想投入大量算力做模型训练。
微调适用场景:
- 想要改变模型输出风格、输出格式,对齐业务话术;
- 少量样本,需要学习特定输出范式;
- 知识固定,几乎不会频繁变动。
工程落地中大量项目采用 RAG + 微调组合方案:RAG 负责提供真实外部知识,微调负责规范模型输出格式。
4. RAG基础流程示例
"""
RAG基础流程伪代码,理解完整链路逻辑
"""
# ========== 离线构建索引 ==========
documents = load_documents("./docs/")          # 加载文档
chunks = split_documents(documents, chunk_size=512) # 文档切片
embeddings = embedding_model.encode(chunks)    # 文本向量化
vector_db.insert(embeddings, chunks)          # 写入向量数据库

# ========== 线上问答推理 ==========
user_query = "RAG技术的核心优势是什么?"
query_vec = embedding_model.encode(user_query) # 问题向量化
retrieved_docs = vector_db.search(query_vec, top_k=3) # 向量检索召回
prompt = build_prompt(user_query, retrieved_docs)     # 组装提示词
answer = llm.chat(prompt)                     # 大模型生成答案
print(answer)
三、向量数据库核心原理
1. 向量数据库的价值
普通数据库 MySQL、PostgreSQL 擅长精确匹配、关键词检索,处理文本语义搜索能力很差。关键词匹配只能匹配字面相同词汇,无法理解语义。
举个例子:文档里写 “检索增强可以降低大模型幻觉现象”,用户提问 “怎么减少大模型胡说八道”。字面词汇几乎没有重合,关键词检索会直接漏召回。但是两段文本语义高度接近,Embedding 模型可以把语义相近文本映射到空间距离很近的向量。
向量就是一组浮点数数组,Embedding 模型把自然语言映射到高维向量空间,语义越接近,向量空间距离越近。我们想要实现语义检索,本质就是找距离用户问题向量最近的一批文档向量。如果使用普通数据库,每一次查询,都需要把库里面全部向量拿出来暴力计算距离。向量数量几十万、上百万的时候,暴力遍历速度完全无法满足线上业务。
向量数据库就是专门为高维向量设计的数据库:
- 支持向量高效存储;
- 提供向量索引算法,实现近似最近邻搜索 ANN;
- 支持向量相似度查询,元数据过滤,增删改查;
- 针对海量向量做查询加速,牺牲极小精度换取查询速度。
向量数据库≠普通数据库加向量字段。普通数据库可以扩展向量能力,但面向百万、千万级别向量场景,性能、索引优化能力远不如专业向量数据库。
2. 向量核心概念
- Embedding 向量:文本经过嵌入模型输出的浮点数组,常见维度512、768、1024维。相同语义文本,向量空间距离更小。
- 距离度量方式:用来判断两个向量相似度。
- 余弦相似度:最常用,适合文本 Embedding,衡量向量夹角,不受向量长度影响;
- L2欧氏距离:计算向量空间直线距离;
- 内积距离,多用于归一化后的向量。 RAG 项目绝大多数场景优先选择余弦相似度。
- ANN 近似最近邻算法:
- 暴力搜索KNN是精确计算全部向量距离,结果100准确,海量数据速度极慢。
- ANN 近似最近邻,通过构建特殊索引结构,跳过大部分向量,只计算部分候选向量,用少量召回精度损失,换取百倍千倍查询速度。
- 主流索引类型:HNSW、IVF_FLAT、IVF_SQ8等。HNSW 综合性能优秀,RAG项目使用最多。
- 元数据:向量数据库除了存储向量、原始文本,还可以存储元数据,文档来源、时间、文档类型、文档 ID。线上检索的时候,可以结合元数据做过滤,例如只检索某一份文档、某一个时间范围的资料。
3. 主流向量数据库选型
目前开源向量数据库有很多,不同数据库在部署难度、性能、资源消耗、生态各有差异。
- Chroma:轻量级,本地内存文件存储,无需额外部署服务,适合原型验证、demo 开发,不适合大规模线上生产;
- FAISS:Meta 开源向量检索库,只有检索能力,不是完整数据库,没有持久化、元数据管理,需要自己封装上层逻辑;
- Milvus:开源生产级向量数据库,功能完整,支持海量向量,丰富索引,支持元数据过滤,RAG 生产落地高频选择;
- Qdrant:开源向量库,性能优秀,API 友好,资源占用可控,文档完善;
- PGVector:PostgreSQL 扩展插件,如果你业务已经重度依赖 PostgreSQL,可以直接复用现有数据库,向量规模千万以内可以考虑。
选型参考建议:
- 原型调试、本地 demo:Chroma;
- 生产环境,百万及以上向量,需要稳定服务:Milvus/Qdrant;
- 不想新增数据库组件,已有PG库:PGVector。
4. Chroma 简易向量库示例
"""
安装依赖:pip install chroma sentence-transformers
简易向量数据库demo,直观理解向量入库和检索
"""
import chroma
from chroma import Client
from sentence_transformers import SentenceTransformer

# 加载开源embedding模型
embedding_model = SentenceTransformer("all‑mps‑base‑v2")

# 初始化本地向量库
client = Client()
collection = client.create_collection(name="rag_demo")

# 原始文档片段
text_list = [
    "RAG检索增强生成,不修改大模型权重,借助外部文档补充知识",
    "向量数据库用来存储文本向量,实现语义相似度检索",
    "大模型幻觉指模型输出看起来合理,但不符合事实的编造内容"
]
# 生成向量
vecs = embedding_model.encode(text_list).tolist()

# 写入向量库
collection.add(
    embeddings=vecs,
    documents=text_list,
    ids=["doc_1","doc_2","doc_3"]
)

# 用户提问,向量化检索
query = "什么手段可以缓解大模型产生虚假内容?"
query_vec = embedding_model.encode(query).tolist()

res = collection.query(
    query_embeddings=[query_vec],
    n_results=2
)
print("检索召回结果:", res["documents"])
四、RAG核心重点
1. 文档切片策略
通常如果做RAG效果差,第一个问题就是文档切片。chunk大小不是固定万能值,切片直接影响向量质量、召回效果。
- 如果chunk设置过大:单个片段包含大量无关信息,向量语义混杂,检索的时候容易带入噪声,同时后续送入大模型会占用大量token。
- 如果chunk设置过小:语义被强行切断,一个完整语义被拆分多个chunk,单条向量信息不足,语义碎片化,检索很难召回完整上下文。
常见切片方式:
- 1. 固定长度切片:最简单,按字符数切割。缺点很明显,会把完整句子、完整段落从中间切断,破坏语义完整性。适合纯简单文本场景。
- 2. 递归字符切片:优先按照换行、句号、逗号等分隔符切割,尽量保证句子完整,达到阈值再截断,LangChain默认方案,业务最常用。
- 3. 语义切片:基于向量相似度,语义发生明显变化的地方切分,按照语义边界切割,效果更好,但计算开销更大。
- 4. Markdown 结构化切片:识别标题层级,按照文档天然标题结构切分,针对markdown文档效果极佳。
应用实践经验:
- 通用中文场景,递归切片,chunk_size300‑800字符,重叠overlap设置为chunk的 10%‑20%。重叠的意义,避免完整语义被切分到两个chunk边界,造成信息丢失。
- 技术文档、说明书:chunk_size偏小300‑500;
- 合同、长段落业务文档:chunk_size 600‑800。
切片不是一套参数通吃所有文档类型,实际项目中,需要针对自己文档做测试调参。
2. Embedding嵌入模型选择
Embedding模型决定向量质量,向量质量差,再好的向量数据库索引也救不回检索效果。Embedding 模型分为开源模型、闭源 API。
- 闭源:OpenAI‑Embedding,调用简单,效果优秀,但有调用费用,内网隔离环境无法使用。
- 开源中文 Embedding:bge‑系列、m3e 系列,是国内 RAG 落地主流选择,可以本地部署,离线可用。
选型要点:
- 输入长度:注意模型支持最大上下文长度,如果文档chunk超过模型最大输入,会直接截断,向量效果大幅下降;
- 向量维度:维度越高,携带信息越多,同时向量存储占用内存、磁盘空间会变大;
- 语言适配:中文业务优先选择中文训练的Embedding,不要直接使用英文预训练模型;
- 检索场景:注意区分检索型Embedding,不是文本生成模型。
查询的向量化,必须和入库文档使用完全同一个Embedding模型。入库用bge,查询用 m3e,向量空间完全不匹配,检索结果完全失效。
3. 检索与重排序
向量数据库返回top‑k候选片段,这里会出现一个问题:语义相似不等于真正对问题有用。向量召回会出现语义相近但是无关的噪声片段。
重排序Rerank就是第二步过滤。Rerank模型接收用户问题和召回出来的文档片段,计算每一段文本和问题相关性分数,重新排序,过滤掉低分无关片段。
实践流程:向量数据库粗召回 top‑8~top‑10,再送入 Rerank 模型,筛选 top‑3‑top‑5 送入大模型。 粗召回多拿一些候选,重排序做精准筛选,是提升 RAG 效果性价比极高的手段。

- Rerank同样有开源模型 bge‑reranker,可以本地部署。线上要注意开销,rerank会增加推理耗时。
- 元数据过滤也是检索环节重要手段。向量检索同时带上过滤条件,例如只检索某部门文档、某时间之后的资料,缩小检索范围,减少无关召回。
4. Prompt工程设计
检索拿到正确文档,不代表大模型就可以输出好答案,Prompt 的设计至关重要。
RAG 场景 Prompt 基础组成:
- 系统提示词:约束大模型行为,告知模型只能参考给定上下文回答,不知道就如实说不知道,禁止编造;
- 检索回来的参考文档片段;
- 用户原始问题。
非常关键的约束指令:如果参考资料没有对应答案,请直接告知没有找到相关信息,禁止编造内容。这条指令可以进一步压制幻觉。同时要控制送入大模型的总token,检索回来的片段不能无限制全部塞进去,防止上下文窗口溢出。
5. RAG项目部署架构
RAG部署架构面向生产环境,划分用户接入、网关业务、核心引擎、存储、运维观测五大层级。包含在线问答、离线文档入库两条解耦链路,支持多格式文档解析、分块向量化,采用向量 + BM25 混合检索搭配重排序优化召回效果。依托多类存储组件分别管理向量、元数据与原始文件,配套监控、链路追踪与问答日志,兼顾业务能力、数据可靠性与可观测性,可落地企业知识库类大模型应用。
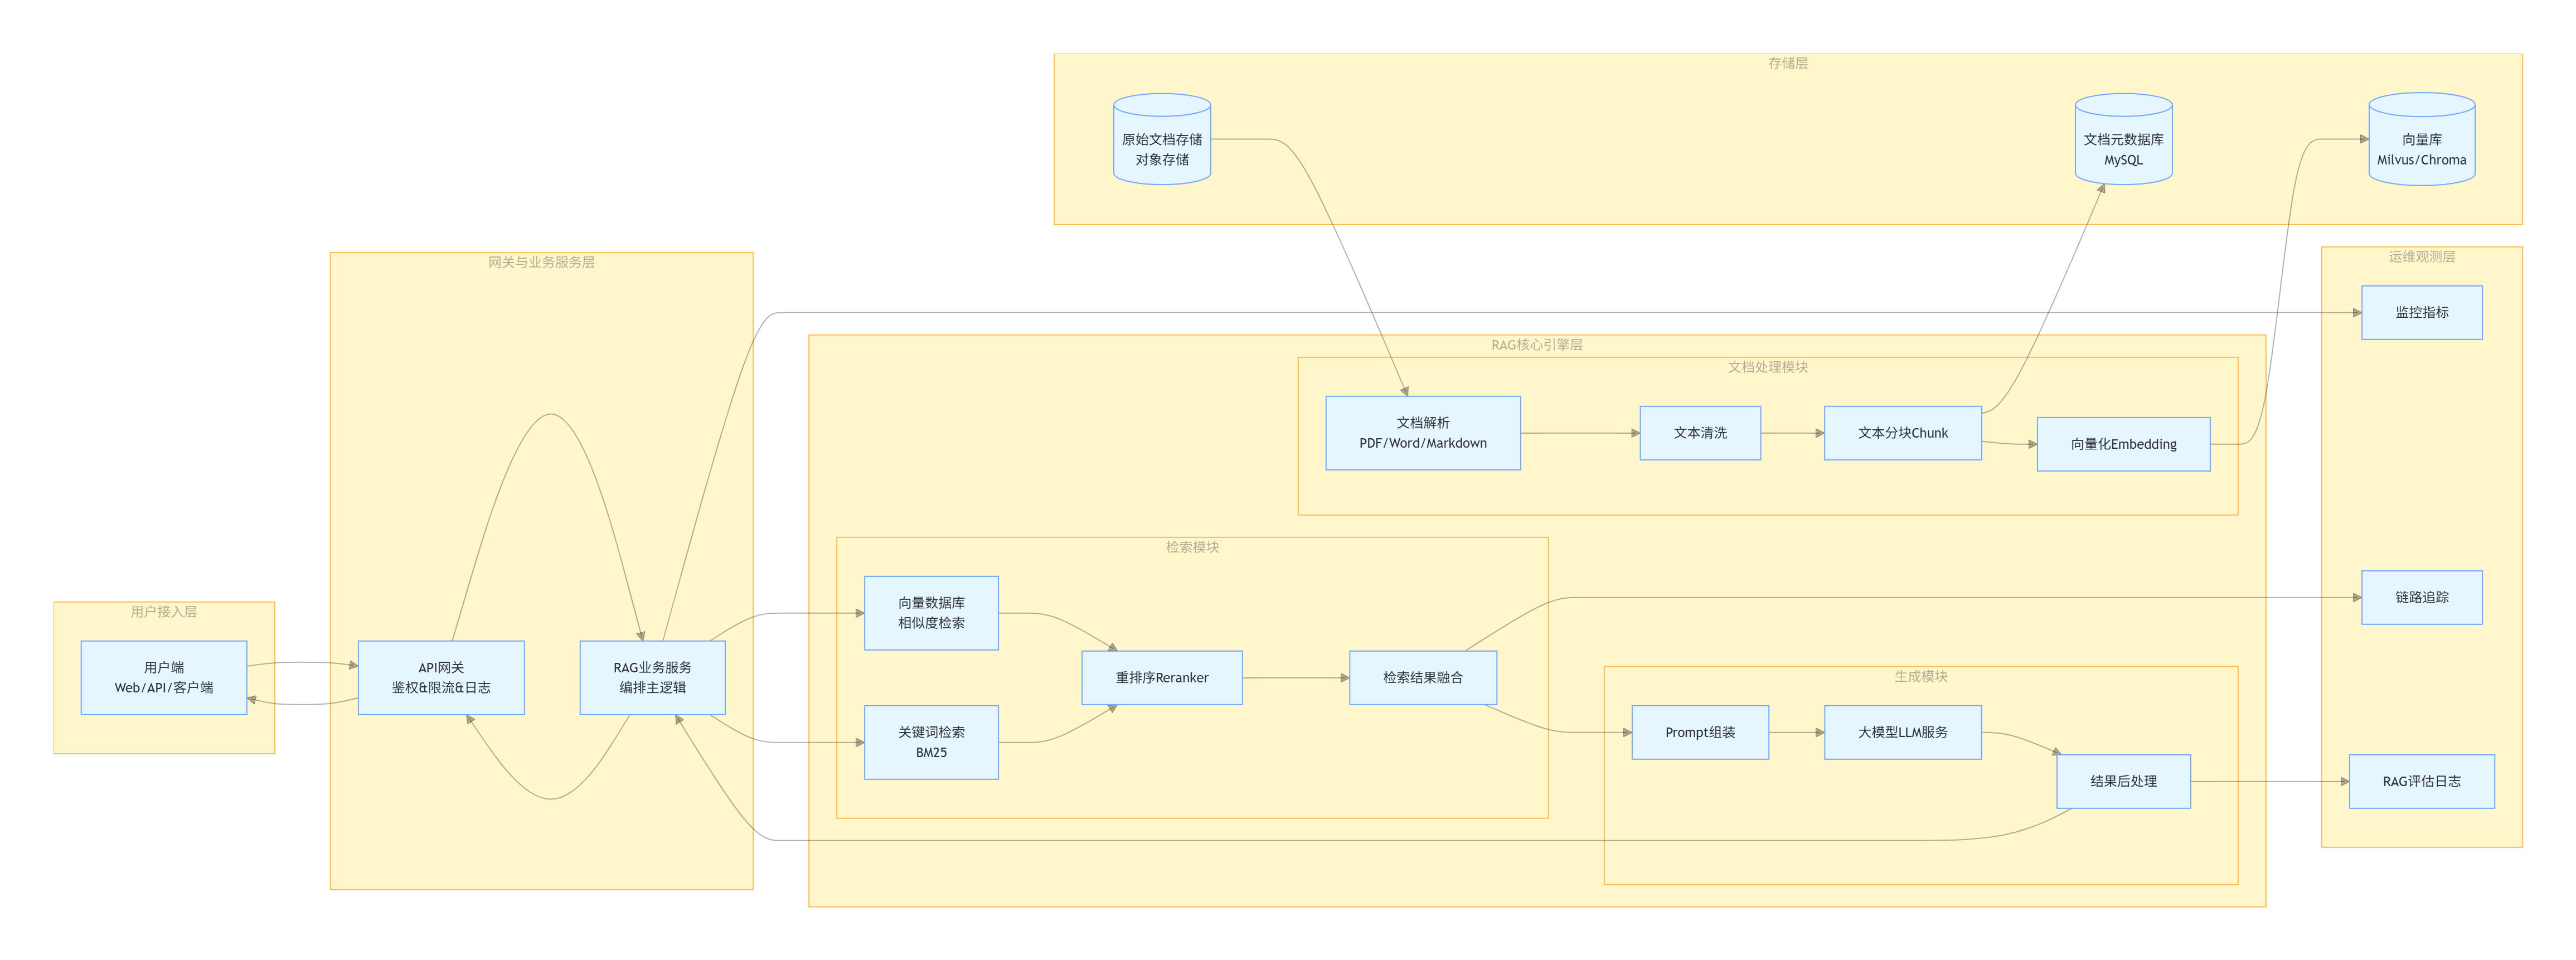
架构图分点说明:
两条链路相互解耦,文档入库为离线异步流程,问答是在线实时流程,互不阻塞。
- 1. 用户接入层
- 承载各类终端访问入口,包含Web页面、API接口、业务客户端。
- 用户问答、文档上传请求统一从这一层流入整个系统,是系统对外交互的入口。
- 2. 网关与业务服务层
- API 网关:承担流量管控,实现鉴权、限流、请求日志记录,拦截非法请求,保护后端核心服务。
- RAG 业务服务:整个RAG流程的编排中枢,串联检索、Prompt构造、大模型调用、结果返回,调度各个子模块协同工作。
- 3. RAG 核心引擎层‑文档处理模块
- 属于离线数据流水线,用于知识库构建。完成原始文档解析、脏数据清洗、文本分块、Embedding 向量化,处理完成的数据送入底层存储,为检索提供数据基础。
- 4. RAG 核心引擎层‑检索模块
- 实现混合检索能力:向量相似度检索 + BM25关键词检索;
- 经过Reranker重排序后融合多源结果。核心目标是从知识库中召回和用户问题最相关的文本片段,减少无关内容。
- 5. RAG 核心引擎层‑生成模块
- 将用户提问与检索得到的上下文片段组装成Prompt,调用大模型服务生成回答,再对输出做过滤、格式整理等后处理,输出最终答案。
- 6. 存储层
- 向量数据库:存储文档片段的向量,提供向量相似度查询;
- 元数据库 (MySQL):保存分块信息、文档ID、权限、版本等元数据;
- 对象存储:保存PDF、Word等原始文档文件,用于溯源与重新解析。
- 7. 运维观测层
- 采集全链路运行信息:服务性能指标、调用链路追踪、RAG问答全量日志。
- 用于定位检索异常、大模型输出问题,支撑知识库迭代与系统运维。
- 8. 两条核心业务链路
- 问答请求链路:用户发起提问,经过网关、业务服务,执行检索‑Prompt组装‑大模型生成,将答案回传给用户;
- 文档入库链路:读取对象存储原始文件,经过文档处理流水线,向量写入向量库、元信息写入数据库,完成知识库更新。
6. 切片 + prompt组装示例
from langchain.text_splitter import RecursiveCharacterTextSplitter

# 原始长文本
long_text = """
RAG检索增强生成技术,主要分为索引构建阶段与查询阶段。
索引阶段对原始文档做加载、切片、向量化存入向量数据库。
查询阶段用户问题向量化,向量库检索相关片段,组装prompt交给大模型生成回答。
向量数据库是RAG系统的底层存储,决定检索召回质量。
文档切片大小会直接影响后续向量语义表达效果。
"""

# 递归字符切片
splitter = RecursiveCharacterTextSplitter(
    chunk_size=200,
    chunk_overlap=30,
    separators=["\n\n","\n","。",","]
)
chunks = splitter.split_text(long_text)
print("切片结果:",chunks)

# 组装RAG提示词
def build_rag_prompt(query, context_list):
    context_str = "\n====文档片段====\n".join(context_list)
    prompt = f"""
你是知识库问答助手,请严格基于下面参考文档片段回答用户问题。
如果参考文档没有相关信息,直接回复未查询到相关内容,不要编造。

【参考文档片段】
{context_str}

用户问题:{query}
你的回答:
"""
    return prompt

user_question = "RAG包含哪些阶段?"
final_prompt = build_rag_prompt(user_question, chunks[:2])
print("\n组装完成Prompt:\n",final_prompt)
五、RAG系统调优
1. 常见问题分析
做RAG项目,经常遇到几类典型问题,我们逐个拆解。
现象 1:明明知识库里面有答案,但是检索召回不到正确片段。 排查方向:
- 1. Embedding模型是否统一,入库和查询是不是同一个模型;
- 2. 文档切片是否把完整语义切碎,关键信息被拆分;
- 3. chunk过大,片段混杂大量无关内容,向量语义被稀释;
- 4. 向量数据库索引参数不合理,ANN索引召回精度不足;
- 5. 问题和文档表达方式差异大,没有做查询改写。
现象 2:检索召回了正确文档,但是大模型回答依旧错误,出现幻觉。 排查方向:
- 1. Prompt没有强制约束模型不能编造,模型习惯自由发挥;
- 2. 检索回来的片段太多,token超限,部分上下文被截断丢失;
- 3. 多个召回片段里面存在互相冲突的信息,模型混淆;
- 4. 大模型本身能力不足,无法理解长参考上下文。
现象 3:召回大量无关文档,噪声很高。 排查方向:
- 1. chunk设置过大,单块文本语义混杂;
- 2. 缺少rerank重排序环节,只依靠向量相似度;
- 3. 没有利用元数据过滤,检索范围过大。
现象 4:向量数据库查询慢,线上QPS上不去。 排查方向:
- 1. 索引类型选择错误,海量向量使用暴力KNN;
- 2. 索引参数配置不合理;
- 3. 向量维度太高,向量数量巨大,硬件资源不足。
2. RAG优化手段
查询改写/查询扩展:
- 用户提问口语化、简短,直接向量化效果差。可以调用大模型,把原始问题改写为多个候选查询,多轮检索。
- 比如用户问 “这个系统怎么部署”,扩写成 “系统部署步骤、系统安装教程”,多向量同时检索,合并召回结果。
文档摘要索引:
- 长文档除了原始chunk,同时存储文档摘要向量。
- 检索的时候先检索摘要,定位对应文档,再拿文档内部片段,适合超长文档。
父‑子检索:
- 子块做检索,使用小chunk,保证检索精度,检索命中子块之后,取出对应的父完整大 chunk 送入大模型。兼顾检索精度和上下文完整性。
自我校验:
- 大模型回答完成之后,校验回答内容是否和参考文档一致,识别幻觉,做二次修正。
并不是所有项目都要一次性上全部高级能力,按需求应用实践顺序:先把基础链路调通,切片、embedding、rerank 调优,基础版本效果达标之后,再逐步叠加高级策略。
3. 应用实践细节
- 知识库更新机制:文档新增、修改、删除。向量数据库需要支持向量的删除更新。直接删除旧向量,写入新向量,要维护文档‑向量映射关系。不要简单重复追加,会产生大量重复噪声数据。
- 来源溯源:每一条回答,需要记录参考了哪些文档片段,输出文档来源 ID,方便校验答案可靠性。
- 资源开销:Embedding、Rerank、LLM都有算力消耗,要评估并发、GPU 资源。
- 评估体系:RAG 效果不能靠肉眼主观感受,需要做量化评估。数据集包含问题、期望参考文档,统计召回率、精确率,迭代参数的时候可以客观对比效果。
- 告警监控:监控向量库查询耗时、召回数量、token 消耗,异常告警。
4. 简易检索改写示例
"""
查询改写简单示例,大模型生成多个候选query,提升召回
"""
def expand_query(llm, origin_query):
    prompt = f"""
请针对用户问题,生成2‑3个不同表达方式的查询,用于知识库检索,只输出查询,每行一个。
原始问题:{origin_query}
"""
    resp = llm.chat(prompt)
    query_list = [q.strip() for q in resp.split("\n") if len(q.strip())>0]
    query_list.append(origin_query)
    return list(set(query_list))

# 使用:多个query分别检索,合并去重结果
# multi_queries = expand_query(llm, "向量数据库如何优化RAG检索速度")
六、完整RAG应用示例
以下示例实现了一个带Rerank重排序的完整 RAG 问答流程:离线阶段用bge-small-zh将文档切片向量化存入Chroma;在线阶段先粗召回Top10,再用bge-reranker交叉编码器精排取Top3,最后组装Prompt送入大模型,显著提升检索精度与回答质量。
from langchain.text_splitter import RecursiveCharacterTextSplitter
import chroma
from chroma import Client
from sentence_transformers import SentenceTransformer
from sentence_transformers import CrossEncoder

# ---------------------- 1.初始化模型 ----------------------
# 文档&查询嵌入模型
embedding_model = SentenceTransformer("BAAI/bge‑small‑zh‑v1.5")
# rerank重排序模型
rerank_model = CrossEncoder("BAAI/bge‑reranker‑small‑zh‑v2")

# 向量库初始化
chroma_client = Client()
try:
    chroma_client.delete_collection("rag_full_demo")
except:
    pass
coll = chroma_client.create_collection(name="rag_full_demo")

# ---------------------- 2.离线构建索引 ----------------------
raw_docs = [
    "RAG检索增强生成,不改动大模型权重,通过检索外部私有文档,补充模型上下文,缓解幻觉问题。",
    "向量数据库专门存储高维文本向量,提供高效ANN近似检索,是RAG系统的底层存储组件。",
    "文档切片是RAG关键步骤,切片过大过小都会损害检索效果,中文业务常用300‑800字符区间。",
    "Rerank重排序模型可以对向量粗召回结果做二次筛选,过滤无关噪声,显著提升RAG回答质量。"
]

# 文档切片
splitter = RecursiveCharacterTextSplitter(
    chunk_size=350,
    chunk_overlap=40,
    separators=["\n","。",","]
)
all_chunks = []
for doc in raw_docs:
    chunks = splitter.split_text(doc)
    all_chunks.extend(chunks)

# 向量化入库
vec_list = embedding_model.encode(all_chunks).tolist()
ids = [f"chunk_{i}" for i in range(len(all_chunks))]
coll.add(embeddings=vec_list, documents=all_chunks, ids=ids)

# ----------------------3.RAG问答推理流程 ----------------------
def rag_answer(user_input:str):
    # 1.问题向量化,向量库粗召回top10
    q_vec = embedding_model.encode(user_input).tolist()
    res = coll.query(query_embeddings=[q_vec], n_results=10)
    recall_texts = res["documents"][0]

    # 2.rerank重排序
    rerank_inputs = [(user_input,text) for text in recall_texts]
    scores = rerank_model.predict(rerank_inputs)
    scored = list(zip(scores, recall_texts))
    scored.sort(key=lambda x:x[0], reverse=True)
    top_context = [item[1] for item in scored[:3]]

    # 3.组装prompt
    context_join = "\n---参考片段---\n".join(top_context)
    prompt = f"""
你是知识库问答助手,请严格依据下面参考片段回答用户问题。
如果参考片段没有对应信息,直接回复【未找到相关资料】,禁止编造任何内容。

参考片段:
{context_join}

用户问题:{user_input}
回答:
"""
    # 这里替换为你的大模型调用,示例直接打印prompt
    return prompt, top_context

if __name__ == "__main__":
    question = "RAG怎么缓解大模型幻觉?"
    final_prompt, context = rag_answer(question)
    print("===检索到的上下文===")
    for t in context:
        print("-",t)
    print("\n===送入LLM的Prompt===")
    print(final_prompt)
七、总结
总的来说,向量数据库、文档切片、Embedding、检索重排这些检索链路组件,才是决定RAG效果的基石。RAG不是一套复制粘贴就可以直接万能生效的模板。没有万能的chunk大小,没有万能Embedding,没有一套参数适配全部业务。真正落地,需要理解每一个环节的影响,针对自己业务文档做调试、对比、迭代。
向量数据库作为整套检索增强系统底座,它的选型、索引配置、向量存储、检索策略,直接决定整套系统的上限。掌握向量数据库实践,理解向量化检索完整逻辑,我们就可以独立设计、落地适配业务的高效向量化检索解决方案,把大模型知识库真正落地到业务场景之中。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号