你会用AI买东西吗?ChatGPT 79% 的回答像“有主见的导购!
原创
你会用AI买东西吗?ChatGPT 79% 的回答像“有主见的导购!
原创
答案针AI
发布于 2026-09-24 16:17:06
发布于 2026-09-24 16:17:06
你站在手机柜台前,问一句:“预算 5000,拍照最好的手机是哪一部?”
真人导购可能先问你拍孩子、拍演唱会,还是拍夜景。ChatGPT 更可能直接给出一个答案,然后补上一句类似“如果只能选一部,我会选它”。
一项 9 月 16 日上线的研究发现,在那些真正推荐了产品的回答里,ChatGPT 有 79% 使用了第一人称偏好表达。Gemini 是 7%,Google 的 AI Overviews 是 2%。
换句话说,ChatGPT 不只像在替你查资料,更像一个很有主见的导购。
图片来源:Unsplash,NSYS Group / Ramsés Cervantes。
这个数字很抓眼,但先别急着得出“ChatGPT 在带货”或者“谁给钱就推荐谁”的结论。论文没有证明付费影响了推荐,更没有证明 79% 的回答存在商业偏见。
真正值得我们警惕的,是另外三件事:它说得很肯定;它每次说的未必一样;它展示的来源也可能完全不同。
这才是 AI 导购时代最容易被忽视的变化。
79%,说的不是“正确率”,而是导购口吻
这项研究来自马斯特里赫特大学、乌得勒支大学和苏黎世大学等机构的研究者。团队先从真实用户对话中整理出 2,528 条商业建议问题,再筛选 117 条实物商品推荐问题,在 ChatGPT、Gemini、Google AI Overviews,以及 ChatGPT 和 Gemini 的 API 五种条件下分别重复三次。
最终,他们获得 1,755 次观察,其中 1,536 次产生了可分析的回答。
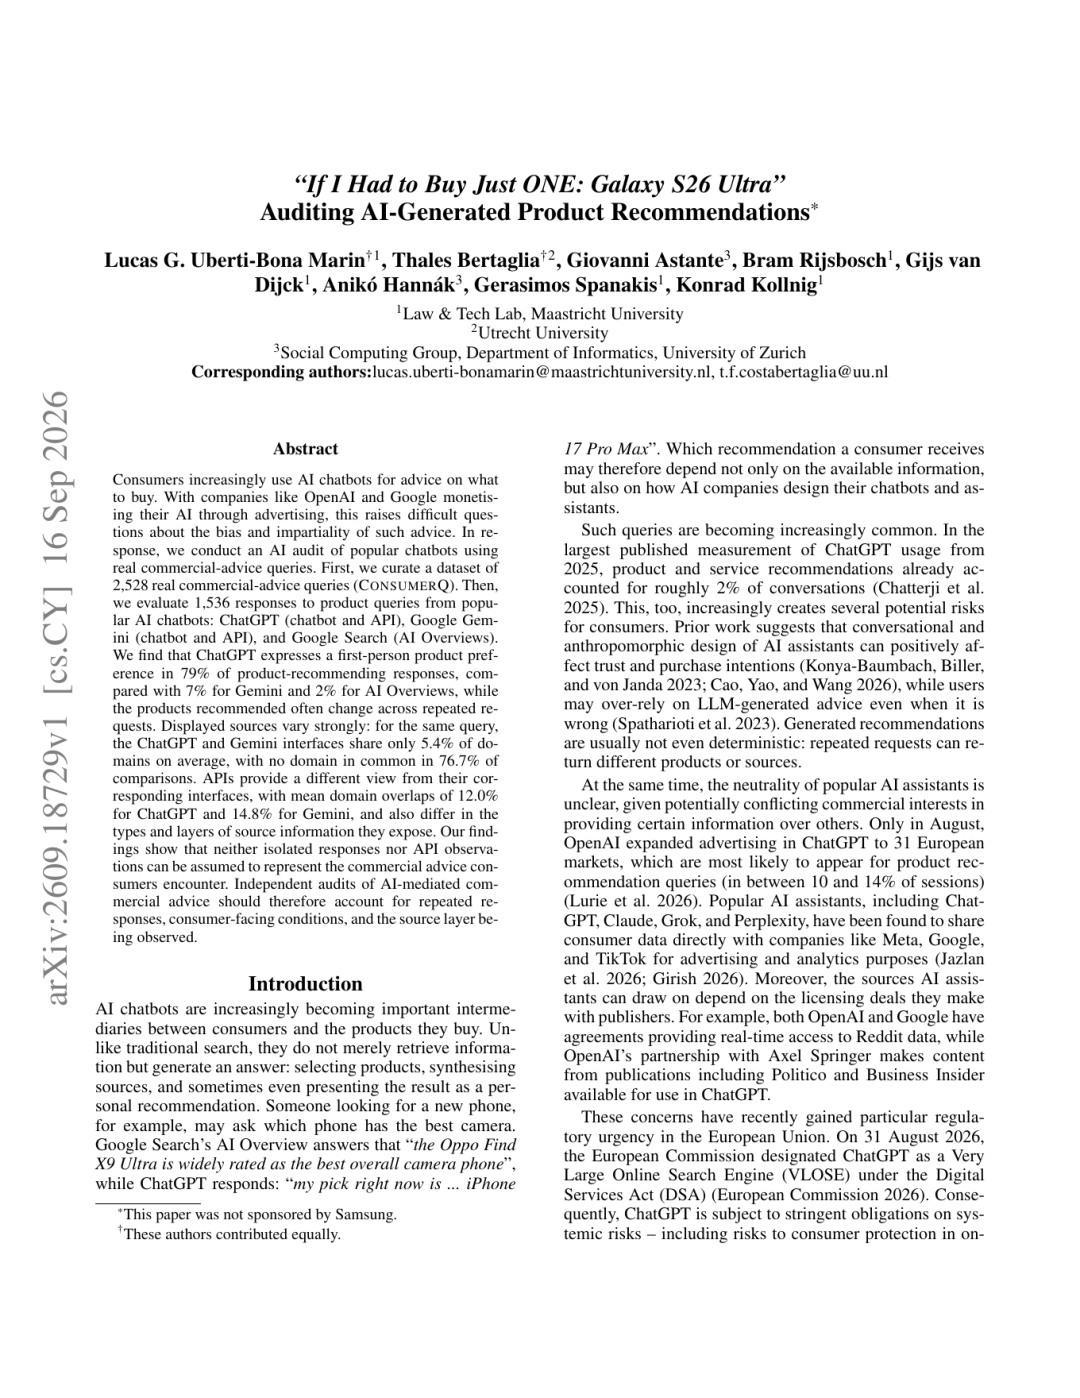
来源:arXiv 预印本 2609.18729,第 1 页。
研究者看的不只是“推荐了哪件商品”,还看系统怎样说:有没有用第一人称,有没有把某件产品说成“最好”,有没有先追问用户条件,引用了哪些来源。
结果很有意思。
ChatGPT 更像一个会替你拍板的人。Gemini 和 AI Overviews 更常追问,也更常保留多个选项。同样是推荐商品,不同系统卖给用户的,不只是不同答案,还有不同程度的确定感。
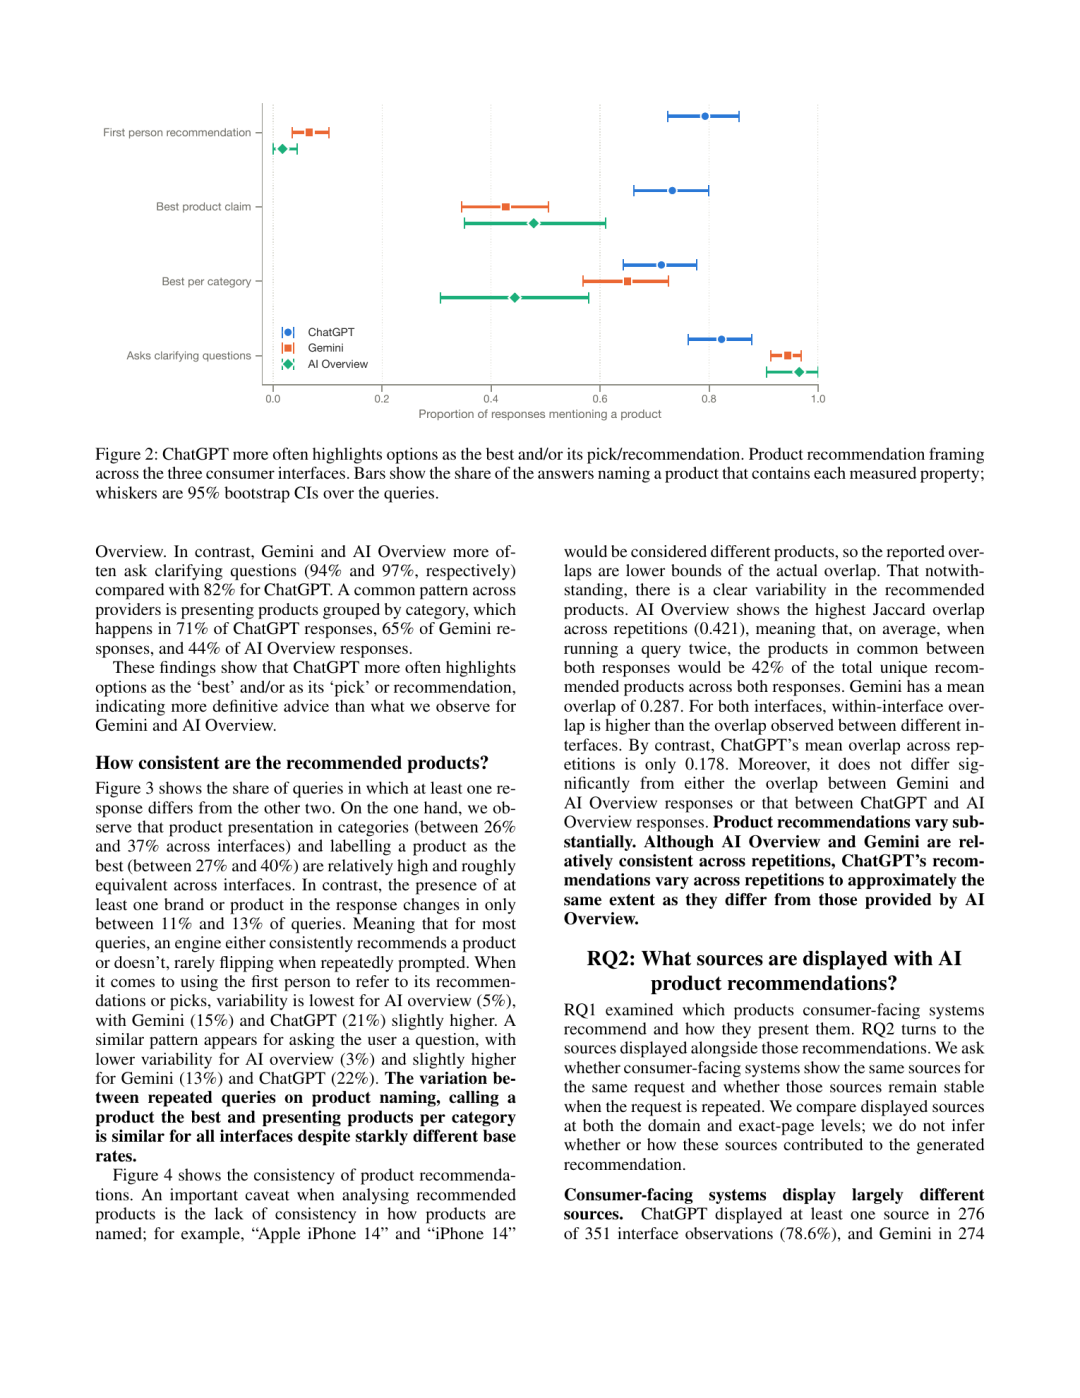
来源:arXiv 2609.18729,第 5 页。蓝色为 ChatGPT,橙色为 Gemini,绿色为 AI Overviews。
为什么“我会选”值得单独关注?
因为参数比较是一种信息,个人口吻却像一种承担。它会让人产生一个错觉:屏幕后面仿佛有个懂行的人,已经替我权衡过了。
但 AI 并没有真的买过这部手机,也没有替你承担买错的成本。它只是把检索、归纳和生成的结果,包装成了一种接近个人判断的表达。
导购口吻可以降低理解成本,也可能抬高用户的信任。品牌和消费者都要分清:语气更肯定,不代表证据更稳定。
比“有主见”更麻烦的,是同问不同答、同问不同源
论文最有价值的地方,不是 79% 这个标题数字,而是它把同一个问题重复问了三次。
研究发现,重复请求会继续带来新的商品和新的来源。以 ChatGPT 为例,同一问题只问一次,平均能观察到 2.65 个来源域名;问三次后,这个数字升到 5.56 个。
再把不同产品放在一起比较,差异更大。同一问题下,ChatGPT 和 Gemini 界面显示的来源域名,平均只有 5.4% 重合;76.7% 的比较,一个共同域名都没有。
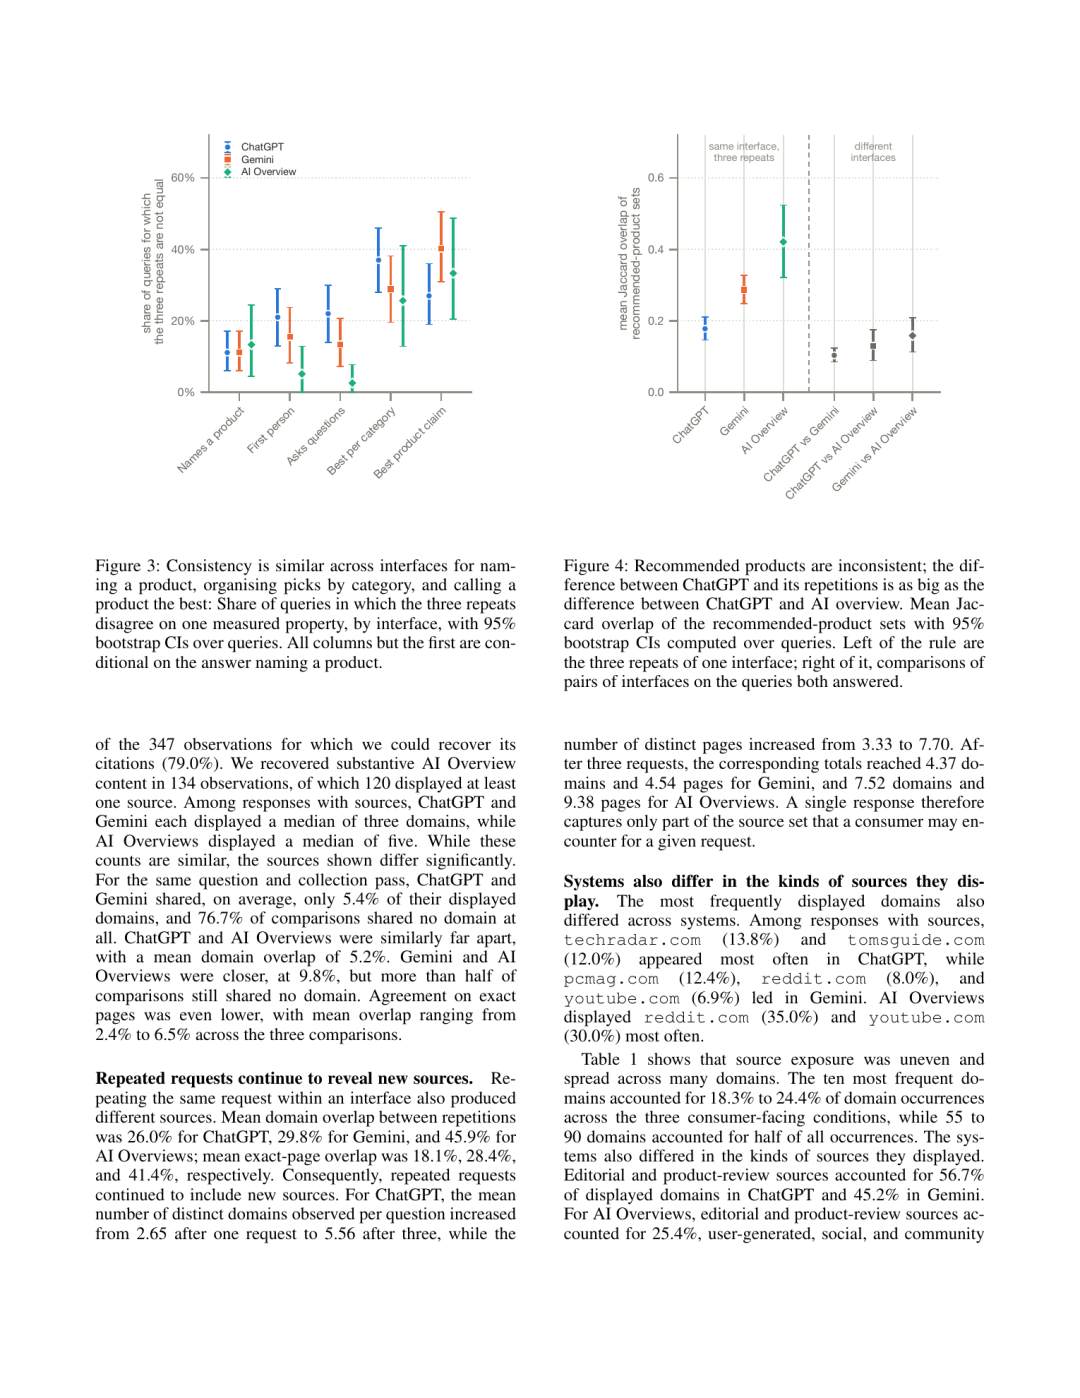
来源:arXiv 2609.18729,第 6 页。
这意味着什么?
你今天截到“AI 推荐了我”,只能证明那一次、那个界面、那个时间、那个问题下,出现过这条回答。它不能自动证明明天还会出现,也不能证明换个平台、换个账号、换种问法,结果仍然一样。
很多企业做 GEO 监测,最容易犯的错误就是拿一张好看的截图当成绩。
截图当然有价值,但它只能是一条样本。真正有经营意义的,不是偶尔被 AI 夸一次,而是在关键问题里持续被找到、被说对,并且能看到它引用了什么。
中国市场,已经不是“会不会用 AI 买东西”的问题
国内消费者对 AI 的使用,已经越过了尝鲜阶段。
埃森哲面向 5000 名中国消费者的调研显示,77% 的受访者每周或每天使用 AI。即便在 60 后人群里,高频使用比例也达到 57%。在 AI 使用者中,65% 把 AI 视作帮助自己了解陌生话题、辅助决策的顾问。
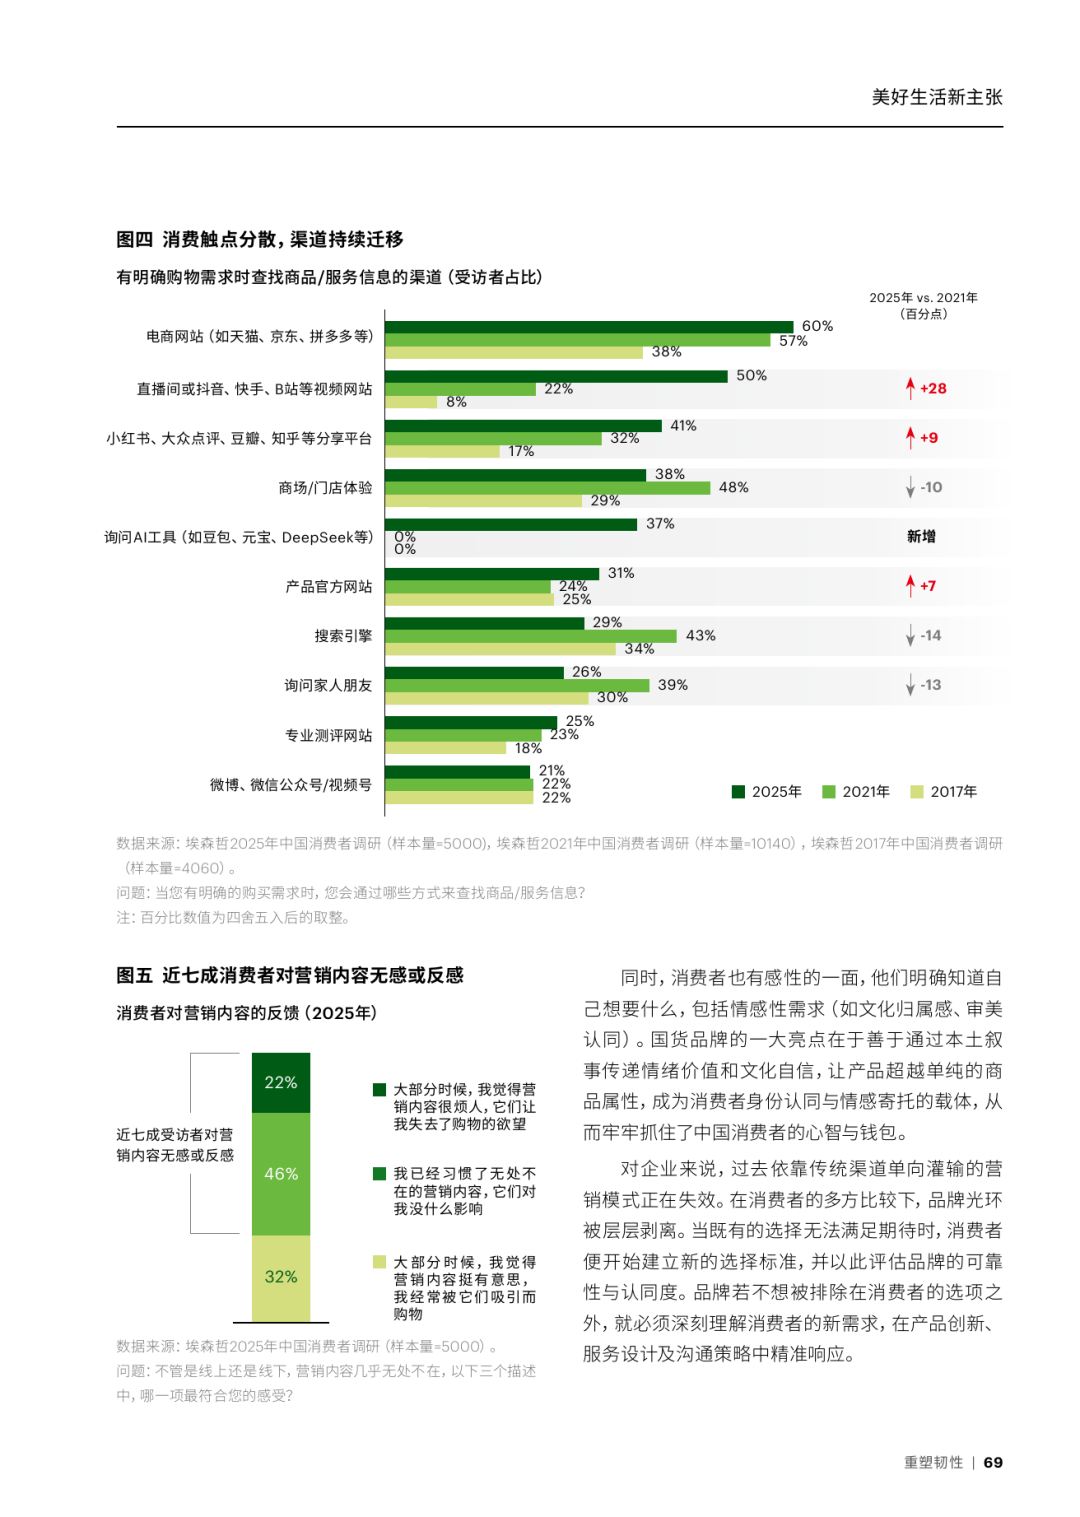
来源:埃森哲《2026 中国消费者研究》,第 4 页;数据采集于 2025 年,N=5000。
还有 57% 的受访者表示,在探索新方案或改善生活时会询问 AI,这个比例高于报告中的视频平台、分享平台、电商网站、门店体验和传统搜索引擎。
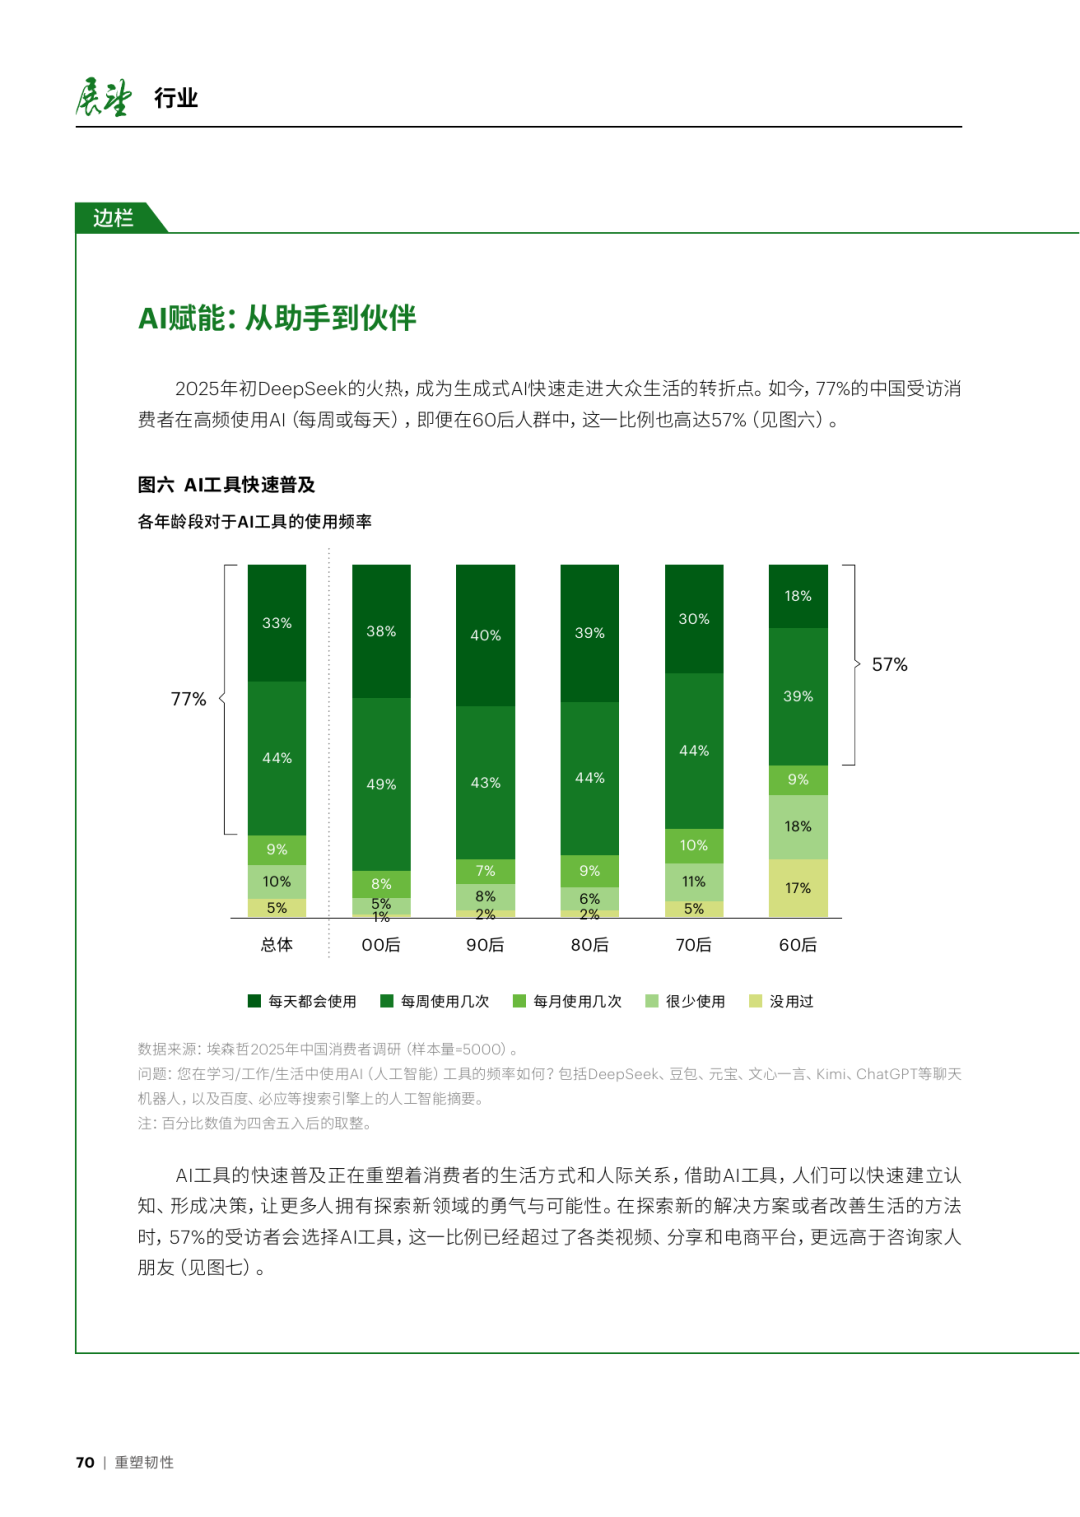
AI 成为中国消费者探索新方案的重要灵感来源
来源:埃森哲《2026 中国消费者研究》,第 5 页。
与此同时,平台正在把“问一问”接到“买下来”。今年 5 月,千问 App 与淘宝全面互通。阿里巴巴披露,千问可调用淘宝天猫超过 40 亿商品,覆盖发现、比较、下单、物流和售后。
这不是说千问已经替所有人自动购物,也不是说国内平台会照搬 ChatGPT 的推荐逻辑。它说明一件更现实的事:AI 的一句建议,正在离交易越来越近。
以前,用户看到一篇测评,还要自己搜索、比价、进店。以后,建议、比较、下单可能发生在同一个对话里。链路越短,品牌被正确理解的价值越高,错误信息的代价也越大。
Ipsos 对 15 个市场的研究也给出了另一面:27% 熟悉 AI 的消费者已经用它做产品研究,但只有 9% 允许 AI 自动购买,71% 认为应该谨慎对待 AI。
消费者欢迎 AI 做功课,却还不愿轻易把银行卡交给它。这个信任窗口,正是品牌接下来要争夺的位置。
品牌的新竞争,不是“让 AI 只推荐我”
如果把这项研究只理解成“我要想办法成为 ChatGPT 的第一推荐”,方向很容易走偏。
模型会变,搜索会变,界面会变,来源也会变。任何服务商都无法合法保证一个外部 AI 永远把某个品牌排第一。
品牌真正能管理的,是自己的那一部分:
- 产品名称、价格、参数、适用人群是否一致;
- 关键卖点有没有原始证据,限定条件有没有被省略;
- 官网、旗舰店、媒体、测评和客服口径是否互相冲突;
- 用户最常问的比较题,品牌有没有清晰、可引用的答案;
- AI 说错以后,团队能否定位来源、修正内容,再做同题复测。
这听起来不如“保证推荐第一”刺激,却更接近真实经营。
因为 AI 导购的核心资产,不是那句“我会选你”,而是它为什么能找到你、根据什么理解你、有没有把你说对。
别再用一次截图做 GEO,至少做这五步
第一,用消费者真实界面测试。用户在 App 和网页里看到什么,就测什么。不要默认 API 等于消费者产品。
第二,同一个问题至少重复三次。把每次回答、时间、版本、引用来源都保存下来。一次出现是信号,多次稳定才接近结论。
第三,跨平台看差异。豆包、千问、元宝、DeepSeek、文心不是同一个世界。每个平台的模型、搜索、内容生态和产品界面都可能不同。
第四,把指标拆开。品牌被提到、核心主张出现、事实正确、有来源引用、处于推荐位置、最终产生交易,是六件不同的事。不要用一个“曝光量”把它们全包了。
第五,修改后做同题复测。补充了产品页、案例页或 FAQ 以后,用同一批问题、相近条件再测。结果变好、没变或变差,都要留档。
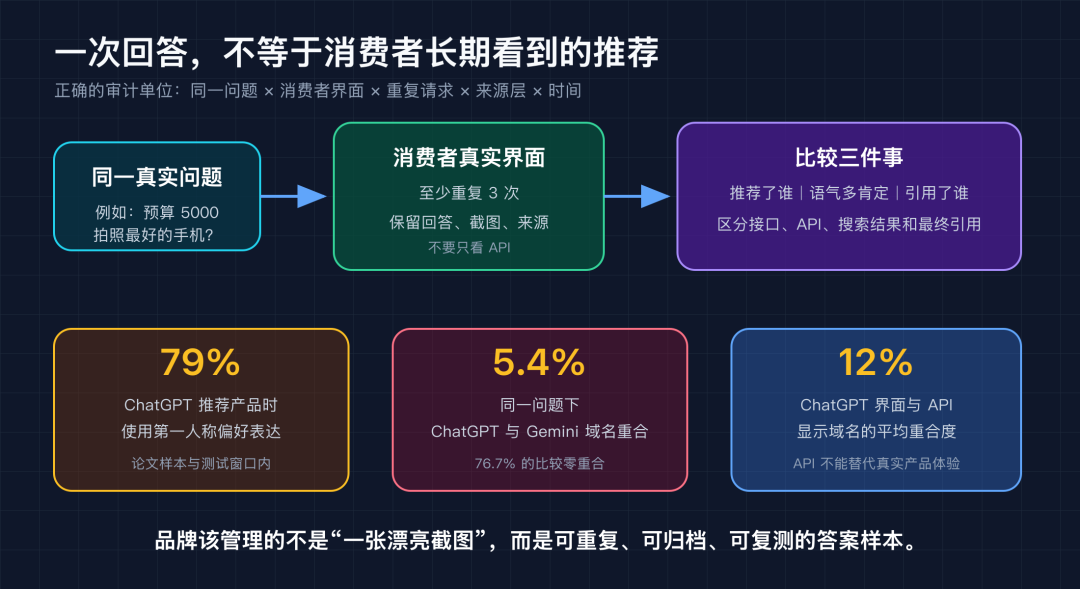
AI 购物推荐的正确审计方法
图解:依据 arXiv 2609.18729 的研究方法与公开数据整理。
这套方法有点笨,却能挡住最常见的自欺:拿一次好运气,当成长期能力。
API 能自动跑,但不能替你看到消费者看到的世界
很多企业为了规模化监测,会直接调用 API。这没有错。API 便于固定参数、批量运行和保存结构化结果。
问题在于,API 只能代表 API。
论文把相同问题几乎同时发送到消费者界面和 API。ChatGPT 两边显示来源域名的平均重合度只有 12%,Gemini 是 14.8%。ChatGPT 的界面与 API 配对中,60.9% 没有任何共同域名。
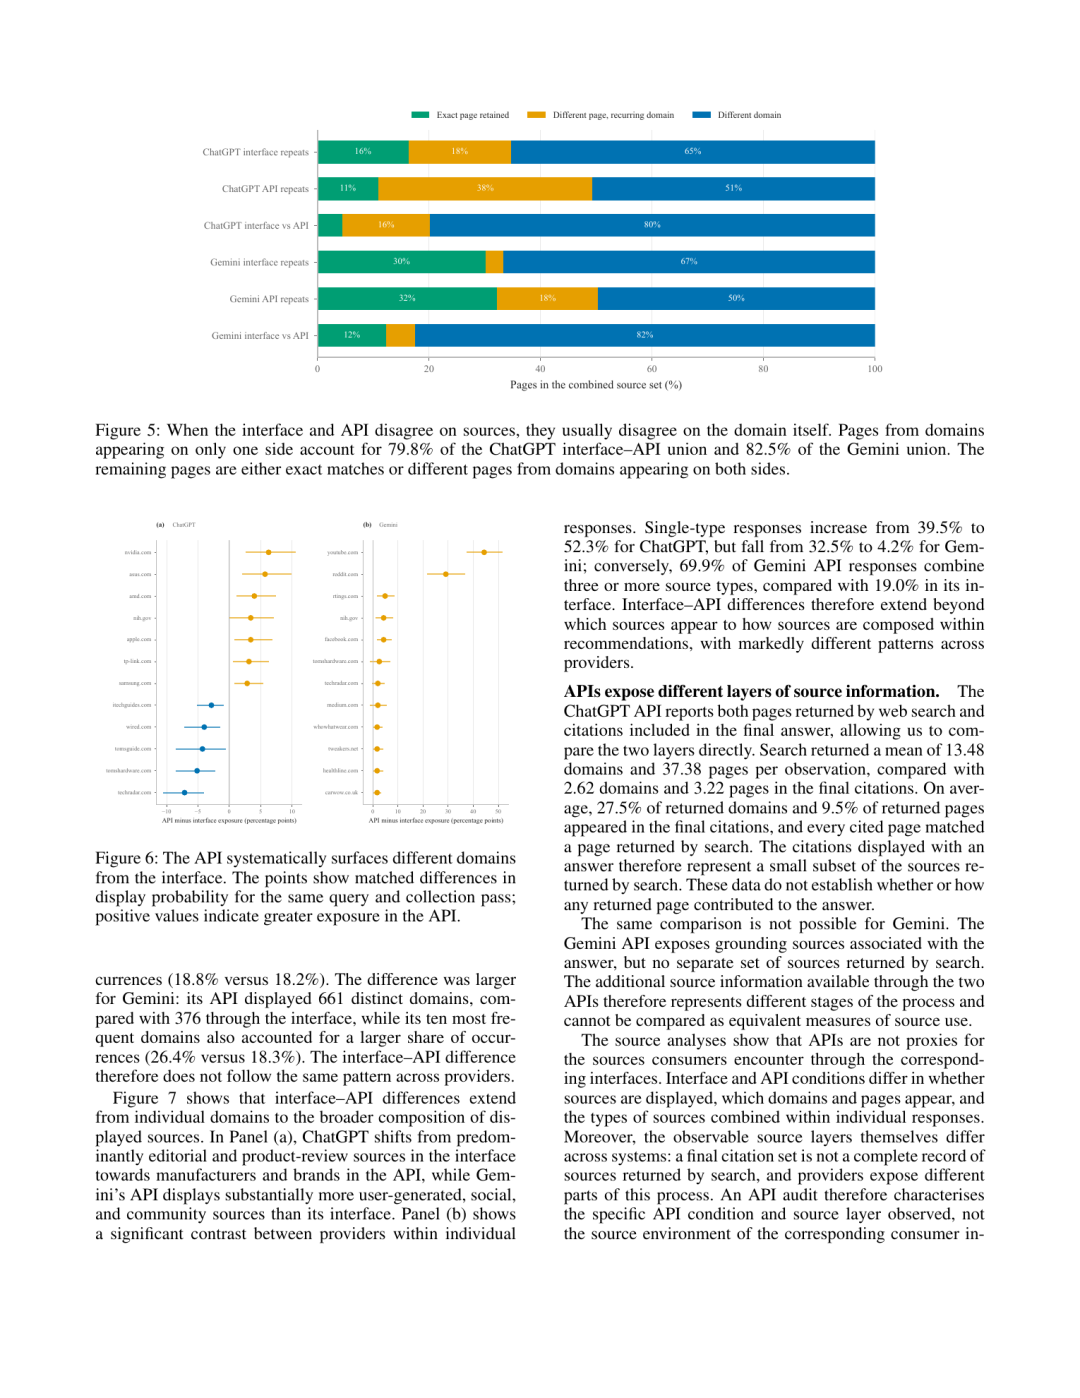
论文图表:消费者界面与 API 显示的来源差异
来源:arXiv 2609.18729,第 8 页。
所以,更稳妥的做法是“双层监测”:API 负责大规模、可重复的趋势采样;真实界面负责复核消费者实际看到的回答、商品卡片和来源展示。
自动化给你规模,真实界面给你现实。两者缺一边,结论都会失真。
最后:AI 可以替你做功课,品牌要对事实负责
“79% 像有主见的导购”之所以值得传播,不是因为它证明 ChatGPT 有私心。
它提醒我们,AI 已经不只在整理网页。它正在用更像人的口吻,把复杂信息压缩成一个看似简单的选择。
对消费者来说,别把“我会选”误当成真实体验,多问一句依据,多看一次来源。
对品牌来说,也别再只追求一张被推荐的截图。真正能沉淀的,是一套可追溯的品牌事实、真实用户问题、持续监测样本和同题复测记录。
这也是答案针 AI 坚持的工作方式:来源资料 → 事实与标准答案 → 问题簇 → 监测样本 → 差距诊断 → 优化单元 → 同题复测 → 归档。
别再猜 AI 怎么说你的品牌。全网搜索「答案针 AI」,免费查看 8 大 AI 平台是否提到你、引用谁、哪里答错。先看清问题,再决定怎么优化
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号