AI客流分析系统技术架构:从3D感知到边缘AI数据输出
原创
AI客流分析系统技术架构:从3D感知到边缘AI数据输出
原创
FOORIR
发布于 2026-09-24 11:16:38
发布于 2026-09-24 11:16:38
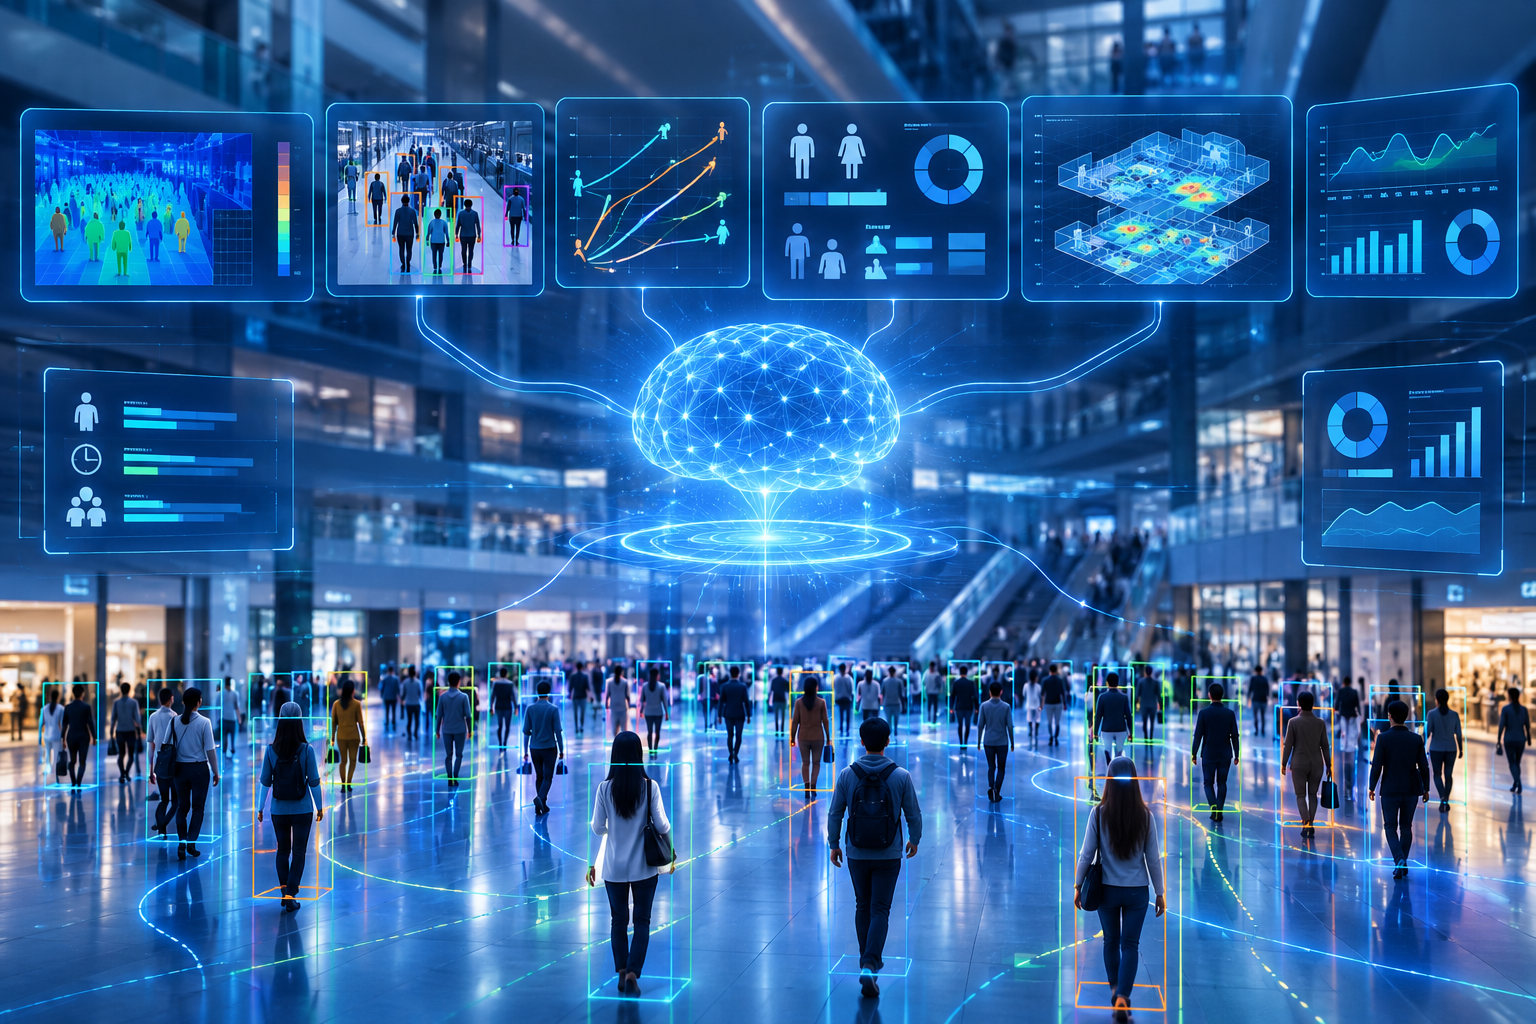
AI客流分析系统本质上是一套实时目标检测与时空数据处理系统。
输入端是传感器数据,输出端是结构化客流数据,中间经过人体检测、深度计算、目标跟踪、轨迹判断、属性识别和数据聚合。
如果只从“统计人数”理解系统,很容易忽略真正决定性能的技术环节。
本文按照系统架构拆解AI客流分析的完整数据链路。
1. 系统总体架构
典型AI客流分析系统可以划分为:
┌──────────────────────────┐
│       Sensor Layer       │
│ RGB / Stereo / Depth     │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│     Perception Layer     │
│ Person Detection         │
│ Depth Estimation         │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│      AI Layer            │
│ Tracking / ReID /        │
│ Age / Gender / Events    │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│     Data Processing      │
│ Filter / Dedup /         │
│ Aggregation              │
└────────────┬─────────────┘
             ↓
┌──────────────────────────┐
│       API Layer          │
│ HTTP / HTTPS / MQTT      │
└──────────────────────────┘
这种架构的核心不是“摄像头”,而是数据从感知层到结构化事件层的连续转换。
2. 感知层:系统到底采集什么
不同系统的传感器配置并不完全相同。
常见输入包括:
- RGB图像
- 双目图像
- 深度数据
- 红外数据
- 时间戳 -设备状态信息
对于双目视觉系统,左右摄像头获得两个不同视角的图像。
通过匹配左右图像中的对应点,可以计算视差。
基本关系:
Z = fB/d
其中Z为深度,f为焦距,B为双目基线,d为视差。
获得深度之后,目标检测不再只有二维坐标:
(x, y)
还可以得到:
(x, y, z)
这就是3D客流分析与普通二维图像计数的重要技术区别之一。
3. 人体检测层
人体检测负责回答:
当前数据中哪里存在人体目标?
输出通常包含:
Class
Confidence
Bounding Box
Timestamp
Depth
例如:
{
  "class": "person",
  "confidence": 0.97,
  "bbox": [312, 124, 428, 516],
  "depth": 3.42
}
检测模块一般不会直接产生最终客流统计。
因为同一个人会在连续帧中反复被检测。
因此需要进入Tracking阶段。
4. Tracking:从单帧检测变成连续目标
Tracking的主要作用是维护目标ID。
例如:
Frame 001 → Person ID 08
Frame 002 → Person ID 08
Frame 003 → Person ID 08
Frame 004 → Person ID 08
如果没有Tracking,系统可能把同一个人在100帧中的100次检测理解为100个目标。
因此客流统计实际上依赖:
Detection + Tracking
而不是单独依赖目标检测模型。
5. 轨迹分析
Tracking之后,系统可以记录目标的位置序列:
P1 → P2 → P3 → P4 → P5这条轨迹可以用于判断:
- Entry
- Exit
- Turn-back
- Dwell
- Pass-by
- Re-entry
例如设置一条虚拟线L:
Outside
   ↓
   P1
   ↓
   P2
--- L ---
   ↓
   P3
   ↓
Inside
只有目标轨迹真正穿越L,系统才产生Entry事件。
因此,客流事件实际上是一个空间+时间联合判断问题。
6. ReID与跨区域关联
单一摄像头可以依靠Tracking维持目标ID。
但是当目标进入另一个检测区域时,原ID可能无法继续使用。
这时可以使用ReID。
ReID通常将人体目标转换成特征向量:
Person A
   ↓
Feature Extraction
   ↓
Embedding Vector
   ↓
Similarity Matching
然后根据相似度进行目标关联。
对于大型场景,多摄像头之间还需要进行:
- 时间同步
- 区域映射
- ID关联
- 数据融合
最终形成统一轨迹。
7. 属性识别
在人体检测和跟踪之后,可以叠加属性模型。
例如:
Gender
输出:
Male
Female
Unknown
Age Group
输出年龄区间。
Staff
通过预设规则或人员特征建立分类。
Body Features
可以使用人体外观特征辅助ReID。
需要特别区分:
属性识别 ≠ 身份识别。
一个系统可以识别“女性、约25–35岁”这一类别,但并不需要知道具体是谁。
8. 边缘AI为什么越来越常见
传统架构可以采用:
Camera
   ↓
Network
   ↓
Server
   ↓
AI Processing
边缘AI则可以变成:
Sensor
   ↓
Edge AI Device
   ↓
Local Processing
   ↓
Structured Data
   ↓
Cloud / Platform
主要计算过程在设备侧完成。
这样可以减少原始视频持续上传。
如果设备最终只上传:
{
  "entry": 15,
  "exit": 11,
  "dwell": 86
}
那么云端接收的是结构化数据,而不是完整视频流。
对于网络带宽、实时性和数据处理方式都会产生影响。
9. 数据处理层
AI模型产生的数据还不能直接作为最终统计结果。
通常需要经过:
Filtering → Validation → Deduplication → Aggregation
例如:
Raw Events
   ↓
Invalid Event Filter
   ↓
Duplicate Check
   ↓
Time Window Aggregation
   ↓
Final Traffic Data
时间窗口可以设置为:
- 1 min
- 5 min
- 15 min
- 30 min
- 60 min
系统根据业务接口要求输出不同粒度的数据。
10. 接口层
客流分析系统最终需要与其他软件交换数据。
常见协议包括:
- HTTP POST
- HTTPS POST
- MQTT
- FTP
- SFTP
- RS485
例如HTTP接口可以发送:
{
  "device_id": "CCD21-001",
  "timestamp": 1727145000,
  "entry": 23,
  "exit": 18,
  "dwell": 126
}
平台接收到数据后,再完成存储和统计。
因此设备端与平台端之间实际上形成:
Edge → API → Platform
的数据链路。
11. 技术指标应该怎么看
AI客流设备常见的指标包括:
指标 | 技术含义 |
|---|---|
Counting Accuracy | 统计结果准确程度 |
Detection Confidence | 目标检测置信度 |
Tracking Stability | 目标ID连续性 |
ID Switch | 跟踪过程中ID错误切换 |
ReID Accuracy | 跨区域目标关联能力 |
Latency | 数据处理延迟 |
FPS | 每秒处理帧数 |
MTBF | 平均无故障时间 |
IP Rating | 防尘防水等级 |
Operating Temperature | 工作温度范围 |
其中不能把Detection Accuracy直接等同于Counting Accuracy。
目标检测准确,并不意味着最终人数统计一定准确。
中间还存在Tracking、Direction Detection和Event Logic。
12. 一个完整事件是如何产生的
假设一个人从入口进入:
Sensor
  ↓
Person Detection
  ↓
Depth Estimation
  ↓
Tracking
  ↓
Trajectory
  ↓
Virtual Line Crossing
  ↓
Direction = IN
  ↓
Event Validation
  ↓
Entry +1
如果继续停留:
Entry Timestamp
       ↓
Tracking
       ↓
Area Monitoring
       ↓
Exit Timestamp
       ↓
Dwell Time
最终得到的不是一个简单的“1”,而是一组带有时间和空间属性的数据。
13. 从技术角度理解AI客流分析
AI客流分析可以抽象成:
Sensor Data → Human Object → Target ID → Trajectory → Attribute → Event → Structured Data
这也是系统最核心的技术链路。
因此,“能识别多少人”只是一个表层指标。
真正需要观察的是:
系统能否稳定检测目标、保持ID连续、建立轨迹、判断方向、识别属性,并在规定延迟内输出结构化事件。
这些能力共同决定最终客流数据的质量。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号