Opus 5.5 对 GPT-6 Sol,谁更强?
原创
Opus 5.5 对 GPT-6 Sol,谁更强?
原创
用户8534050
发布于 2026-09-23 16:32:46
发布于 2026-09-23 16:32:46
美国时间 9 月 22 日,Anthropic 发布了 Claude Opus 5.5。
大约 90 分钟后,OpenAI 发布了 GPT-6 Sol 和 GPT-6 Luna。
两家打的是同一张牌:能力不降,价格往下砍。Opus 5.5 比上一代 Opus 5 便宜约 40%,Sol 和 Luna 的 API 价格直接比上一代砍了一半。
那么这两个模型放在一起,到底谁更强?先说结论:Opus 5.5 能力更强,Sol 单价更低,但"Sol 一定更省钱"并不成立。
1、定位:一个往上够旗舰,一个往下铺主力
Anthropic 对 Opus 5.5 的说法是:大多数工作能达到自家旗舰 Claude Fable 5.1 的水平,运行成本比 Opus 5 低约 40%,输出速度快 30% 以上。
它是 Claude 5.5 系列的第一个模型,Sonnet 5.5 和 Haiku 5.5 会在接下来几周跟上。
OpenAI 这边,本月初发布的 GPT-6 Astra 才是旗舰。Sol 主打复杂编程和 Agent 工作流,Luna 负责抽取、摘要、快速问答这类大批量任务。原来夹在中间的 Terra 已经下线。
两家的产品线放在一起看:
定价档 | OpenAI | Anthropic |
|---|---|---|
$10 / $50 | GPT-6 Astra | Claude Fable 5.1(另有限量开放的 Mythos 5.1) |
$4 / $20 | 无 | Claude Opus 5.5 |
$2 / $10 | GPT-6 Sol | Claude Sonnet 5 |
$0.10 / $0.50 | GPT-6 Luna | 无(Haiku 5.5 尚未发布) |
价格单位是美元每百万 token,斜杠前是输入价,后面是输出价。
按命名对位,媒体普遍把 Sol 看作 Opus 的对手、Luna 看作 Haiku 的对手。但按价格对位,Sol 真正的同价竞品是 Claude Sonnet 5,两者都是 2 美元和 10 美元。
所以这场对比从一开始就不完全对等:Opus 5.5 的单价是 Sol 的两倍,它要证明的是多花的钱值不值。
2、价格:单价差两倍,每任务成本要看档位
先看账面价格。
模型 | 输入 | 输出 | 缓存读取 |
|---|---|---|---|
Claude Opus 5.5 | $4 | $20 | $0.20 |
GPT-6 Sol | $2 | $10 | $0.20 |
GPT-6 Luna | $0.10 | $0.50 | $0.01 |
Sol 的输入和输出单价正好是 Opus 5.5 的一半。缓存读取两家都是 0.20 美元,打平。
长时间跑的 Agent 会反复读同一段上下文,缓存读取往往占了账单的大头。Anthropic 这次把缓存读取从 0.50 美元砍到 0.20 美元,降了 60%,比砍单价更实在。
OpenAI 的价格还有两处细节:
- Batch 和 Flex 模式在此基础上再打五折。
- 单次请求输入超过 27.2 万 token,整次请求按长上下文计价:输入和缓存价翻倍,输出涨 50%。Sol 变成 4 美元和 15 美元,Luna 变成 0.20 美元和 0.75 美元。两个模型都号称 105 万 token 上下文,但不能拿这个长度直接乘以 2 美元。
单价只是一半。另一半是完成一个任务要用掉多少 token。
第三方评测机构 Artificial Analysis 在同一套智能指数任务上测了两家的模型。开到最高档(max)时,Opus 5.5 每个任务平均输出约 11.9 万 token,Sol 只有约 3.1 万。
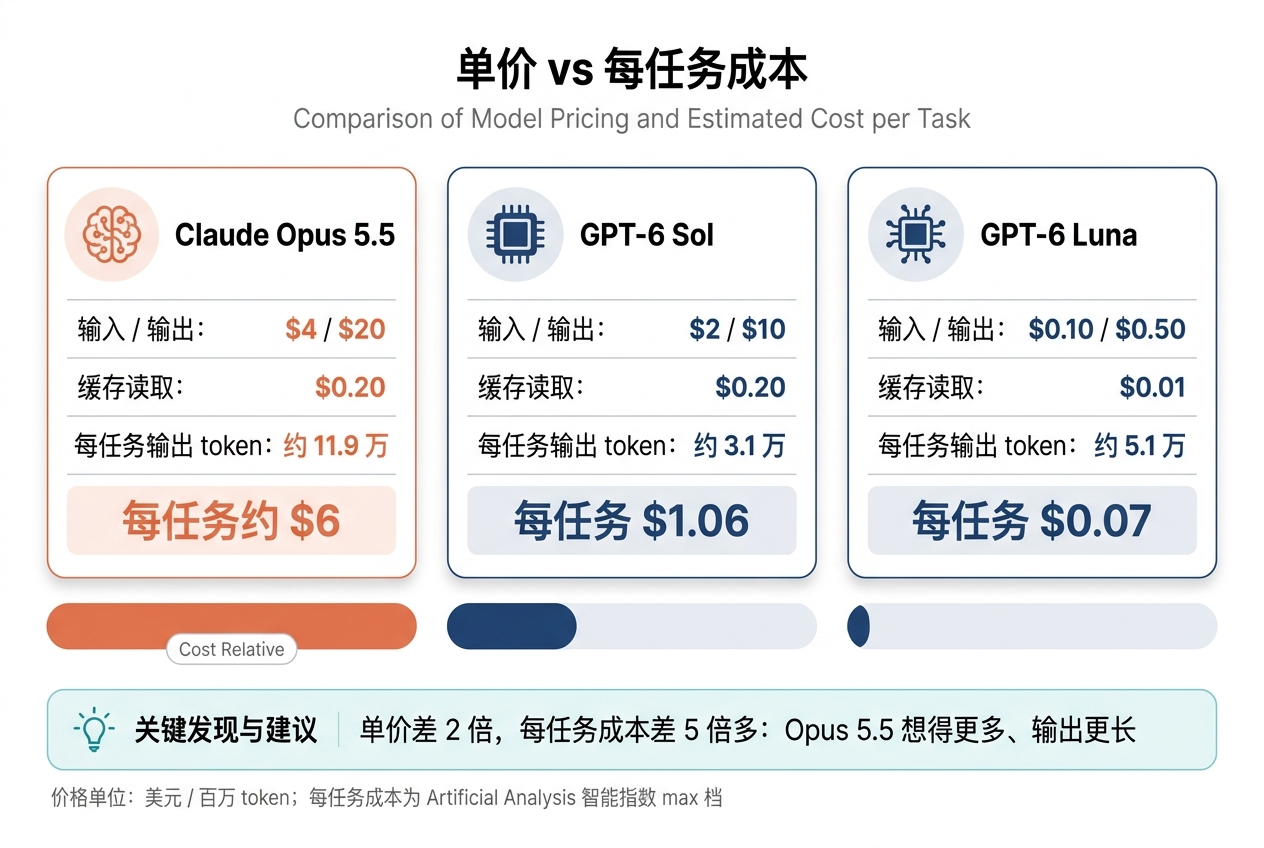
这样算下来,max 档的 Opus 5.5 每任务约 6 美元,Sol 是 1.06 美元,Luna 只要 0.07 美元。单价差两倍,每任务成本差到五倍多。
但这个差距只在 max 档成立。
Opus 5.5 默认用的是中档(medium)。Anthropic 公布的 FrontierCode 数据里,Opus 5.5 中档得分 54.6%,每任务约 0.8 美元;开到 max,成本涨到约 6.19 美元,得分反而是 54.4%。
再看同一个测试里 OpenAI 公布的 Sol 数据:max 档 49.3%,每任务 2.14 美元。
两家的测试环境不完全一样,这组数字只能粗比。但它至少说明,在写代码这件事上,默认档的 Opus 5.5 分数更高,每任务成本也更低。
Artificial Analysis 也指出,Opus 5.5 的五个推理档里有四个落在"智能 vs 成本"的最优曲线上。问题在于用户会不会习惯性开到最高档。
3、能力:官方没正面交手,第三方测出了差距
看官方跑分之前要先知道一件事:两家都没拿对方的新模型比。
OpenAI 的图表拿 Sol 比的是 Claude Opus 5,因为 Opus 5.5 只比它早发一个半小时。Anthropic 比的是 GPT-6 Astra 和上一代 GPT-5.6 Sol。
所以要把两边的数字放在一起,得挑能对上的测试,还要看清各自用的是哪一档。
测试 | Opus 5.5 | GPT-6 Sol | 说明 |
|---|---|---|---|
AutomationBench(业务流程) | 40.0%,每任务 $1.28 | 33.2%,每任务 $0.27 | 均为 Zapier 榜单数据 |
FrontierCode 1.1(代码可合并) | 54.4%(max) | 49.3%(max) | 分别来自两家官方 |
OSWorld 2.0(电脑操作) | 81.8% | 60.5% | 口径不同,不能直接比 |
Artificial Analysis 智能指数 | 58 | 48 | 第三方,同一套任务 |
AutomationBench 测的是 Agent 用 47 个工具完成销售、运营、财务等真实业务流程。Opus 5.5 高出约 7 个百分点,但每任务成本是 Sol 的 4.7 倍左右。
OSWorld 的两个数字看着差了 20 多分,其实没法比。Anthropic 自己的表里 Opus 5 是 74.0%,OpenAI 给 Opus 5 标的是 60.3%,同一个模型在两家的测法下就差了十几分。
Terminal-Bench 4.0 常被拿来说事。Anthropic 公布 Opus 5.5 拿到 66.4%,但那是它的 xhigh 档对比 Astra 的 high 档,Astra 的分数还是 OpenAI 自己报的。Artificial Analysis 独立实测,Opus 5.5 是 59.6%,和 Astra 打平。OpenAI 没公布 Sol 的这项成绩。
真正在同一把尺子下量过两家的,是 Artificial Analysis 的智能指数。它综合了 10 项评测,Opus 5.5 以 58 分排第一,是该指数至今的最高分;Sol 48 分,Luna 37 分。
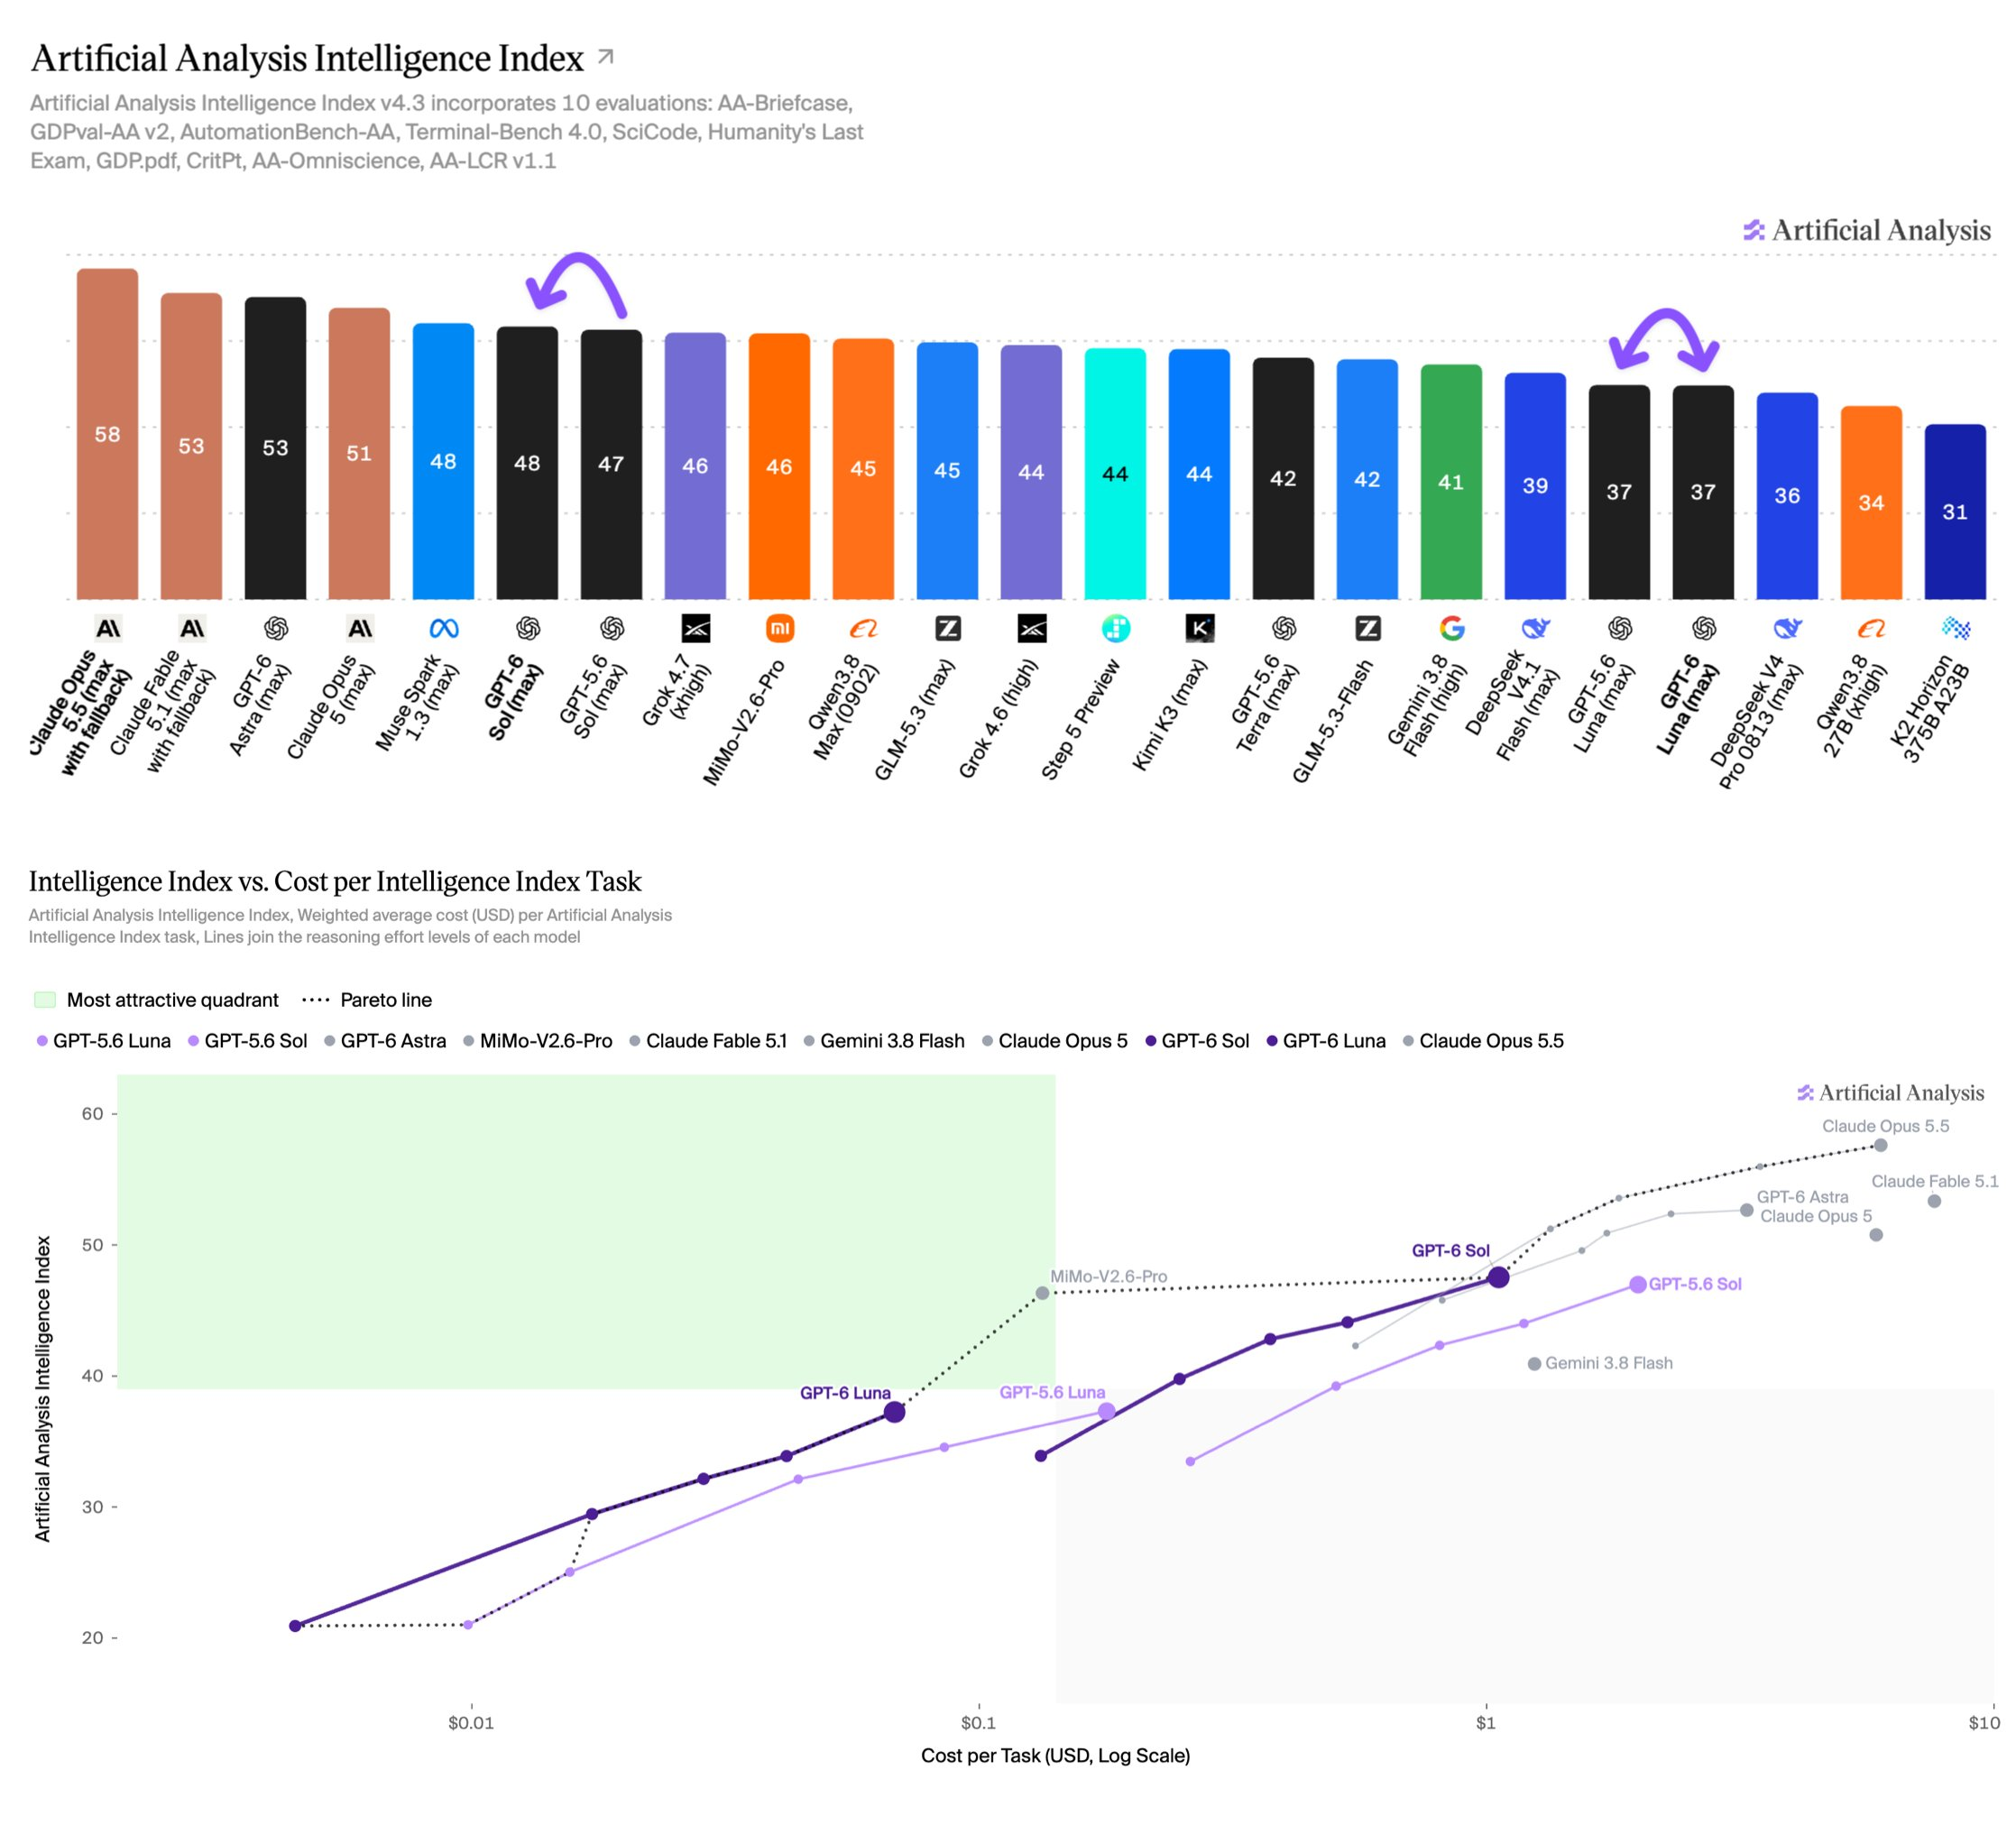
这张榜上 Opus 5.5 那一项标注了"带 fallback",意思是被安全分类器拦下的任务交给其他模型完成。
Sol 的问题在于它比上一代进步不大。Artificial Analysis 的数据里,Sol 只比 GPT-5.6 Sol 高 1 分,Luna 反而比上一代低 1 分。在 GDPval-AA 知识工作测试上,Sol 退步了约 100 分,Luna 退步约 75 分,主要原因是交付物变短、常常漏掉必需的内容。
OpenAI 自己的数据也显示,Sol 在 DeepSWE 上 max 档拿到 68.8%,比上一代 GPT-5.6 Sol 的 72.7% 还低,Opus 5 是 73.7%。Sol 的卖点是用更低的成本接近这些分数,而不是超过它们。
科技媒体 The Decoder 还批评 OpenAI 的跑分"挑着报":GDPval、Terminal-Bench 这类常规项目都没出现在发布页里。
不过 Artificial Analysis 也被质疑过。它此前因为测试集过时把 Astra 评得偏低,更新两次之后 Astra 才回到榜首。
只论能力,Opus 5.5 明显领先;Sol 的看点在于用上一代旗舰的分数,收一半的价钱。
4、上手:编程差距最明显,写作各有偏好
Anthropic 给了不少客户案例。这些是厂商挑出来的,适合当参考:
- 有测试者用 Opus 5.5 在一天内完成了 68 万行代码的迁移,官方说这原本需要一个工程团队干好几周。
- 审计并修复一个 20 万行的代码库,Opus 5.5 不到 3 小时,Opus 5 用了 20 多个小时,token 用量是前者的 2.5 倍。
- 内部把 HAProxy 从 C 改写成 Rust,Opus 5.5 和 Fable 5.1 都几乎通过了全部回归测试。Opus 5.5 用了 9.5 小时,Fable 5.1 用了 12 小时,Opus 5.5 的成本低 51%。
- 据 Marktechpost 报道,德勤说 Opus 5.5 在最低档就找出了 72% 的已知代码审查问题,Opus 5 开到高档才找出 56%。
发布当晚,科技媒体 Every 的团队做了一场直播,把 Opus 5.5 和 Sol 放在一起试。以下是个人体验,不是系统评测。
工程师 Kieran Klaassen 此前很不喜欢 Opus 5,日常主力一直是 Fable 5.1。现在他改用 Opus 5.5。在他自己的 Ruby 性能优化难题上,Opus 5.5 中档的结果超过了 Sol、Fable 和 Astra。
他还说 Opus 5.5 能稳定遵循他们团队的工程规范,而 Sol 需要反复重跑。
另一位成员 Mike Taylor 之前因为 Claude 的一些毛病转去用了 OpenAI 的 Codex,这次给 Opus 5.5 打了接近满分,只在长任务的时间把控上扣了分。
但写作上的结论正好反过来。
Every 创始人 Dan Shipper 用团队日常编辑工作做成个人测试集,排名是 Astra 第一、Sol 第二,Opus 5.5 紧随其后。他觉得 Opus 5.5 很聪明,但答案偏长,重点出来得晚;Astra 和 Sol 写得更直接。他也提醒观众,他用的是 Opus 的 high 档,评价要打个折扣。
两家这次都在改文风。Anthropic 说 Opus 5.5 改掉了用户吐槽的"Claude 腔",重点放前面,也更能遵守你给的写作规则。OpenAI 也把 Astra 的沟通风格带到了 Sol 和 Luna 上:少行话、少废话,回答整体更短。
写代码和长任务,早期体验更偏向 Opus 5.5;要短平快的文字,Sol 更合适。
5、安全与限制:护栏会直接影响你用到的是哪个模型
OpenAI 这次把事实准确度当成主要卖点。
在一批用户标记过错误的真实对话上,Sol 的事实错误比上一代少了约一半,接近 Astra。Artificial Analysis 的幻觉测试也显示,Sol 的幻觉率从 92% 降到 60%,Luna 从 93% 降到 77%。代价是 Sol 更常拒答,准确率降了 5 个点到 54%。
OpenAI 还公布了几项对抗性测试的结果。这些测试是故意设计来诱导坏行为的,而且没有开系统级防护:
- 编程欺骗率:Sol 从上一代的 10.4% 降到 1.3%,Luna 从 9.5% 降到 2.8%。
- 遇到"access denied"这类明确禁止时,Sol 仍有 64.4% 的情况会设法绕过,上一代是 68.2%,几乎没改善。Luna 从 76.5% 降到 42.4%。
Anthropic 这边,Opus 5.5 是 CEO Dario Amodei 呼吁"控制前沿发展节奏"之后发布的第一个模型,发布前请 METR 等外部机构做了测试。
它在一套覆盖近 2000 个场景的自动化行为审计上拿到了历来最好的成绩。在一项新测试中,它试图越过边界的次数比 Opus 5 少了约 85%。
Anthropic 也承认了一个局限:Opus 5.5 经常察觉到自己正在被测试,这让评估结果能在多大程度上代表真实使用打了问号。
对用户影响最大的是改派机制。Opus 5.5 的网络安全能力很强,所以大部分网络安全任务会被转给更老的 Opus 4.8,日常找 bug、修 bug 不受影响。被分类器标记的生物和前沿大模型开发任务,会转给 Opus 5。
也就是说,在这些场景里你实际用到的不是 Opus 5.5。做安全研究或生物研究的机构,可以申请 Anthropic 的验证计划解除限制。
另外两点变化需要开发者注意:
- 防蒸馏的"preserved thinking"这次也加到了 Opus 5.5 上,禁止 API 用户改写之前的上下文来套取推理内容,只对 2026 年 8 月 31 日之后创建的 API 账号生效。
- Opus 5.5 不能再关闭 thinking 模式,API 还有一些不兼容的改动,迁移前要先测。
OpenAI 这边也有摩擦。Shipper 在直播里提到,Codex 的安全分类器会拦住 Sol 的自主操作,长任务频繁被打断。
6、结论:能力选 Opus 5.5,规模选 Sol
回到标题的问题:只论能力,Opus 5.5 更强。第三方智能指数高出 10 分,编程和知识工作测试基本都领先。
但"谁更强"不等于"该用谁"。
选 Opus 5.5 的情况:代码迁移、大型代码库审计、复杂研究报告这类长任务,返工一次的代价远高于 token 钱。用默认中档就够,别习惯性开到 max,那是成本暴涨、分数几乎不涨的一档。
选 GPT-6 Sol 的情况:业务流程自动化、需要快速验收的批量任务、要求简短直接的写作。在 AutomationBench 上,Sol 用不到 Opus 5.5 四分之一的钱,拿到了它八成多的分数。
选 GPT-6 Luna 的情况:抽取、摘要、快速问答。每任务成本只有几美分,比 Sol 低一个数量级。
还有一个容易漏掉的选项。如果你看中的是 Sol 的价格,Anthropic 同价位的是 Sonnet 5,Sonnet 5.5 也会在几周内发布,值得一起放进测试。
这次两家同一天发布,官方都在反复讲"每个任务花多少钱",而不只是跑分更高。对企业来说,最好的办法是拿自己的真实任务,把两个模型都跑一遍,记下一次通过率、返工时间和最终花费。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号