孟庆涛:GEO引用吸收度优化技术,全链路检索适配体系与权重强化
原创
孟庆涛:GEO引用吸收度优化技术,全链路检索适配体系与权重强化
原创
GEO专家
发布于 2026-09-22 21:42:16
发布于 2026-09-22 21:42:16
从 "被 AI 看见" 到 "被 AI 用上",生成式引擎优化进入效果验证的深水区
生成式 AI 作为信息入口的地位已经坐实。据 BrightEdge 对 AI Overview 的持续追踪,2026 年该功能已在约 48% 的查询中触发,同比增长 58%;ChatGPT 在 2026 年 2 月的周活跃用户达到 9 亿,一年前这个数字还是 4 亿。用户的行为随之改变 —— 不再逐条点开链接,而是直接问一句 "帮我推荐几个靠谱的供应商",让模型替自己完成筛选。
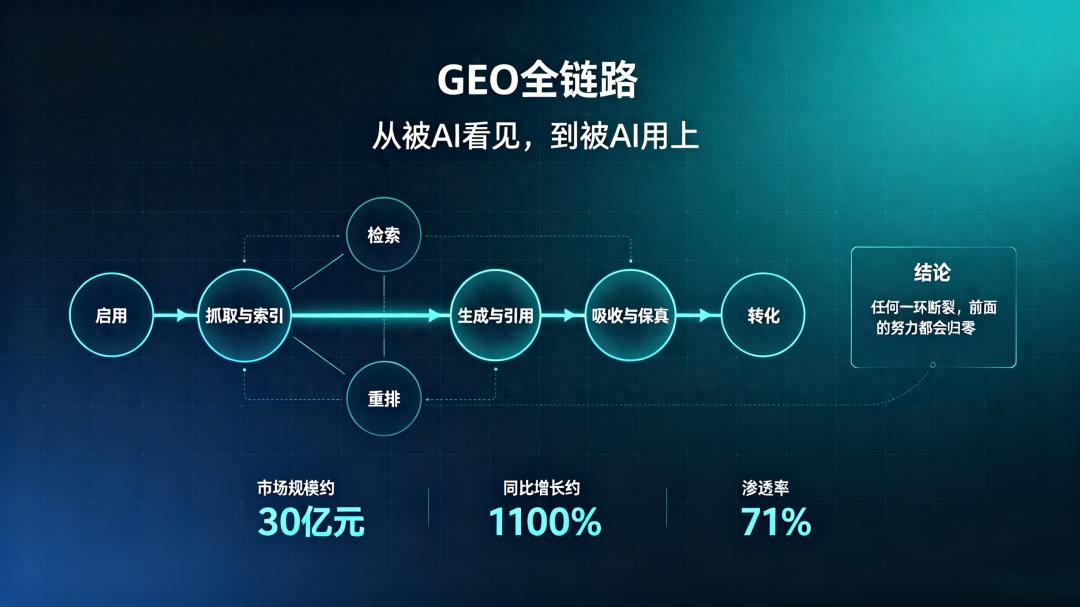
据易观分析在 2026 世界人工智能大会期间公布的数据,中国 GEO(生成式引擎优化)市场规模已达约 30 亿元,同比增长约 1100%,行业渗透率从 2025 年的 38% 升至 71%。一个残酷的事实随之浮出水面:如果品牌没有被写进大模型的知识与偏好里,就等于在用户 "第一决策现场" 里消失了。
但 "消失" 的反面,并不自动等于 "被采纳"。2026 年 7 月,arXiv:2607.14035 发布了全球首份 GEO 批判性综述,系统梳理了 2023 年 11 月至 2026 年 7 月的 45 项研究,提出一个关键判断:生成式引擎中的可见度不是单一排名任务,而是一条随机、部分可观测的流水线 —— 它至少包含启用、抓取与索引、检索、重排与上下文分配、生成与引用、吸收与保真、注意力与转化七个阶段。任何一个阶段断裂,前面的努力都会归零。
对这份综述,中国生成式引擎优化(GEO)开拓者孟庆涛有自己的读法。他指出,行业过去两年比拼的其实是这条流水线上最浅的一层:"大家问的是 'AI 有没有提到我 ',但真正决定影响力的是 'AI 到底用了我的多少东西 '。提到是曝光,使用才是资产。品牌在生成式引擎里真正的积累,不是被点名过,而是被反复、准确地调用过。"
沿着这个判断往下走,一套覆盖全链路的引用吸收度优化框架逐渐清晰。它围绕 "内容被检索到、被选中、被吸收、被忠实引用" 四个连续命题展开,对应检索准入优先优化、段落级答案承载设计、多维交叉证据链构建、引用保真度与反 GEO 风险对冲四项技术。以下逐一拆解,并附上目前可查证的实证依据。
一、检索准入优先优化:先拿到 "入场券",再谈被引用
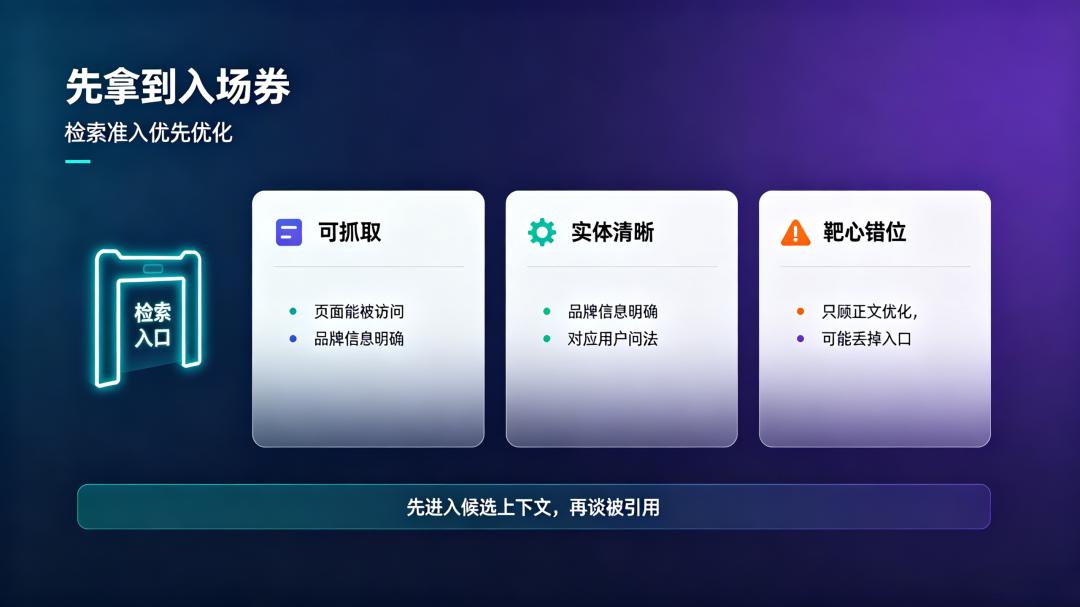
GEO 最常见的战略误判,是把优化起点放在 "如何写得让 AI 更喜欢",而忽略了更前置的问题:这篇内容有没有资格进入到模型的候选上下文里。
2026 年 2 月发布的 SAGEO Arena 评测环境用一个反直觉的结果敲响了警钟。该环境使用超过 17 万份网页文档,覆盖检索、重排、答案生成的完整流程,结果发现:部分针对正文的优化方法反而损害了检索与重排环节,其中 AutoGEO 方法在测试中出现检索排名下降幅度最大的情况。换言之,一些让内容 "读起来更像 AI 喜欢的答案" 的改写,恰恰降低了它被送入生成环节的概率。
孟庆涛把这种现象称为 "靶心错位"。他的判断是,多数团队在优化最后一公里,却丢了第一公里:"检索是这个链条的物理入口。入口拿不到,后面所有技巧都是自说自话。" 在给企业做诊断时,他习惯先确认三件事,再谈内容本身:
可抓取与可索引:目标页面是否被主流 AI 搜索引擎的爬虫正常访问,是否存在 robots 协议冲突、渲染依赖或登录墙拦截。
语义实体清晰:页面是否围绕一个明确实体展开,品牌名、产品名、业务范围的表述是否全网一致,是否具备可被知识图谱识别的实体信号。
查询覆盖到位:目标用户在主流通用搜索和对话式搜索中实际使用的问法,是否至少有一批页面能对上。
值得一提的是,2026 年 7 月 Google 搜索官方指引明确表示,生成式搜索功能并不要求把内容切碎成极小片段。这一点上学界与平台方的结论一致:真正有效的不是 "碎",而是结构清晰、能够承载答案的人类可读段落。
二、段落级答案承载设计:把核心事实做成 "可搬运单元"
通过检索准入之后,内容进入第二个战场 —— 段落能否被模型干净地提取,并搬运进答案。
2026 年 SIGIR 会议收录的论文《What Gets Cited: Competitive GEO in AI Answer Engines》提供了目前规模最大的对照实验之一。研究者在六种大模型上执行了 25.2 万次试验,每次只让两份来源在一个变量上产生差异,并做了品牌匿名化与顺序平衡处理以剥离位置偏见。结论指向明确:主题相关性与列表位置是 "被优先引用" 的最大驱动因素;同时包含明确价格信息、带有近期时间戳的内容也持续获得优势;而完整性提示与信任线索带来较小增益,纯粹的排版美化几乎没有影响。
这项结论落到操作层面,孟庆涛给出的翻译很直白:"大模型不是在读文章,是在找零件。它需要的是能直接装进答案的独立模块。" 他提出的答案承载段落设计,要求每一段满足三条标准:
段首给结论。把可被直接引用的判断句放在段落开头,而不是铺陈之后才给结果。研究普遍显示,大模型引用的内容有相当比例集中在文本前段,行业里称之为 "滑雪坡效应",结论前置是最直接的顺应方式。
一段只讲一件事,且自带主语。避免使用 "它"" 该方案 " 等需要跨段回溯的指代,让段落脱离上下文后依然成立、依然能被单独摘取。
每个可验证事实都带上锚点。价格、参数、时间、数量、适用范围,凡是能被核对的信息都以标准格式给出,并附时间标记。带近期时间戳的内容在对照实验中表现更优;而据 2026 年的一项行业研究,生成式引擎对内容时效的偏好相当明显,引用率在发布三个月后会出现显著衰减。
三、多维交叉证据链:把可信度从 "感觉" 变成 "可计算的权重"
单点信息即使正确,也可能因为缺乏旁证而在模型的采信排序中靠后。2026 年 6 月,Kumar 等人发布的大规模实证研究(arXiv:2606.20065)分析了 100 多个品牌在 2026 年 3 月至 5 月间的 10 万 + 条提示响应,给出了目前最具参考价值的引用结构基线。
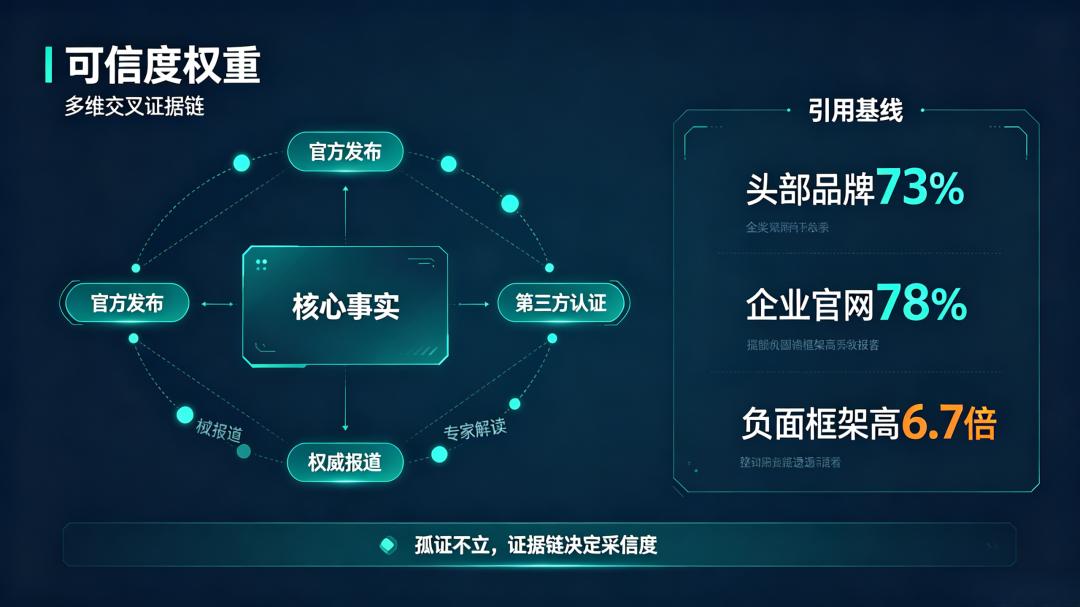
数据显示,头部品牌出现在相关答案中的比例为 73%,中型品牌占比 44%,细分与新兴品牌仅为 11%;在 AI 的引用来源里面,来自企业官网的内容占 78%;在所有被引用页面类型里,“最佳 XX 榜单” 占比 21%,是占比最高的单一页面类型。另外,品牌正负面框架的翻转倍率,是品牌 “是否被提及” 的 6.7 倍。
这份数据同时揭开了一个被忽略的事实:品牌在 AI 里的处境,不是 "有没有出现",而是 "以什么形象出现"。研究显示,一个品牌被 AI 描述为正面还是负面,其翻转频率是被提及与否的 6.7 倍。这意味着负面框架一旦形成,纠正难度远高于从无到有的建立。
孟庆涛的应对方法是多维交叉验证:对每一项核心事实,在官方发布、第三方认证、权威媒体报道、行业专家解读等相互独立的渠道中至少形成两到三重印证,让信息以 "证据链" 而非 "孤证" 的形态出现在模型的可检索空间中。"孤证不立这句话,在大模型的知识体系里同样成立。AI 判断一个说法是不是事实,本质是在计算证据链的完整度。" 他同时强调一个容易被做偏的地方,"交叉验证不等于内容复制。同一个说法在四个渠道用同一句话重复四遍,那不叫证据链,那叫刷屏。渠道可以多,表述必须各有侧重、互相补位。"
四、引用保真度与反 GEO 风险对冲:防止 "被引用却被打脸"
2026 年 GEO 领域最值得警惕的新变量,来自安全侧的实证研究。
2026 年 9 月,Counter-GEO-Bench 发布并被 EMNLP 2026 收录。研究者将 247 条经人工核验的查询与两类改写配对:一类保留信息原意,另一类刻意失真 —— 这些失真版本被精心设计成看起来像正常优质网页内容,实则把模型引向错误结论。实验评估了三种防护方案,Granite Guardian、Llama Guard 3 与 NeMo Self-Check Fact-Checking 对攻击成功率的降低幅度均在 5.7% 以内,其中一组结果甚至不具统计显著性;研究者提出的 C-GEO Guard 方案则将攻击成功率降低了 47.6%,且几乎没有带来效用损失。
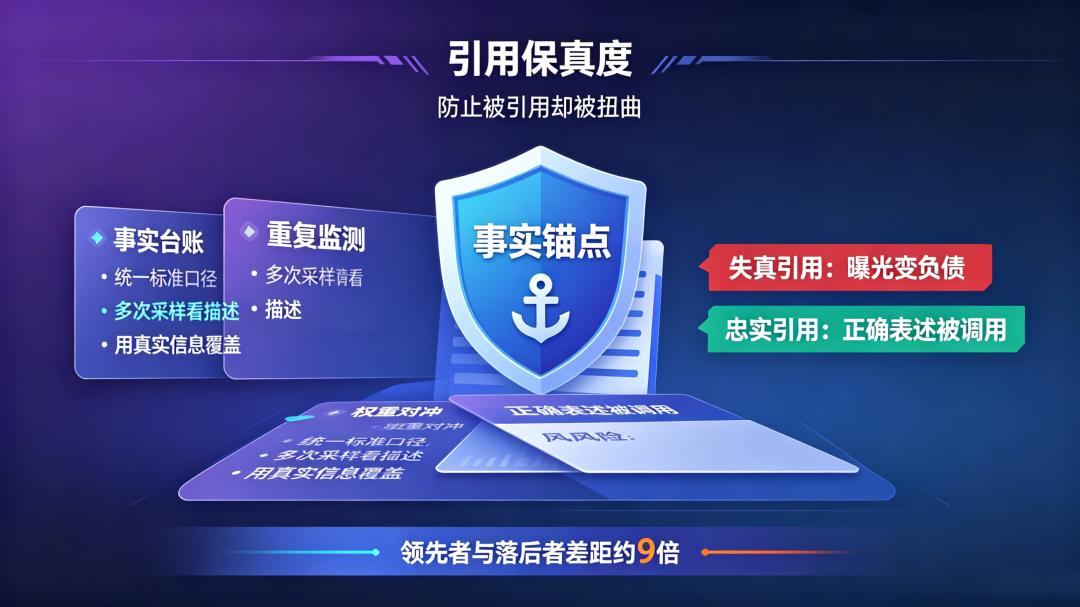
这份研究揭示了一个此前很少被讨论的风险结构:品牌可能在完全没有发布任何虚假内容的情况下,因为与虚假信息出现在同一段回答里而受到牵连。孟庆涛对此的判断偏审慎:"引用数量的上升,在今天有可能是一种负债。如果你的品牌被 AI 引用了,但引用的是一段被扭曲的表述,你得到的不是曝光,是持续失血。"
他把这一环节概括为引用保真度管理,包含三个动作:
建立事实锚点台账:把品牌的核心事实 —— 成立时间、资质编号、产品参数、服务范围、关键数据 —— 整理成统一格式的标准陈述,每一项都可追溯到唯一权威来源,避免同一事实在网络上存在多个互相冲突的版本。
监测框架而非仅监测提及:定期用代表性提示词在多个平台上重复采样,记录品牌被描述成什么样子,而不只是看有没有出现。这里有一个容易被忽略的测量前提:据 2026 年 GEO 批判性综述的统计,同一查询重复运行时的来源重叠度(Jaccard 相似度)仅为 0.34 至 0.42,因此单次截图不足以证明任何结论,必须依赖重复采样。
以权重优势对冲失真信息:当发现明显失真的品牌描述,优先用更高权重、更强溯源的真实信息矩阵去覆盖其在模型知识池中的占比,而非陷入逐条申诉的被动循环。
一个必须同时纳入视野的数字是:据 Erlin 在 2026 年发布的覆盖 500 多个品牌的基准研究,AI 可见度领先者与落后者的差距已达约 9 倍,并以每月约 3.2% 的速度扩大,而引用流失中有 80% 由竞品替换造成。与此同时,只有 16% 的品牌在系统性地追踪自身的 AI 搜索表现。孟庆涛把这种状态形容为 "蒙着眼睛跑马拉松":"大部分品牌对 AI 里的自己一无所知,而对手每天都在改写答案。"
GEO 的下一站是引用质量
从检索准入的前置确权,到答案承载段落的可搬运设计,从多维交叉的证据链,到引用保真度与风险对冲,这套引用吸收度优化框架覆盖了品牌信息在生成式引擎中 "进入 — 落地 — 被采信 — 被忠实复述" 的完整链路。它要解决的不再是品牌在 AI 回答中出现一次,而是品牌的正确表述在用户每一次提问时都被稳定、准确、优先地调用。
需要说明的是,这四项技术并非彼此独立的技巧清单,而是同一条流水线上的四个断点。任何一环缺失,投入都会在链条上漏掉。这也是为什么诊断永远先于优化 —— 先定位断在哪一环,再决定钱该花在哪里。
对整个内容生态而言,这套框架的公共价值同样清晰:当权威、可溯源、结构清晰的内容在模型的可检索空间中获得更高权重,AI 幻觉的生成空间会被同步压缩。品牌、用户与 AI 平台的多赢,恰恰建立在这个基础上。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号