课前准备--蛋白蛋白分子对接的位点搜索逻辑(二)
原创
课前准备--蛋白蛋白分子对接的位点搜索逻辑(二)
原创
追风少年i
发布于 2026-09-17 08:52:47
发布于 2026-09-17 08:52:47
作者,Evil Genius
这一篇我们需要分析另一个问题,如果的蛋白蛋白对接构象发生了变化 一些藏在内部的氨基酸暴漏了出来参与了对接 这种情况该怎么计算。
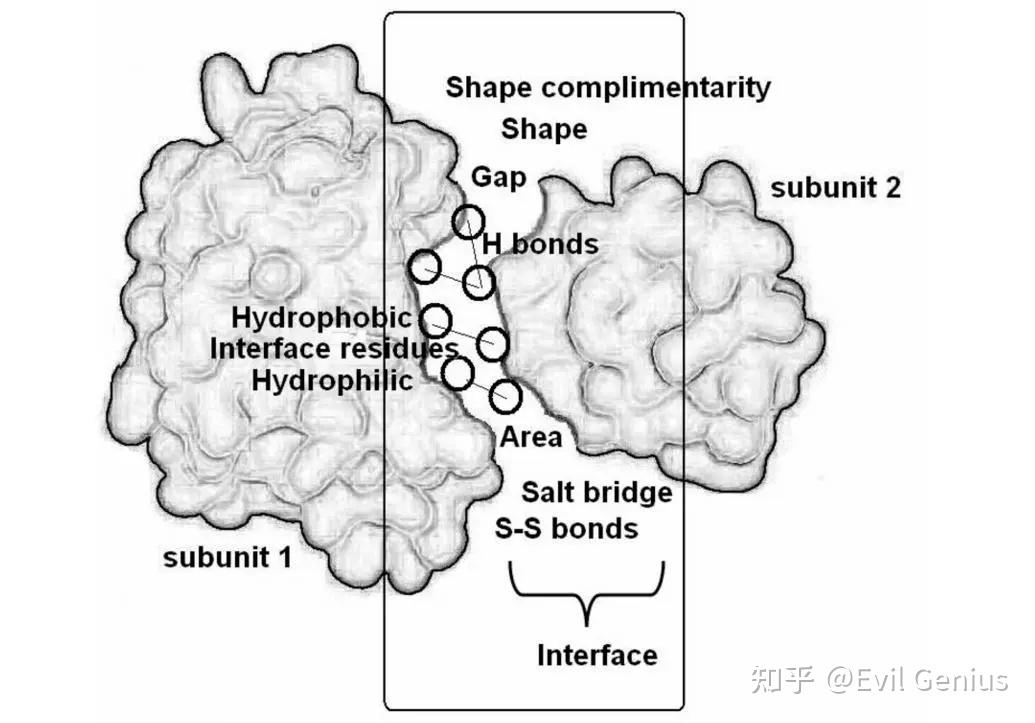
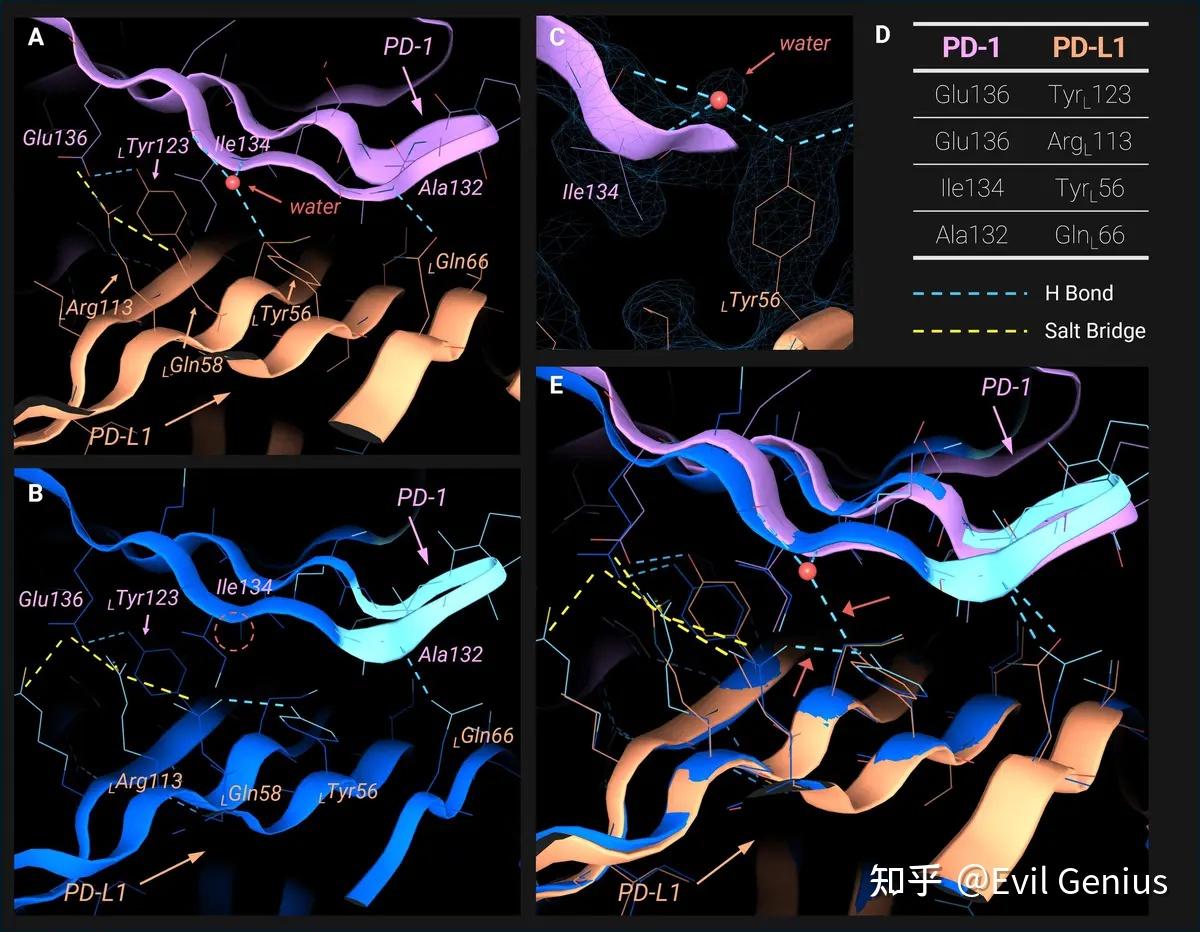
这种情况实际上是蛋白–蛋白诱导契合(induced fit)/构象选择(conformational selection)问题。此时不能简单把两个静态 PDB 做一次 rigid-body docking,因为“内部残基暴露出来后参与界面”正是传统刚体对接容易漏掉的情况。
核心思路是:
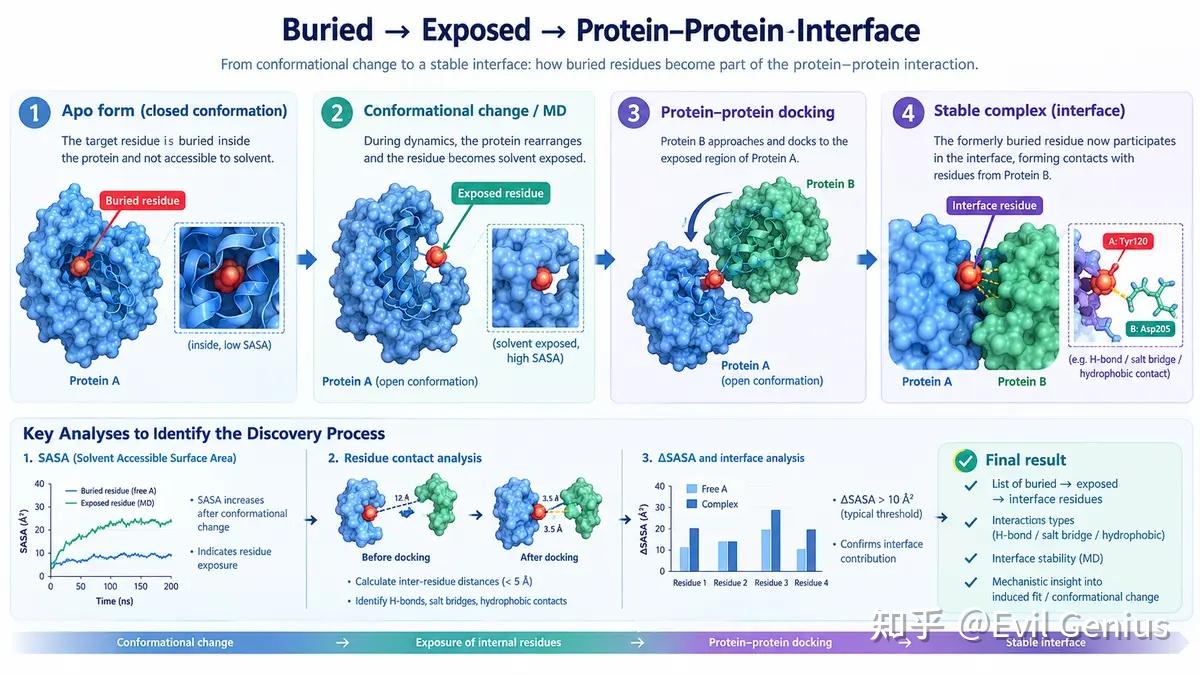
先产生蛋白的不同构象 → 找到暴露状态 → 对不同构象分别进行 PPI docking → 比较界面 → 用 MD 验证结合过程中是否发生内部残基暴露和界面形成。
1. 先解释蛋白蛋白对接的诱导契合
例如蛋白 A 初始状态:
Protein A

        ┌──────────────────┐
        │                  │
        │     XXXXX        │
        │    XXXXXXX       │
        │   XXX ● XXX      │
        │    XXXXXXX       │
        │     XXXXX        │
        │                  │
        └──────────────────┘
              ↑
          内部残基
残基 ● 原来被其他残基包围,SASA 很低,甚至接近 0。
发生构象变化以后:
Protein A

        ┌──────────────────┐
        │                  │
        │                  │
        │          ●───────┼──── Protein B
        │                  │
        │                  │
        └──────────────────┘
                   ↑
              新暴露残基
这个时候 ● 可能变成:
- solvent accessible
- 可以与 Protein B 接触
- 形成 H-bond
- salt bridge
- hydrophobic interaction
- van der Waals interaction
这就是需要重点计算的东西。
2. 第一件事不是 docking,而是“构象采样”
如果只有:
A.pdb
B.pdb
不要直接:
A + B → docking而应该:
A
│
├── conformation 1
├── conformation 2
├── conformation 3
├── conformation 4
├── ...
└── conformation N
然后 Protein B 也可以有多个构象:
B
│
├── B1
├── B2
├── B3
└── ...
于是实际上变成:
A1 ──┐
A2 ──┤
A3 ──┤
A4 ──┼── Protein–Protein docking
...  │
An ──┘这就是比较合理的ensemble docking(集合对接)。
3. 怎么获得这些“内部残基暴露”的构象?
最常用的方法就是:
MD simulation
例如:
初始结构
   ↓
Energy minimization
   ↓
NVT
   ↓
NPT
   ↓
Production MD
   ↓
获得 1000s–100000s snapshots
例如:
MD trajectory

Frame 1       Frame 500       Frame 1000       Frame 2000
   │              │               │                │
   ↓              ↓               ↓                ↓

 buried         buried          exposed          exposed
于是可以从 MD trajectory 中找到:
“这个残基什么时候从 buried 变成 exposed?”
4. 最关键的指标:SASA
最推荐首先计算:
SASA = Solvent Accessible Surface Area
例如残基:
A:TYR120MD 前:
SASA = 2.1 ŲMD 后:
SASA = 18.7 Ų那么说明:
Tyr120 周围的蛋白构象发生变化,使其逐渐暴露于溶剂。
可以进一步定义:
SASA(t)画成:
SASA
 ↑
 │                    ______
 │                  /
 │                /
 │______________/
 │
 └────────────────────────→ time
                  ↑
              residue exposed
这个非常适合证明“内部残基暴露”。
5. 但是仅仅 SASA 增加还不够
这是一个非常重要的地方。
假设:
Tyr120

SASA:
2 Ų → 20 Ų
只能说明:
Tyr120 暴露了。
但是不能说明:
Tyr120 参与了蛋白–蛋白结合。
所以还需要第二层分析。
6. 第二层:Residue contact
假设 Protein B 中:
Asp205
Glu207
Tyr210
那么可以计算:
A:Tyr120 ↔ B:Asp205
A:Tyr120 ↔ B:Glu207
A:Tyr120 ↔ B:Tyr210
例如定义:
heavy atom distance < 4–5 Å
作为接触。
那么:
Frame 1

A:Tyr120
     │
     │ 12 Å
     │
B:Asp205


Frame 500

A:Tyr120
     │
     │ 4.1 Å
     │
B:Asp205
这就说明:
Tyr120 在构象变化以后进入 Protein–Protein interface。
7. 最好再计算 ΔSASA
这是分析 PPI interface 非常有用的指标。
定义:
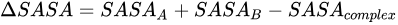
如果某个残基在:
free protein状态下:
SASA = 30 Ų结合以后:
SASA = 5 Ų说明:
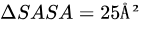
即这个残基有相当一部分表面积被另一个蛋白遮挡。
8. 实际上应该分成两个过程
这是最容易混淆的地方。
阶段 A:构象变化
A_closed
   ↓
A_open
内部残基:
buried
 ↓
exposed
然后:
阶段 B:蛋白–蛋白结合
A_open + B
      ↓
A_open:B
这个过程中:
exposed residue
      ↓
interface residue
所以完整过程是:
MD
              ↓
      ┌───────────────┐
      │ A closed      │
      │ buried residue│
      └───────┬───────┘
              ↓
        conformational
            change
              ↓
      ┌───────────────┐
      │ A open        │
      │ exposed       │
      └───────┬───────┘
              ↓
         PPI docking
              ↓
      ┌───────────────┐
      │ A:B complex   │
      │ interface     │
      └───────┬───────┘
              ↓
             MD
              ↓
       interface stable?
9. 所以不要只做一次 docking
如果直接:
A_closed + B
       ↓
    docking
程序可能根本找不到这个 interface。
因为:
A_closed 状态下,这个残基被埋在蛋白内部。
更合理的是:
A trajectory
      ↓
cluster
      ↓
A1 A2 A3 A4 A5
      ↓
ensemble docking
      ↓
B
例如:
A构象 | 内部残基暴露程度 | Docking结果 |
|---|---|---|
A1 | 低 | 无合理interface |
A2 | 低 | 无合理interface |
A3 | 中 | 弱interface |
A4 | 高 | 强interface |
A5 | 高 | 强interface |
这就非常有意义了。
10. 还可以做“残基暴露概率”
比如对 MD 的 10,000 个 frame:
Tyr120

buried   7000 frames
exposed  3000 frames
那么:
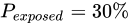
再进一步:
Tyr120

exposed probability = 30%

             ↓

参与 interface probability = 25%
那么可以说:
Tyr120 是一个具有构象依赖性的潜在 interface residue。
这个分析比单独看一张 docking 图强很多。
11. 如果已经有蛋白–蛋白复合物结构,分析会更直接
如果已经获得:
A:B complex那么可以比较:
A_free
     vs
A_complex
重点计算:
① SASA
A_free → A_complex② residue depth
判断残基原来是不是内部残基。
③ contact number
A residue
   ↓
与多少个 B residue 接触
④ interface ΔSASA
判断该残基是否真正成为 interface residue。
⑤ H-bond / salt bridge
例如:
A:Lys120 ───── B:Asp205⑥ distance
例如:
A:TYR120 —— B:ASP205
          3.4 Å
12. 如果是“真正的 induced fit”,还需要更进一步
如果想研究:
蛋白 A 在接近蛋白 B 的过程中,B 诱导 A 打开,使内部残基暴露,然后形成 interface。
那么单纯:
MD(A) → docking(A_open+B)
仍然是近似。
更完整的方法是:
A + B
 ↓
protein-protein docking
 ↓
多个候选 encounter complexes
 ↓
MD
 ↓
观察:
A是否打开?
↓
内部残基是否暴露?
↓
是否形成新的 interface?
↓
interface是否稳定?
也就是说:
Docking 负责寻找可能的结合模式,MD 负责观察结合以后构象是否能够自洽地发生变化。
13. 对这种问题,推荐的计算路线
Protein A
                    │
                    ▼
              Initial MD
                    │
                    ▼
          Trajectory clustering
                    │
          ┌─────────┼─────────┐
          ↓         ↓         ↓
         A1        A2        A3 ...
          │         │         │
          └─────────┼─────────┘
                    ↓
            Ensemble docking
                    +
                Protein B
                    ↓
             docking poses
                    ↓
               clustering
                    ↓
          candidate interfaces
                    ↓
          ┌─────────┴─────────┐
          ↓                   ↓
       SASA变化           interface contacts
          ↓                   ↓
       residue exposed → residue participates
                    ↓
               MD complex
                    ↓
        interface stability analysis
                    ↓
        H-bond / salt bridge /
        RMSD / RMSF / SASA /
        contact occupancy
                    ↓
              最终机制
14. 如果目标是“找出那些原来埋藏、后来参与 PPI 的氨基酸”,可以直接建立这样的判定逻辑
定义三个条件:
条件 1:原始状态 buried
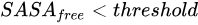
↓
条件 2:构象变化后 exposed
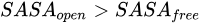
↓
条件 3:复合物中形成 interface
例如:
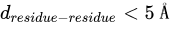
并且最好有:
- H-bond
- salt bridge
- hydrophobic contact
- ΔSASA
- contact occupancy
那么:
buried → exposed → interface
这类残基才是真正想找的构象变化驱动型 interface residues。
生活很好,有你更好。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号