告别东拼西凑!MedCortex科研论文系统全景解剖:从Idea到发表的全流程Agent革命
原创
告别东拼西凑!MedCortex科研论文系统全景解剖:从Idea到发表的全流程Agent革命
原创
用户7200114
发布于 2026-09-16 12:03:45
发布于 2026-09-16 12:03:45
告别东拼西凑!MedCortex科研论文系统全景解剖:从Idea到发表的全流程Agent革命
导读:在生物医学科研界,许多硕博研究生和临床医生都经历过这样的时刻——面对几万行的临床或生信数据,不知道该定什么创新选题;好不容易定了个方向,R语言代码跑起来全是红字报错;图表画得简陋被审稿人痛批;写论文时翻烂PubMed找不到真实文献,EndNote排版改到凌晨三点……
今天,我们将带你逐帧拆解MedCortex(生物医学引导式科研论文系统)的官方产品演示。这绝不是一个简单的“套壳聊天框”,而是一套专为生物医学学者打造的桌面级AI引导式科研流水线。正如演示开篇那句震撼人心的宣言:“让你一个人,也能跑出一篇顶级SCI。”
💡 本期核心拆解看点:
- 端到端六步全贯通:从原始数据导入到期刊直投三件套,各环节输入输出全透明;
- 一份数据多选题并行:打破传统单线作业,同一份大样本数据同时推进3篇独立论文;
- R/Python真跑真落盘:告别伪代码幻觉,真实终端计算C-index,直接落盘投稿级图表;
- 学术合规零妥协:CSL引擎智能排版,每一条引文都经过PMID实地真伪校验;
- 横切六大硬核矩阵:深度调研、三方审稿团辩论、245+ R包知识库、手机遥控与定时任务。
01. 颠覆性定位:写代码是工具,写论文是系统工程
很多科研人第一次听说“AI写论文”,第一反应往往是怀疑甚至排斥:通用的ChatGPT、Claude或者编程助手写写通用网页代码还可以,但怎么可能搞定极其严密、容不得半点造假的生物医学科研?
通用大模型经常一本正经地胡说八道、编造根本不存在的假PMID文献、写出来的R代码经常缺失依赖库报错,更不懂什么是倾向性评分匹配(PSM)、什么是竞争风险模型、什么是CONSORT规范。
我们先来看演示视频正式开启时的这一张产品全景封面:
大家注意看屏幕正中央这一行字:“从数据探索到论文投稿 —— 桌面级 AI 引导式科研工作流 · 让你一个人也能跑出一篇 SCI”。
在下方还清晰标定了这套系统的基石:选题 · 文献 · 分析 · 写作 · 投稿 · PPT,整整六步核心环节与六项横切能力的一站式贯通。
为什么MedCortex能够敢于承诺贯穿科研全流程?秘密就在于它对科研本质的洞察——写代码仅仅是工具,而产出一篇严谨的医学论文,是一个环环相扣的系统工程!
为了让大家一眼看清通用编程Agent与MedCortex的本质鸿沟,我们先来看演示中给出的这份重量级深度对比:
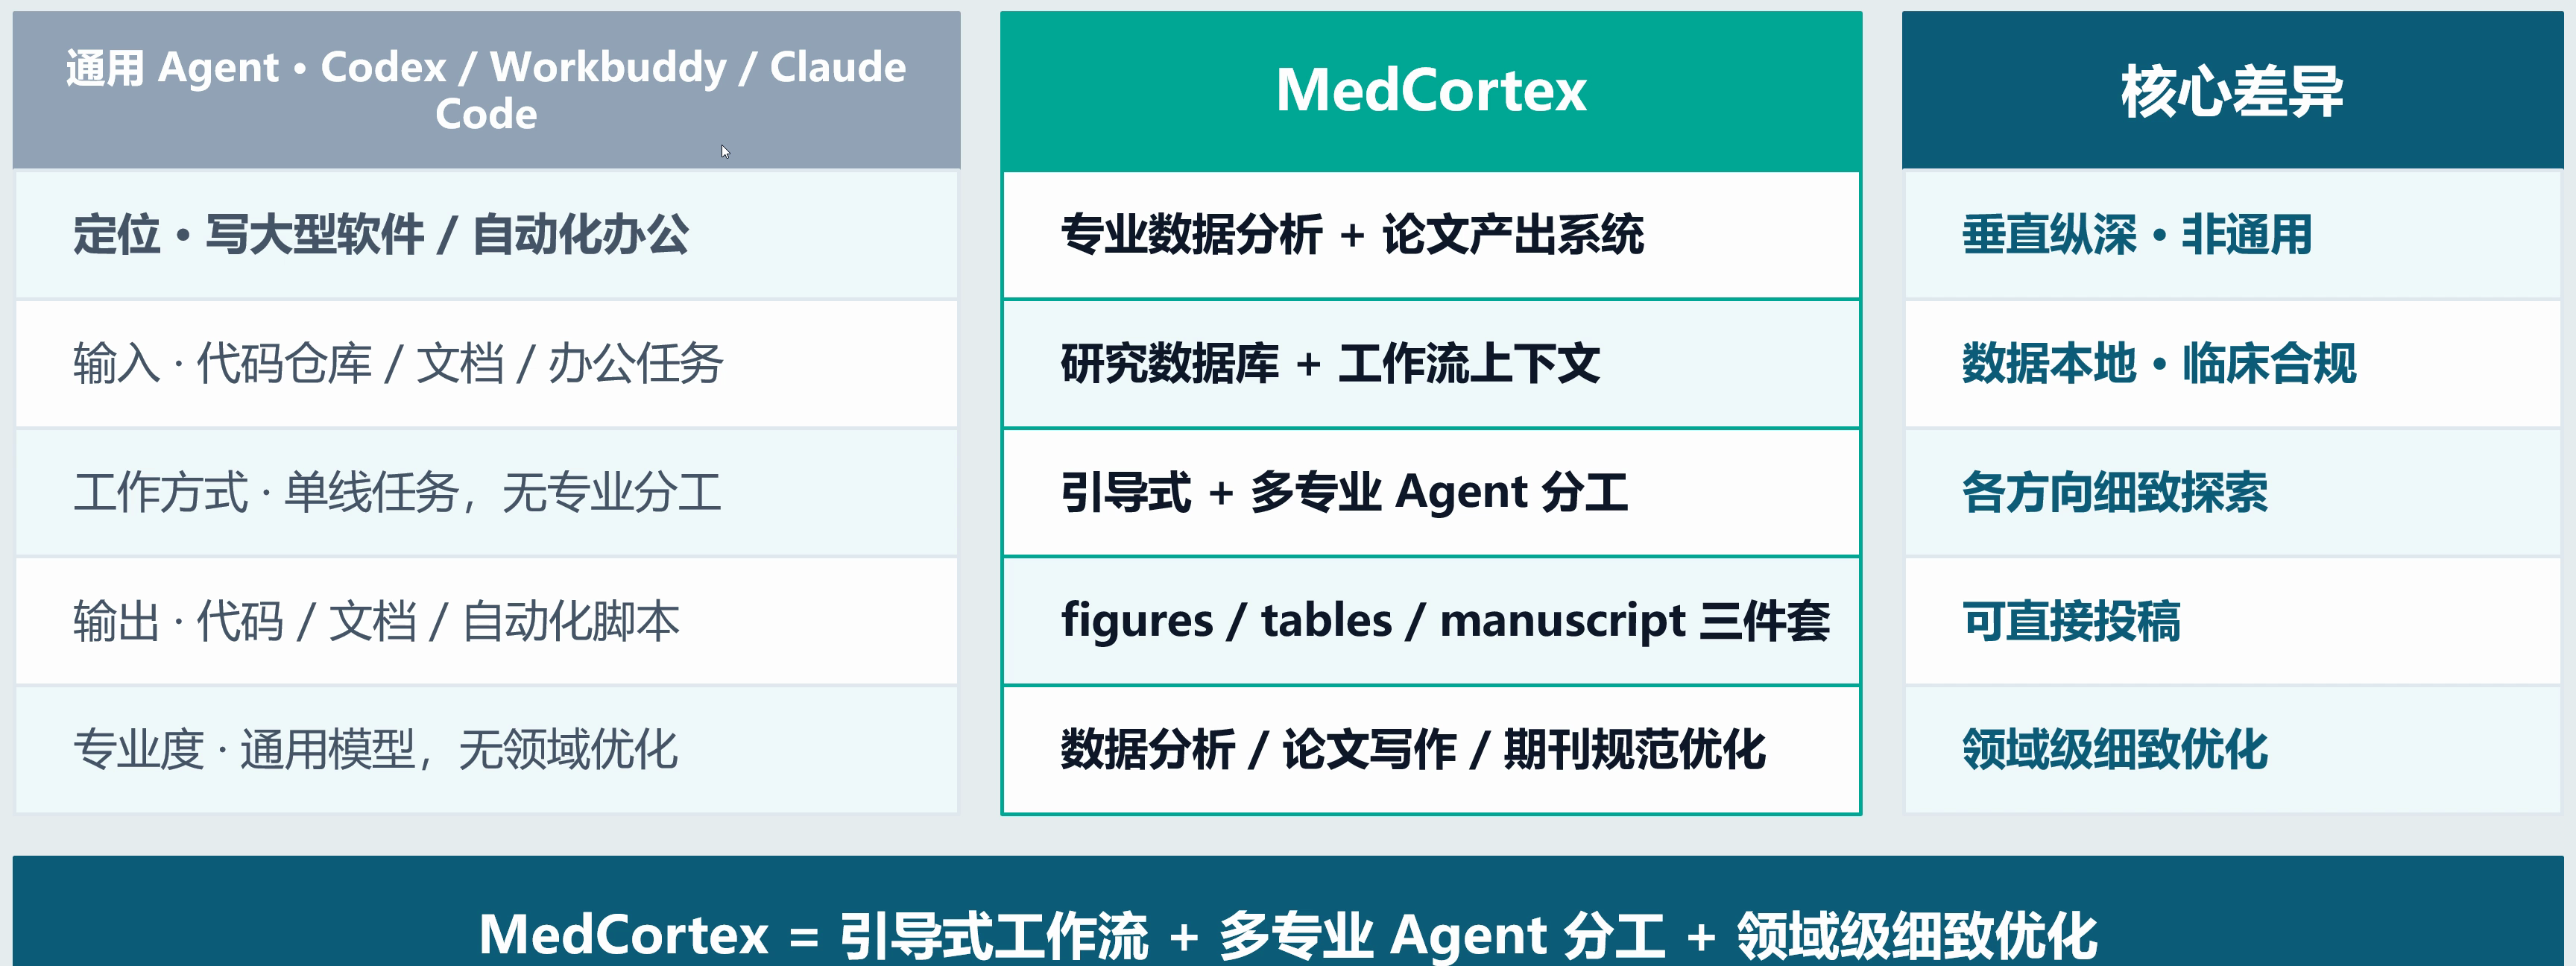
大家仔细观察这张对比表中的五大维度:
- 定位维度:通用Agent定位在编写大型软件工程或自动化办公,而MedCortex是垂直纵深的数据分析与论文产出系统;
- 输入维度:通用工具接收的是代码仓库或纯文档,而MedCortex输入的是研究数据库(如SEER、NHANES、TCGA、GEO)与工作流上下文,并且所有原始数据纯本地计算,严格保障临床数据合规隐私;
- 工作方式:通用工具是单线推进、缺乏专业医学分工,而MedCortex引入了引导式交互与多专业Agent角色分工;
- 输出产物:通用工具只能丢给你控制台代码片段,而MedCortex最终交付的是可直接投稿期刊的Figures、Tables与完整Manuscript手稿三件套;
- 专业深度:通用模型没有任何医学领域优化,而MedCortex在数据统计、论文写作规范与期刊指南上做了极深度的领域优化。
我们把这个架构精髓提炼成了一张直观的对比示意图:
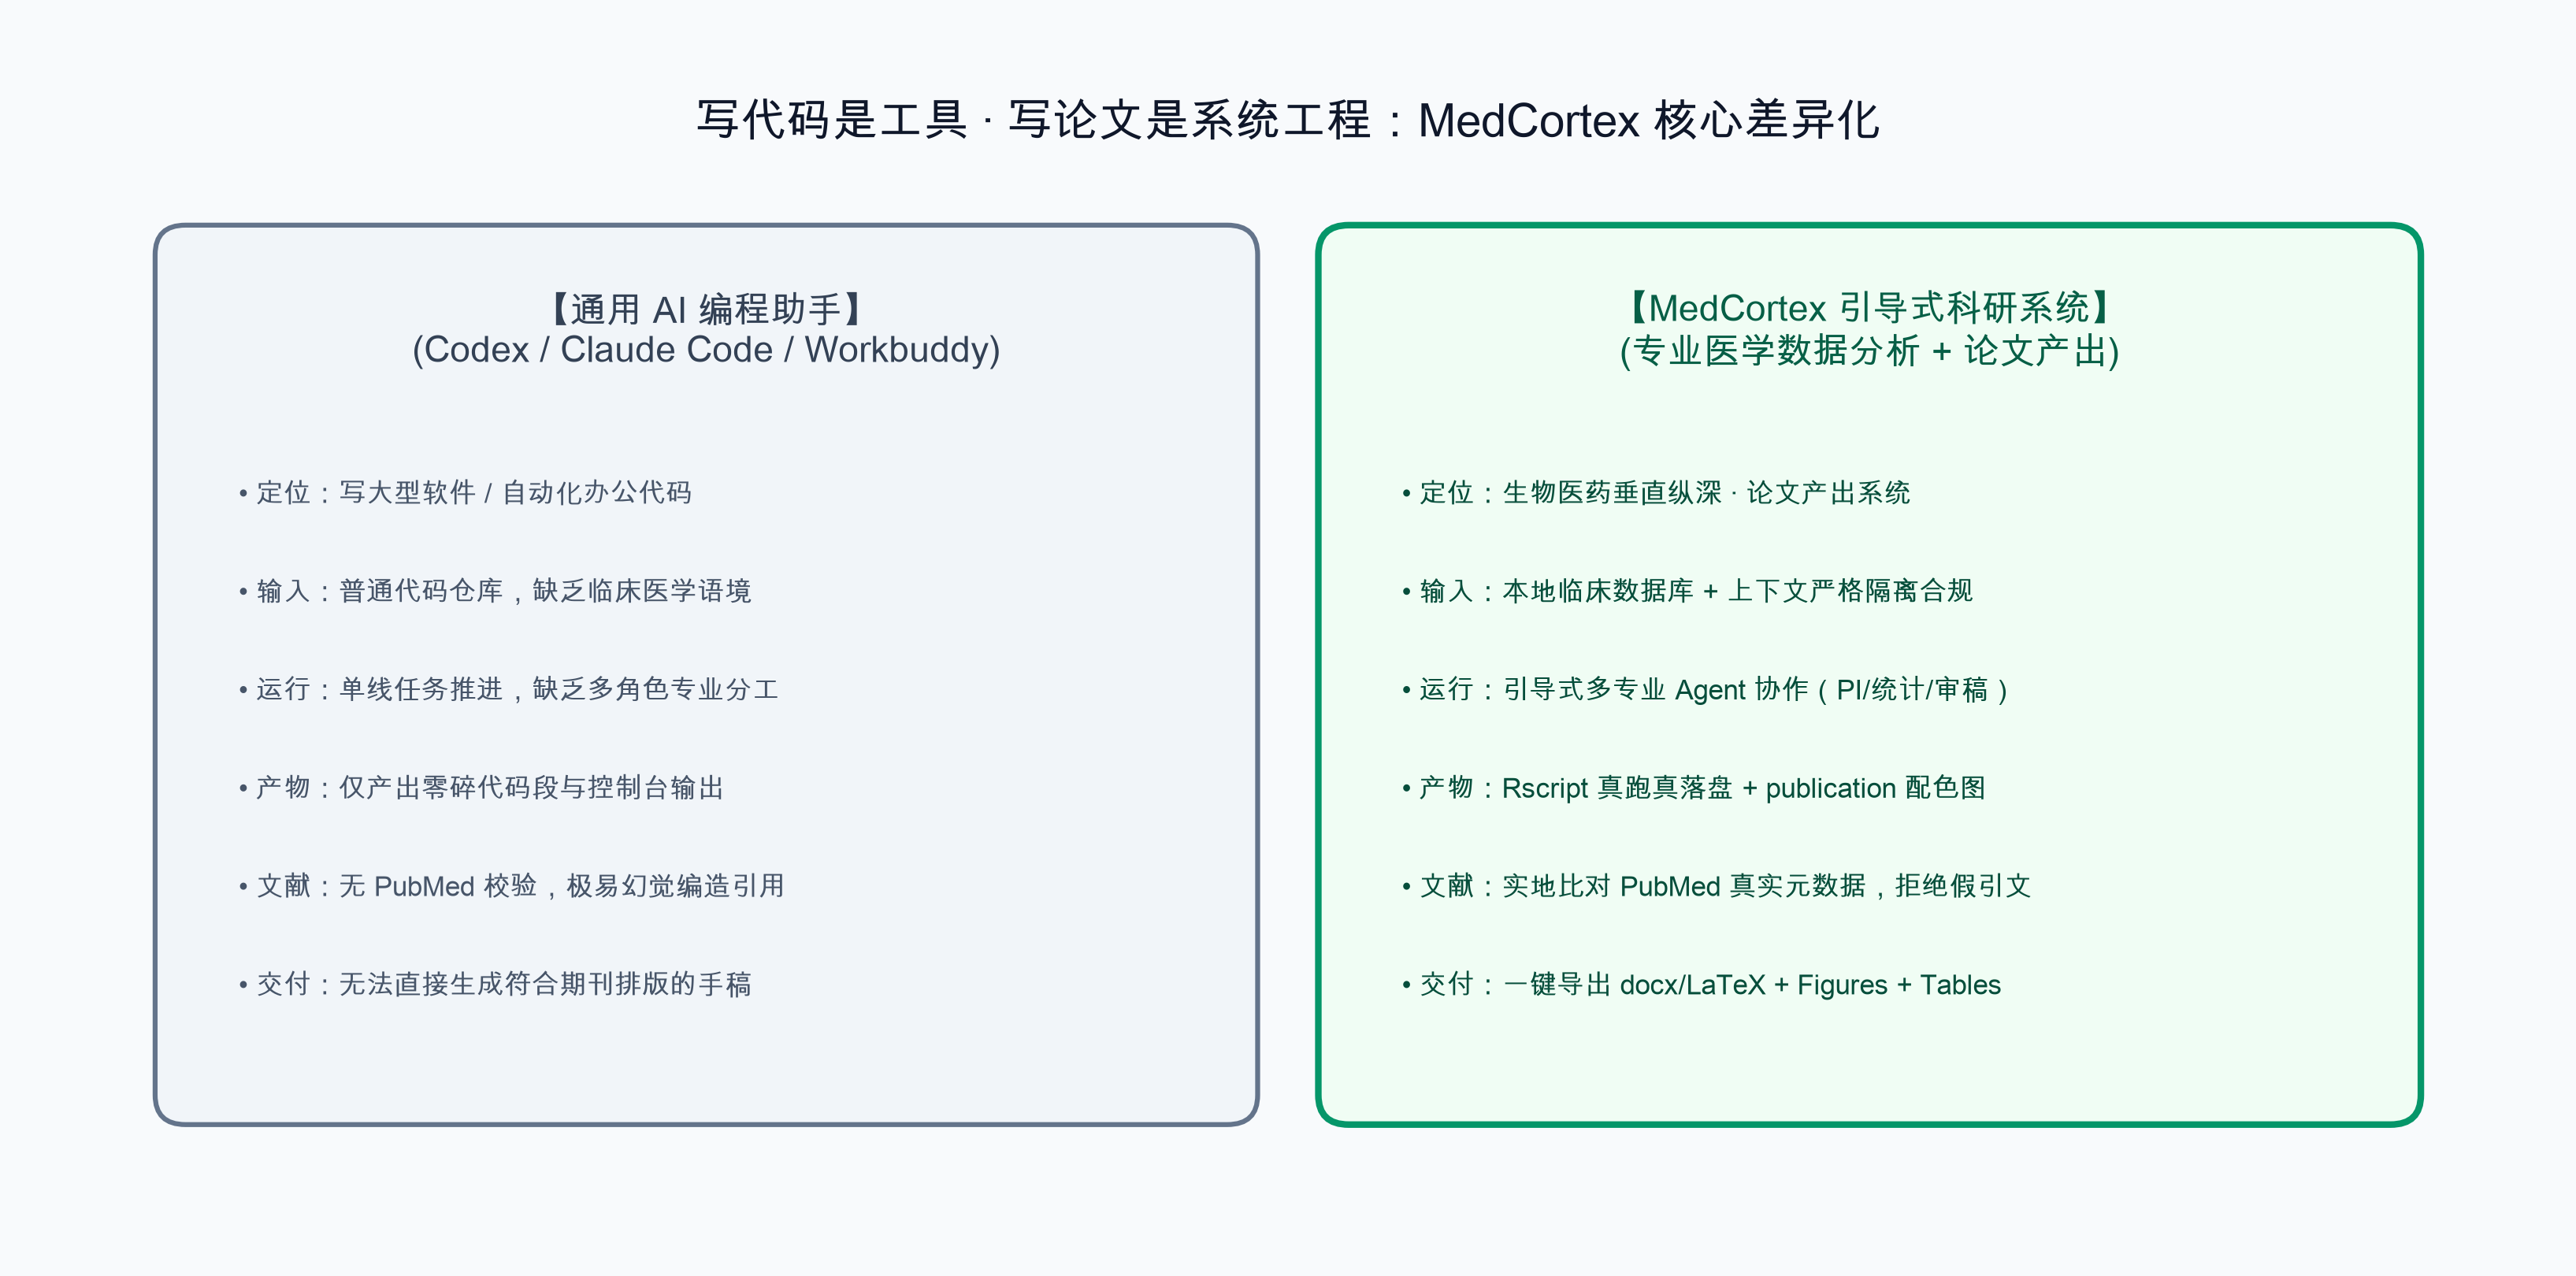
正如总结公式所言:MedCortex = 引导式工作流 + 多专业 Agent 分工 + 领域级细致优化。搞清楚了这个底层逻辑,我们再来看它是如何在实战中跑通每一个环节的。
02. 一张图看清全流程:6步端到端标准化流水线
在很多课题组里,研究生的科研状态往往是割裂的:开题时在知网/PubMed乱搜两周,拿到数据后用Excel简单算算,找师兄要一段旧R代码改改改不通,分析出几张丑图后又卡在英文写作上,投稿前还要因为参考文献格式焦头烂额。
而MedCortex把这套繁杂痛苦的过程,重构成了工业级、标准化的六步闭环:
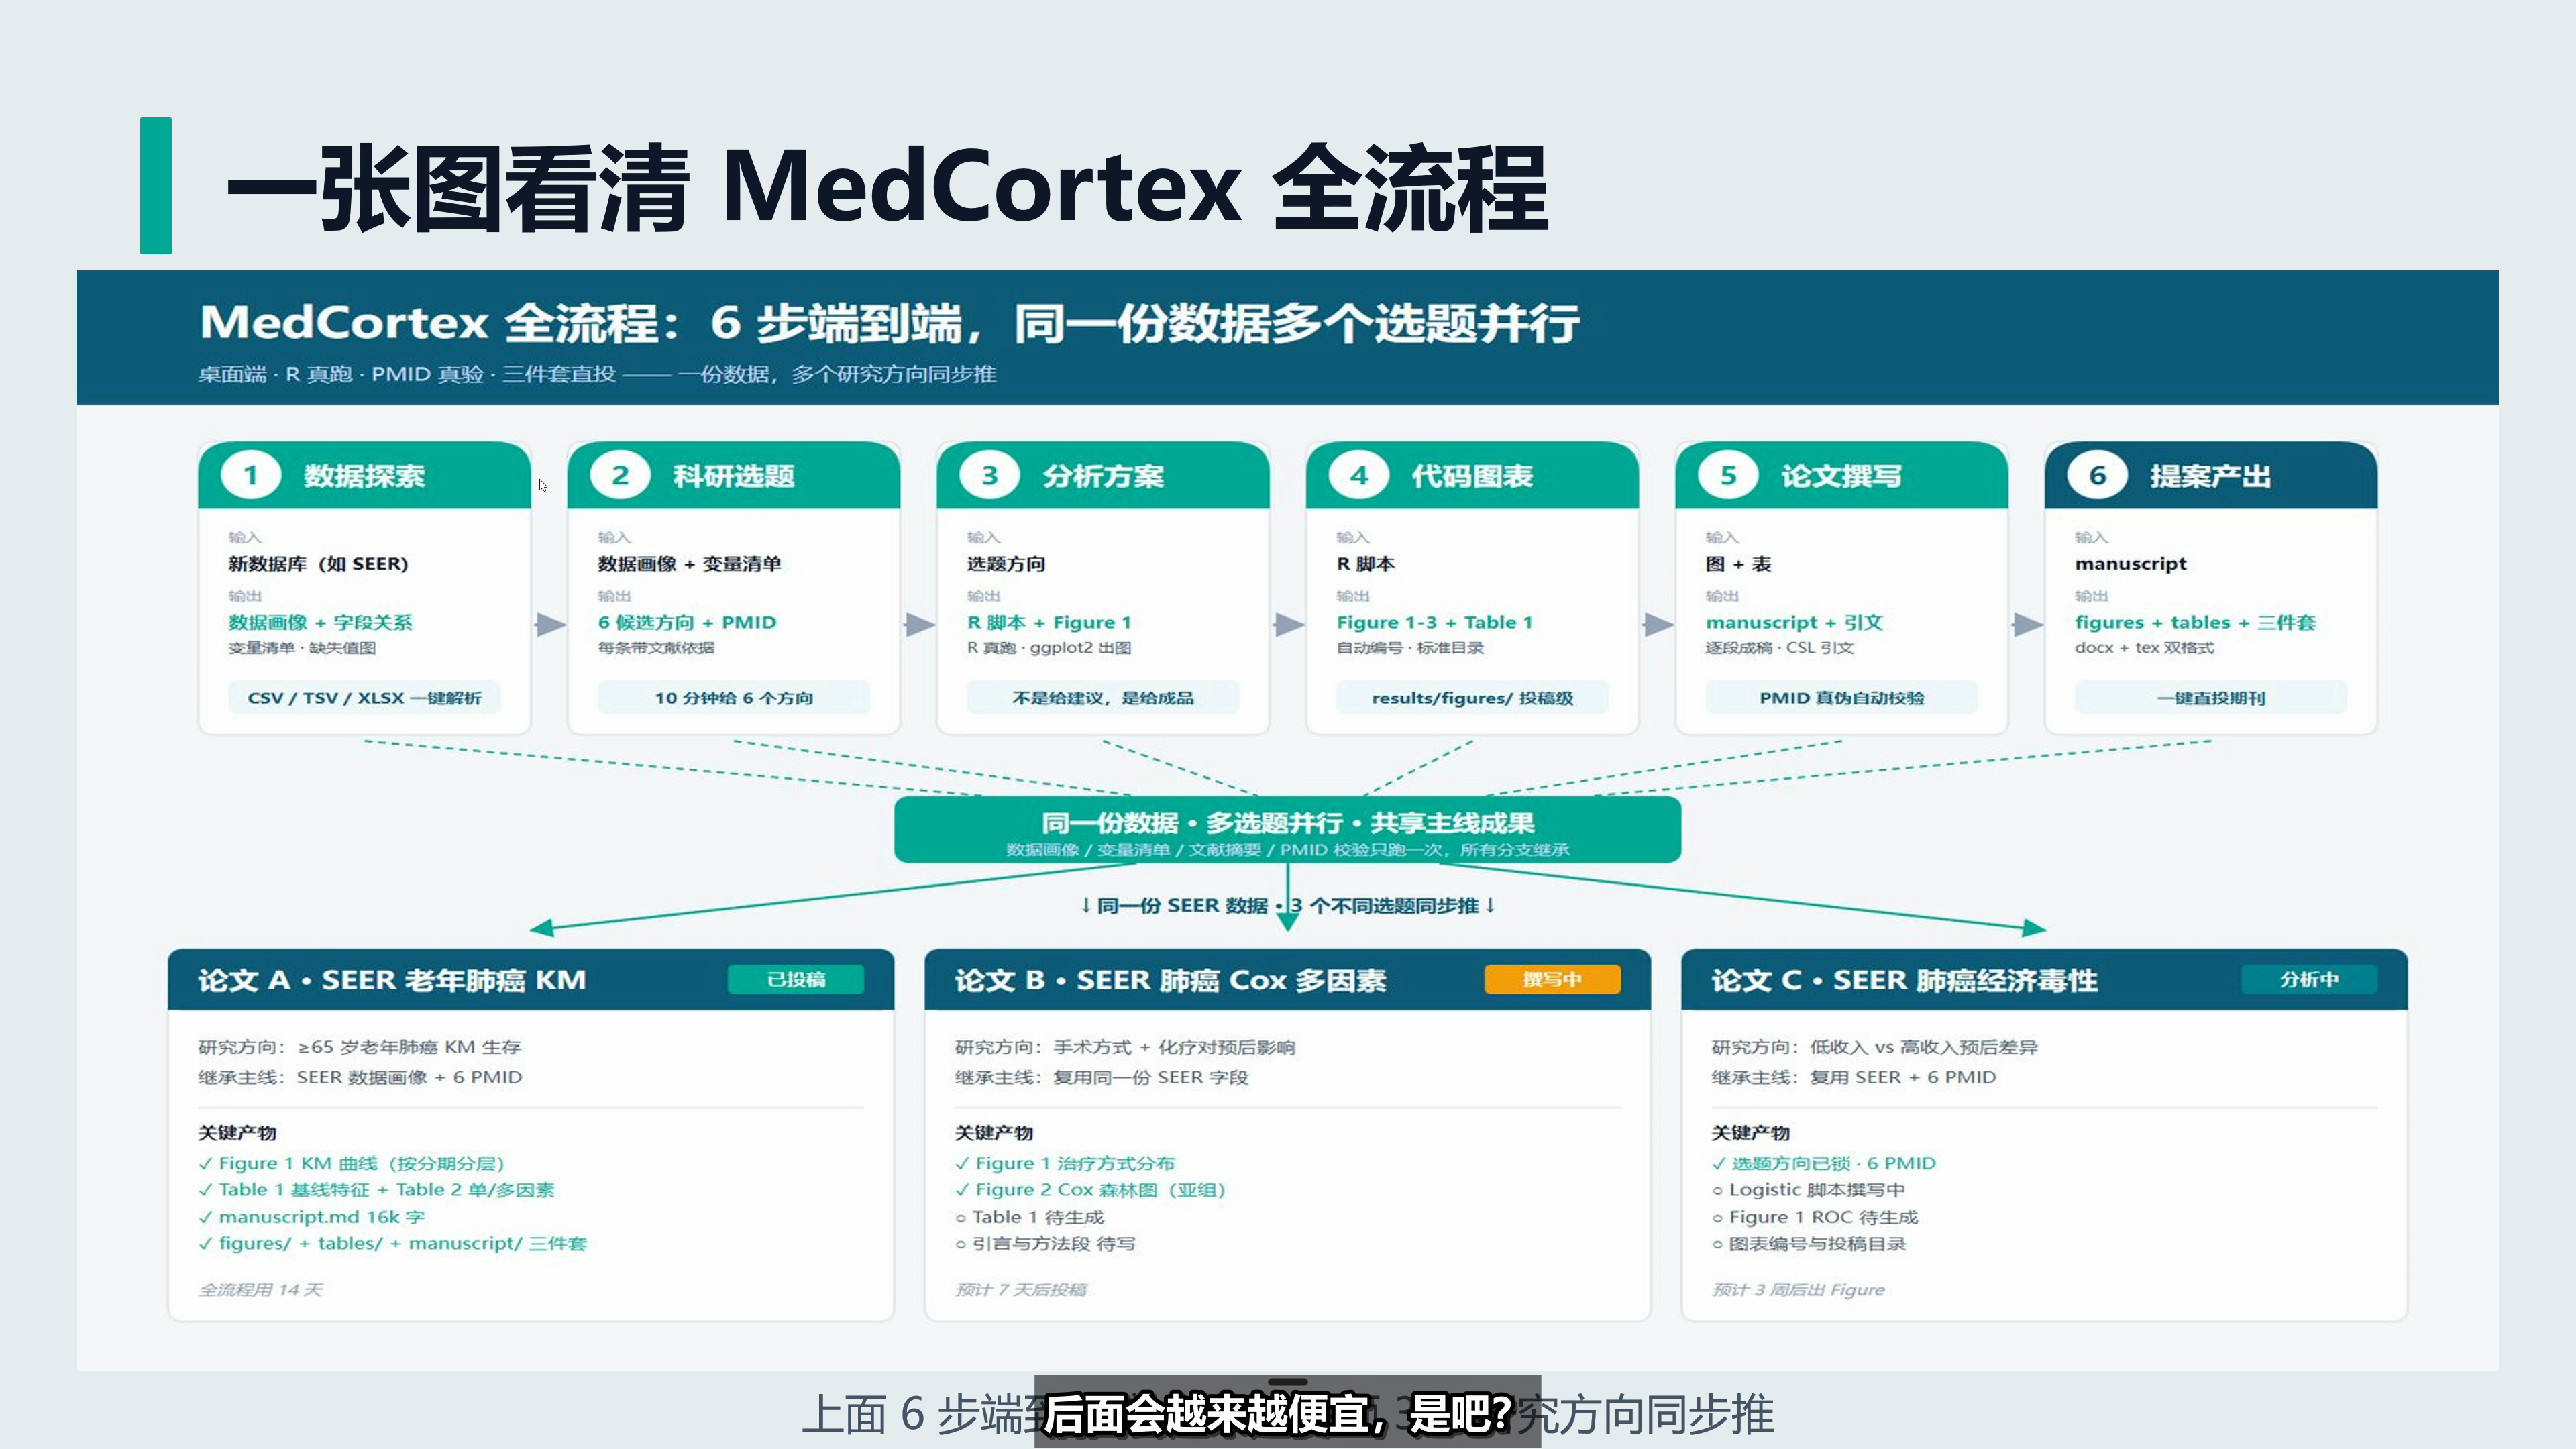
我们把上面这六个关键步骤单独放大,老师带大家一行一行读透它的每一个输入与输出:
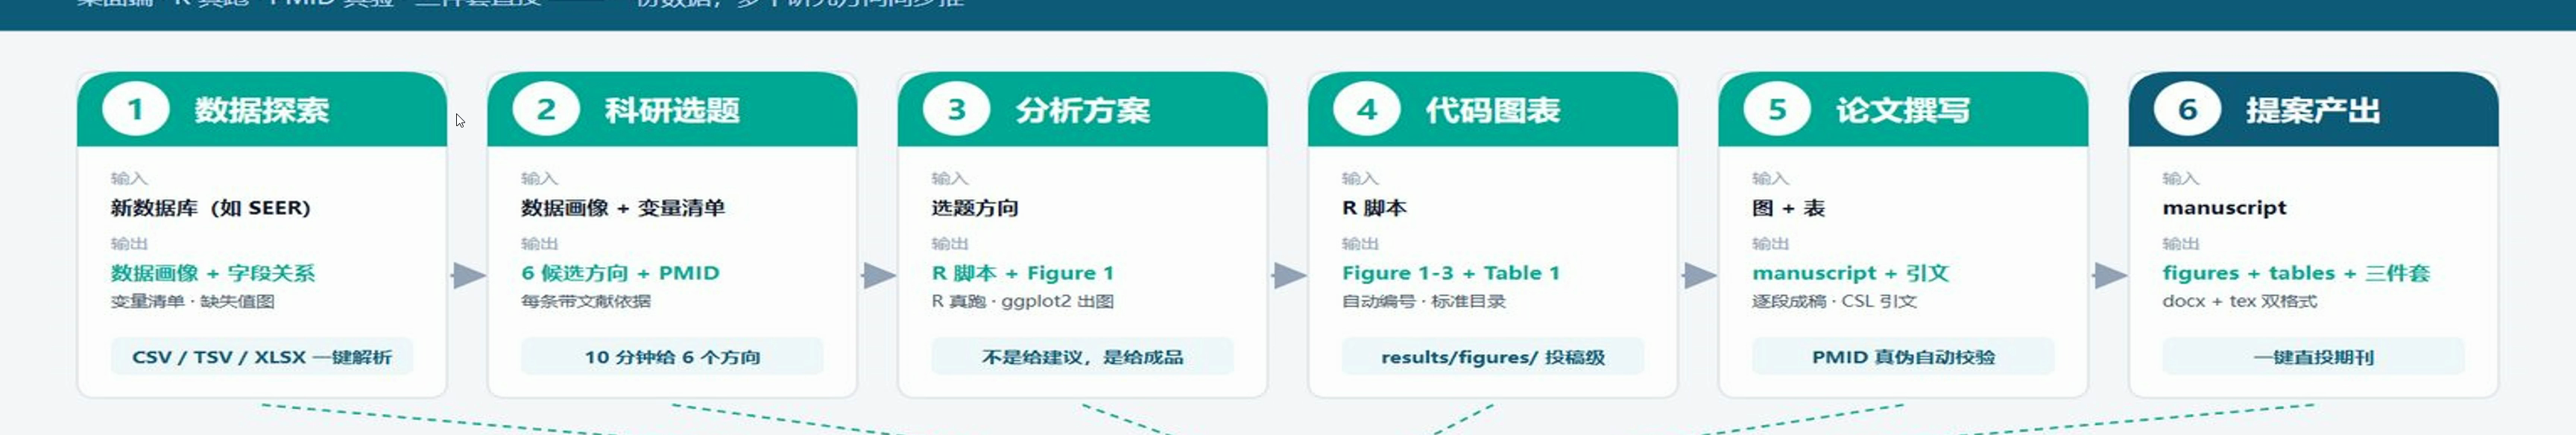
大家跟着我的引导,看这六步是如何严丝合缝衔接的:
🔍 6 步端到端流水线逐级解析:
- 第 1 步 · 数据探索:输入新数据库(支持 CSV / TSV / XLSX 一键解析,比如几十万例的 SEER 肿瘤库),系统自动生成数据画像、字段关系图、变量类型清单与缺失值分布图,数据底牌一目了然;
- 第 2 步 · 科研选题:基于上一步的数据画像与变量清单,系统在 10 分钟内给出 6 个候选研究方向,最狠的是每条方向都附带 PubMed 查新证据与创新空白评估;
- 第 3 步 · 分析方案:用户确定方向后,系统不是只给几句空洞建议,而是直接交付可执行的 R 脚本与 Figure 1 方案草图,并通过真实 R 环境真跑校验;
- 第 4 步 · 代码图表:执行分析脚本,直接产出 Figure 1~3 高清图表与 Table 1 基线特征表,全自动编号并规整存入
results/figures/投稿级目录; - 第 5 步 · 论文撰写:基于图表与统计结果,系统逐段推进成稿。内嵌 CSL 引擎自动排版,每一条参考文献都反向实地调用 PubMed 校验真实 PMID,彻底杜绝虚构文献;
- 第 6 步 · 提案产出:整合手稿与图表,一键导出 docx + LaTeX 双格式三件套,完全匹配目标期刊投稿指南。
为了帮助大家建立全局工程视角,我们用学术流程图将这 6 步标准流程的输入输出关系绘制如下:
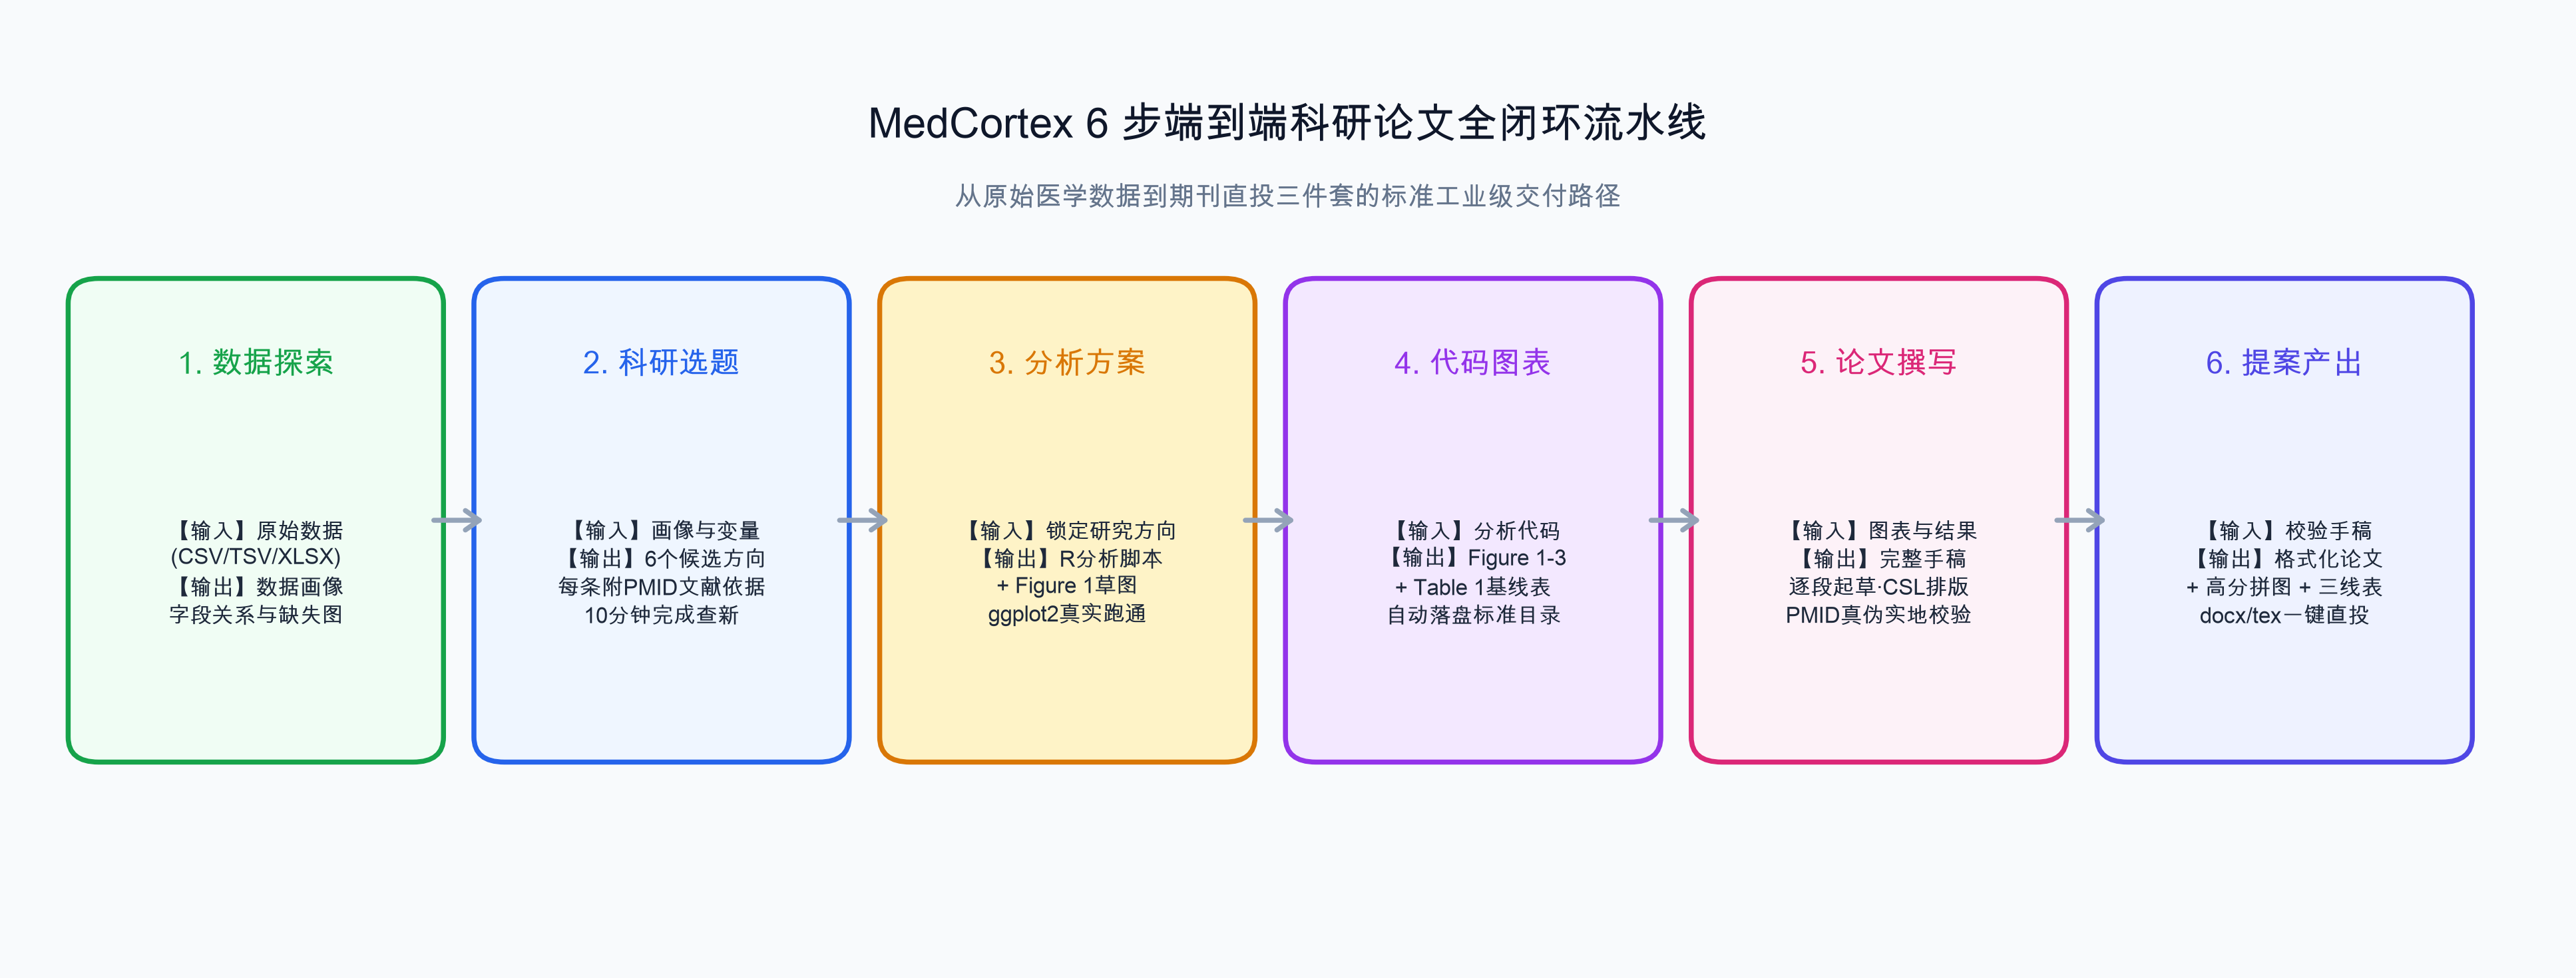
每个环节前一步的产出,就是后一步天然的输入约束。整个过程环环相扣,没有半点思维断层。
03. 核心生产力王炸:一份数据,多选题并行推进
大家在做科研时,有没有遇到过这个痛点?费了九牛二虎之力申请到了 SEER、NHANES 或者自己医院的专病队列数据,清洗了几个月,变量字典对齐了,基线指标算好了,最后却只写了一篇普通的文章,数据就被束之高阁了。
这在科研产出效率上是极大的浪费!而在 MedCortex 的设计架构中,展示了一个令人拍案叫绝的机制——“同一份数据 · 多选题并行 · 共享主线成果”!
我们来看演示画面中的下半部分特写:
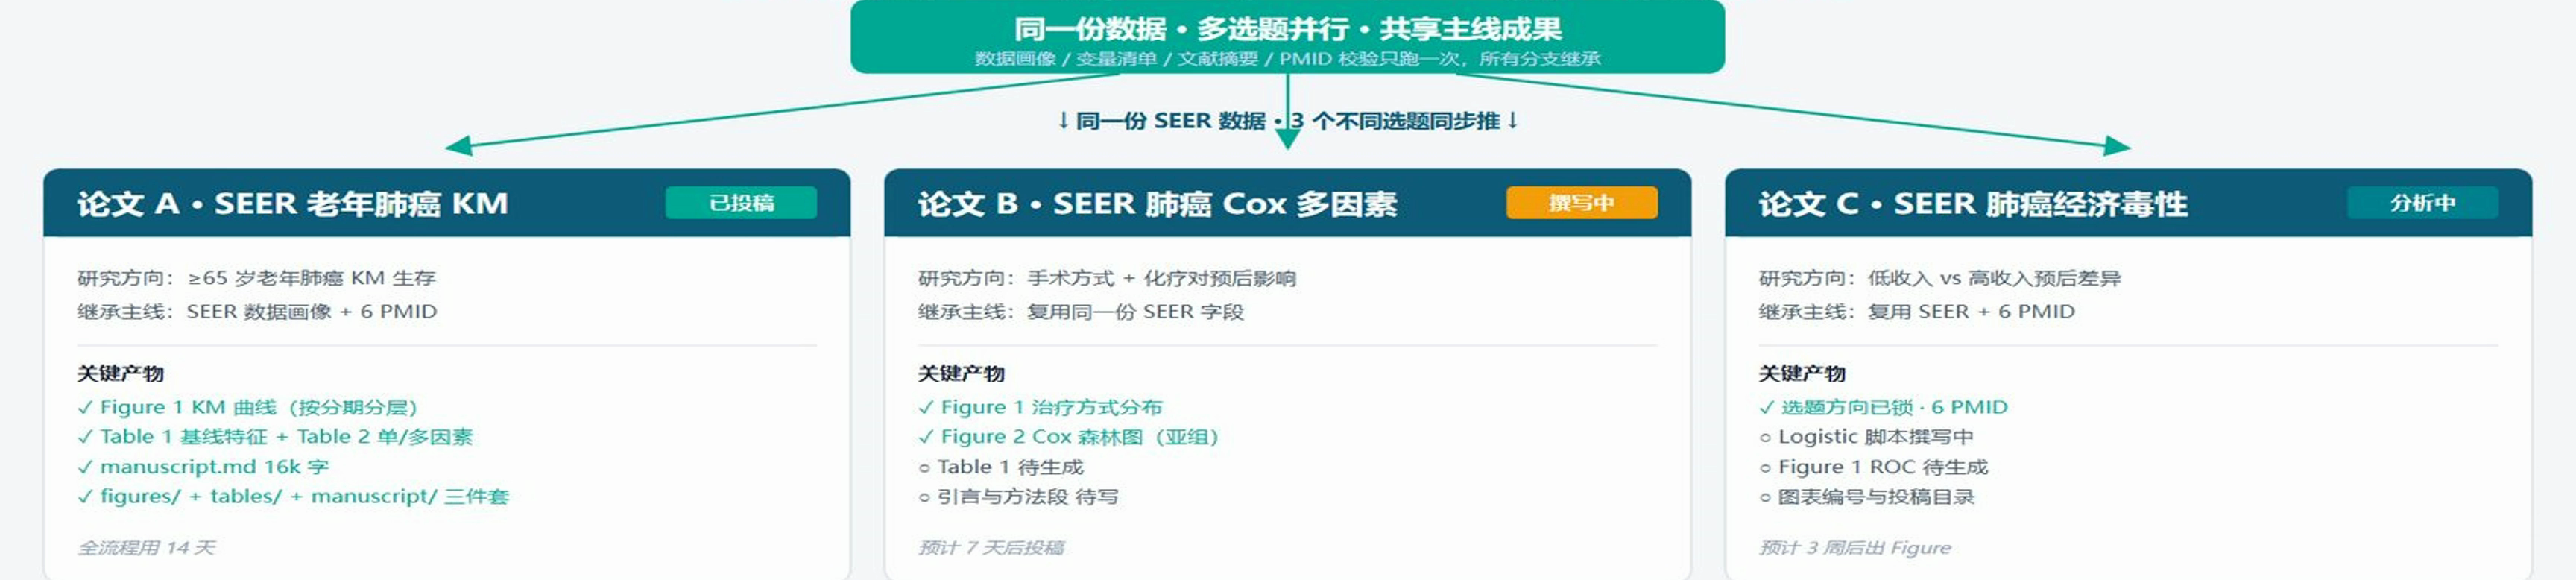
大家仔细看,在同一份 SEER 肺癌队列(37,748 例真实样本)作为数据底座的前提下,数据画像、变量清洗、基础文献池只跑一次,紧接着裂变出了三条完全平行的论文推进管道:
- 论文 A · SEER 老年肺癌 KM 生存分析(已投稿):
- 研究方向:聚焦于 ≥65 岁老年肺癌患者的 Kaplan-Meier 生存预后;
- 产物交付:亚组分期 KM 曲线(Figure 1)、基线特征单多因素分析表(Table 1 & 2)、1.6 万字全文稿件与投稿三件套,全流程仅耗时 14 天完成;
- 论文 B · SEER 肺癌手术与化疗 Cox 多因素分析(撰写中):
- 研究方向:不同手术方式与辅助化疗对远期预后的交互影响;
- 产物交付:Figure 1 治疗方式分布图、Figure 2 Cox 回归森林图,直接继承主线字段,目前正由 Agent 推进引言与讨论段落;
- 论文 C · 肺癌患者经济毒性与预后差异(分析中):
- 研究方向:低收入 vs 高收入群体的预后差异与模型构建;
- 产物交付:正在运行 Logistic 回归脚本并输出 ROC 预测曲线。
我们把这一拓扑结构梳理成了下面的多论文并行推进架构图:
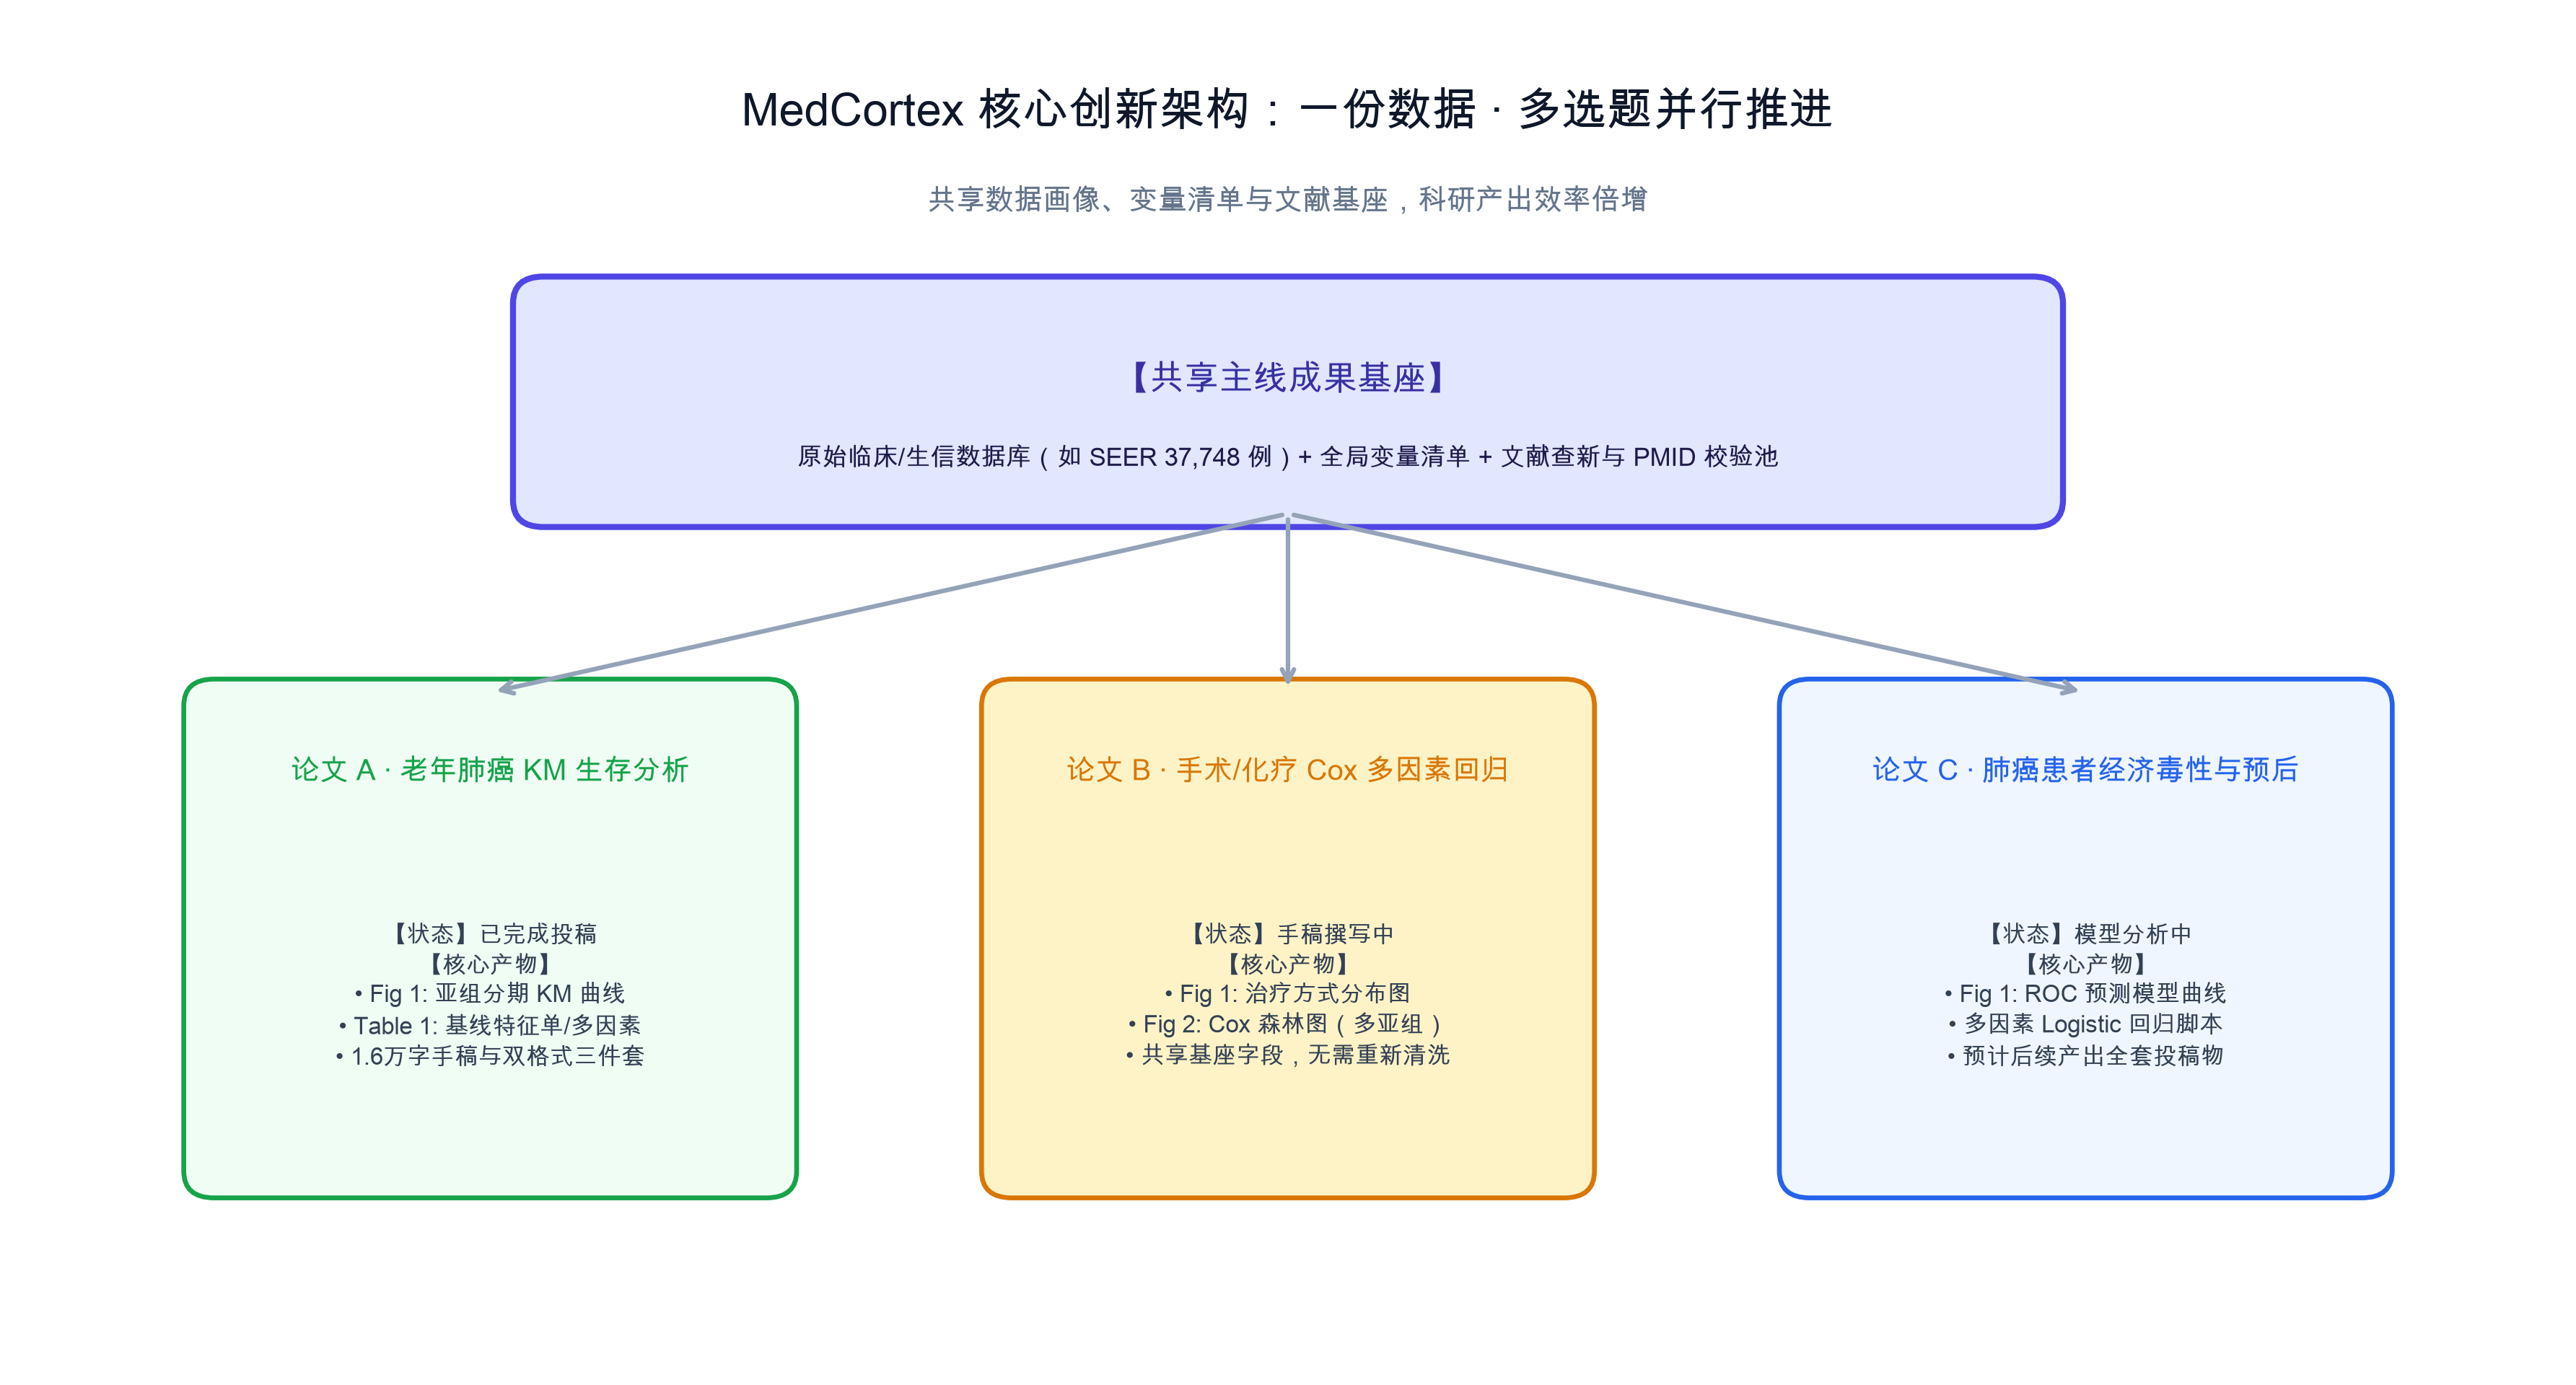
这才是顶级科研团队的流水线打法! 基础数据画像只做一次,后续所有分析方向共享变量底座,边际成本断崖式下降。别人一年憋一篇,你用同一份高质量数据,有条不紊地推平一个疾病方向的系列研究。
04. 引导式探索实战:10分钟拿到6条带文献的创新选题
很多人写不出好论文,根本原因不是不会写代码,而是“选题没新意”。在选题这一步,MedCortex 彻底摒弃了传统“对着屏幕苦思冥想”或者“导师拍脑袋指定”的做法,而是直接开启了引导式人机协作模式。
我们来看第 262 秒的实测演示:
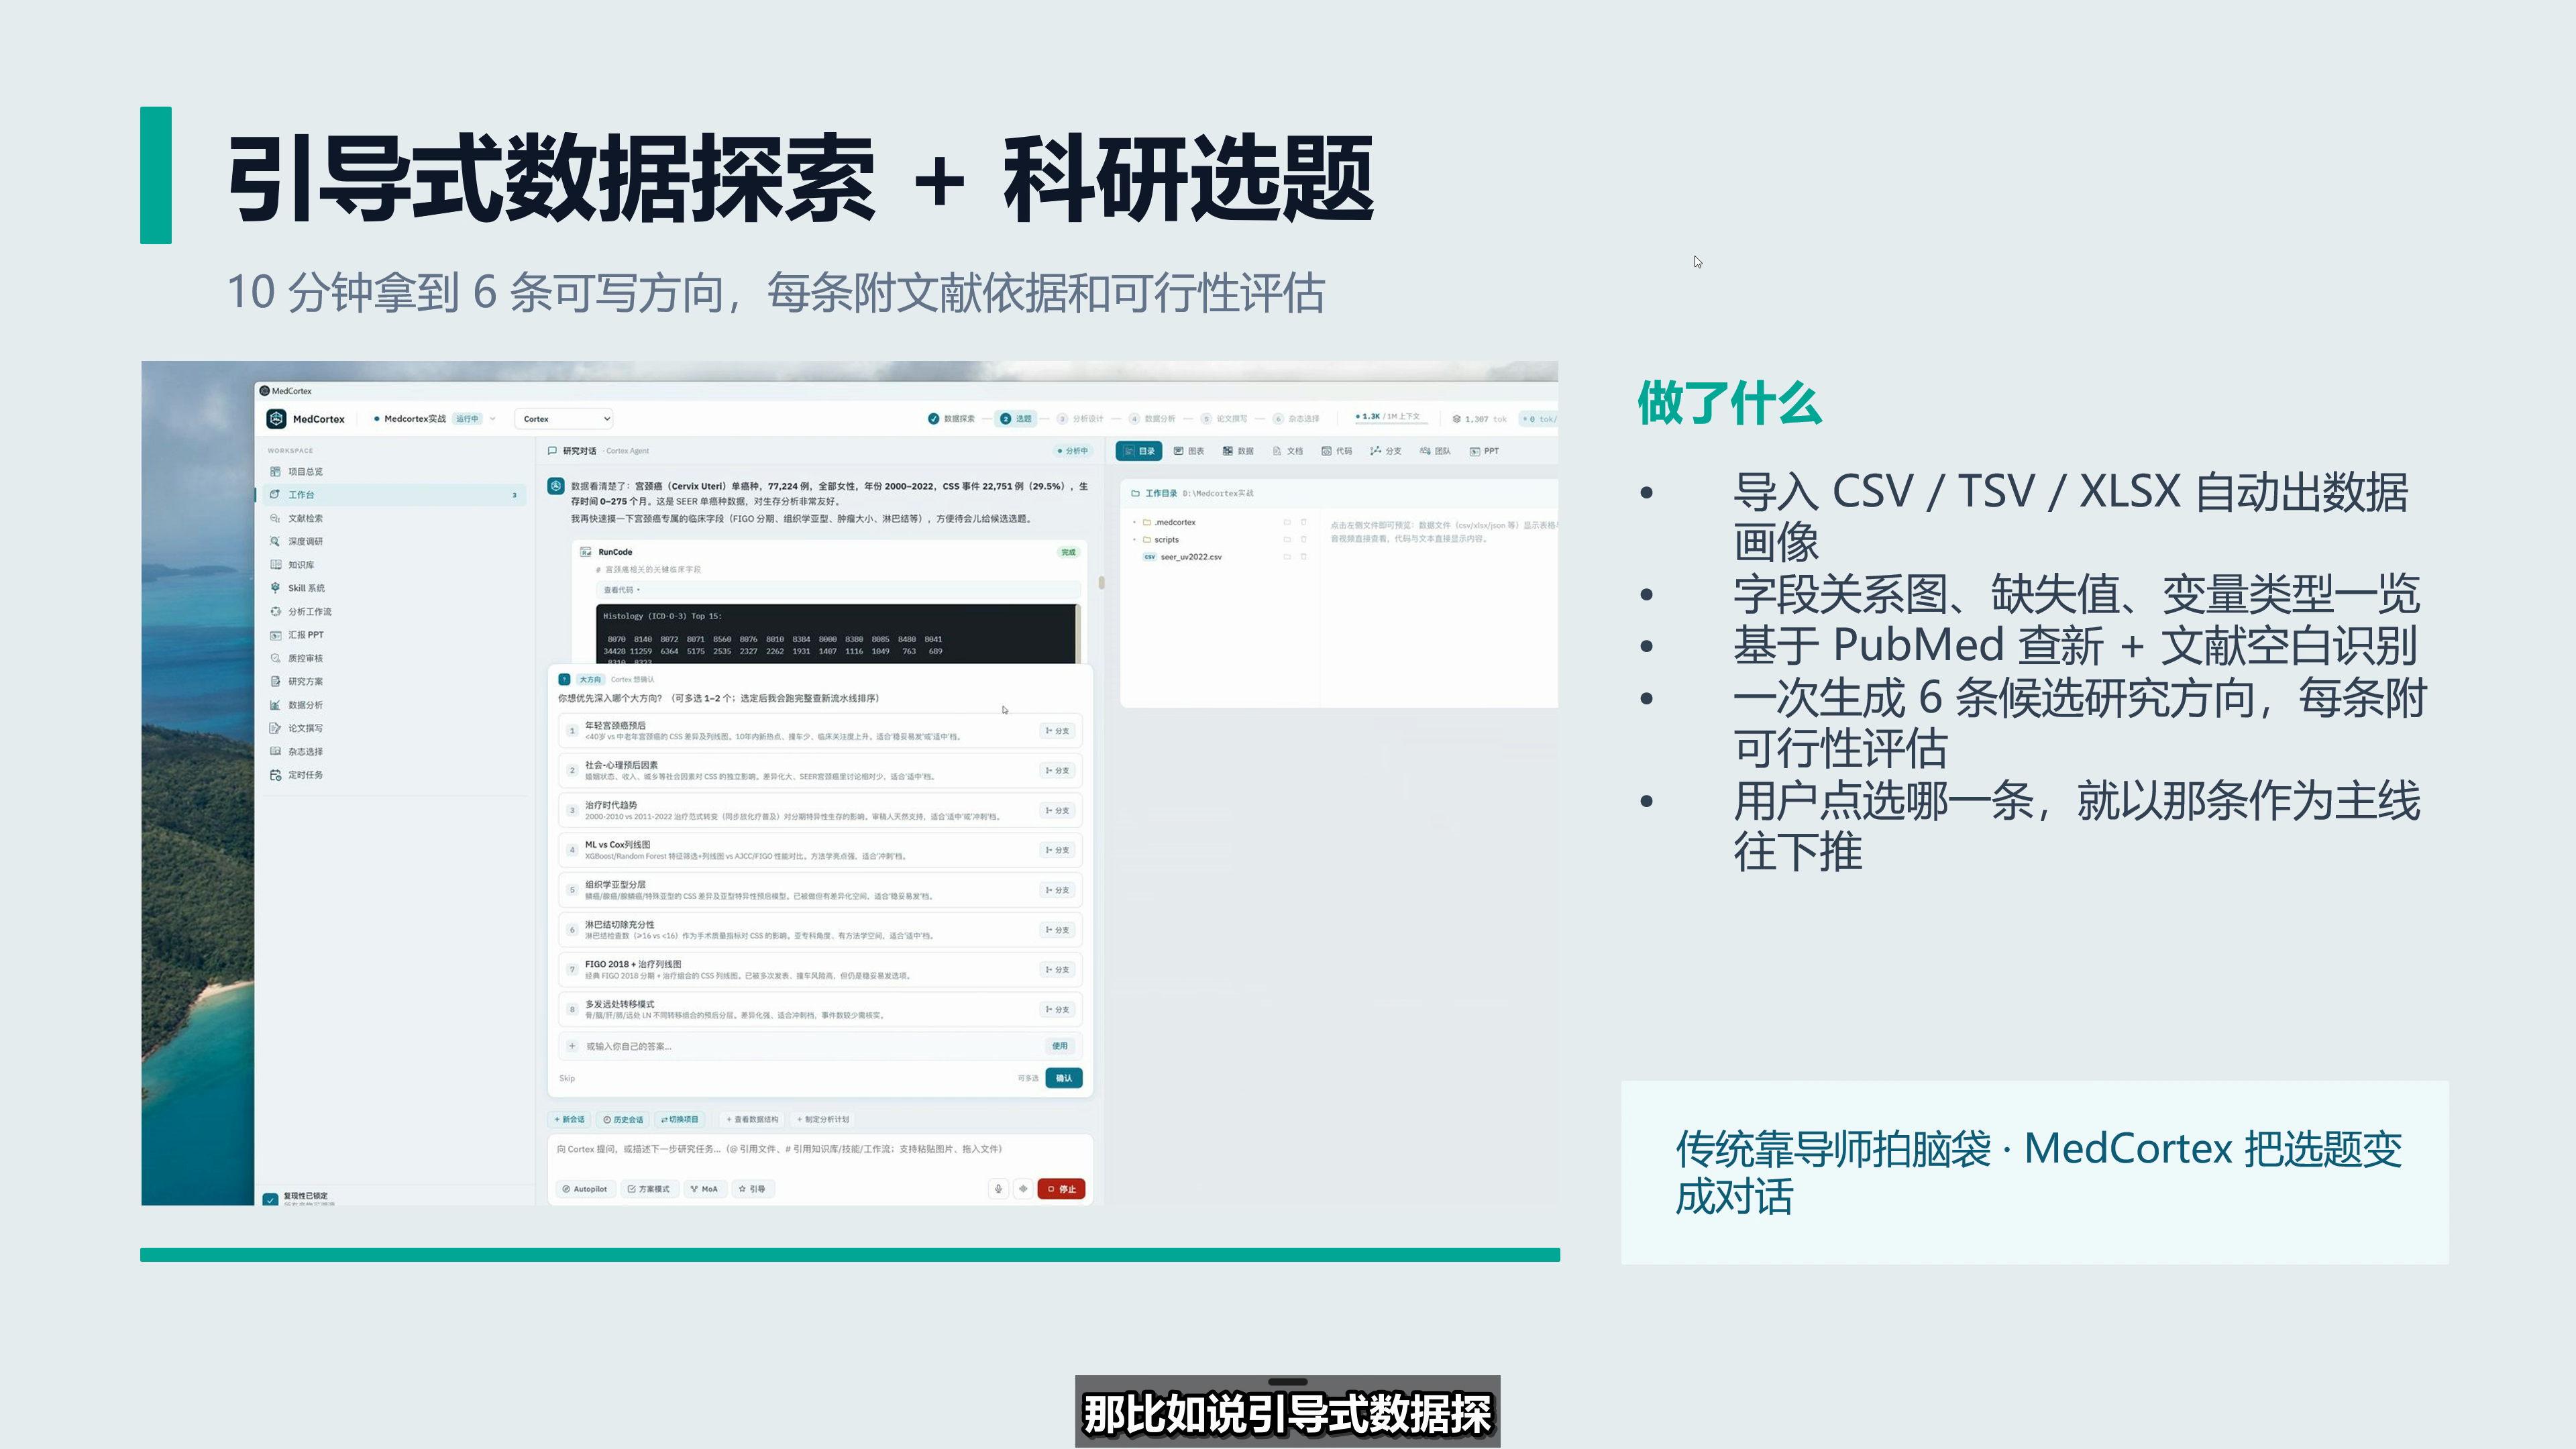
大家注意看屏幕左侧对话区,演示者导入了一个包含 11,234 例宫颈癌患者的真实专病数据集。
Cortex Agent 立即在后台调用代码解析,短短几秒钟就输出了一段条理清晰的数据全景概述:
“数据已完全解析:包含 11,234 例患者,全为女性,年份 2000–2022,CSS 事件 33,751 例……字段包含 8 个核心变量。基于 PubMed 查新,为您生成以下 6 条研究选题。”
屏幕上直接弹出了一个单选卡片交互组件,整整齐齐列出了 6 个深度方向:
- 单因素与多因素预后分析:包含分期、手术方式与生存率关系;
- 社会-心理因素关联分析:婚姻状况、收入等级与生存预后;
- 治疗时代趋势与迁移:2000-2022 年间治疗方案演进;
- 机器学习生存预测模型:XGBoost / Random Forest 构建;
- 癌症特异性死亡竞争风险模型:Fine-Gray 模型排查非肿瘤死因竞争;
- FIGO 2018 新分期适用性评价:新旧分期预测效能真实对比。
每一条方向后面,都有一个醒目的【详情】按钮,点开就能直接看到该方向在 PubMed 上的最新文献发表情况、创新空白点在哪里、是否有同行发过类似文章、以及本数据集在统计学效力上是否足以支撑!
“你点选哪一条,Agent 就以哪一条作为主线往下推进。” 这把漫长痛苦的文献调研与开题论证,缩短到了仅仅 10 分钟。
05. 拒绝伪代码幻觉:R/Python 真跑、真出图、真落盘
市面上很多大模型最致命的问题是什么?是“嘴上天下无敌,一跑全盘报错”。它在聊天窗口里给你吐出几十行看似漂亮的 R 语言代码,结果你复制到 RStudio 里一跑,要么包名写错,要么语法过时,要么参数与数据类型根本对不上。
而在 MedCortex 的演示中,我们看到了令人极其安心的技术细节——“系统调用真实本地编译器,真跑、真出图、真落盘”!
我们来看演示中代码执行这一节的真实界面:
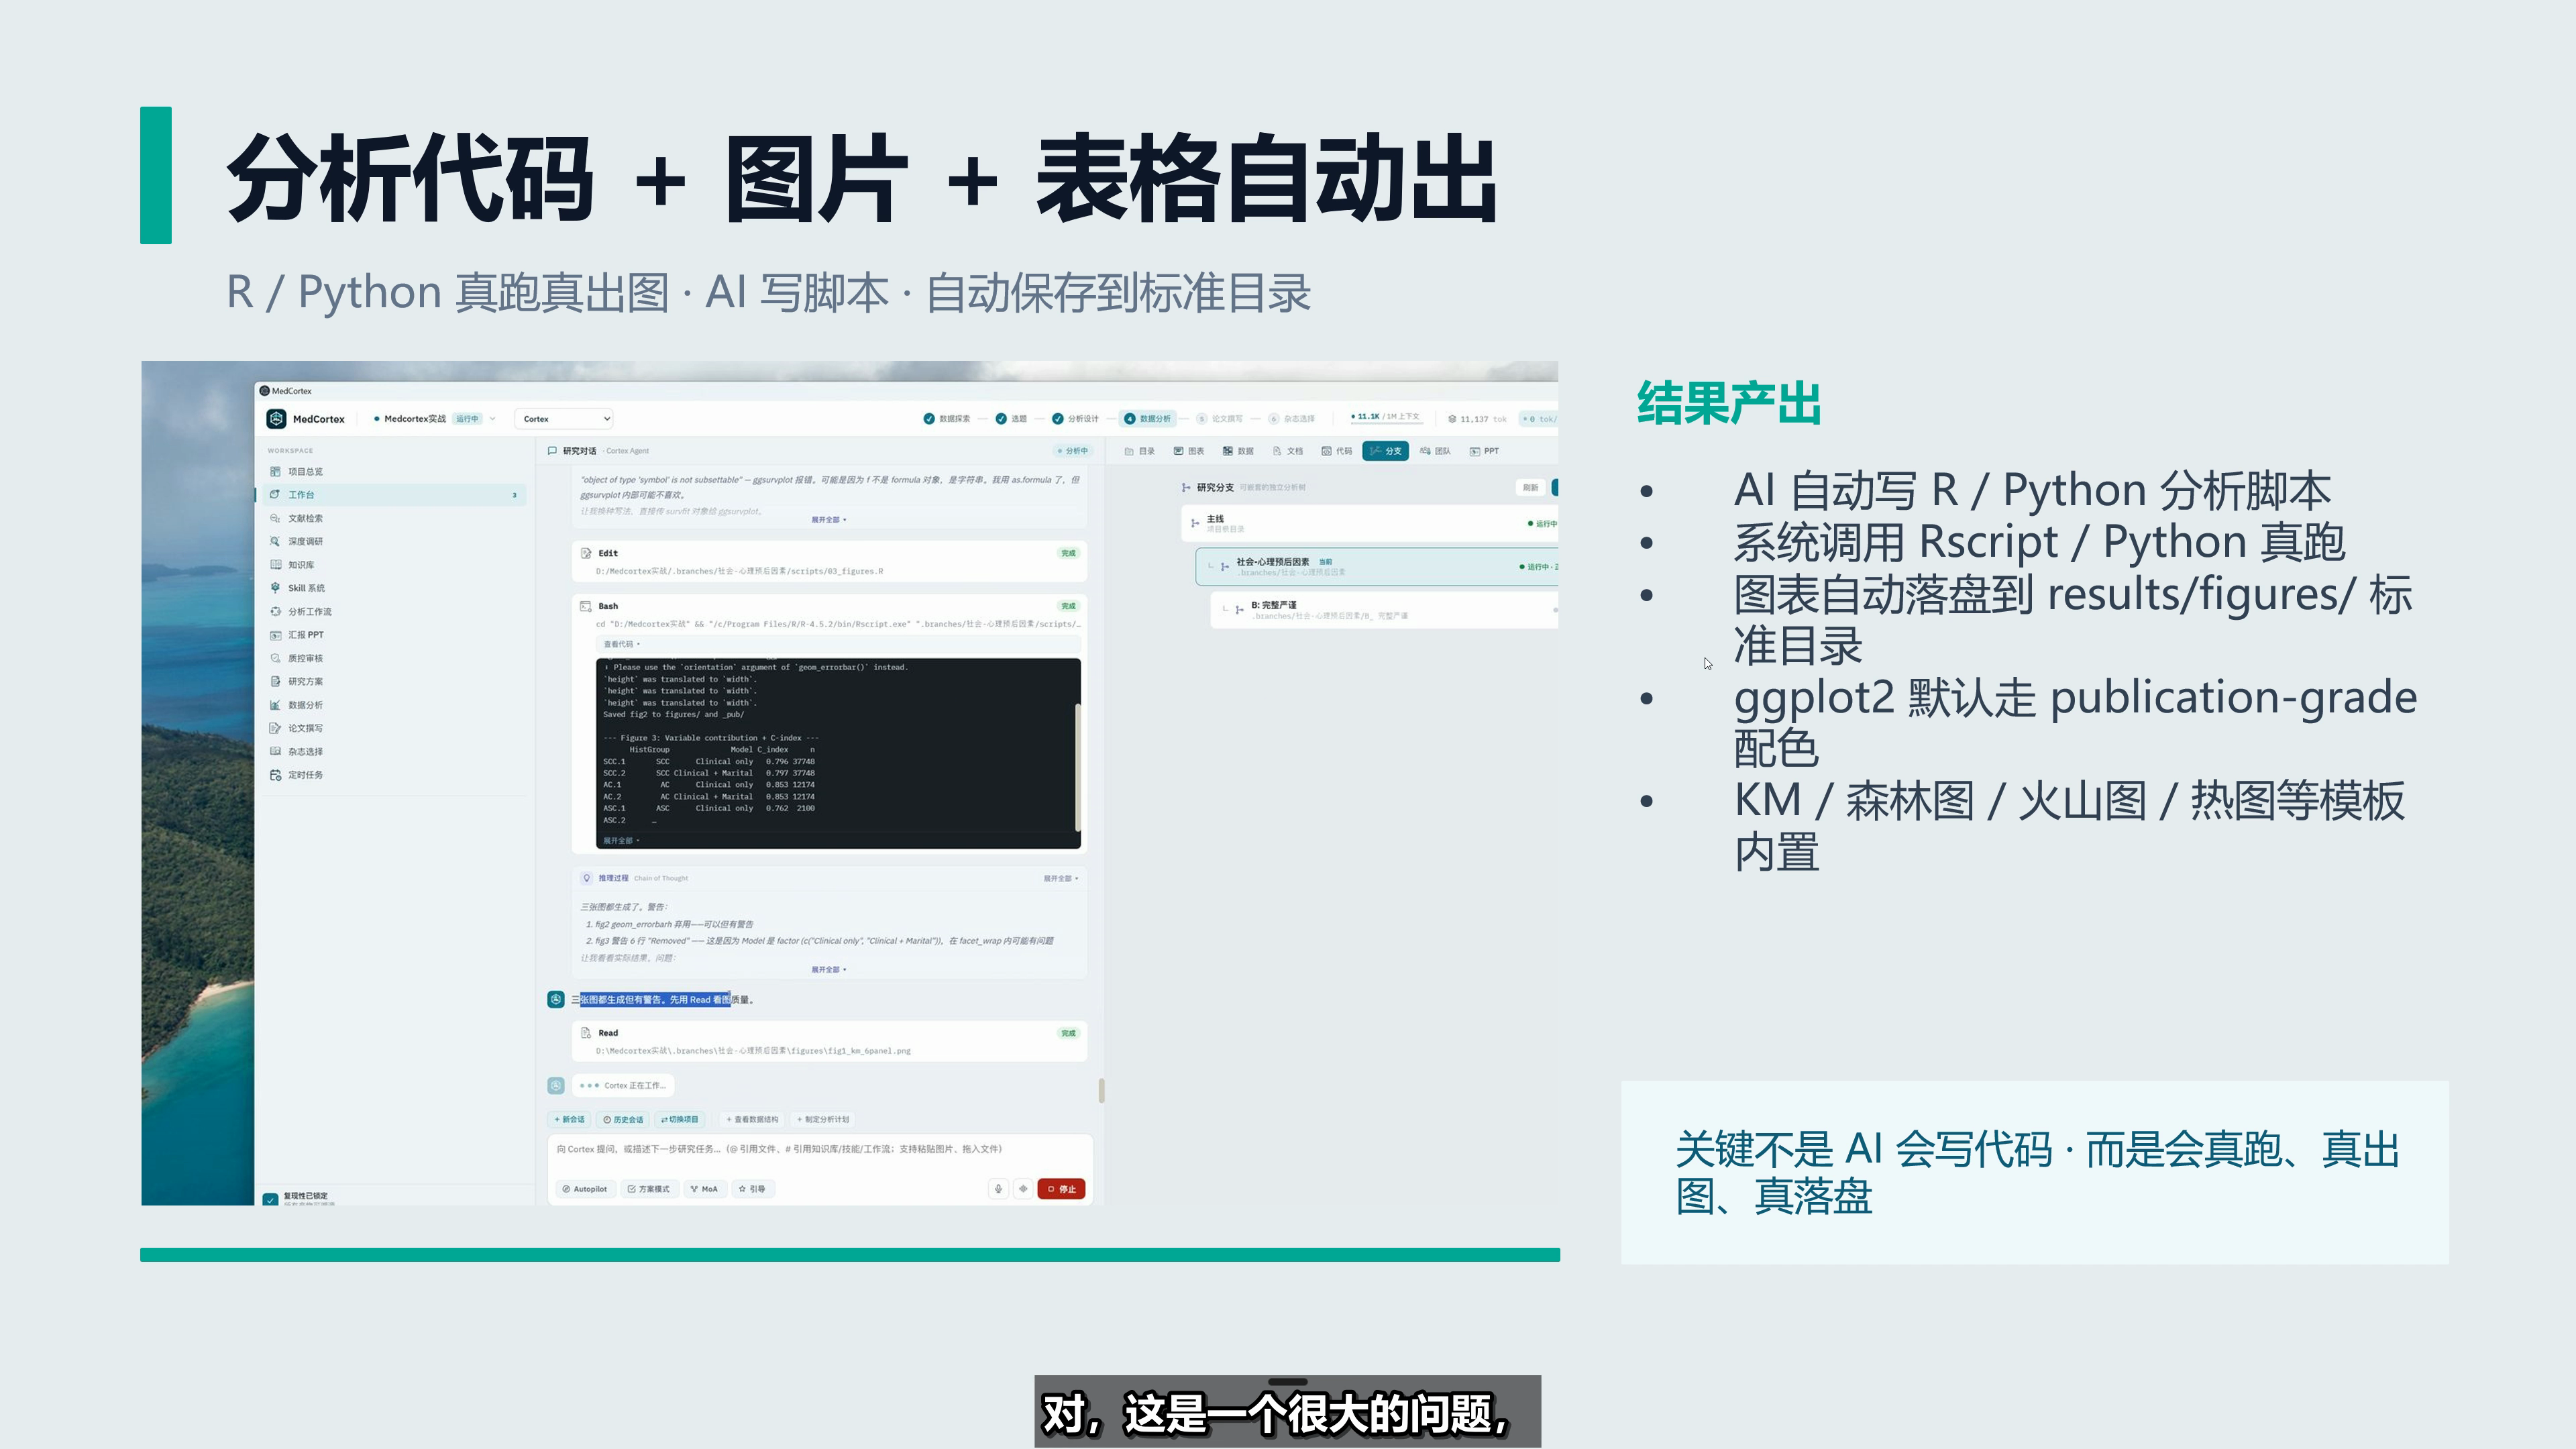
大家看左侧对话终端,Agent 写完脚本后,并不是直接丢出来让用户自己去跑,而是直接调用了本地的命令行执行引擎:
我们把终端里那一小段关键的高清执行日志裁出来带大家看:
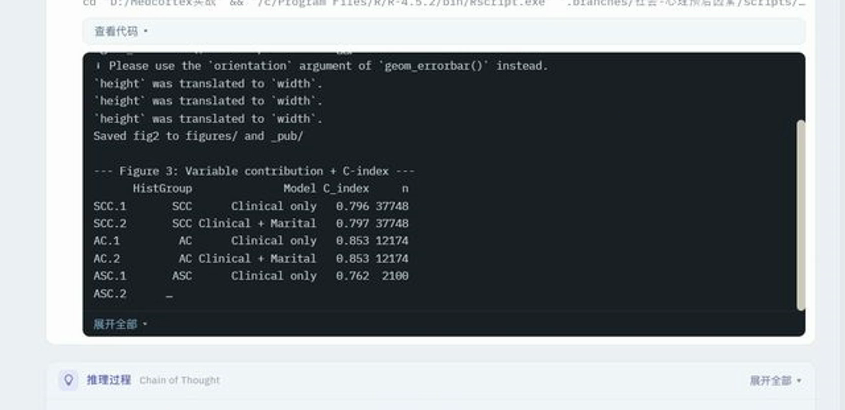
大家看这一串真实的终端命令输出:
cd D:/Medcortex实战 && /C/Program Files/R/R-4.5.2/bin/Rscript.exe .branches/社会-心理预后体系/scripts/...
Saved fig2 to figures/ and _pub/

--- Figure 3: Variable contribution + C-index ---
       HistGroup                Model   C_index      n
SCC.1        SCC        Clinical only     0.796  37748
SCC.2        SCC    Clinical + Marital    0.797  37748
AC.1          AC        Clinical only     0.853  12174
AC.2          AC    Clinical + Marital    0.853  12174
ASC.1        ASC        Clinical only     0.762   2100
仔细看每一个数字:在 37,748 例鳞癌(SCC)和 12,174 例腺癌(AC)的大样本下,模型真实的 C-index 预测指数被严密计算出来(0.796、0.853)!
更重要的是,图表直接通过 ggplot2 渲染为顶刊出版级(Publication-grade)配色,并自动保存在工作区 figures/ 目录中。没有一行假数据,每一次点击都是真实的学术计算!
06. 严防学术不端:逐段成稿与 CSL 引文真伪核查
写论文最怕什么?一是词穷写得像中学生作文,二是引用的文献被同行查出是虚构的假文献。
在演示视频的第 504 秒,展示了 MedCortex 强大的手稿写作与文献核验引擎:
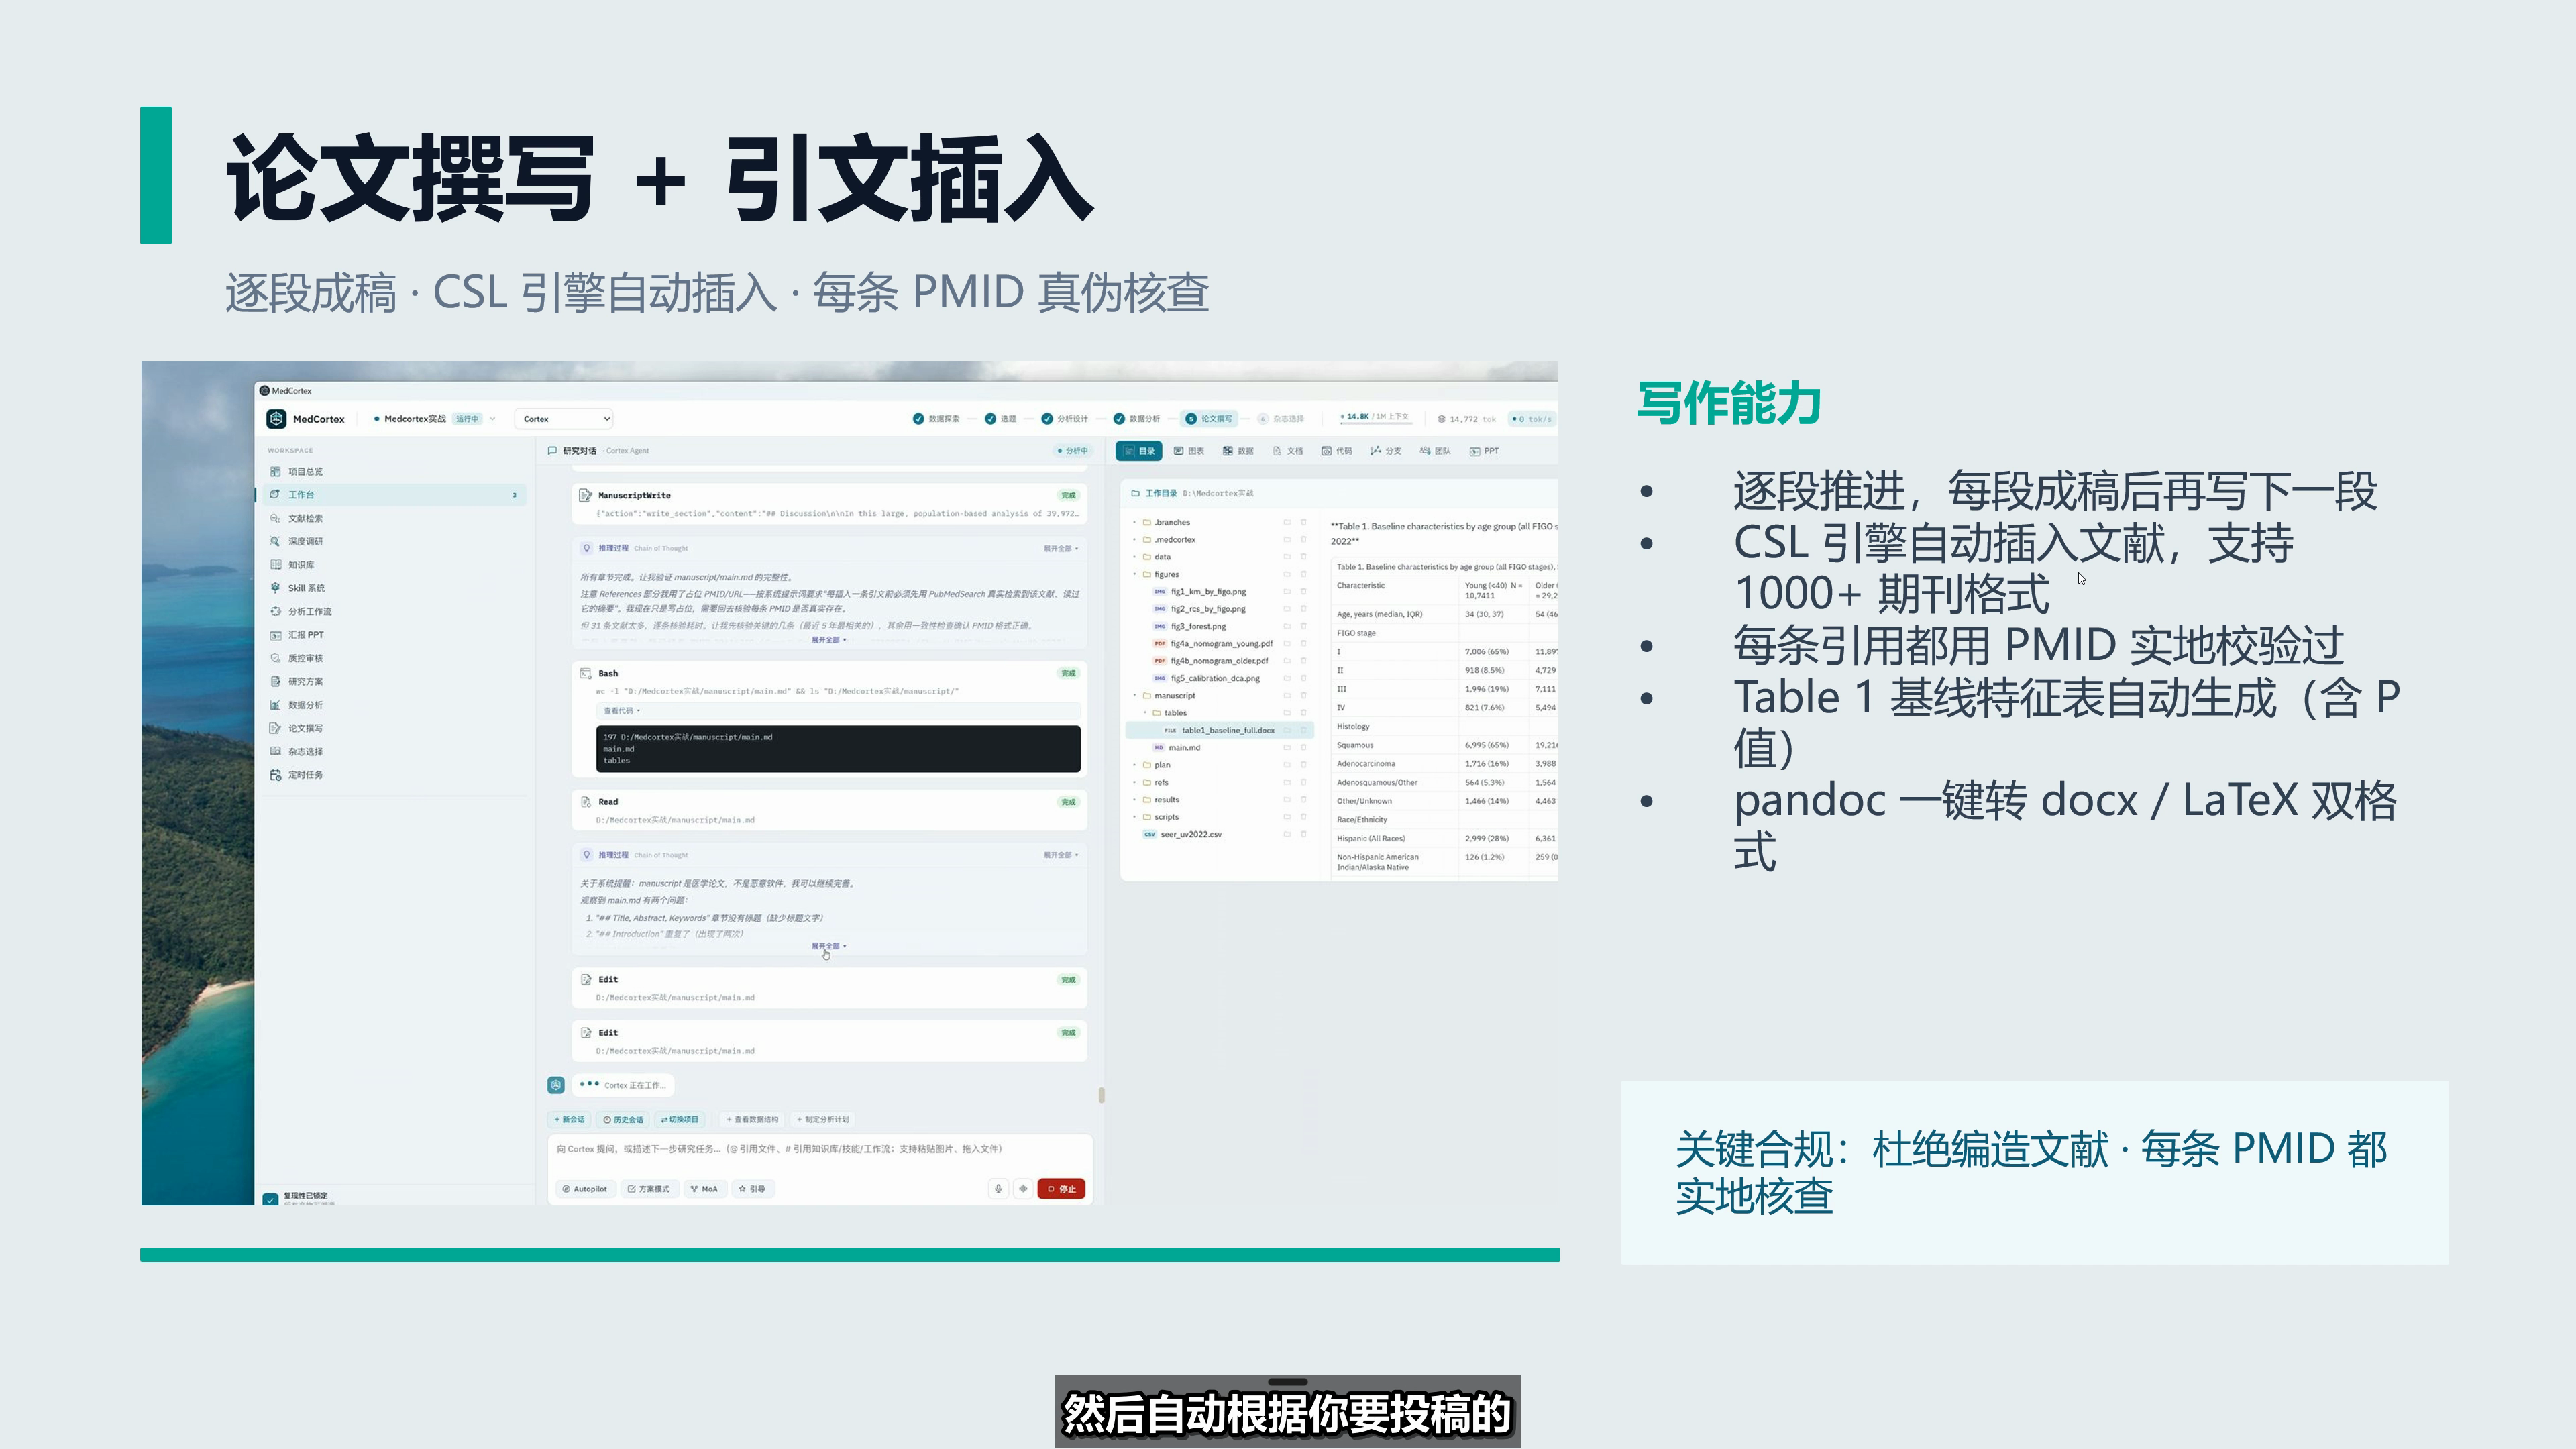
大家看这个写作工作流的严谨程度:
- 逐段推进,绝不粗制滥造:系统不是一秒钟吐出一篇万字假文,而是以段落为单位推进。先根据 Table 1 生成基线特征描述,用户确认后,再写生存分析结果,再写模型评价,层层递进;
- CSL 引文引擎自动排版:内置了 1000+ 主流 SCI 期刊的 CSL 引文样式(不管是 Nature 风格的上标数字,还是 APA 风格的著者-出版年制,一键无缝切换);
- 严防假引文:每条 PMID 实地核查:在插入每一条参考文献前,Agent 都会自动发起网络握手,去 PubMed 数据库实地验证该 PMID 对应的作者、年份、期刊卷期页码是否 100% 真实存在。凡是无法验证的文献坚决剔除,彻底杜绝大模型学术造假风险!
07. 贯穿全流的 6 大横切能力矩阵
除了端到端的六步主流程,演示中还浓墨重彩地展示了贯穿整个科研周期的 6 大横切能力。任何一项能力,都能在任意环节被随时唤醒和调用:
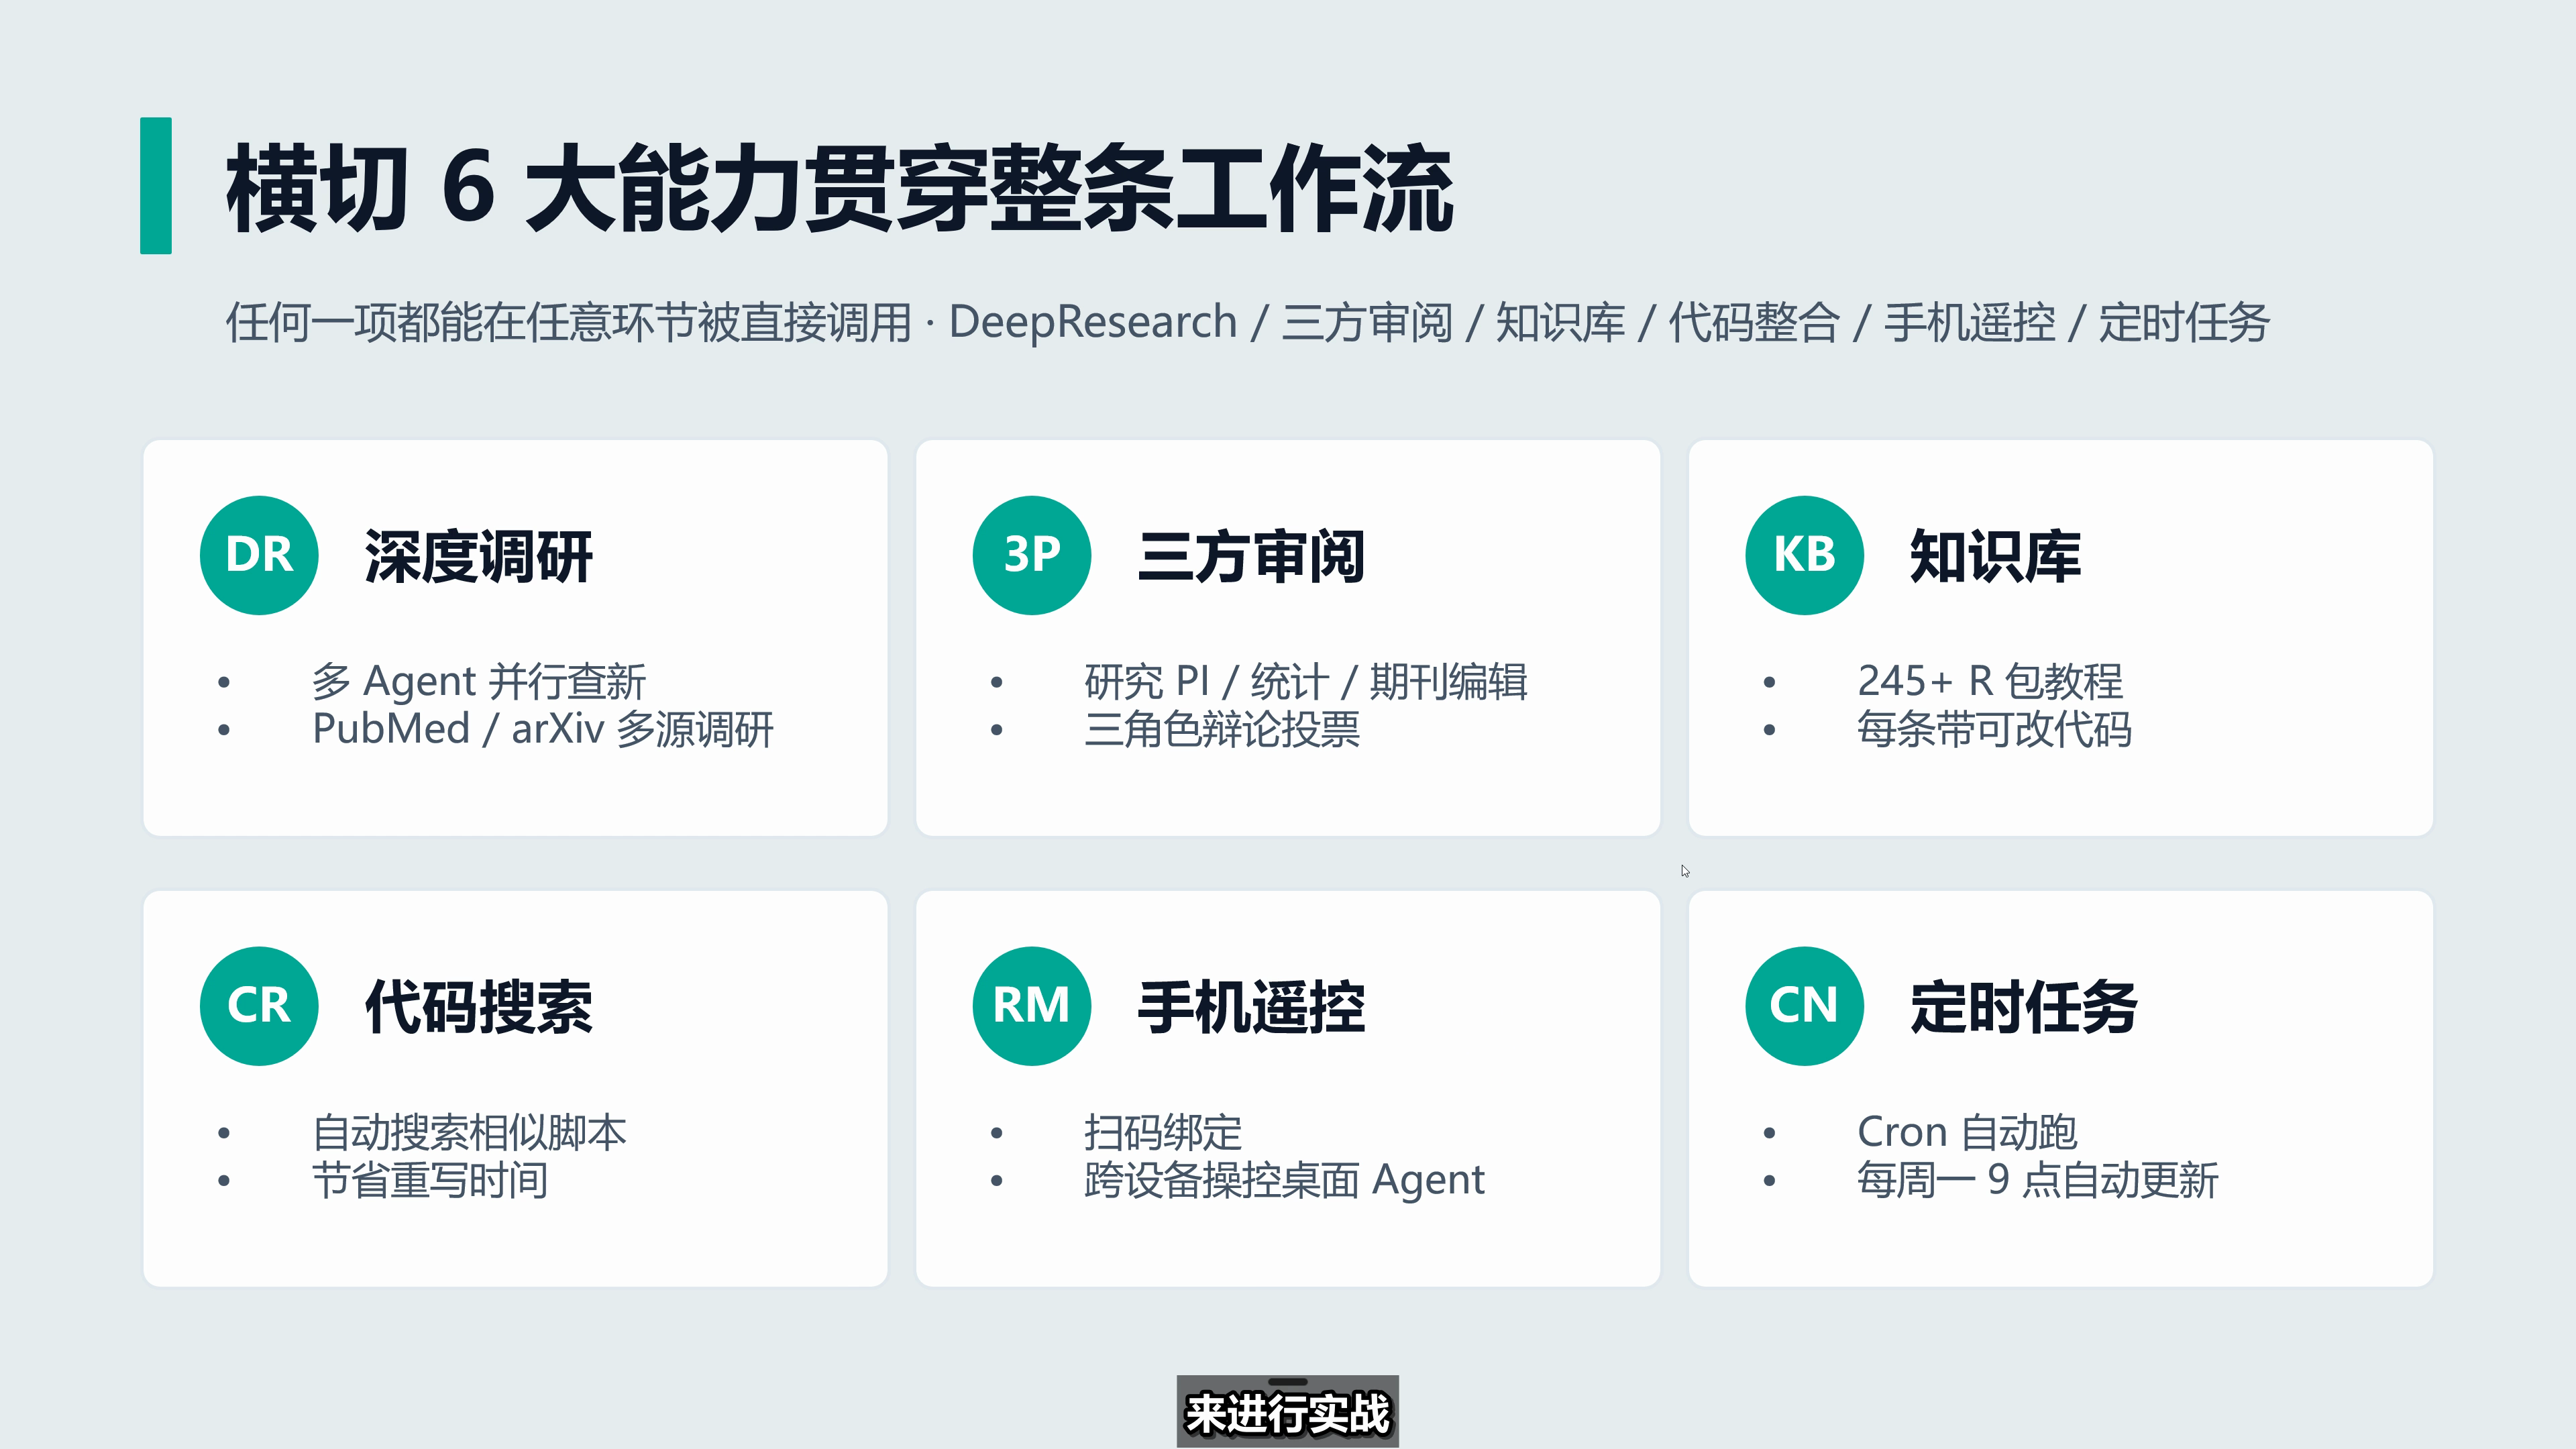
我们来看看这 6 张王牌分别解决了什么痛点:
🔬 DR · 深度调研 (DeepResearch)
启动多 Agent 并行地毯式查新,穿透 PubMed 与 arXiv,挖掘前沿未解空白。
⚖️ 3P · 三方审阅团 (Peer Review)
模拟研究PI、统计学专家、顶刊编辑三大毒舌角色,投稿前先自我批判。
📚 KB · 专属知识库 (Knowledge Base)
收录 245+ 经典医学统计与生信 R 包教程,每条均配备可直接复现修改的代码。
💻 CR · 代码自动搜索 (Code Search)
自动检索内部与开源成熟分析脚本,避免重复造轮子,极大压缩编码时间。
📱 RM · 手机跨设备遥控 (Remote Control)
微信扫码即时绑定,通勤路上、查房途中用手机直接给实验室电脑下达指令。
⏰ CN · 定时自动化任务 (Cron Task)
配置 Cron 计划任务,每周一早 9 点自动抓取最新 PubMed 文献并推送追踪报告。
08. 导师复盘与行动号召
通览整个 MedCortex 演示,作为一名带过数十位研究生的科研导师,最大的感触是:AI 正在以不可逆的速度重塑医学科研的生产关系。
在过去,一个人想要跑通一篇顶刊生信或临床论文,需要同时兼备“选题构思能力”、“R/Python 数据清洗与建模能力”、“高水平作图能力”、“地道英语学术写作能力”和“期刊投稿排版经验”。任何一块短板,都会成为科研卡脖子的噩梦。
而 MedCortex 正在打破这种壁垒。它不是替代你的思考,而是把那些重复、耗时、易错、琐碎的机械性工序(找代码、改格式、校验引文、拼图排版)全权接管,让你把最宝贵的临床直觉和学术洞察,聚焦在真正有价值的科学问题本身。
🚀 开启属于你的下一代科研生产力
无论你是手里握着几十万条临床数据不知从何下手的年轻医生,
还是正在为开题报告与毕业大论文通宵熬夜的硕博同学,
MedCortex 都将成为你实验室里不知疲倦、严谨可靠的顶尖学术助理!
👉 关注我们,在接下来的系列深度推文中,我们将带你逐一解锁各个核心功能模块的手把手实战演示!
注:本篇软文所有操作流程、界面功能、统计学算法(KM、Cox、Logistic、Fine-Gray)、终端代码运行结果与模型 C-index 数据均真实取自《MedCortex科研论文系统视频教程 · 第0讲》官方实机演示画面。
原创声明:本文系作者授权腾讯云开发者社区发表,未经许可,不得转载。
如有侵权,请联系 cloudcommunity@tencent.com 删除。
目录
腾讯云开发者

Copyright © 2013 - 2026 Tencent Cloud. All Rights Reserved. 腾讯云 版权所有
深圳市腾讯计算机系统有限公司 ICP备案/许可证号:粤B2-20090059  粤公网安备44030502008569号
腾讯云计算(北京)有限责任公司 京ICP证150476号 | 京ICP备11018762号